一、安装python 环境
我使用是的3.9.13,尽量用验证过的版本,paddleocr对版本有要求
安装成功后升级pip
python -m pip install --upgrade pip先提前切换清华源,防止在安装过程中卡住
python
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple验证切换结果:
pip config list二、安装paddle
CPU 版本
python -m pip install paddlepaddle -i https://pypi.tuna.tsinghua.edu.cn/simpleGPU版本
python -m pip install paddlepaddle-gpu -i https://pypi.tuna.tsinghua.edu.cn/simple这一步一般不会遇到什么问题。
三、安装 paddle OCR
安装前需要先安装安装 Shapely whl 文件
这有一个清华源下载地址:
https://pypi.tuna.tsinghua.edu.cn/simple/shapely/
选择Shapely-1.8.2-cp39-cp39-win_amd64.whl版本
在下载目录下安装:
pip install Shapely-1.8.2-cp39-cp39-win_amd64.whl由于paddle ocr依赖 pyclipper,先安装pyclipper
pip install pyclipper==1.3.0.post4这里有坑,即使安装成功了,如果机器上没有Microsoft Visual C++ ,也无法使用,所以还需要安装
Microsoft Visual C++ 2015-2022 Redistributable (x64)
到此,才是真正安装paddleocr,执行以下命令:
pip install "paddleocr>=2.0.1" 安装完成后查看结果
pip list | findstr paddleocr如果显示paddleocr 3.3.1,说明安装成功了。
四、测试是否成功
执行命令:
python -m paddleocr ocr -i 1.jpg --use_angle_cls true其中1.jpg是测试图片
执行后会自动下载模型
official_models\PP-LCNet_x1_0_doc_ori
official_models\UVDoc
official_models\PP-LCNet_x1_0_textline_ori
official_models\PP-OCRv5_server_det
official_models\PP-OCRv5_server_rec
下载需要十几分钟,需要耐心等待:
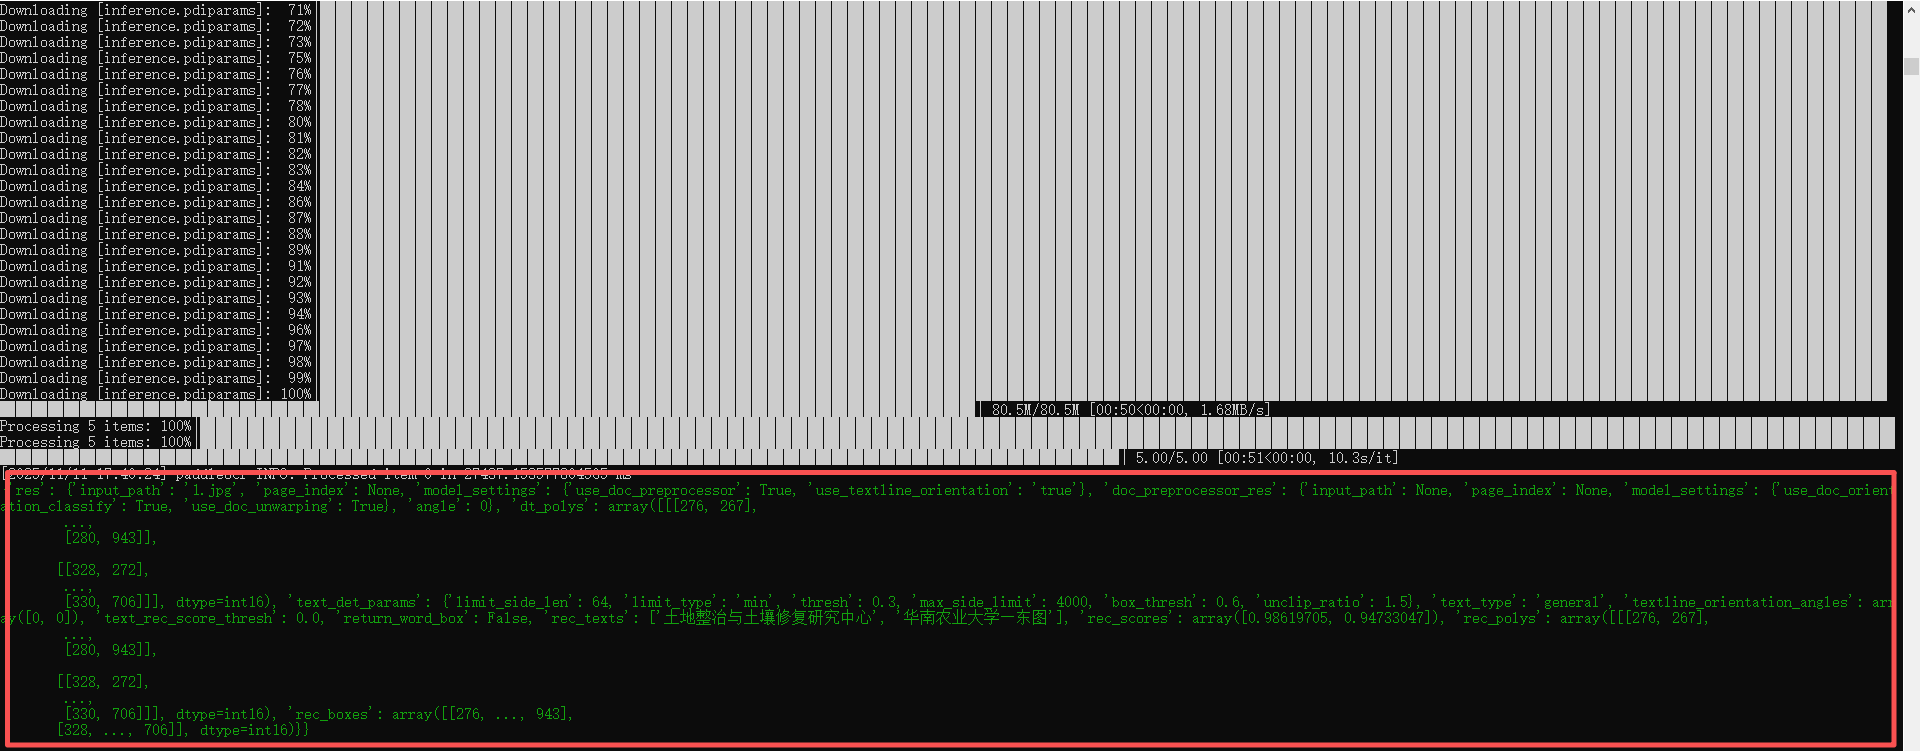
下载完成后会自动执行测试结果:
五、发布为API服务
安装必要的 Web 框架和依赖:
pip install fastapi uvicorn python-multipartfastapi:用于构建 API 服务的框架。uvicorn:用于运行 FastAPI 服务的服务器。python-multipart:支持处理文件上传。
编写API代码,如ocr_api.py,内容如下:
from fastapi import FastAPI, UploadFile, File
from fastapi.responses import JSONResponse
import paddleocr
import time
import numpy as np
from PIL import Image
import io

app = FastAPI(title="PaddleOCR API 服务")
print("FastAPI应用已创建")

# 初始化 OCR 模型
print("正在初始化PaddleOCR模型...")
ocr = paddleocr.PaddleOCR(
    use_angle_cls=True,
    device="cpu",
    cpu_threads=8
)
print("PaddleOCR模型初始化完成")

@app.post("/ocr", summary="图片文字识别接口")
async def ocr_recognition(file: UploadFile = File(..., description="待识别的图片文件")):
    try:
        start_time = time.time()
        print(f"接收到文件: {file.filename}, 内容类型: {file.content_type}")

        contents = await file.read()
        print(f"文件大小: {len(contents)} 字节")
        image = Image.open(io.BytesIO(contents))
        print(f"图片尺寸: {image.size}, 模式: {image.mode}")
        image_np = np.array(image)
        print(f"NumPy数组形状: {image_np.shape}")


        print("开始OCR识别...")
        result = ocr.predict(image_np)
        # 将原始结果转换为字符串形式返回
        print(f"OCR结果: {result}")

        # 记录结束时间并计算执行时间
        end_time = time.time()
        execution_time = end_time - start_time
        print(f"OCR识别执行时间: {execution_time:.4f} 秒")

        return JSONResponse({
            "success": True,
            "message": "识别成功" if result else "未识别到文字",
            "results": str(result)  # 以字符串形式返回原始结果
        })

    except Exception as e:
        return JSONResponse({
            "success": False,
            "message": f"识别失败:{str(e)}",
            "results": []
        }, status_code=500)

if __name__ == "__main__":
    import uvicorn
    print("正在启动OCR API服务...")
    print("服务地址: http://0.0.0.0:8000")
    uvicorn.run(app, host="0.0.0.0", port=8000)
启动 python ocr_api.py
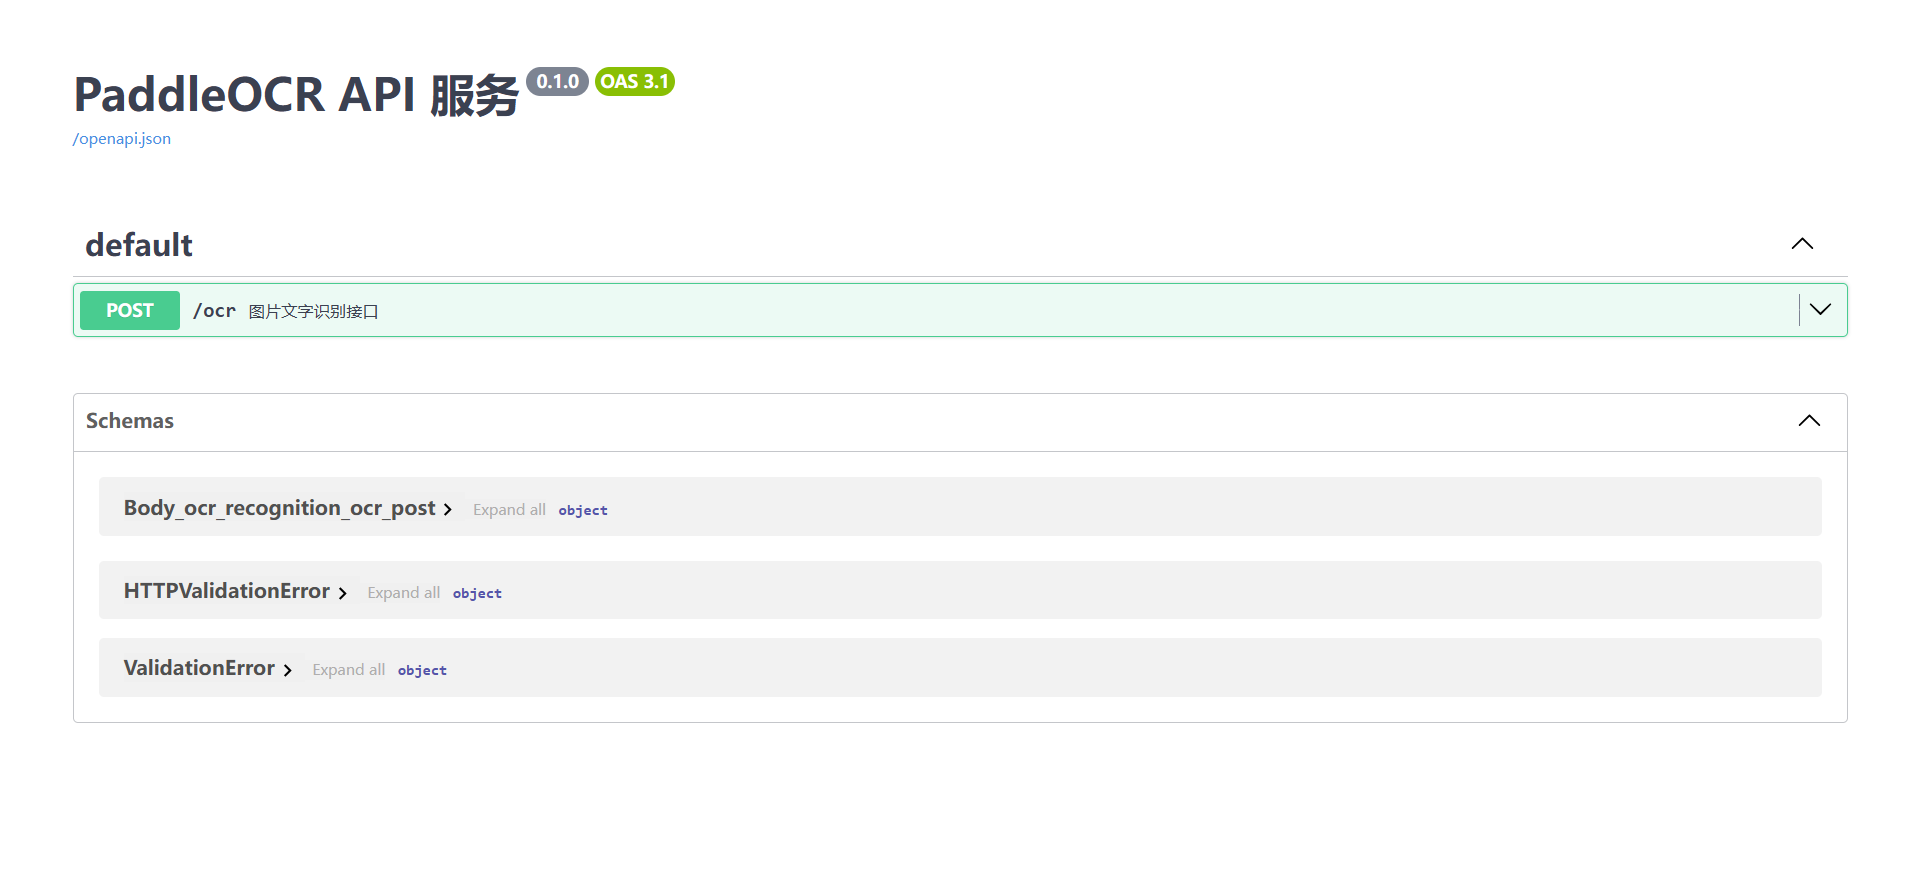
启动成功后进入测试页面:
http://localhost:8000/docs