import json
import multiprocessing
import os
import torch
from torch import nn
from d2l import torch as d2l
###############################################################################################
#下载预训练的bert模型:base and small
d2l.DATA_HUB['bert.base'] = (d2l.DATA_URL + 'bert.base.torch.zip',
                             '225d66f04cae318b841a13d32af3acc165f253ac')
d2l.DATA_HUB['bert.small'] = (d2l.DATA_URL + 'bert.small.torch.zip',
                              'c72329e68a732bef0452e4b96a1c341c8910f81f')
###############################################################################################
#加载预训练模型:
def load_pretrained_model(pretrained_model,num_hiddens,ffn_num_hiddens,
                          num_heads,num_layers,dropout,max_len,devices):
    data_dir=d2l.download_extract(pretrained_model)
    vocab=d2l.Vocab()
    vocab.idx_to_token=json.load(open(os.path.join(data_dir,'vocab.json')))
    vocab.token_to_idx = {token: idx for idx, token in enumerate(
        vocab.idx_to_token)}
    bert = d2l.BERTModel(len(vocab), num_hiddens, norm_shape=[256],
                         ffn_num_input=256, ffn_num_hiddens=ffn_num_hiddens,
                         num_heads=4, num_layers=2, dropout=0.2,
                         max_len=max_len, key_size=256, query_size=256,
                         value_size=256, hid_in_features=256,
                         mlm_in_features=256, nsp_in_features=256)
    bert.load_state_dict(torch.load(os.path.join(data_dir,'pretrained.params')))
    return bert,vocab
###############################################################################################
class SNLIBERTDataset(torch.utils.data.Dataset):
    def __init__(self, dataset, max_len, vocab=None):
        all_premise_hypothesis_tokens = [[
            p_tokens, h_tokens] for p_tokens, h_tokens in zip(
            *[d2l.tokenize([s.lower() for s in sentences])
              for sentences in dataset[:2]])]

        self.labels = torch.tensor(dataset[2])
        self.vocab = vocab
        self.max_len = max_len
        (self.all_token_ids, self.all_segments,
         self.valid_lens) = self._preprocess(all_premise_hypothesis_tokens)
        print('read ' + str(len(self.all_token_ids)) + ' examples')

    def _preprocess(self, all_premise_hypothesis_tokens):
        pool = multiprocessing.Pool(4)  # 使用4个进程
        out = pool.map(self._mp_worker, all_premise_hypothesis_tokens)
        all_token_ids = [
            token_ids for token_ids, segments, valid_len in out]
        all_segments = [segments for token_ids, segments, valid_len in out]
        valid_lens = [valid_len for token_ids, segments, valid_len in out]
        return (torch.tensor(all_token_ids, dtype=torch.long),
                torch.tensor(all_segments, dtype=torch.long),
                torch.tensor(valid_lens))

    def _mp_worker(self, premise_hypothesis_tokens):
        p_tokens, h_tokens = premise_hypothesis_tokens
        self._truncate_pair_of_tokens(p_tokens, h_tokens)
        tokens, segments = d2l.get_tokens_and_segments(p_tokens, h_tokens)
        token_ids = self.vocab[tokens] + [self.vocab['<pad>']] \
                             * (self.max_len - len(tokens))
        segments = segments + [0] * (self.max_len - len(segments))
        valid_len = len(tokens)
        return token_ids, segments, valid_len

    def _truncate_pair_of_tokens(self, p_tokens, h_tokens):
        # 为BERT输入中的'<CLS>'、'<SEP>'和'<SEP>'词元保留位置
        while len(p_tokens) + len(h_tokens) > self.max_len - 3:
            if len(p_tokens) > len(h_tokens):
                p_tokens.pop()
            else:
                h_tokens.pop()

    def __getitem__(self, idx):
        return (self.all_token_ids[idx], self.all_segments[idx],
                self.valid_lens[idx]), self.labels[idx]

    def __len__(self):
        return len(self.all_token_ids)
###############################################################################################
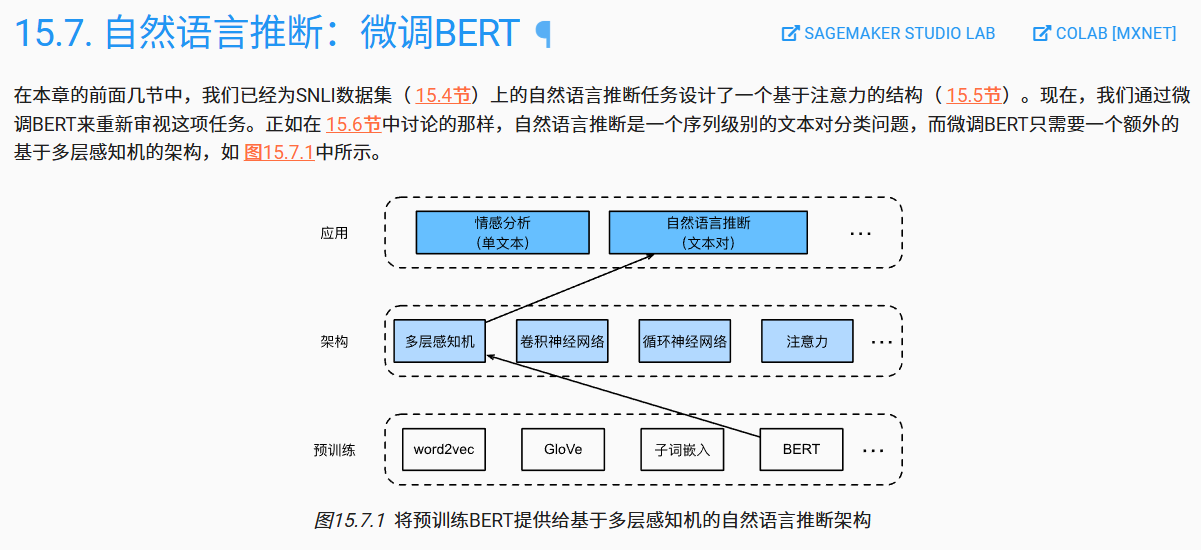
class BERTClassifier(nn.Module):
    def __init__(self, bert):
        super(BERTClassifier,self).__init__()
        self.encoder=bert.encoder
        self.hidden=bert.hidden
        self.output=nn.Linear(256,3)
    def forward(self,inputs):
        tokens_X,segments_X,valid_len_x=inputs
        encoded_X=self.encoder(tokens_X,segments_X,valid_len_x)
        #只取<CLS> token进行分类
        return self.output(self.hidden(encoded_X[:,0,:]))
###############################################################################################
#预训练模型加载
devices = d2l.try_all_gpus()
bert,vocab=load_pretrained_model('bert.small',num_hiddens=256,ffn_num_hiddens=512,
                                 num_heads=4,num_layers=2,dropout=0.1,max_len=512,devices=devices)
#数据集加载
batch_size, max_len, num_workers = 512, 128,d2l.get_dataloader_workers()
data_dir=r"/data1/zhongyan/deepl/pytorch/13_应用自然语言模型/snli_1.0"
train_set = SNLIBERTDataset(d2l.read_snli(data_dir, True), max_len, vocab)
test_set = SNLIBERTDataset(d2l.read_snli(data_dir, False), max_len, vocab)
train_iter = torch.utils.data.DataLoader(train_set, batch_size, shuffle=True,num_workers=num_workers)
test_iter = torch.utils.data.DataLoader(test_set, batch_size,num_workers=num_workers)
#模型训练与测试:
print("1")
net = BERTClassifier(bert)
lr,num_epochs=1e-4,5
trainer=torch.optim.Adam(net.parameters(),lr=lr)
loss=nn.CrossEntropyLoss(reduction='none')
d2l.train_ch13(net,train_iter,test_iter,loss,trainer,num_epochs,devices)
###############################################################################################