翻看十年前的博客,我曾轻描淡写地记录着使用 SQL*Loader 的"轻松"经历。
没想到,这个我以为毫无难度的工具,在十年后的今天却结结实实地给我上了一课。
当问题出现时,我求助了多位"AI老师",但它们给出的答案都未能药到病除。几经周折,最终还是得靠自己深入细节、焦头烂额地排查,才找到了症结所在。
回顾整个排查过程,总结经验教训,梳理成本文,方便读者或未来的自己能在有需要时可以直接使用不踩坑,掌握这种能直接将Excel数据"搬"进数据库的办公硬技能。
1.解决Mac导出CSV的兼容性问题
Mac上直接将Excel文件另存为CSV格式,注意选下面这个UTF-8格式的,否则中文会乱码。
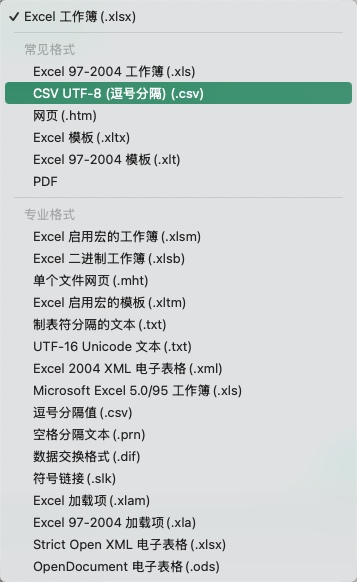
开始以为这样就OK,结果还是存在隐藏特殊字符的问题。
这里提供一个shell脚本 vi clean_csv_for_sqlldr.sh 来二次处理,内容如下:
BASH
#!/bin/bash

# 脚本名称:clean_csv_for_sqlldr.sh
# 脚本作用:自动完成 "换行符转换 + 空行清理"
# 使用方法:
# chmod +x clean_csv_for_sqlldr.sh
# ./clean_csv_for_sqlldr.sh your_file_name.csv
#
# 版本:v1.0
# 修改时间:2025年11月12日
# 作者:Alfred

# 检查是否提供了文件名参数
if [ $# -ne 1 ]; then
    echo "用法:$0 <需要处理的CSV文件名>"
    echo "示例:$0 utf8-product_Records.csv"
    exit 1
fi

csv_file="$1"

# 检查文件是否存在
if [ ! -f "$csv_file" ]; then
    echo "错误:文件 '$csv_file' 不存在!"
    exit 1
fi

# 步骤1:将Mac换行符\r转换为Unix换行符\n
tr '\r' '\n' < "$csv_file" > "$csv_file.tmp1"

# 步骤2:删除所有空行(保留有效数据行)
awk 'NF > 0 {print}' "$csv_file.tmp1" > "$csv_file.tmp2"

# 步骤3:替换原文件(保留备份)
mv "$csv_file" "$csv_file.bak"  # 备份原文件(可选,避免误操作)
mv "$csv_file.tmp2" "$csv_file"

# 清理临时文件
rm -f "$csv_file.tmp1" "$csv_file.tmp2"

echo "处理完成!"
echo "原文件已备份为:$csv_file.bak"
echo "处理后的文件:$csv_file"
注:也许使用 dos2unix 转换更简单,但笔者可能当时被其他连带问题干扰,以为没效果,后来使用这个脚本成功处理。
2.SQL*Loader控制文件配置详解
起初,时间太久甚至忘了sqlldr的控制文件规则,这里先给出一个模版方便举例说明(注意不是最终版本,若不想看过程,可以直接滑到文章最后看最终版):
vi template.ctl
OPTIONS (SKIP=1)  -- 跳过表头行
LOAD DATA
INFILE '.csv'
TRUNCATE INTO TABLE xxx
FIELDS TERMINATED BY ',' OPTIONALLY ENCLOSED BY '"'
TRAILING NULLCOLS
(
 ...具体字段名1,字段名2...
)
需要注意,已经在Oracle数据库中建好对应空表的情况下,这里控制文件中具体字段名大部分都不需要指定类型,可以直接拷贝CSV文件中的表头即可。
但是,关于时间列字段,通常都需要明确下格式,如果不明确会报错,报错再处理也OK:
类似这样的错误:
BASH
Record 49: Rejected - Error on table xxxx, column xxdate.
ORA-01861: literal does not match format string
Help: https://docs.oracle.com/error-help/db/ora-01861/
举例:常用的TIMESTAMP和DATE声明格式参考:
bash
某某时间 TIMESTAMP "YYYY/MM/DD HH24:MI:SS.FF3",
某某日期 DATE "YYYY/MM/DD",
某某客户,某某数量,某某地点
到这里,一般的CSV文件基本上都能搞定入库。
3.CSV数据预处理与优化技巧
笔者遇到还有报错的情况,本质是因为,某某列的内容有换行。
虽然该列被"包含,但是sqlldr没能解析正确,就是这里折腾了很久。
包括各种问豆包、ChatGPT、Grok等模型,都没有给出正确答案,产生各种幻觉,即使我已经把问题描述的很清楚,也给了最小示例。
最终让他们给我官方文档的链接,看文档才发现应该在控制文件中如此设置:
去掉历史常用的这个写法,改成处理带嵌入换行的CSV:
-- FIELDS TERMINATED BY ',' OPTIONALLY ENCLOSED BY '"' -- 历史写法
FIELDS CSV WITH EMBEDDED  -- 处理带嵌入换行的CSV
终于不报这个错误了。
4.应对超长字符的实用解决方案
上面处理完,绝大部分数据都能入库成功了。
但是还发现该列仍有少量数据没导入成功,排查发现是因为字符过长导致。虽然表中该列的定义是CLOB,不过看起来sqlldr还是默认当做字符串处理的。
因为这里数据过长的,实际字符串也没有超过4000的,所以直接指定下即可。
BASH
c06 CHAR(4000), -- 显示指定手工声明直接定义CHAR(4000),终于成功导入所有行。
5.总结
其实这里遇到的每个问题都不大,但是混杂在一起时,就容易迷失方向。
笔者最终采用最小化测试用例,逐一排查依次解决的方式,终于成功导入了所有数据。
总结就是:
-
1.要注意处理文件特殊字符,尤其针对不同平台的换行符。
-
2.本次经验,给出的控制文件最终示例,
vi 4.ctl内容如下:
bash
OPTIONS (SKIP=1)  -- 跳过表头行
LOAD DATA
INFILE '4-xxx.csv'
TRUNCATE INTO TABLE your_table_name
FIELDS CSV WITH EMBEDDED -- 处理带嵌入换行的CSV效果很好
TRAILING NULLCOLS
(
ID,
start_date TIMESTAMP "YYYY/MM/DD HH24:MI:SS.FF3",  -- 时间TIMESTAMP指定
c03 DATE "YYYY/MM/DD", -- 时间DATE指定
c06 CHAR(4000), -- 超长字符定义
c10,c_level --其他普通列正常无需指定,快速通过CSV文件中的表头复制
)- 3.导入命令示例,尽可能简化命名,方便排查问题:
bash
$ sqlldr user/password@service_name control=4.ctl log=4.log尽管这只是使用一个Oracle小工具的微末之事,但在各路大模型都无法给出正解的当下,为这样一个具体而微的问题留下清晰的注脚,或许正是技术记录在AI时代新的意义所在。