文章目录
- CIFAR-10
- 具体操作
- 加速训练
- 进一步优化,提高模型准确率
-
-
- [第一:加宽加深模型 (升级大脑) ------ 最关键](#第一:加宽加深模型 (升级大脑) —— 最关键)
- 第二:数据增强 (Data Augmentation)
- 第三:换个更聪明的优化器
- 背景知识补充
-
- [1. Batch Normalization (BN):**"流水线质检员"**](#1. Batch Normalization (BN):“流水线质检员”)
- [3. Dropout:**"特种兵抗压训练"**](#3. Dropout:“特种兵抗压训练”)
- 完整代码
-
CIFAR-10
玩一玩机器学习的图像识别,使用CIFAR-10数据集
github仓库地址:https://github.com/0xlally/CIFAR-10-
数据集
数据集来源于https://www.cs.toronto.edu/\~kriz/cifar.html
如果直接下载 Python 版本(最常用),你会得到一个 Python Pickle (cPickle) 格式的文件。
它的数据结构并不是直接的图片文件(如 .jpg),而是压缩后的数组。这里有三个关键点需要注意,很多初学者会在这里卡住:
数据形状 (Shape) : 网页提到 data 是一个 10000x3072 的 numpy 数组。
-
10000 代表这一个批次有 10,000 张图。
-
3072 代表一张图的像素点总数。怎么来的?
32(宽)×32(高)×3(颜色通道 RGB)=3072
通道排列顺序 (Channel Order) : 这是最容易出错的地方。这 3072 个数字不是 像我们通常图片格式那样 (R, G, B), (R, G, B)... 交替排列的。 网页明确指出:前 1024 个是红 ® ,接下来 1024 个是绿 (G) ,最后 1024 个是蓝 (B)。
- 这意味着如果你直接把它 reshape 成
(32, 32, 3),图片看起来会是一团乱码。你需要先 reshape 成(3, 32, 32),然后再转置(Transpose)。
标签 (Labels) : labels 是一个包含 0-9 数字的列表,对应 10 个类别(飞机、汽车、鸟、猫等)。你需要根据 batches.meta 文件将数字映射回文字名称。
然而后续使用pytorch框架时,发现他有自带的用于下载数据集的代码,不需要提前下载
整体步骤
要做这个项目,我建议遵循以下四个阶段:
数据加载与预处理 (Data Loading)
- 任务:把网页上描述的那个
10000x3072的数组,转换成你的模型能读懂的 Tensor(张量)。 - 关键操作:归一化(Normalization),通常把像素值从 0-255 缩放到 0-1 或 -1 到 1 之间。
模型搭建 (Model Architecture)
- 对于图像,标准的做法是使用 卷积神经网络 (CNN)。
- 结构:卷积层 (提取特征) -> 池化层 (压缩特征) -> 全连接层 (分类)。
训练 (Training)
- 定义损失函数(CrossEntropyLoss,因为是多分类)。
- 选择优化器(SGD 或 Adam)。
- 循环迭代:前向传播 -> 计算误差 -> 反向传播更新权重。
测试与评估 (Evaluation)
- 使用测试集(test batch)查看准确率。
具体操作
数据处理
归一化
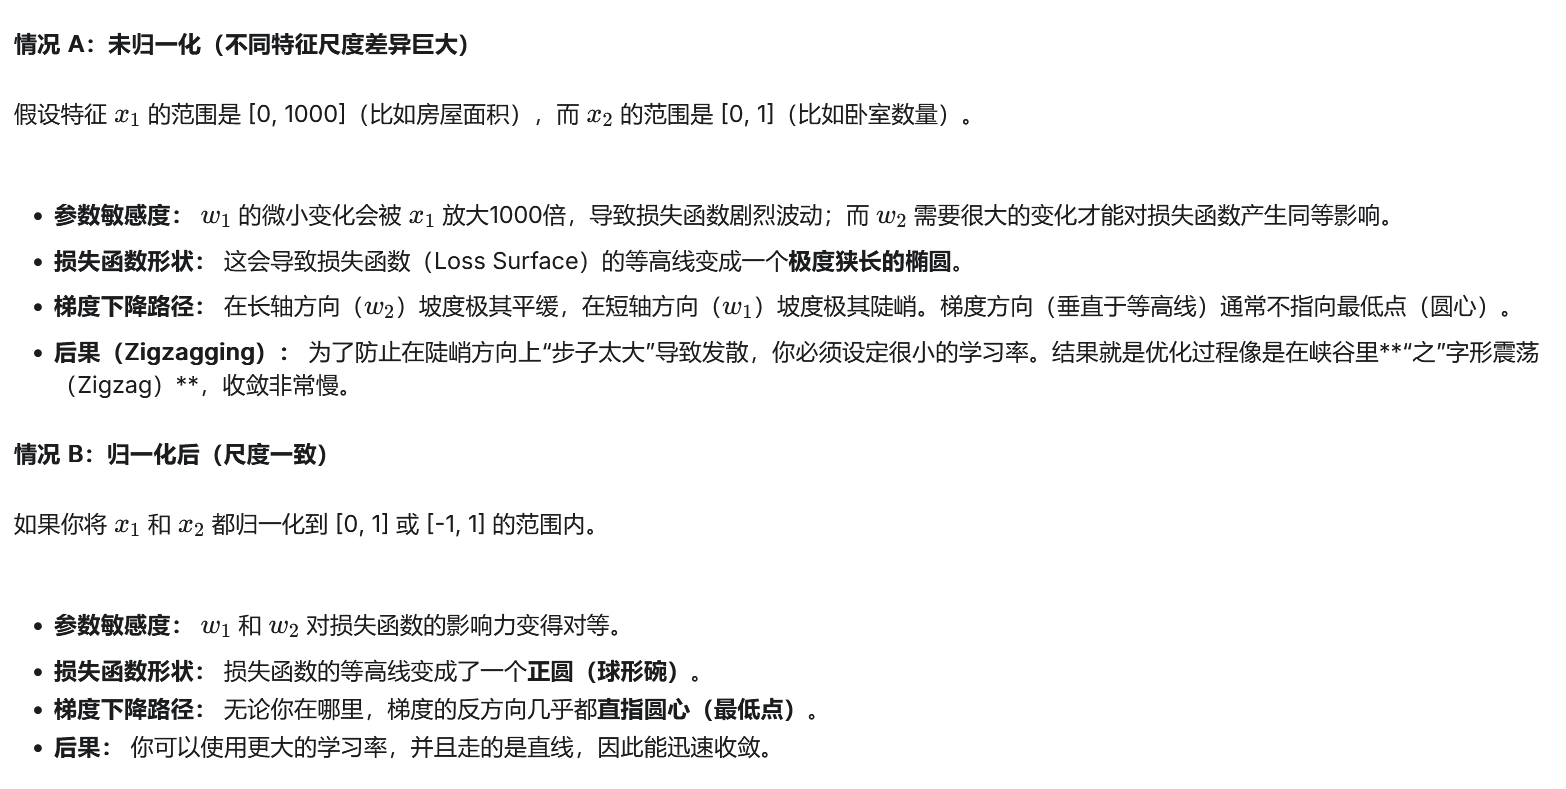
其实,把 0-255 变成 0-1(或者 -1 到 1),最主要的原因是为了让模型"学"得更快、更稳。
这就好比你在山里找路下山(我们在寻找损失函数的最低点):
- 不归一化 (0-255):这座山的地形可能会变得非常畸形------像一个又细又长的峡谷。你每走一步都得非常小心(学习率必须很小),否则很容易撞到墙壁或者走回头路。
- 归一化 (0-1) :地形会变成一个比较规则的圆形碗。你可以迈开大步直接冲向谷底,训练速度会快很多。
举个例子,200*0.01和1*0.01所产生的数值差异是很大的,归一化就是在减小这种极端变化的情况
定义数据预处理 (Transforms)
通常我们需要做两个核心操作:
- 把图片数据转换成 PyTorch 能处理的格式。
- 标准化(Normalize)。
在 PyTorch 的 torchvision.transforms 工具箱里,有一个最常用的工具叫 transforms.ToTensor()。
transforms.ToTensor() 会自动把像素值除以 255,将它们缩放到 0, 1 的范围内。
但为了让数据分布更符合标准正态分布(加速收敛),我们通常希望把范围进一步调整到 -1, 1 。这时候就需要用到 transforms.Normalize。
import torch
import torchvision
import torchvision.transforms as transforms

# 定义预处理流程
transform = transforms.Compose([
    transforms.ToTensor(),  # 第一步:转为 Tensor 并归一化到 [0, 1]
    transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5)) # 第二步:标准化
])

# 下载并加载训练集
trainset = torchvision.datasets.CIFAR10(root='./data', train=True,
                                        download=True, transform=transform)
trainloader = torch.utils.data.DataLoader(trainset, batch_size=4,
                                          shuffle=True, num_workers=2)

transforms.Normalize((M1, M2, M3), (S1, S2, S3))- 第一组
(0.5, 0.5, 0.5):均值 (Mean)M1 = 0.5对应 R (红) 通道的均值M2 = 0.5对应 G (绿) 通道的均值M3 = 0.5对应 B (蓝) 通道的均值
- 第二组
(0.5, 0.5, 0.5):标准差 (Std)S1 = 0.5对应 R (红) 通道的标准差- 同理对应 G 和 B。
搭建模型
搞定了数据加载,现在的核心任务是搭建卷积神经网络 (CNN)。
CIFAR-10 的图片尺寸比较小 (32×32)。一个经典的 CNN 结构通常像是"夹心饼干":一层卷积(提取特征),一层池化(压缩尺寸),再一层卷积......最后拉平(Flatten)连接到全连接层进行分类。
先做一些背景知识的了解
什么是池化
你可以把池化想象成是在做**"浓缩"或者"马赛克化"**。
2×2 的最大池化(Max Pooling)就是把图片切成无数个 2×2 的小方块(每块有4个像素)。在每个小方块里,它只保留最大的那个数值,扔掉其他三个像素。
- 目的:减少数据量(让图片变小,计算更快),同时保留最显著的特征(比如保留最亮的边缘)。
什么是卷积
想象你在一间漆黑的屋子里,墙上挂着一幅巨大的画(这就是我们的输入图片 )。 你手里拿了一个手电筒 (这就是卷积核 或者叫过滤器 Filter)。
这个手电筒有两个特点:
- 光圈很小:它一次只能照亮画上的一小块区域(比如 3×3 的像素区域)。
- 有特殊的"镜片" :这个镜片不是透明的,而是上面刻着某种特定的图案(比如一条竖线,或者一个直角)。
卷积的过程 ,就是你拿着手电筒,从画的左上角 开始,一格一格地往右下角移动(扫描)。
- 当你手电筒照到的地方,如果画上的内容和镜片上的图案很像 ,手电筒就会亮红灯(输出一个很大的数值)。
- 如果照到的地方和图案完全不像,手电筒就不亮(输出 0 或者很小的数值)。
2. 为什么要这么做?(找特征)
这就是卷积的核心目的:寻找特征。
- 如果是普通的神经网络(全连接),它是把整张图一次性"吞"进去,太乱了。
- 卷积层是派了一堆"侦探"去局部扫描。
回到代码中的 nn.Conv2d(3, 6, 5):
- 3 (Input Channels): 因为图片是彩色的(RGB),所以我们的手电筒比较厚,要同时透过红、绿、蓝三层来看。
- 5 (Kernel Size): 手电筒的光圈大小是 5×5 个像素。
- 6 (Output Channels) : 这是最关键的! 为什么输出变成了 6?
这意味着我们派出了 6 个拿不同手电筒的侦探:
- 侦探 A 的手电筒专门找"横线"。
- 侦探 B 的手电筒专门找"竖线"。
- 侦探 C 的手电筒专门找"圆弧"。
- ...
- 侦探 F 的手电筒专门找"颜色突变"。
理解了卷积(提取特征)和池化(压缩),我们就可以搭建一个经典的 CNN 网络了。
在 PyTorch 里,我们需要继承 nn.Module 并填写两个部分:
-
__init__:定义你要用的层(比如卷积层、池化层、全连接层)。 -
forward:连接这些层,规定数据流动的顺序。import torch.nn as nn
import torch.nn.functional as Fclass Net(nn.Module):
def init(self):
super(Net, self).init()
# 1. 卷积层 1: 输入3个通道(RGB), 输出6个通道, 卷积核大小 5x5
self.conv1 = nn.Conv2d(3, 6, 5)
# 2. 池化层: 2x2 最大池化
self.pool = nn.MaxPool2d(2, 2)
# 3. 卷积层 2: 输入6个通道, 输出16个通道, 卷积核大小 5x5
self.conv2 = nn.Conv2d(6, 16, 5)# 4. 全连接层 (Fully Connected Layers) # 这里的 16 * 5 * 5 是怎么算出来的?这是新手最容易卡住的地方 self.fc1 = nn.Linear(16 * 5 * 5, 120) self.fc2 = nn.Linear(120, 84) self.fc3 = nn.Linear(84, 10) # 最后输出10个分类 def forward(self, x): # 数据流向:卷积 -> 激活函数(ReLU) -> 池化 x = self.pool(F.relu(self.conv1(x))) x = self.pool(F.relu(self.conv2(x))) # 展平 (Flatten): 把立体的特征图拉成一条直线,才能喂给全连接层 x = torch.flatten(x, 1) x = F.relu(self.fc1(x)) x = F.relu(self.fc2(x)) x = self.fc3(x) return xnet = Net()
关键点解析:那个 16 * 5 * 5 是怎么来的?
这是搭建网络时的数学题:
- 原始图片: 32×32
- 经过 Conv1 (kernel=5): 像素减少 4 个 (5−1) →28×28
- 经过 Pool (/2): →14×14
- 经过 Conv2 (kernel=5): 像素再减少 4 个 →10×10
- 经过 Pool (/2): →5×5
因为 Conv2 输出是 16 个通道,所以最后的数据体积是 16×5×5。
在代码流程里:
-
卷积层提取出了 16×5×5=400 个特征值。
-
fc1(大脑皮层第一层):把这 400 个特征拿来进行综合分析,转化成 120 个更高级的特征。 -
fc2(大脑皮层第二层):把 120 个特征再浓缩成 84 个。 -
fc3(输出层) :把 84 个特征最终映射到 10 个分类上(飞机、汽车、鸟...)。x = F.relu(self.fc1(x)) # 第一步:思考 + 激活
x = F.relu(self.fc2(x)) # 第二步:思考 + 激活
x = self.fc3(x) # 第三步:最终输出分数
这里还有一个细节: 前两层 fc 后面都加了 F.relu(激活函数),这是为了给网络加入非线性 ,让它能处理复杂的逻辑。 但在最后一层 fc3 后面,通常不加 ReLU。因为最后一层输出的是每一类的"得分",这个得分也就是可以是负数(代表可能性极低),如果加了 ReLU 变成 0,就丢失信息了。
损失函数和优化器
optimizer.zero_grad() (梯度清零)
- 为什么? PyTorch 默认会把梯度"累加"。这就像你在黑板上做题,做下一道题之前,必须先把上一道题的演算过程擦干净,否则字叠在一起就乱套了。
outputs = net(inputs) (前向传播)
- 考试:把图片(试卷)喂给网络,网络经过层层计算,吐出预测结果(outputs)。
loss = criterion(outputs, labels) (计算损失)
- 打分:判卷老师对比"模型的预测"和"真实标签",算出一个分数(Loss)。Loss 越小,说明答得越好。
loss.backward() (反向传播)
- 找原因:这是深度学习的魔法时刻。PyTorch 会自动计算"梯度"。
- 通俗地说,它会分析:为了让 Loss 变小,每一个神经元的权重应该"变大一点"还是"变小一点"?这个方向信息就叫梯度。
optimizer.step() (更新参数)
-
改正:补习老师登场。它根据刚才算出来的梯度,真正地去修改模型里的权重参数。
-
执行完这一步,模型就比上一秒钟聪明了一点点。
import torch.optim as optim
1. 定义损失函数
criterion = nn.CrossEntropyLoss()
2. 定义优化器
net.parameters() 告诉优化器我们要更新哪些参数
lr=0.001 是学习率 (步子大小)
momentum=0.9 是动量 (惯性)
optimizer = optim.SGD(net.parameters(), lr=0.001, momentum=0.9)
for epoch in range(2): # loop over the dataset multiple times (训练 2 轮)
  running_loss = 0.0
  for i, data in enumerate(trainloader, 0):
      # data 中包含图片 (inputs) 和标签 (labels)
      inputs, labels = data

      # --- 核心动作开始 ---

      # 1. 梯度清零
      optimizer.zero_grad()

      # 2. 前向传播 (考试)
      outputs = net(inputs)

      # 3. 计算误差 (对答案)
      loss = criterion(outputs, labels)

      # 4. 反向传播 (找原因) + 更新权重 (改正)
      loss.backward()
      optimizer.step()

      # --- 核心动作结束 ---

      # 打印日志
      running_loss += loss.item()
      if i % 2000 == 1999:    # print every 2000 mini-batches
          print(f'[{epoch + 1}, {i + 1:5d}] loss: {running_loss / 2000:.3f}')
          running_loss = 0.0
print('Finished Training')
测试与评估
outputs = net(images)输入:一批测试图片(比如 4 张)。
输出 :一个形状为 (4, 10) 的矩阵。每一行对应一张图,包含 10 个数字(代表 10 个类别的得分)。
_, predicted = torch.max(outputs.data, 1)outputs.data:取出得分数据。
参数 1 :指定在维度 1(列的方向,即横向)上寻找最大值。因为每一行代表一张图的 10 个分类得分,我们要看在这 10 个分里哪个最高。
返回值 :torch.max 会返回两个张量:
-
最大值本身 (比如 5.1 分)。我们不关心分数具体是多少,所以用下划线
_丢弃它。 -
最大值的索引 (比如第 3 个位置)。这个索引(0-9)就代表模型预测的类别 ID 。我们将它赋值给
predicted。torch.no_grad() 非常重要!
因为测试时不需要算梯度,这能省下大量内存和计算时间
with torch.no_grad():
for data in testloader:
images, labels = data
outputs = net(images)# 核心操作:找出得分最高的那个类别的编号 # outputs.data 是那10个分数 # 1 代表我们在"行"方向上找最大值 # max函数会返回两个值:(最大分数, 最大分数的索引) # 我们只关心索引(predicted),所以第一个用 _ 忽略掉 _, predicted = torch.max(outputs.data, 1) total += labels.size(0) correct += (predicted == labels).sum().item()print(f'Accuracy of the network on the 10000 test images: {100 * correct / total} %')
labels.size(0) :获取当前批次的样本数量(例如 batch_size 是 4,这里就是 4),加到 total 总数里。
predicted == labels :将模型预测的类别 ID 与真实标签 ID 进行逐一对比。结果是一个布尔张量,如 [True, False, True, True](即 [1, 0, 1, 1])。
.sum():将上面的 1 加起来(例如结果是 3),表示这一批猜对了 3 个。
.item() :把张量格式的数值 3 转换成标准的 Python 数字 3,以便累加到 correct 变量中。
加速训练
将模型放到gpu上,这一段加到main函数的最开头
# 检测是否有可用的 GPU
device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
print(f'当前使用的设备: {device}')
找到 net = Net() 这一行,在后面加一行:
net = Net()
net.to(device)  # <--- 关键代码:把模型搬到 GPU
模型在 GPU 上了,但数据加载器(DataLoader)读出来的数据默认还在内存(CPU)里。CPU 的数据不能直接喂给 GPU 的模型,否则会报错。
你需要进入训练循环 和测试循环,把每一批读进来的图片和标签也都搬过去。
for i, data in enumerate(trainloader, 0):
        # 原始代码:inputs, labels = data

        # 修改后的代码:把数据拆开并搬运
        inputs, labels = data[0].to(device), data[1].to(device)

        optimizer.zero_grad()
        outputs = net(inputs) # 此时 inputs 已经在 GPU 上了
        loss = criterion(outputs, labels)
        loss.backward()
        optimizer.step()
保存模型
只保存模型网络中的参数
# 定义保存路径 (后缀名通常用 .pth 或 .pt)
PATH = './cifar_net.pth'

# 核心代码:只保存模型的"参数字典" (state_dict)
# 它本质上就是把每一层的权重矩阵存成了一个字典文件
torch.save(net.state_dict(), PATH)

print(f"模型已保存至 {PATH}")
怎么加载?
你需要做的是:
-
重新定义网络结构 (必须让 PyTorch 知道
Net是个什么东西)。 -
实例化网络。
-
加载参数。
1. 自动检测当前机器的最佳设备
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
2. 加载模型
map_location=device 这一招非常灵
它会自动判断:如果当前只有CPU,就强制把原本在GPU上的模型拉回到CPU
如果当前有GPU,它也会正确处理
net.load_state_dict(torch.load(path, map_location=device))
3. 确保模型实体也在该设备上 (双重保险)
net.to(device)
进一步优化,提高模型准确率
在当前的简单两层网络结构下,epoch为50,batch为64,通道数为6和16的背景下,我们只能达到
类别 plane : 73.50 %
类别   car : 76.10 %
类别  bird : 41.80 %
类别   cat : 43.40 %
类别  deer : 60.80 %
类别   dog : 53.40 %
类别  frog : 72.10 %
类别 horse : 79.50 %
类别  ship : 70.10 %
类别 truck : 68.80 %
核心问题在于:你的模型"脑容量"太小了(Underfitting)。 目前的网络只有 2 层卷积,通道数也只有 6 和 16。它就像让一个刚学会认字母的小学生去读《哈姆雷特》,它看不懂那么复杂的纹理细节(比如猫毛和狗毛的区别)。
第一:加宽加深模型 (升级大脑) ------ 最关键
原来的模型太瘦了(通道少)。现代 CNN 通常起步就是 32 或 64 个通道。 我们需要:
-
增加卷积层:从 2 层加到 3 层。
-
增加通道数 :
3 -> 6 -> 16改为3 -> 32 -> 64 -> 128。 -
引入 Batch Normalization (BN):这是神器,能让训练快几倍且更稳定。
class BetterNet(nn.Module):
def init(self):
super(BetterNet, self).init()# 第一层块: 3 -> 32 # 加了 BatchNorm2d,这是提升准确率的神器 self.conv1 = nn.Conv2d(3, 32, 3, padding=1) self.bn1 = nn.BatchNorm2d(32) # 第二层块: 32 -> 64 self.conv2 = nn.Conv2d(32, 64, 3, padding=1) self.bn2 = nn.BatchNorm2d(64) # 第三层块: 64 -> 128 self.conv3 = nn.Conv2d(64, 128, 3, padding=1) self.bn3 = nn.BatchNorm2d(128) self.pool = nn.MaxPool2d(2, 2) # 全连接层 # 经过3次池化(32->16->8->4),且最后一层通道是128 # 所以输入是 128 * 4 * 4 self.fc1 = nn.Linear(128 * 4 * 4, 512) self.fc2 = nn.Linear(512, 10) # Dropout: 防止过拟合,扔掉一些神经元 self.dropout = nn.Dropout(0.5)
第二:数据增强 (Data Augmentation)
让模型多见见世面。现在的模型看一张图是死记硬背。我们可以让图片在训练时随机翻转 、随机裁剪。 这样模型就会明白:"头朝左的猫是猫,头朝右的猫也是猫"。
# 训练集:加了随机翻转和随机裁剪,增加难度,防止死记硬背
transform_train = transforms.Compose([
transforms.RandomHorizontalFlip(), # 50%概率水平翻转
transforms.RandomCrop(32, padding=4), # 随机裁剪
transforms.ToTensor(),
transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))
])第三:换个更聪明的优化器
SGD 对学习率很敏感。我们换成 Adam,它自带自适应学习率,通常收敛更快。
optimizer = optim.Adam(net.parameters(), lr=0.001)背景知识补充
1. Batch Normalization (BN):"流水线质检员"
它是什么? 在深度神经网络中,数据经过每一层计算后,数值的分布会发生变化(有的变大,有的变小,有的偏左,有的偏右)。这会让下一层的神经元非常"头大",因为它们每次都要重新适应新的数据分布,导致训练很慢,甚至练不动。
BN 做什么? BN 层就像一个极其严格的质检员 ,被安插在每一个卷积层和激活函数之间。 它的工作是:强行把流过来的数据重新整理,让它们的平均值变成 0,方差变成 1(标准正态分布)。
生活类比: 想象你在教一个班级(神经网络),学生是上一层的输出。
- 没有 BN:第一天来的学生全是考 10 分的差生,你得用教差生的方法;第二天来的全是考 100 分的学霸,你得换教法。你每天都在适应学生,教学进度非常慢。
- 有 BN :BN 强制把学生按能力分班,或者标准化他们的成绩。不管上一层送来什么学生,到了你这一层,看起来都差不多。你只需要专注于你的逻辑教学,不需要一直调整适应。
作用:
- 极大加快训练速度(你可以开更大的学习率)。
- 让模型更稳定,不容易梯度消失或爆炸。
SGD (Stochastic Gradient Descent):手动挡车
- 原理:看准下山的方向,迈出固定的一步。
- 缺点 :
- 死板:不管地形是陡峭还是平缓,它的步子大小(学习率)通常是固定的。
- 怕坑:容易困在局部最低点(Local Minima)爬不出来。
- 难调:非常依赖你手动设置的学习率,设大了震荡,设小了走不动。
Adam (Adaptive Moment Estimation):自动挡越野车 Adam 结合了两个强大的机制:
- 动量 (Momentum) :惯性。像一个重铁球滚下山,即使遇到小坑,借着惯性也能冲过去。
- 自适应学习率 (Adaptive LR) :智能步幅 。
- 路平坦时(梯度小),它会自动迈大步子加速。
- 路陡峭时(梯度大),它会自动迈小步子防摔倒。
为什么新手首选 Adam?
- 省心 :Adam 对学习率不敏感。通常设个
0.001就能跑得很好。而 SGD 可能需要你反复尝试0.1,0.01,0.005... - 收敛快:在训练初期,Adam 的下降速度通常吊打 SGD。
3. Dropout:"特种兵抗压训练"
它是什么? Dropout 是一种防止过拟合(Overfitting)的手段。过拟合就是模型"死记硬背"了训练集的图片,导致考试(测试集)时遇到稍微不一样的图就不会了。
Dropout 做什么? 在训练过程中,它会随机关掉(扔掉) 一部分神经元(比如 50%)。 这意味着:每一次训练,网络都有一半的神经元在"罢工"。
生活类比: 想象在一个项目组里:
- 没有 Dropout:所有人都依赖组里的大神(某个强特征)。如果有问题,都问大神。一旦大神生病了(测试集里没有这个特征),整个项目组就垮了。
- 有 Dropout :轮流强制让组员休假。大神今天强制休假,其他人被迫要学会独立解决问题;明天另一波人休假...
- 结果 :经过这种"残缺"的训练,组里每个人(每个神经元)都变得很强,不再依赖某一个特定的线索。整个团队的鲁棒性极高。
注意: Dropout 只在训练(Train)时开启 。 在测试(Test/Eval)时,所有人都要回来上班(所有神经元全连接),以发挥最强实力。 这也是为什么我在代码里强调 net.train() 和 net.eval() 的原因。
完整代码
完成了这一步,在大多数类的准确率就可以达到百分之九十了
>> 总体准确率: 84.87 %
正在分析每一类的表现...
类别 plane : 89.70 %
类别 car : 93.70 %
类别 bird : 77.00 %
类别 cat : 67.20 %
类别 deer : 81.80 %
类别 dog : 77.10 %
类别 frog : 90.30 %
类别 horse : 90.20 %
类别 ship : 90.00 %
类别 truck : 91.70 %import torch
import torchvision
import torchvision.transforms as transforms
import torch.nn as nn
import torch.nn.functional as F
import torch.optim as optim
def main():
device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
print(f'Training on: {device}')
# ==========================================
# 策略 1: 数据增强 (Data Augmentation)
# ==========================================
# 训练集:加了随机翻转和随机裁剪,增加难度,防止死记硬背
transform_train = transforms.Compose([
transforms.RandomHorizontalFlip(), # 50%概率水平翻转
transforms.RandomCrop(32, padding=4), # 随机裁剪
transforms.ToTensor(),
transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))
])
# 测试集:保持原样,只做标准化
transform_test = transforms.Compose([
transforms.ToTensor(),
transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))
])
trainset = torchvision.datasets.CIFAR10(root='./data', train=True,
download=True, transform=transform_train)
# Batch Size 建议 64 或 128
trainloader = torch.utils.data.DataLoader(trainset, batch_size=64,
shuffle=True, num_workers=2)
testset = torchvision.datasets.CIFAR10(root='./data', train=False,
download=True, transform=transform_test)
testloader = torch.utils.data.DataLoader(testset, batch_size=64,
shuffle=False, num_workers=2)
# ==========================================
# 策略 2: 定义更深更宽的网络 (Better Architecture)
# ==========================================
class BetterNet(nn.Module):
def __init__(self):
super(BetterNet, self).__init__()
     # 第一层块: 3 -> 32
     # 加了 BatchNorm2d,这是提升准确率的神器
     self.conv1 = nn.Conv2d(3, 32, 3, padding=1)
     self.bn1 = nn.BatchNorm2d(32)

     # 第二层块: 32 -> 64
     self.conv2 = nn.Conv2d(32, 64, 3, padding=1)
     self.bn2 = nn.BatchNorm2d(64)

     # 第三层块: 64 -> 128
     self.conv3 = nn.Conv2d(64, 128, 3, padding=1)
     self.bn3 = nn.BatchNorm2d(128)

     self.pool = nn.MaxPool2d(2, 2)

     # 全连接层
     # 经过3次池化(32->16->8->4),且最后一层通道是128
     # 所以输入是 128 * 4 * 4
     self.fc1 = nn.Linear(128 * 4 * 4, 512)
     self.fc2 = nn.Linear(512, 10)

     # Dropout: 防止过拟合,扔掉一些神经元
     self.dropout = nn.Dropout(0.5)
def forward(self, x):
# Conv -> BN -> ReLU -> Pool
x = self.pool(F.relu(self.bn1(self.conv1(x))))
x = self.pool(F.relu(self.bn2(self.conv2(x))))
x = self.pool(F.relu(self.bn3(self.conv3(x))))
x = torch.flatten(x, 1)
x = F.relu(self.fc1(x))
x = self.dropout(x) # 在全连接层之间加 Dropout
x = self.fc2(x)
return x
net = BetterNet()
net.to(device)
# ==========================================
# 策略 3: 使用 Adam 优化器
# ==========================================
criterion = nn.CrossEntropyLoss()
# Adam 通常比 SGD 收敛更快,且对学习率不那么敏感
optimizer = optim.Adam(net.parameters(), lr=0.001)
# ==========================================
# 训练循环
# ==========================================
# 建议跑 20-30 个 Epoch 看看效果
for epoch in range(50):
net.train() # 确保开启训练模式(启用 Dropout/BN)
running_loss = 0.0
for i, data in enumerate(trainloader, 0):
inputs, labels = data[0].to(device), data[1].to(device)
optimizer.zero_grad()
outputs = net(inputs)
loss = criterion(outputs, labels)
loss.backward()
optimizer.step()
running_loss += loss.item()
# 这里的 200 是打印频率,你可以根据自己喜好改
if i % 200 == 199:
print(f'[Epoch: {epoch + 1}, Batch: {i + 1:5d}] loss: {running_loss / 200:.3f}')
running_loss = 0.0
print('Finished Training')
# 保存新模型
torch.save(net.state_dict(), './cifar_betternet.pth')
print("BetterNet 模型已保存")
if __name__ == '__main__':
main()import torch
import torchvision
import torchvision.transforms as transforms
import torch.nn as nn
import torch.nn.functional as F
# ==========================================
# 1. 网络结构定义 (必须与训练代码完全一致)
# ==========================================
class BetterNet(nn.Module):
def __init__(self):
super(BetterNet, self).__init__()
# 第一层块: 3 -> 32
self.conv1 = nn.Conv2d(3, 32, 3, padding=1)
self.bn1 = nn.BatchNorm2d(32)
# 第二层块: 32 -> 64
self.conv2 = nn.Conv2d(32, 64, 3, padding=1)
self.bn2 = nn.BatchNorm2d(64)
# 第三层块: 64 -> 128
self.conv3 = nn.Conv2d(64, 128, 3, padding=1)
self.bn3 = nn.BatchNorm2d(128)
self.pool = nn.MaxPool2d(2, 2)
# 全连接层 (输入是 128 * 4 * 4)
self.fc1 = nn.Linear(128 * 4 * 4, 512)
self.fc2 = nn.Linear(512, 10)
# Dropout
self.dropout = nn.Dropout(0.5)
def forward(self, x):
# Conv -> BN -> ReLU -> Pool
x = self.pool(F.relu(self.bn1(self.conv1(x))))
x = self.pool(F.relu(self.bn2(self.conv2(x))))
x = self.pool(F.relu(self.bn3(self.conv3(x))))
x = torch.flatten(x, 1)
x = F.relu(self.fc1(x))
# 注意:虽然这里写了 dropout,但在 net.eval() 模式下它会自动失效
x = self.dropout(x)
x = self.fc2(x)
return x
def main():
# ==========================================
# 2. 准备工作
# ==========================================
device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
print(f'当前测试运行设备: {device}')
# 测试集的预处理(不需要翻转和裁剪,只要归一化)
transform_test = transforms.Compose([
transforms.ToTensor(),
transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))
])
testset = torchvision.datasets.CIFAR10(root='./data', train=False,
download=True, transform=transform_test)
testloader = torch.utils.data.DataLoader(testset, batch_size=100,
shuffle=False, num_workers=2)
classes = ('plane', 'car', 'bird', 'cat',
'deer', 'dog', 'frog', 'horse', 'ship', 'truck')
# ==========================================
# 3. 加载模型
# ==========================================
# 注意文件名要和你训练保存的名字一致
PATH = './cifar_betternet.pth'
print(f"正在加载模型: {PATH} ...")
net = BetterNet()
try:
net.load_state_dict(torch.load(PATH, map_location=device))
except FileNotFoundError:
print(f"错误:找不到文件 {PATH}。请先运行训练脚本生成模型。")
return
except RuntimeError as e:
print(f"加载失败,可能是网络结构定义不匹配。\n详细错误: {e}")
return
net.to(device)
# 开启评估模式!这会冻结 BN 层和关闭 Dropout,至关重要
net.eval()
# ==========================================
# 4. 评估总体准确率
# ==========================================
print("开始评估...")
correct = 0
total = 0
with torch.no_grad():
for data in testloader:
images, labels = data[0].to(device), data[1].to(device)
outputs = net(images)
_, predicted = torch.max(outputs.data, 1)
total += labels.size(0)
correct += (predicted == labels).sum().item()
print(f'>> 总体准确率: {100 * correct / total:.2f} %')
# ==========================================
# 5. 评估每一类的准确率
# ==========================================
print("\n正在分析每一类的表现...")
class_correct = list(0. for i in range(10))
class_total = list(0. for i in range(10))
with torch.no_grad():
for data in testloader:
images, labels = data[0].to(device), data[1].to(device)
outputs = net(images)
_, predicted = torch.max(outputs, 1)
c = (predicted == labels).squeeze()
for i in range(len(labels)):
label = labels[i]
class_correct[label] += c[i].item()
class_total[label] += 1
for i in range(10):
acc = 100 * class_correct[i] / class_total[i]
print(f'类别 {classes[i]:>5s} : {acc:.2f} %')
if __name__ == '__main__':
main()后续想要进一步提升准确率,可以利用Res-Net18,更改亮度,对比度使模型强行记住形状等策略