人工智能之数据分析 Pandas
第三章 DataFrame
文章目录
- [人工智能之数据分析 Pandas](#人工智能之数据分析 Pandas)
- 前言
- [一、什么是 DataFrame?](#一、什么是 DataFrame?)
- [二、DataFrame 的核心特性](#二、DataFrame 的核心特性)
- [三、创建 DataFrame 的 6 种主要方式](#三、创建 DataFrame 的 6 种主要方式)
- [1. 从字典(最常见)](#1. 从字典(最常见))
- [2. 从列表的列表(嵌套列表)](#2. 从列表的列表(嵌套列表))
- [3. 从 Series 字典](#3. 从 Series 字典)
- [4. 从 NumPy 数组](#4. 从 NumPy 数组)
- [5. 从外部文件(实际中最常用)](#5. 从外部文件(实际中最常用))
- [6. 创建空 DataFrame](#6. 创建空 DataFrame)
- [四、DataFrame 的关键属性](#四、DataFrame 的关键属性)
- 五、数据访问与选择(重点!)
- [1. 选择列](#1. 选择列)
- [2. 选择行](#2. 选择行)
- [3. 同时选择行列](#3. 同时选择行列)
- [4. 布尔索引(条件筛选)](#4. 布尔索引(条件筛选))
- 六、常用数据操作
- [1. 添加列](#1. 添加列)
- [2. 删除行/列](#2. 删除行/列)
- [3. 重命名](#3. 重命名)
- [4. 排序](#4. 排序)
- [5. 缺失值处理](#5. 缺失值处理)
- [6. 描述性统计](#6. 描述性统计)
- 七、高级功能概览
- 八、注意事项与最佳实践
- 九、总结
- 后续
- 资料关注
前言
DataFrame 是pandas 中最常用的二维数据结构,用于处理二维表格型数据 (类似 Excel 表格或 SQL 表)。它是数据分析、清洗、探索和建模的基础工具。本文从定义、结构、创建方式、常用操作、高级功能等方面进行全面而深入的介绍。
一、什么是 DataFrame?
DataFrame 是一个带标签的二维异构数据结构,具有以下特点:
- 行(Rows):每行代表一个观测/记录(如一个人、一次交易)。
- 列(Columns):每列代表一个变量/特征(如姓名、年龄、收入),各列可为不同数据类型(int, float, str, bool 等)。
- 索引(Index):行标签,默认为从 0 开始的整数,但可自定义(如日期、ID)。
- 列名(Columns):列的标签,必须唯一(默认为字符串,但也可为其他可哈希类型)。
✅ 简单理解:DataFrame = 多个共享同一索引的 Series 组成的字典
二、DataFrame 的核心特性
| 特性 | 说明 |
|---|---|
| 二维表格结构 | 行 × 列,支持混合数据类型 |
| 自动对齐 | 运算时按行索引和列名自动对齐 |
| 缺失值支持 | 使用 NaN 表示缺失,不影响整体结构 |
| 灵活索引 | 支持 .loc(标签)、.iloc(位置)、布尔索引等多种访问方式 |
| 可扩展性强 | 易于添加/删除行、列,支持合并、连接、重塑等操作 |
| 与 NumPy 兼容 | 可通过 .values 获取底层 NumPy 数组 |
三、创建 DataFrame 的 6 种主要方式
1. 从字典(最常见)
python
import pandas as pd

data = {
    '姓名': ['张三', '李四', '王五'],
    '年龄': [25, 30, 35],
    '城市': ['北京', '上海', '广州']
}
df = pd.DataFrame(data)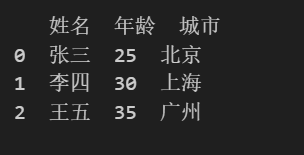
⚠️ 字典的 key → 列名,value(列表/数组)→ 列数据,长度必须一致。
2. 从列表的列表(嵌套列表)
python
data = [['张三', 25, '北京'],
        ['李四', 30, '上海'],
        ['王五', 35, '广州']]
df = pd.DataFrame(data, columns=['姓名', '年龄', '城市'])
3. 从 Series 字典
python
s1 = pd.Series([25, 30, 35], name='年龄')
s2 = pd.Series(['北京', '上海', '广州'], name='城市')
df = pd.DataFrame({'年龄': s1, '城市': s2})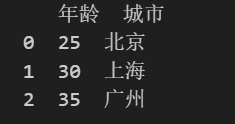
4. 从 NumPy 数组
python
import numpy as np
arr = np.random.randn(3, 2)
df = pd.DataFrame(arr, columns=['A', 'B'], index=['x', 'y', 'z'])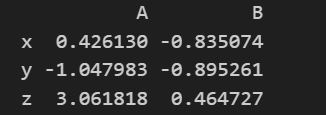
5. 从外部文件(实际中最常用)
python
# CSV
df = pd.read_csv('data.csv')

# Excel
df = pd.read_excel('data.xlsx', sheet_name='Sheet1')

# JSON
df = pd.read_json('data.json')
6. 创建空 DataFrame
python
df_empty = pd.DataFrame()
# 或指定列
df_empty = pd.DataFrame(columns=['姓名', '年龄'])
四、DataFrame 的关键属性
| 属性 | 说明 | 示例 |
|---|---|---|
.index |
行索引 | df.index |
.columns |
列名 | df.columns |
.values |
数据(NumPy 数组) | df.values |
.shape |
形状 (行数, 列数) |
df.shape → (3, 3) |
.dtypes |
每列的数据类型 | df.dtypes |
.size |
总元素数 | df.size |
.ndim |
维度(总是 2) | df.ndim |
.T |
转置 | df.T |
五、数据访问与选择(重点!)
1. 选择列
python
df['姓名']        # 返回 Series
df[['姓名', '年龄']]  # 返回 DataFrame(注意双括号)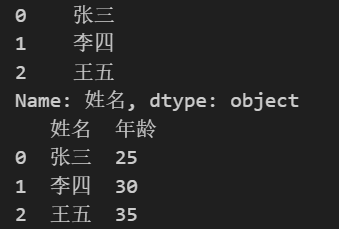
2. 选择行
-
按标签(推荐) :
pythondf.loc[0] # 第 0 行(标签为 0) df.loc[0:1] # 标签切片(包含末端) -
按位置(整数索引) :
pythondf.iloc[0] # 第 0 行(位置) df.iloc[0:2] # 位置切片(不包含末端)
3. 同时选择行列
python
df.loc[0, '姓名']           # 单个值
df.loc[0:1, ['姓名', '年龄']]  # 子集
df.iloc[0:2, 0:2]          # 位置方式
4. 布尔索引(条件筛选)
python
df[df['年龄'] > 30]                # 年龄大于 30 的行
df[(df['年龄'] > 25) & (df['城市'] == '上海')]  # 多条件(注意括号和 &)
六、常用数据操作
1. 添加列
python
df['性别'] = ['男', '女', '男']     # 直接赋值
df['年龄_明年'] = df['年龄'] + 1   # 基于现有列计算
2. 删除行/列
python
df.drop('姓名', axis=1)      # 删除列(axis=1)
df.drop(0, axis=0)           # 删除第 0 行(axis=0)
# 默认返回新对象,加 inplace=True 可原地修改
3. 重命名
python
df.rename(columns={'姓名': '名字'}, inplace=True)
df.rename(index={0: '第一行'}, inplace=True)
4. 排序
python
df.sort_values('年龄')        # 按"年龄"升序
df.sort_values(['城市', '年龄'], ascending=[True, False])
5. 缺失值处理
python
df.isnull()          # 判断是否为 NaN
df.dropna()          # 删除含 NaN 的行
df.fillna(0)         # 用 0 填充 NaN
6. 描述性统计
python
df.describe()        # 数值列的统计摘要(均值、标准差、分位数等)
df['年龄'].mean()    # 单列均值
七、高级功能概览
| 功能 | 方法/说明 |
|---|---|
| 分组聚合 | df.groupby('城市')['年龄'].mean() |
| 透视表 | pd.pivot_table(df, values='年龄', index='城市', aggfunc='mean') |
| 合并数据 | pd.concat([df1, df2]), pd.merge(df1, df2, on='key') |
| 重塑数据 | df.melt(), df.pivot(), df.stack(), df.unstack() |
| 时间序列 | 支持 DatetimeIndex,可进行重采样(resample)、移动窗口(rolling)等 |
| apply 函数 | df.apply(lambda x: x.max() - x.min())(按列/行应用函数) |
八、注意事项与最佳实践
-
避免链式赋值警告
❌
df[df['年龄']>30]['城市'] = '深圳'→ 可能无效✅ 使用
.loc:df.loc[df['年龄']>30, '城市'] = '深圳' -
复制 vs 视图
df2 = df是引用(修改 df2 会影响 df)df2 = df.copy()创建独立副本
-
性能优化
- 避免在循环中逐行操作,优先使用向量化运算
- 对大文件使用
chunksize分块读取
-
内存管理
- 使用
df.info()查看内存占用 - 可通过
astype()降低数据类型精度(如 int64 → int32)
- 使用
九、总结
DataFrame 是 Pandas 的灵魂:
- 它是结构化数据处理的"瑞士军刀";
- 结合 Series、索引、向量化操作,实现高效、简洁的数据分析;
- 几乎所有真实场景的数据(CSV、数据库、API 返回)最终都会转为 DataFrame 处理。
后续
python过渡项目部分代码已经上传至gitee,后续会逐步更新。
资料关注
公众号:咚咚王
gitee:https://gitee.com/wy18585051844/ai_learning
《Python编程:从入门到实践》
《利用Python进行数据分析》
《算法导论中文第三版》
《概率论与数理统计(第四版) (盛骤) 》
《程序员的数学》
《线性代数应该这样学第3版》
《微积分和数学分析引论》
《(西瓜书)周志华-机器学习》
《TensorFlow机器学习实战指南》
《Sklearn与TensorFlow机器学习实用指南》
《模式识别(第四版)》
《深度学习 deep learning》伊恩·古德费洛著 花书
《Python深度学习第二版(中文版)【纯文本】 (登封大数据 (Francois Choliet)) (Z-Library)》
《深入浅出神经网络与深度学习+(迈克尔·尼尔森(Michael+Nielsen)》
《自然语言处理综论 第2版》
《Natural-Language-Processing-with-PyTorch》
《计算机视觉-算法与应用(中文版)》
《Learning OpenCV 4》
《AIGC:智能创作时代》杜雨+&+张孜铭
《AIGC原理与实践:零基础学大语言模型、扩散模型和多模态模型》
《从零构建大语言模型(中文版)》
《实战AI大模型》
《AI 3.0》