在 Apache Flink 的状态计算中,状态主要分为以下两类:
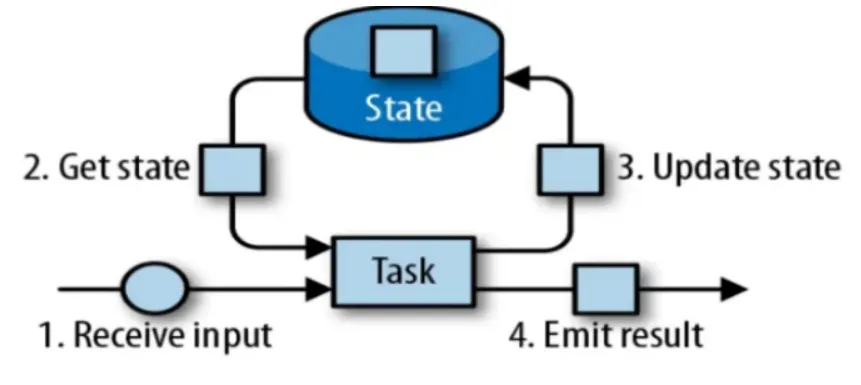
1. Keyed State
- 定义:与特定键(Key)关联的状态,每个键独立维护其状态数据。
- 特点 :
- 作用域为当前键,不同键的状态互不影响。
- 仅能在
KeyedStream的函数(如map()、flatMap())中访问。
- 存储结构 :
ValueState<T>:存储单值,例如: \\text{计数器}ListState<T>:存储列表,例如: \\text{窗口内事件列表}MapState<K, V>:存储键值对,例如: \\text{用户行为映射表}ReducingState<T>:聚合状态(已弃用,推荐用AggregatingState)
2. Operator State
- 定义:与算子实例(Operator Instance)绑定的状态,不依赖数据键。
- 特点 :
- 作用域为整个算子,所有输入数据共享同一状态。
- 可在非
KeyedStream的算子(如Source、Sink)中使用。
- 存储结构 :
ListState<T>:用于存储列表形式的状态(如 Kafka 偏移量)。BroadcastState<K, V>:用于广播状态至下游所有并行实例。
核心区别
| 特性 | Keyed State | Operator State |
|---|---|---|
| 作用域 | 按键分区 | 算子实例级 |
| 访问限制 | 仅限相同键的数据 | 所有输入数据均可访问 |
| 典型应用 | 窗口聚合、状态机(如 CEP) | 全局配置、源/接收器状态 |
状态作用域示意图
\\begin{array}{c\|c} \\text{Keyed State} \& \\text{Operator State} \\ \\hline \\begin{array}{c} \\text{Key=1} \\ \\downarrow \\ \\text{State A} \\ \\end{array} \& \\begin{array}{c} \\text{Operator} \\ \\downarrow \\ \\text{Global State} \\ \\end{array} \\ \\begin{array}{c} \\text{Key=2} \\ \\downarrow \\ \\text{State B} \\ \\end{array} \& \\end{array}
最佳实践
- Keyed State:适用于需要分区隔离的场景(如用户会话分析)。
- Operator State:适用于全局状态管理(如动态规则更新)。
通过合理选择状态类型,可优化资源利用并保障计算一致性。