作者:飞桨开发者技术专家 刘力
| 仅需一张消费级显卡,教你利用多模态大模型打造专属的日本漫画翻译神器。
一,引言:当AI遇上二次元
如果你曾尝试使用传统的 OCR 工具直接翻译一本未汉化的日本漫画(Manga),你可能会遇到令人抓狂的体验:文字识别乱码、气泡顺序错乱,尤其是那些 竖排(Vertical) 且字体夸张的拟声词,AI 往往视而不见。
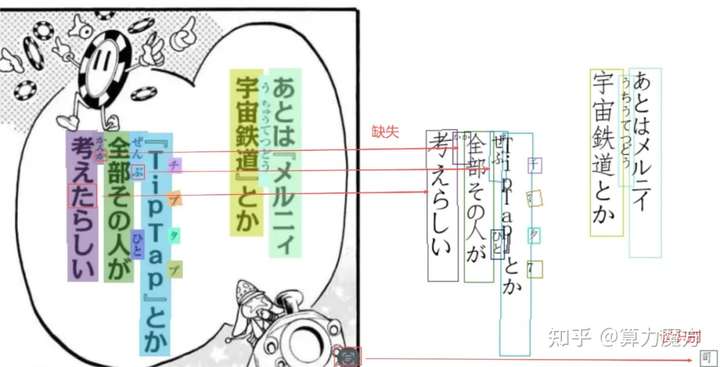
通用的 OCR 模型大多是针对文档、路牌或水平文本训练的。面对漫画中复杂的背景、垂直的阅读顺序以及手写体,标准模型往往显得力不从心。今天,我们将解决这个问题。我们不再使用传统的检测+识别架构,而是使用更前沿的 Vision-Language (VL) 模型------PaddleOCR-VL。我们将展示如何在仅有 12GB 显存的 NVIDIA RTX 3060 上,利用 BF16 精度和梯度累积技术,对这个强大的多模态模型进行监督微调(SFT)。
项目源码参考:https://github.com/openvino-book/PaddleOCR-VL-SFT-for-Japanese-Manga-on-RTX-3060二,为什么选择 PaddleOCR-VL?
1,多模态理解能力:传统的 OCR 将图片切分为小块进行识别,容易丢失上下文。PaddleOCR-VL 是一种视觉-语言模型,它能"看"懂整张图的语义,这对于理解漫画中气泡的阅读顺序(从右向左、从上向下)至关重要。
2,惊人的效果提升:根据我们的实测,在 RTX 3060 上微调后,精确匹配率 (Exact Match) 从基础模型的 9.0% 飙升至 64.4%,字符错误率 (CER) 降低了 80%。
|------------|--------|--------|----------|
| 指标 | 原始模型 | 微调后 | 变化 |
| 完全匹配率 | 9.0% | 64.4% | +55.4%⬆️ |
| 字符错误率(CER) | 55.41% | 10.88% | -80%⬇️ |
三,核心挑战:如何在 12GB 显存上训练大模型?
微调 VL 模型通常需要昂贵的 A100 显卡,但本教程的目标是让每个拥有 RTX 3060 (12GB) 的开发者都能跑通。
我们采用了一下技术组合来降低显存占用:
- BF16 混合精度:使用 BF16Trainer 配合 torch.amp.autocast,在保持精度的同时大幅减少显存占用。
- 梯度累积 (Gradient Accumulation):将 Batch Size 设为 1,但设置梯度累积步数为 16,从而模拟 Batch Size = 16 的训练效果。
- 梯度检查点 (Gradient Checkpointing):以计算换显存,进一步压缩内存需求。
四,实战指南:从零开始微调
第一步:环境搭建
1,克隆项目
git clone https://github.com/openvino-book/PaddleOCR-VL-SFT-for-Japanese-Manga-on-RTX-3060.git2,创建 conda 环境 (Python 3.11)
conda create -n manga-ocr python=3.11 -y
conda activate manga-ocr
3,安装项目依赖
注意:我们需要安装支持 CUDA 的 PyTorch 版本
pip install torch torchvision --index-url [https://download.pytorch.org/whl/cu118](https://download.pytorch.org/whl/cu118)
pip install -r requirements.txt
第二步:数据准备 (Manga109s)
我们需要高质量的漫画数据集。Manga109s 是学术界公认的日本漫画数据集,包含精确的文本框标注。
1,下载数据集:访问https://huggingface.co/datasets/hal-utokyo/Manga109-s 申请并下载 Manga109s_released_2023_12_07.zip。
2,解压与配置:
# 解压到项目根目录
unzip Manga109s_released_2023_12_07.zip -d .
# 配置环境变量
cp .env.example .env
# 确保 .env 文件中的 MANGA109_ROOT 指向解压后的文件夹
3,运行数据处理脚本: 该脚本会自动解析 XML 标注,裁剪出文本区域,生成适合 VL 模型训练的格式。
python prepare_manga109_data.py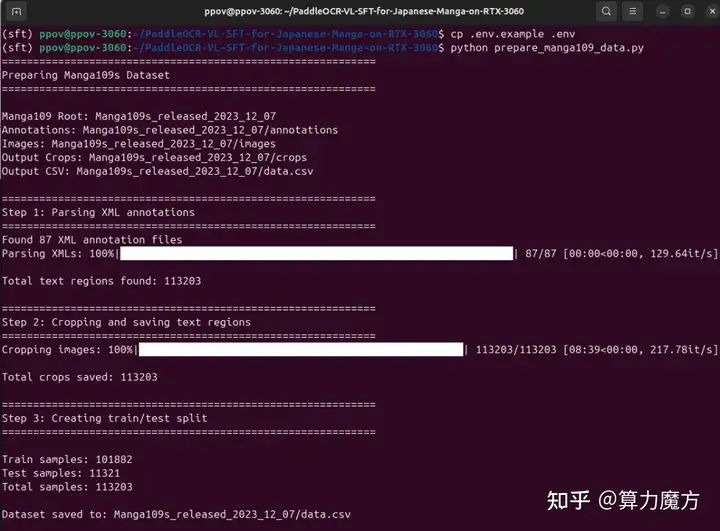
第三步:开启训练 (SFT)
一切准备就绪。我们提供了一个一键启动脚本 train.sh,其中已经预设了适合 RTX 3060 的参数。
bash train.sh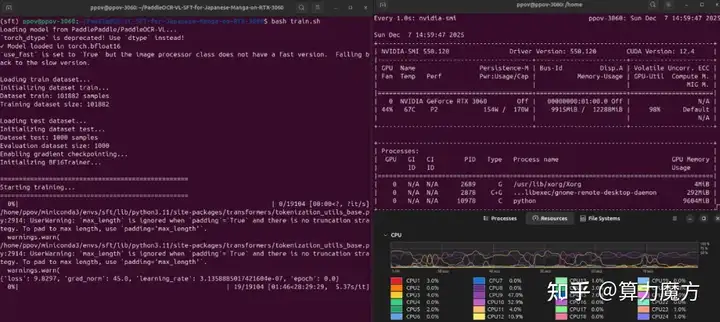
第四步:模型评估
训练完成后,我们需要验证模型是否真的学会了读漫画。
# 评估微调后的模型 (SFT Output)
python evaluate_model.py --model_path ./sft_output --num_samples 500
# (可选) 对比原始模型
python evaluate_model.py --model_path PaddlePaddle/PaddleOCR-VL --num_samples 500
你将看到类似这样的巨大提升:
- Base Model:经常输出乱码,无法理解竖排。
- Fine-tuned Model:准确识别 "あとは『メルニィ宇宙鉄道』とか..." 等复杂句式。
PaddleOCR-VL_3060
五,结语
通过这个项目,我们证明了即使是在消费级显卡 RTX 3060 上,通过合理的技术优化(BF16、梯度累积),我们也完全有能力微调先进的 Vision-Language 模型。
PaddleOCR-VL 的微调版本不仅解决了竖排文本识别的难题,更为构建自动化的漫画翻译/汉化工具铺平了道路。
如果你对这个项目感兴趣,或者想获取详细的代码,请访问我们的 GitHub 仓库: 👉
https://github.com/openvino-book/PaddleOCR-VL-SFT-for-Japanese-Manga-on-RTX-3060.gitHappy Coding & Happy Reading!
如果你喜欢这篇文章,请点赞并关注我们,获取更多 AI 实战教程!
如果你有更好的文章,欢迎投稿!
稿件接收邮箱:++nami.liu@pasuntech.com++