库的制作
什么是库?
库是写好的现有的,成熟的,可以复用的封装好的代码。可分为静态库和动态库。
前提准备(我们下边代码演示都是用这些案列)
cpp
//计算字符串长度
my_string.h
#pragma once
int my_strlen(const char* s);
my_string.cc
#include"my_string.h"
int my_strlen(const char* s){
    const char *end=s;
    while(*end!='\0'){
        end++;
    }
    return end-s;
}
//计算两数和
mystdio.h
#pragma once
int ADD(int a,int b);
mystdio.cc
#include"mystdio.h"
int ADD(int a,int b){
    return a+b;
}
//测试文件
#include "my_string.h"
#include"mystdio.h"
#include <stdio.h>
int main()
{
    const char *s = "abcdefg";
    printf("%s: %d\n", s, my_strlen(s));
    printf("a+b=%d\n",ADD(10,20));
    return 0;
}
静态库
linux平台下后缀为.a,windows平台下后缀为.lib
制作流程:
gcc -c *.c //把所有.c形成.o文件
ar -rc libmyc.a *.o //把所有的.o文件打包成静态库(.a后缀)
eg:libmyc.a 我们把该静态库称为myc静态库
cpp
Makefile文件
libmyc.a:my_string.o mystdio.o//形成静态库
	ar -rc $@ $^
my_string.o:my_string.cc
	g++ -c $<
mystdio.o:mystdio.cc
	g++ -c $<
.PHONY:clean
clean:
	rm -rf my_string.o mystdio.o libmyc.a
使用流程:
gcc -o code code.c -I 路径 (头文件位置) -L 路径(制作的库所在位置) -lmyc(要使用的库)
//如果我们不想指定头文件位置可以把我们自己的实现的头文件拷贝到/usr/include目录中
//库的指定类似,把库拷贝到/usr/lib64中
假设我们现在只有动态库,和对应的头文件,对应结构如下
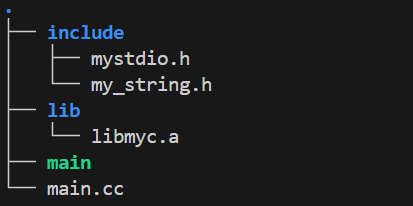
正确执行命令:g++ -o main main.cc -I ./include -L ./lib -lmyc
./main
//运行结果
abcdefg: 7
a+b=30
动态库
linux平台下后缀为.so,windows平台下后缀为.dll
制作流程:
gcc -fPIC -c *.c //把所有.c文件形成.o文件 -fPIC位置无关码
gcc -shared -o libmy.so *.o //把所有的.o文件形成.so动态库 -shared表示成共享库格式
cpp
Makefile
libmyc.so:my_string.o mystdio.o//制作动态库
	g++ -shared -o $@ $^
my_string.o:my_string.cc
	g++ -fPIC -c $<     //形成.o文件要带-fPIC位置无关码
mystdio.o:mystdio.cc
	g++ -fPIC -c $<
.PHONY:clean
clean:
	rm -rf my_string.o mystdio.o libmyc.so
使用流程:
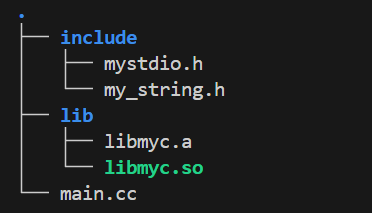
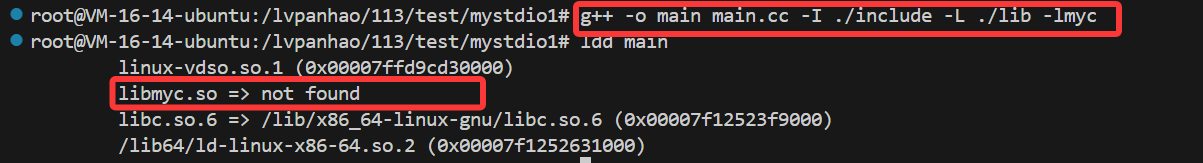
我们要在和静态库使用方法(g++ -o main main.cc -I ./include -L ./lib -lmyc)虽然可以执行但没有链接到任何库。
因为对于静态库我们指定路径是把对应的静态文件告诉了编译器,编译器直接能够使用,
但对于动态库我们需要让系统知道这个动态库的位置。
使用方法:
1..拷贝.so到系统/lib64
2.建立软连接/ln -s /文件目录 lib/64目录
3.LD_LIBRARY_PATH(一次性环境变量)系统查找动态库
4.可以把当制作的lib库写到/etc/ld.so.conf.d/ sudo ldconfig(重新加载)
总结:
1.使用静态库时程序在编译链接的时候把库的代码链接到可执⾏⽂件中,程序运⾏的时候将不再需要静态库。使用动态库时程序在运⾏的时候才去链接动态库的代码,多个程序共享使⽤库的代码。
2.动态库和静态库同时存在是,系统默认优先使用动态库,强制使用静态库,在编译的时候后边加-static。
3.在可执行文件开始运行以前,外部函数的机器码 由操作系统从磁盘上的该动态库中复制到内存中,这个过程称为动态链接。相比静态库动态库可以在多个程序间共享,所以动态链接使得可执行文件更小,节省了磁盘空间。操作系统采用虚拟内存机制允许物理内存中的⼀份动态库被要用到该库的所有进程共用,节省了内存和磁盘空间(后边会详细讲)。
原理
目标文件
把源文件编译形成得.o文件叫做目标文件。
由下图可以看出我们要形成可执行文件,做重要得两步就是编译链接。
编译就是把我们的程序的源代码编译形成机器可识别的.o二进程语言。
链接就是把所有的.o目标文件链接在一起形成可执行文件。
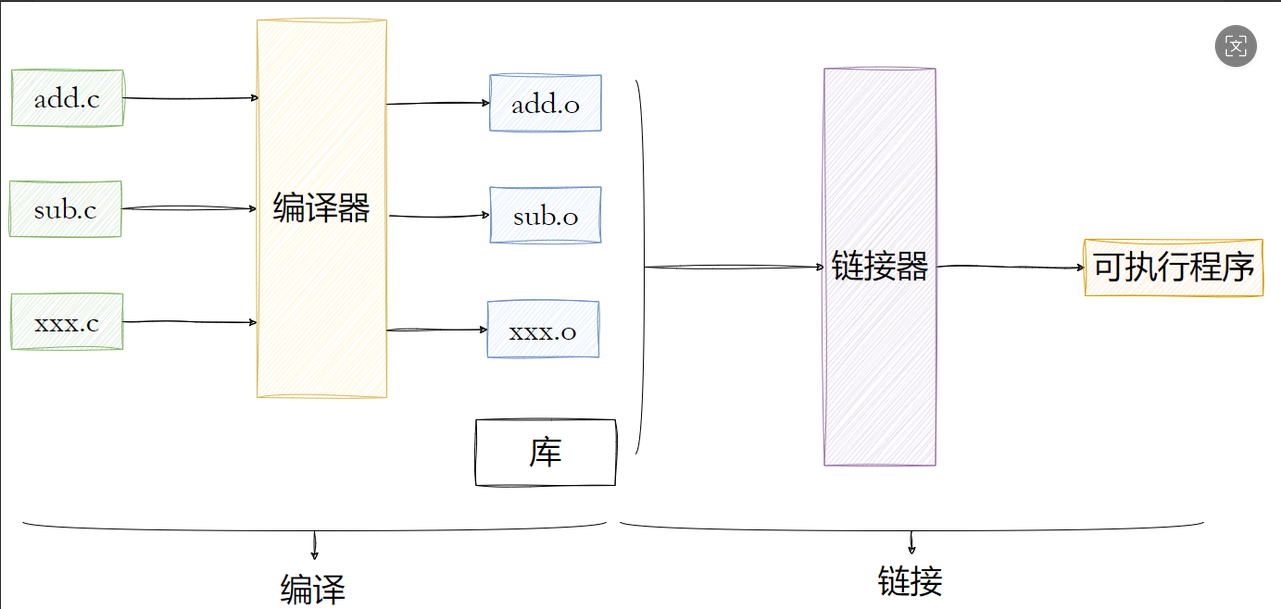
优势:编译时是把每个文件分别进行编译,而不是合到一起进行编译,这样更有利于后期的维护。在编译的时候,如果有一些函数调用,那么编译器会默认写0,等到链接时在填充需要填充相关的地址,这也说明了.o是可重定位文件。
ELF文件
常见的ELF文件
1.可重定位文件(.o文件)
2.可执行文件(.elf 可执行程序)
3.共享目标文件(.so 动静态库)
4.内核转储(core dumps):存储进程的执行上下文,用户dump信号触发。
ELF文件的构成
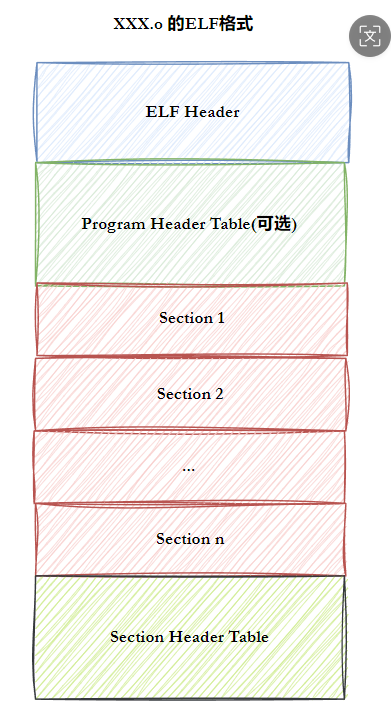
1.ELF头(ELF head):描述整体文件的主要特征。位于文件的开始部分,主要定位文件的其他位置。
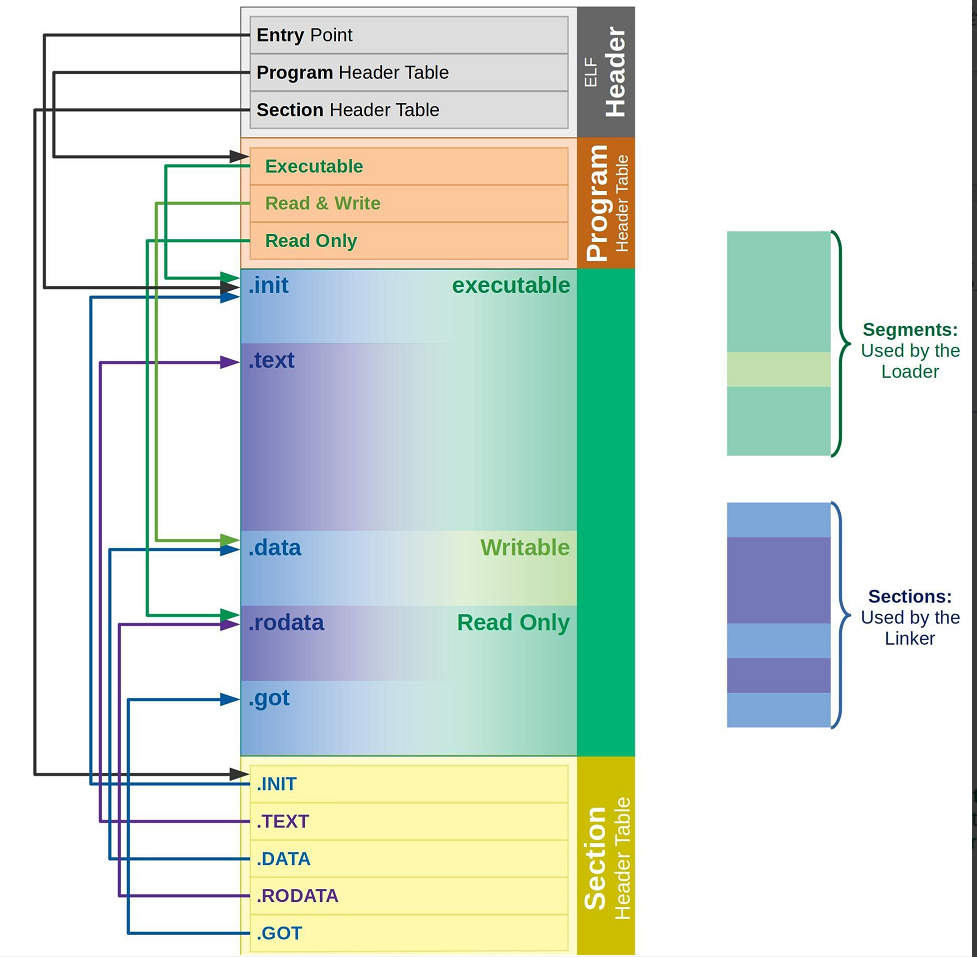
2.程序头表(program header tabe):列举了所有有效的段(segments)(合并后的)和他们的属性,记录权限。记录了每个段开始的位置,长度(偏移)。完成进程内存的初始化。(合并时根据这个决定)。
3.节头表(section header table):包含对节(section 一个个section)的描述。
4.节(section):elf文件的基本组成单位,包含了特定类型的数据(数据段)。ELF文件的各种信息和数据都存储在不容的节中,eg:代码节储存了可执行代码,数据节存储了全局变量和静态数据。
ELF文件向西结构图
查看elf文件基本信息
readelf -S a.out //读取节 ------S读取节,通常读取的是Section header表里边的内容
readelf -s a.out //小s读取符号表
readelf -l a.out //读取合并之后的数据节
readelf -h a.out //读取合并之后的表头
objdump -d code.o>code.s//反汇编
elf部分节的作用
**.text 节:**是保存了程序代码指令的代码节。
**.data 节:**保存了初始化的全局变量和局部静态变量等数据。
**.bss 节:**为未初始化的全局变量和局部静态变量预留位置
**.rodata 节:**保存了只读的数据,如一行 C 语言代码中的字符串。由于.rodata 节是只读的,所以只能存在于一个可执行文件的只读段中。因此,只能是在 text 段(不是 data 段)中找到.rodata 节。
**.symtab 节:**Symbol Table 符号表,就是源码里面那些函数名、变量名和代码的对应关系。
.got.plt 节 (全局偏移表 - 过程链接表):.got 节保存了全局偏移表。.got 节和.plt 节一起提供了对导入的共享库函数的访问入口,由动态链接器在运行时进行修改。(主要是这部分可以被修改)。
ELF的形成
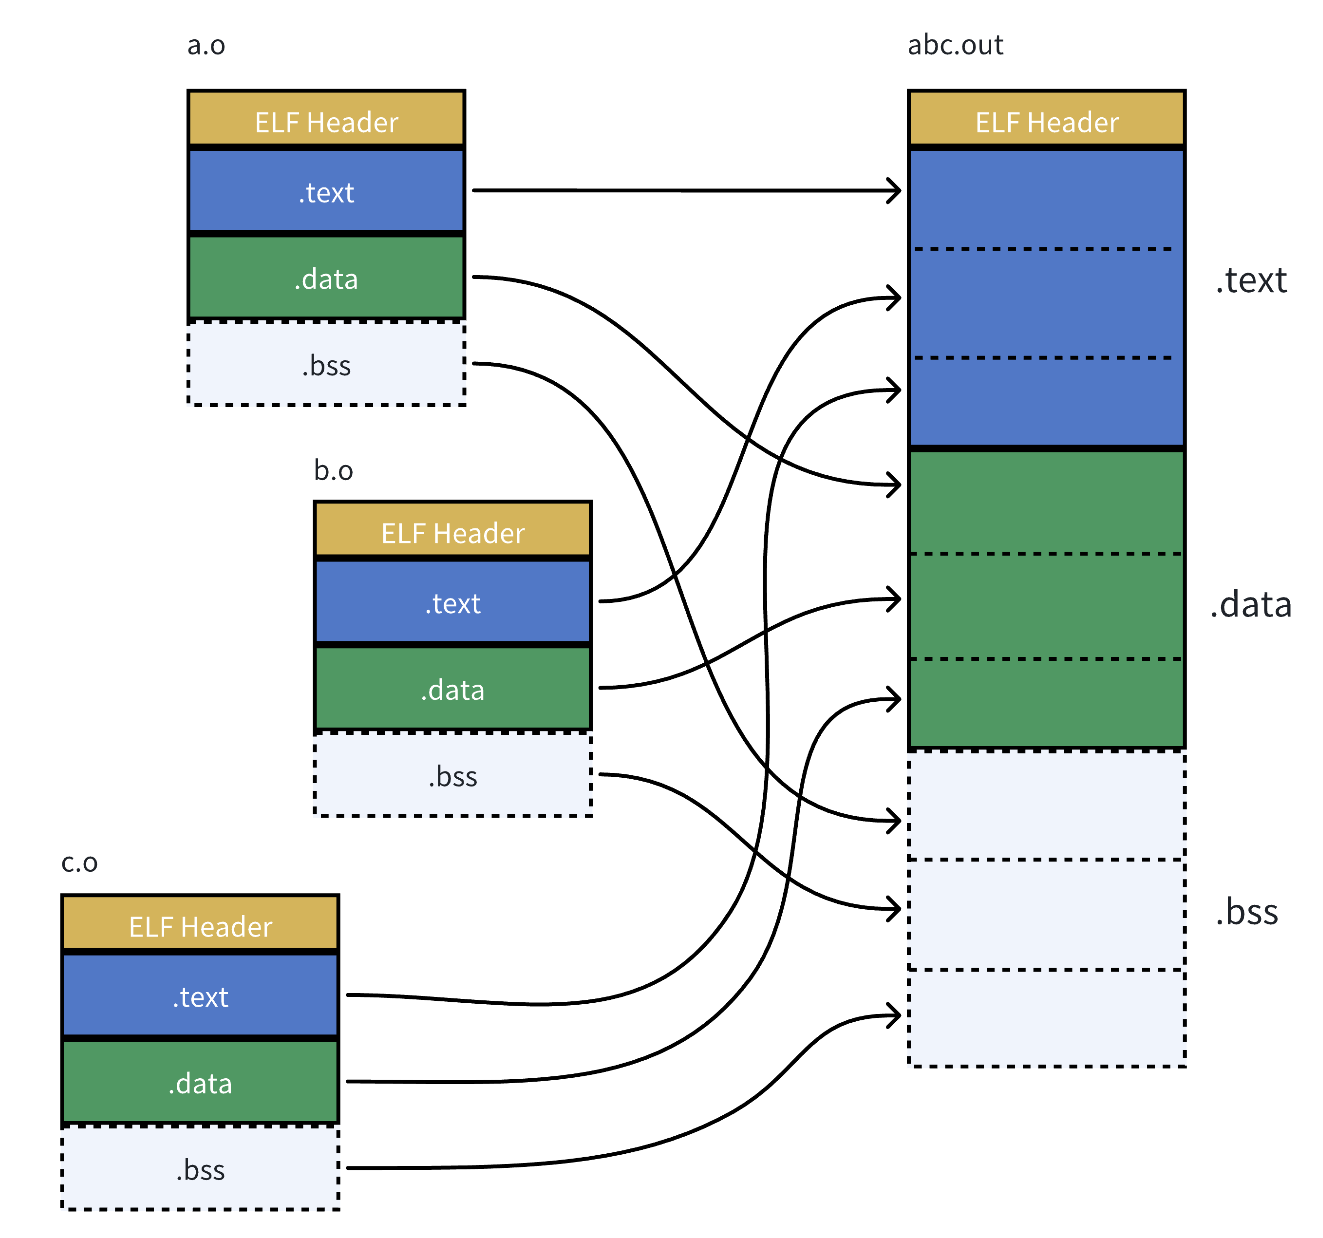
ELF形成可执行文件
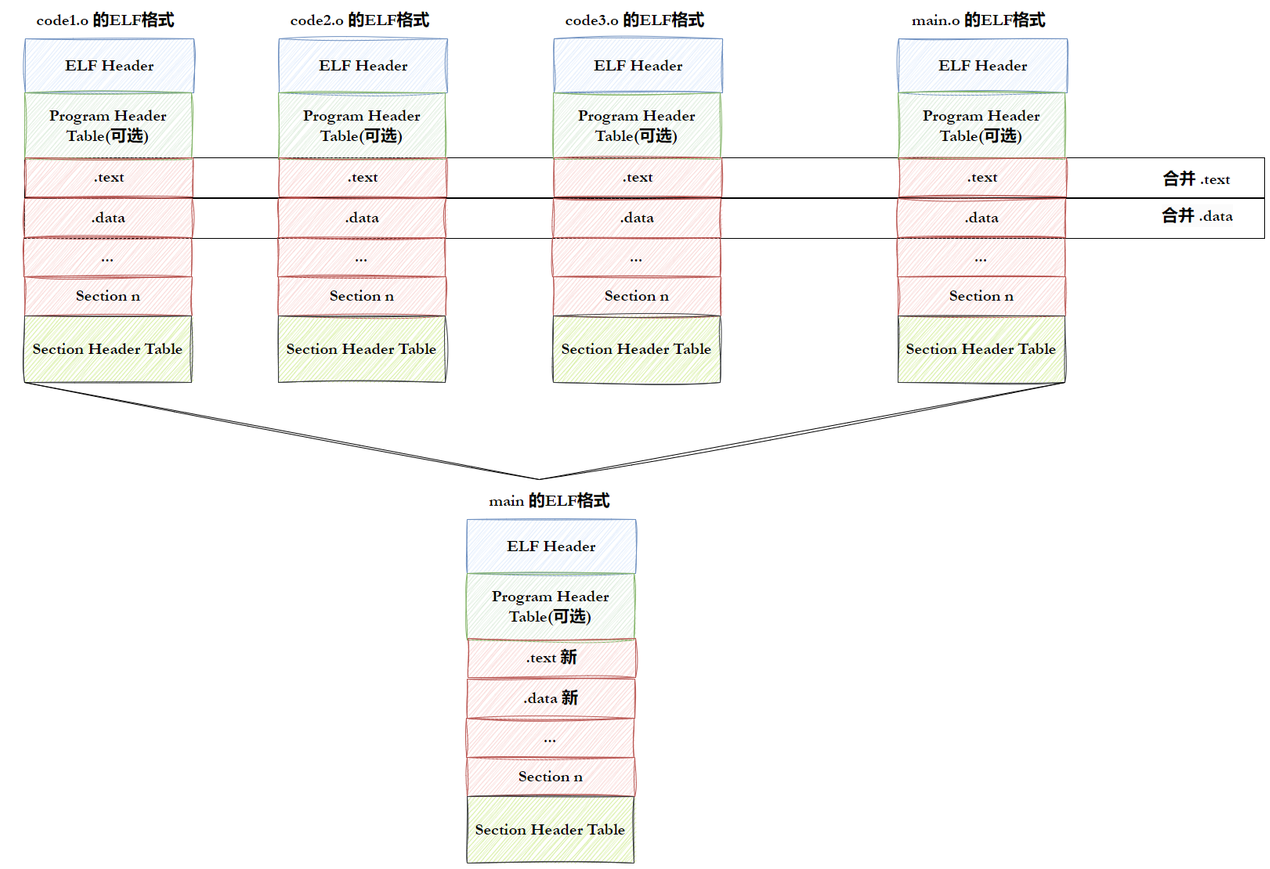
1.首先多份源代码 gcc -c编译成.o文件
2.将多份.o的相同节合并到一起,形成新的elf文件。
单个elf文件也会有不同的section,在加载到内存时,也会进行section合并,形成segment。合并原则:相同属性(可读,可写,可执行)
为什么要合并?
1.section合并的主要原因时是为了减少页面碎片化,提高内存使用效率,防止浪费空间。
eg:.text(4097)和.init(512) 两个段属性一样,如果不进行合并则需要用至少3个页面,如果进行合并则只需要2个页面即可。(根据相同属性方面来回答)
2.相同权限得节合并为同一个,从而优化内存管理和权限访问控制。
经过 pargarm head table 把相同属性,相同类型进行合并 eg:.data /.bss合成一个数据段。
总:合并工作也已经在形成ELF文件的时候,合并方式已经被记录在了ELF程序表头中。
ELF文件的加载
理解一个ELF文件如何从磁盘中加载到内存中的
逻辑地址/虚拟地址/物理地址
逻辑地址=虚拟地址:在磁盘中为逻辑地址(其实为0+偏移),初始化mm_struct,mm_area_struct称之为虚拟地址(4GB独立空间地址)
物理地址:加载到物理内存后的地址。
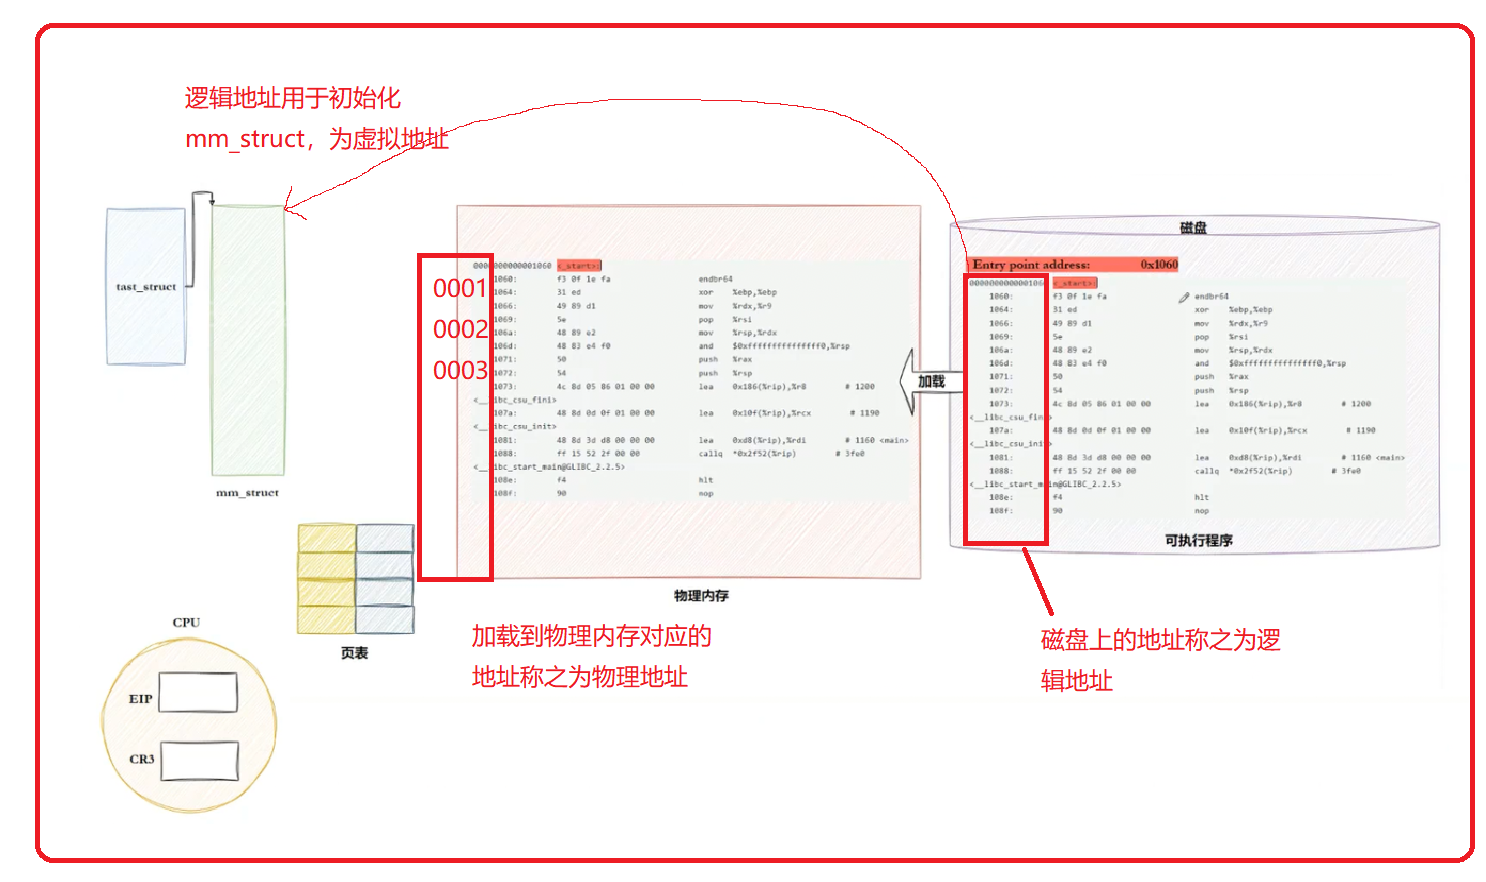
虚拟地址如何加载
加载磁盘中的地址到虚拟地址,来初始化mm_struct(mm_area_struct).
对应的mm_area_struct结构如下。
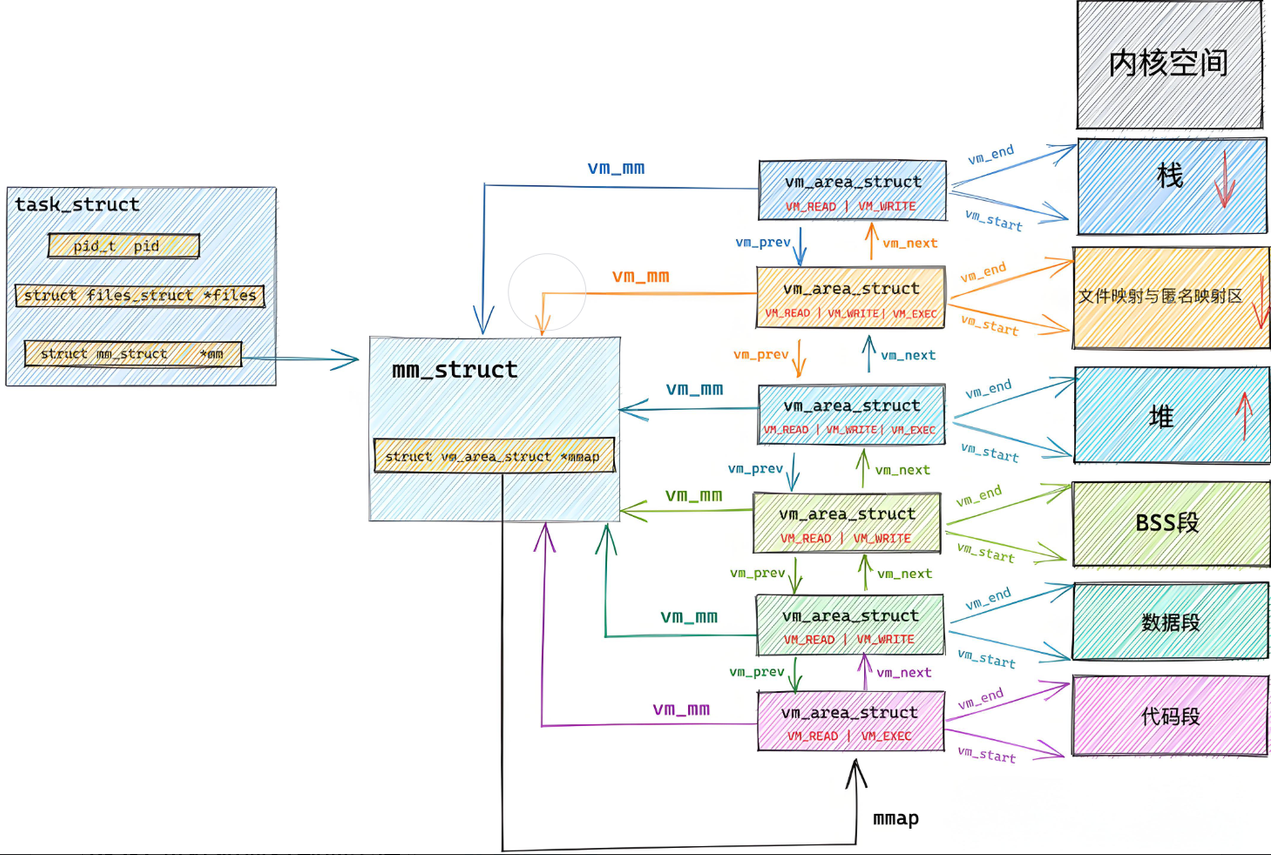
由上图可以看出mm_area_struct中,只要知道每个段的其实和结束地址就可以,在磁盘中,elf文件也是进行segment分节的,每个segment有自己的起始地址和长度,根据这个就可以对mm_strucr进行初始化。
整体理解
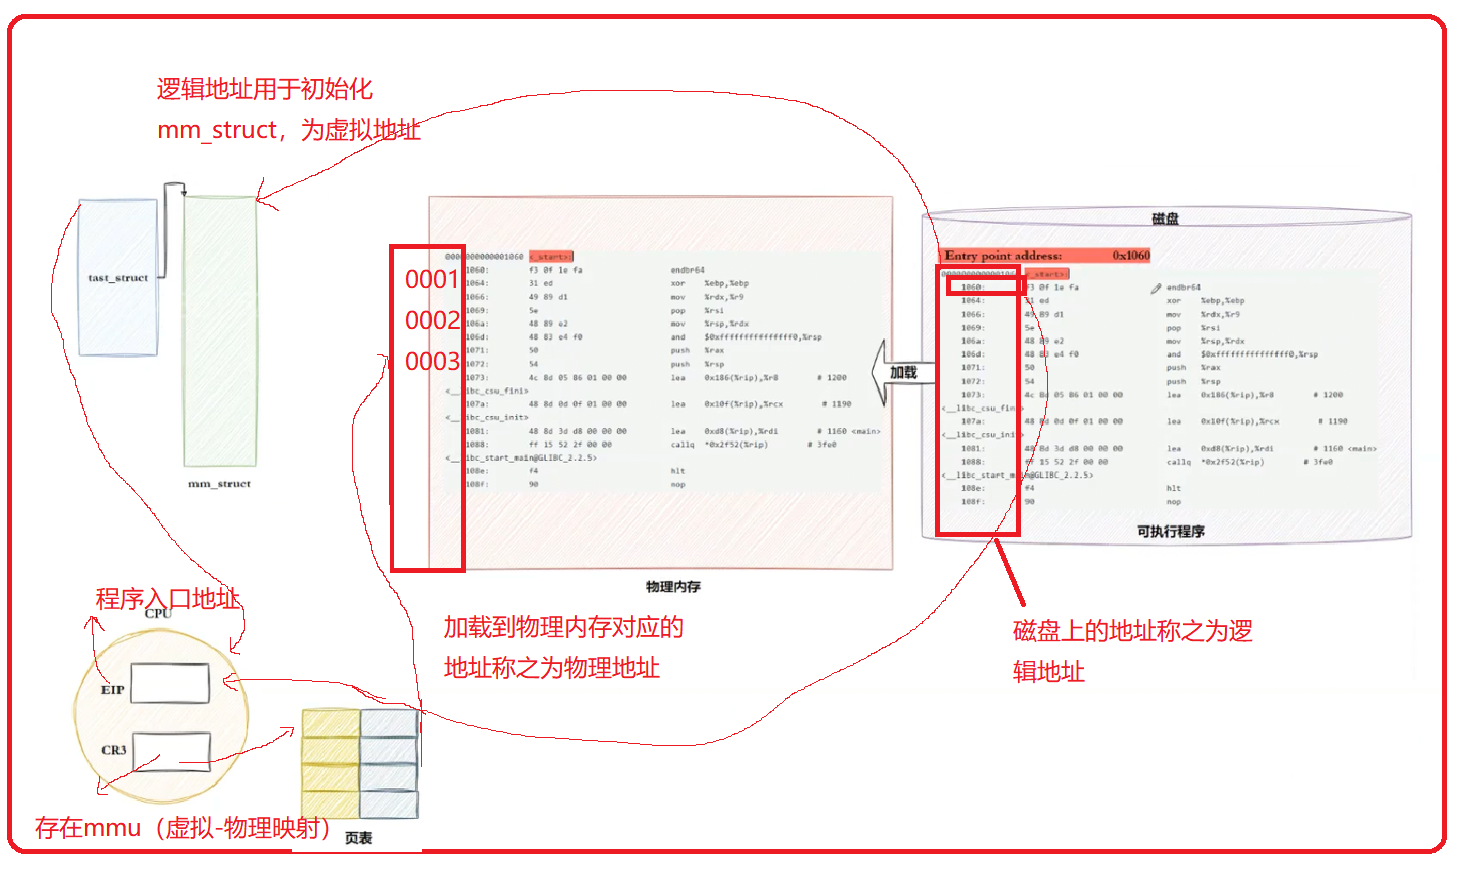
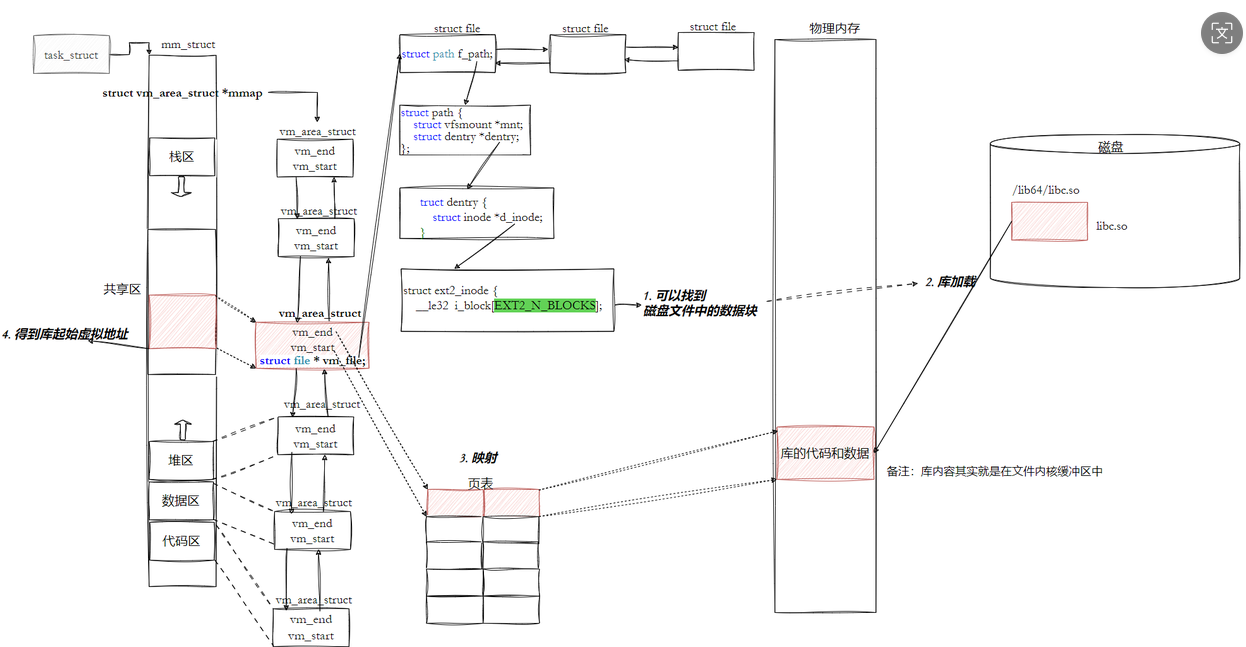
我们来对整个过程进行一下理解。
首先elf文件在磁盘中有对应的逻辑地址,加载该文件到物理内存中,会创建物理内存。另外还会填充虚拟地址空间mm_struct。
在ELF HEAD里边存在函数入口地址,cpu只要拿到该地址存放在EIP中,我们就知道在执行哪个程序。另外os会自动根据虚拟地址和物理地址对应填充页表,cpu通过mmu(地址映射)根据虚拟地址可以精准找到对应的物理地址。
静态链接和动态链接
静态链接
主要时静态库如何与程序进行链接的
静态链接就是把.o文件进行合并的过程
我们拿任意一个程序举例:使用printf()或自定义函数,对程序进行编译,使用objdump -d来对程序反汇编,发现对应函数调用的地方全都是00 00 00 00。这是因为编译器在编译的时候编译器完全不知道这些函数的存在,在链接的时候为了让编译器将来能够正确定位到被修改的地址,在代码块(.data)中存在一个重定位表,这张表在链接的时候填充地址进行修正。
总结:其实所谓的静态链接就是将编译好的所有目标文件(.o文件),连同使用到的一些静态库,在链接的时候拼装成一个独立的可执行文件(包括一些地址的加载和修改)。当所有的模块组合在一起后,连接器会根据我们的.o文件或静态库中的重定位表周到需要被重定位函数的全局变量,从而修改他们的地址。
因为在链接中涉及到对.o中外部符号进行地址重定位,所以我们称.o文件是可重定位文件。
动态链接
静态链接vs动态链接
**静态链接:**会将编译产生的所有目标文件,连同用到的各种库,合并成一个独立的可执行文件,不需要额外的依赖就能运行。但静态链接最大的问题在于生成的文件体积大,消耗资源。
**动态链接:**可以将需要共享的代码提取出来,保存成一个独立的动态链接库,等到程序运行时,在将他们加载到内存,可以节约内存空间。
进程如何看待动态库
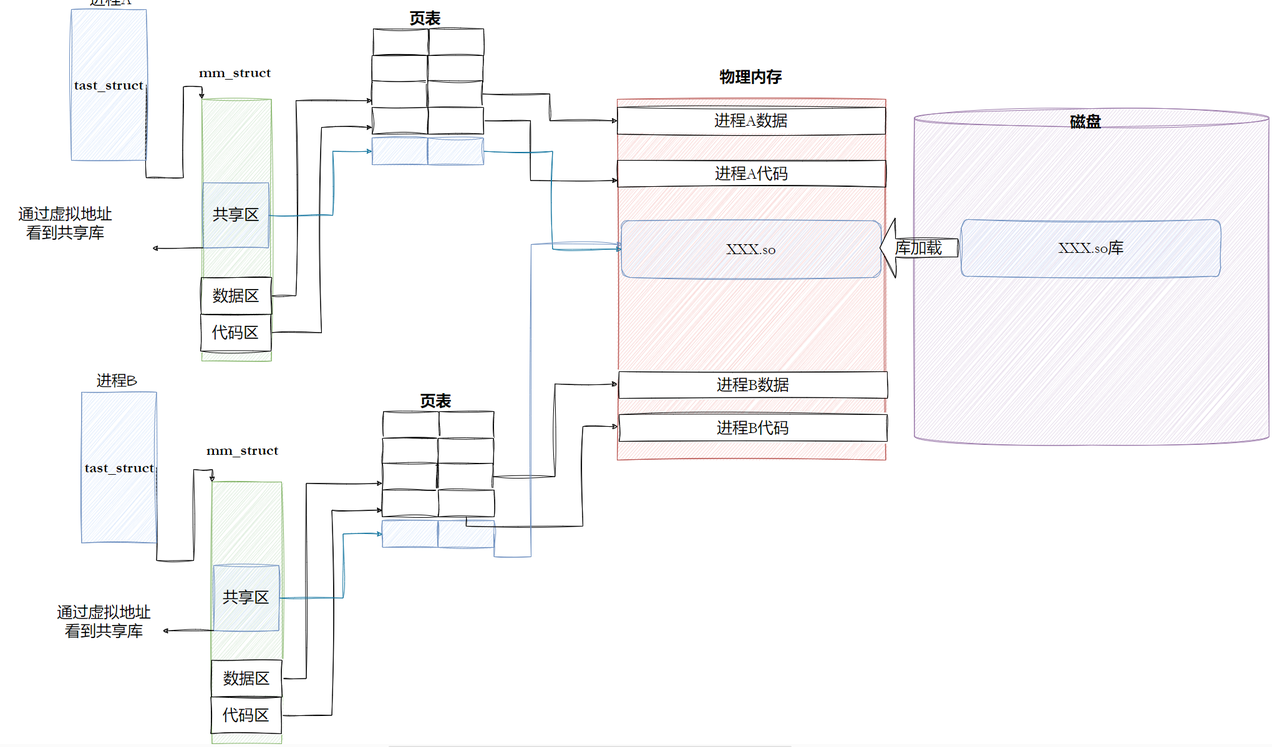
动态链接是如何进行工作的?
动态链接实际上是将整个程序运行过程推迟到了程序加载的地方。
比如我们去运行⼀个程序,操作系统会首先将程序的数据代码连同它用到的⼀系列动态库先加载到内存(库和代码数据同时加载到物理内存),其中每个动态库的加载地址都是不固定的(多个库),页表映射之后,操作系统会根据当前进程的地址空间的使用情况为它们动态分配⼀段共享内存。 当动态库被加载到内存以后,⼀旦它的内存地址被确定,我们就可以去修正动态库中的那些函数跳转地址了(地址重定位)。
_start入口函数
程序执行时并不会从main函数开始执行,而是从cong_start函数开始执行,_start函数是由c运行库或则时ldd运行库提供的特殊函数。
_start函数的作用:
1.设置堆栈创建一个初始堆栈环境。
2.初始化数据段:将程序的数据段(全局变量和静态变量)从初始化数据段复制到相应的内存位置,清0数据段。
3**.动态链接**:调用动态连接器的代码来解析和加载程序所依赖得到动态库。动态连接器会处理所有的符号解析和重定位,确保程序中的函数和变量访问能够正确的映射到动态库中的实际地址。
**访问动态库中的方法:**动态库映射的起始地址+偏移量。
一开始库函数中的方法不能确定地址,只能知道偏移量,因为库函数没有加载到内存,没有分配具体其实地址。
程序和动态库的映射
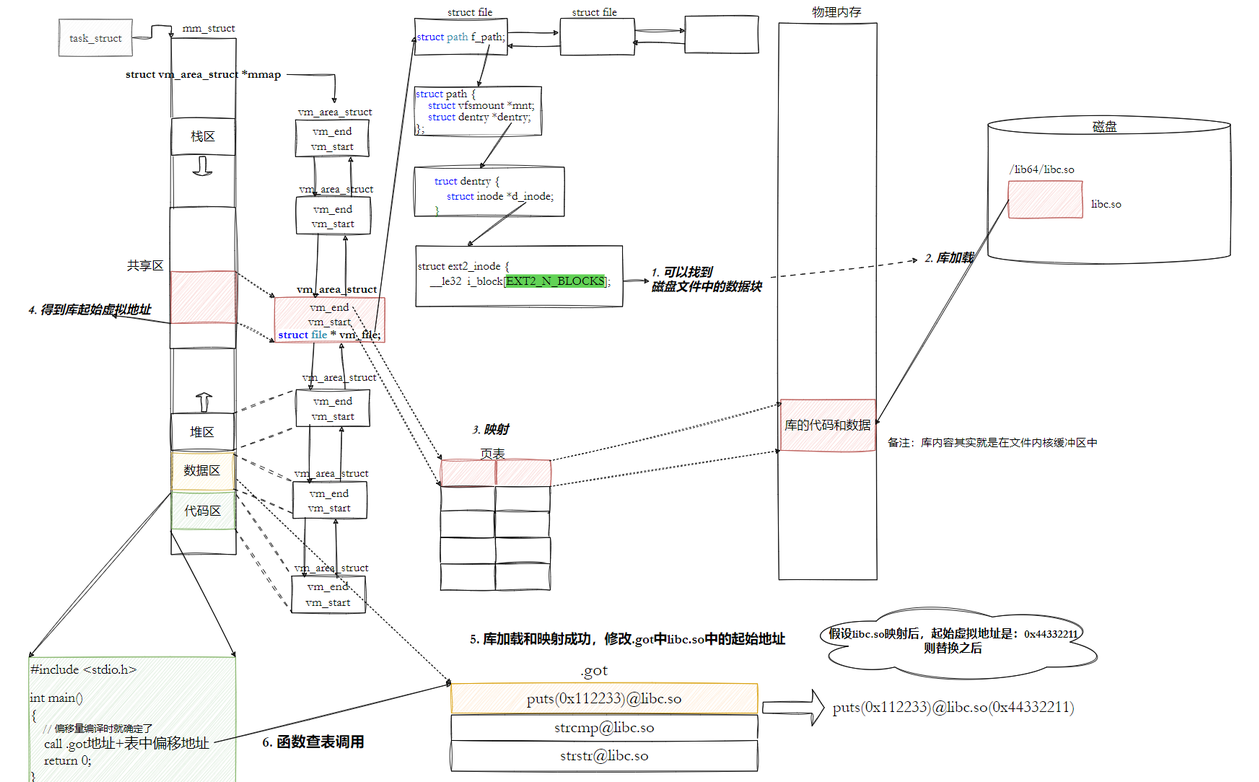
程序找到动态库本质:动态库也是一个文件,要访问也需要被打开加载到内存,不过最主要区别是动态库加载到虚拟内存的一共共享区,我们访问的时候需要跳转到这个共享区进行访
问,访问结束在跳转回来即可。
程序如何正确使用动态库中的方法。我们如果调用动态库中其中一个库函数,os首先会把动态库映射到虚拟地址空间,确定好地址后,库函数中的方法地址也已经知道了(根据偏移量)。所以我们既知道动态库的起始虚拟地址也知道要使用的方法偏移量,那么就很容易找到对应的方法。
注意:在整个使用过程中,是从代码区跳转到共享区,使用完之后从共享区跳转到代码区,整个过程是在程序的虚拟地址空间中进行的。
全局偏移量表GOT
全局偏移量表主要解决代码区不能修改的问题。
首先我们知道加载到虚拟地址后,会进行库函数映射,我们调用所需库函数时,知道动态库地址,然后方法偏移量也知道,也就是可以确定方法地址,这时我们需要对加载到内存中库函数调用进行地址修改(主要是修改代码区 填充call 后边的地址)这个过程叫地址重定位。'
但是我们知道代码区在进程中是只读区域,不能进行修改,所以动态链接采用的方法是在可执行程序中专门预留一片区域来存放函数的跳转地址,这个叫做全局偏移GOT表。
换句话来讲既然我们不能修改代码区数据,那么我们就固定一个函数地址(got表地址),然后跳转到got区域,来进行地址修改,调用对应的库函数。
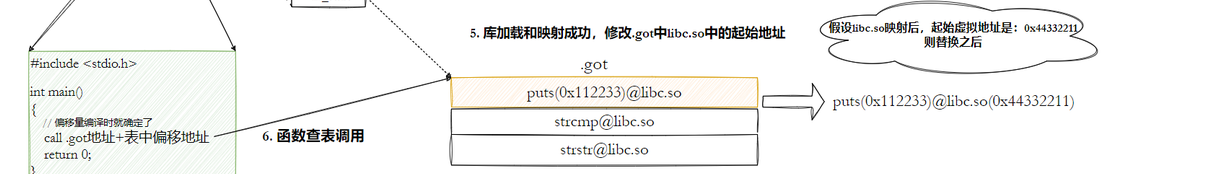
简单总结:
- 代码段只读无法直 接修改,借助 GOT 表可让代码被进程共享,但不同进程中动态库地址 / 位置不同,每个进程的每个动态库有独立 GOT 表,故进程间不能共享 GOT 表。
- 单个.so 中,GOT 表与.text 段相对位置固定,可通过 CPU 相对寻址找到 GOT 表。
- 调用函数时先查 GOT 表,再按表中地址跳转;这些地址会在动态库加载时被修改为真实地址。
- 这种动态链接方式称为 PIC(地址无关代码),动态库无需修改即可加载到任意内存地址运行,且能被所有进程共享;这也是编译时指定 - fPIC 参数的原因, PIC = 相对编址 + GOT。
库之间的依赖
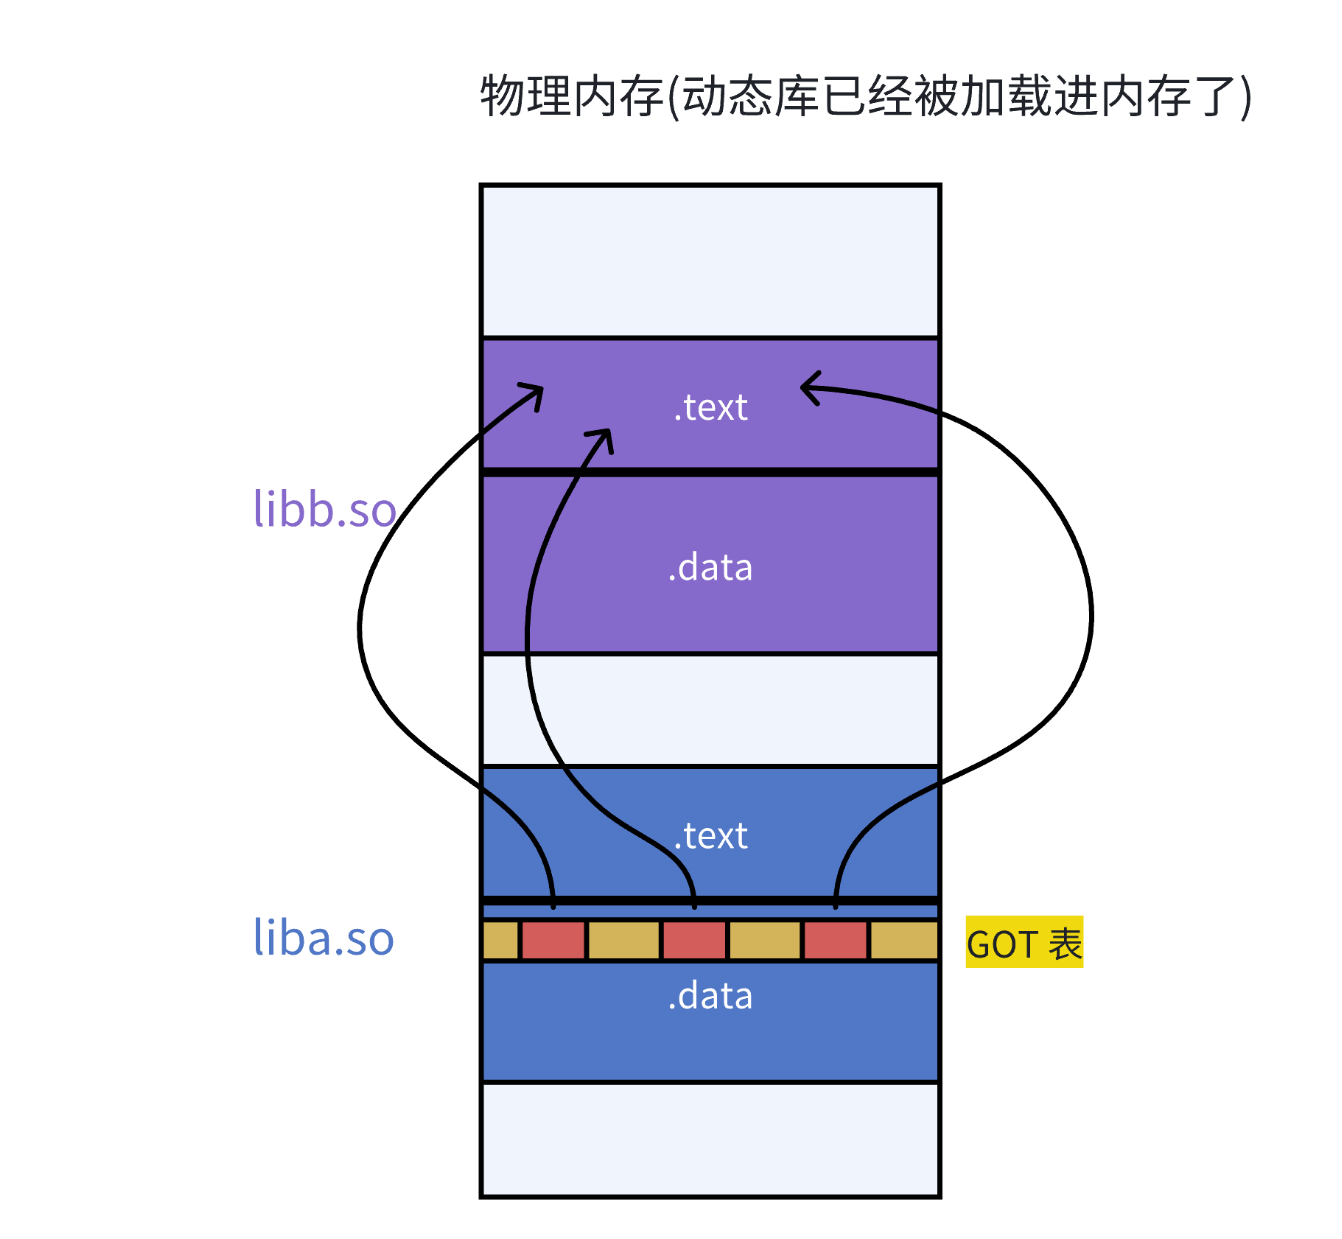
不仅仅可执行程序依赖库,库也会依赖其他库,另外库中也有.GOT表,这也可以说名他们都是一样的格式(ELF文件)。
总结:
静态链接提高了程序的模块化/水平,会将编译产生的所有目标文件和用到的各种库合并成为一个独立的可执行文件,其中我们会去修正模块间函数的跳转地址,这个也叫静态重定位。
动态链接实际上将链接推迟到了程序加载的时候,运行程序的时候os会首先将程序的数据代码连同他用到的一系列动态库有限加载到内存,其中每个动态库的加载地址都是不确定的,但无论加载到什么地方,都要映射到进程所在的进程地址空间,然后通过got表当时进行调用(运行重定位,也叫动态地址重定位)。