python实现打开网站并进行搜索操作
打开B站搜索python
python
from selenium import webdriver
from selenium.webdriver.edge.options import Options
from selenium.webdriver.common.keys import Keys
from selenium.webdriver.common.by import By
from selenium.webdriver.edge.service import Service
import os

# ========== 1. 修复核心错误 ==========
# 错误1:路径含多余空格("AppLication" 拼写错误+路径空格)
EDGE_BROWSER_PATH = r"C:\Program Files (x86)\Microsoft\Edge\Application\msedge.exe"
# 错误2:必须指定 EdgeDriver 路径(之前的环境问题)
EDGEDRIVER_PATH = r"C:\Users\叶梓聪\AppData\Local\Programs\Python\Python37\Scripts\msedgedriver.exe"  # 替换为你的驱动路径

# ========== 2. 配置 Edge 选项 ==========
edge_options = Options()
edge_options.binary_location = EDGE_BROWSER_PATH  # 修复路径+拼写错误
# 关闭日志干扰
edge_options.add_experimental_option('excludeSwitches', ['enable-logging'])
# 禁用自动化提示
edge_options.add_argument('--disable-blink-features=AutomationControlled')

# ========== 3. 配置驱动服务 ==========
# 临时加入环境变量(避免 PATH 问题)
os.environ["PATH"] += os.pathsep + os.path.dirname(EDGEDRIVER_PATH)
service = Service(executable_path=EDGEDRIVER_PATH)

# ========== 4. 启动浏览器 ==========
driver = webdriver.Edge(service=service, options=edge_options)
driver.maximize_window()  # 最大化窗口,避免元素被遮挡
driver.implicitly_wait(10)  # 隐式等待10秒,确保页面加载完成

# ========== 5. 修复元素定位+方法名错误 ==========
driver.get('http://www.bilibili.com')
# 错误3:find_eLement 拼写错误(L大写)→ 正确:find_element
# 错误4:TAG_NAME 定位input会找到多个元素,改用B站搜索框专属定位
search_box = driver.find_element(By.ID, "nav-searchform")  # B站搜索框父元素
input_box = search_box.find_element(By.TAG_NAME, "input")  # 精准定位搜索输入框
# 错误5:清空原有内容(避免残留)+ 输入关键词 + 回车
input_box.clear()
input_box.send_keys("Python" + Keys.RETURN)

# 等待用户输入,保持浏览器打开
input('按回车键关闭浏览器...')
driver.quit()  # 最后关闭浏览器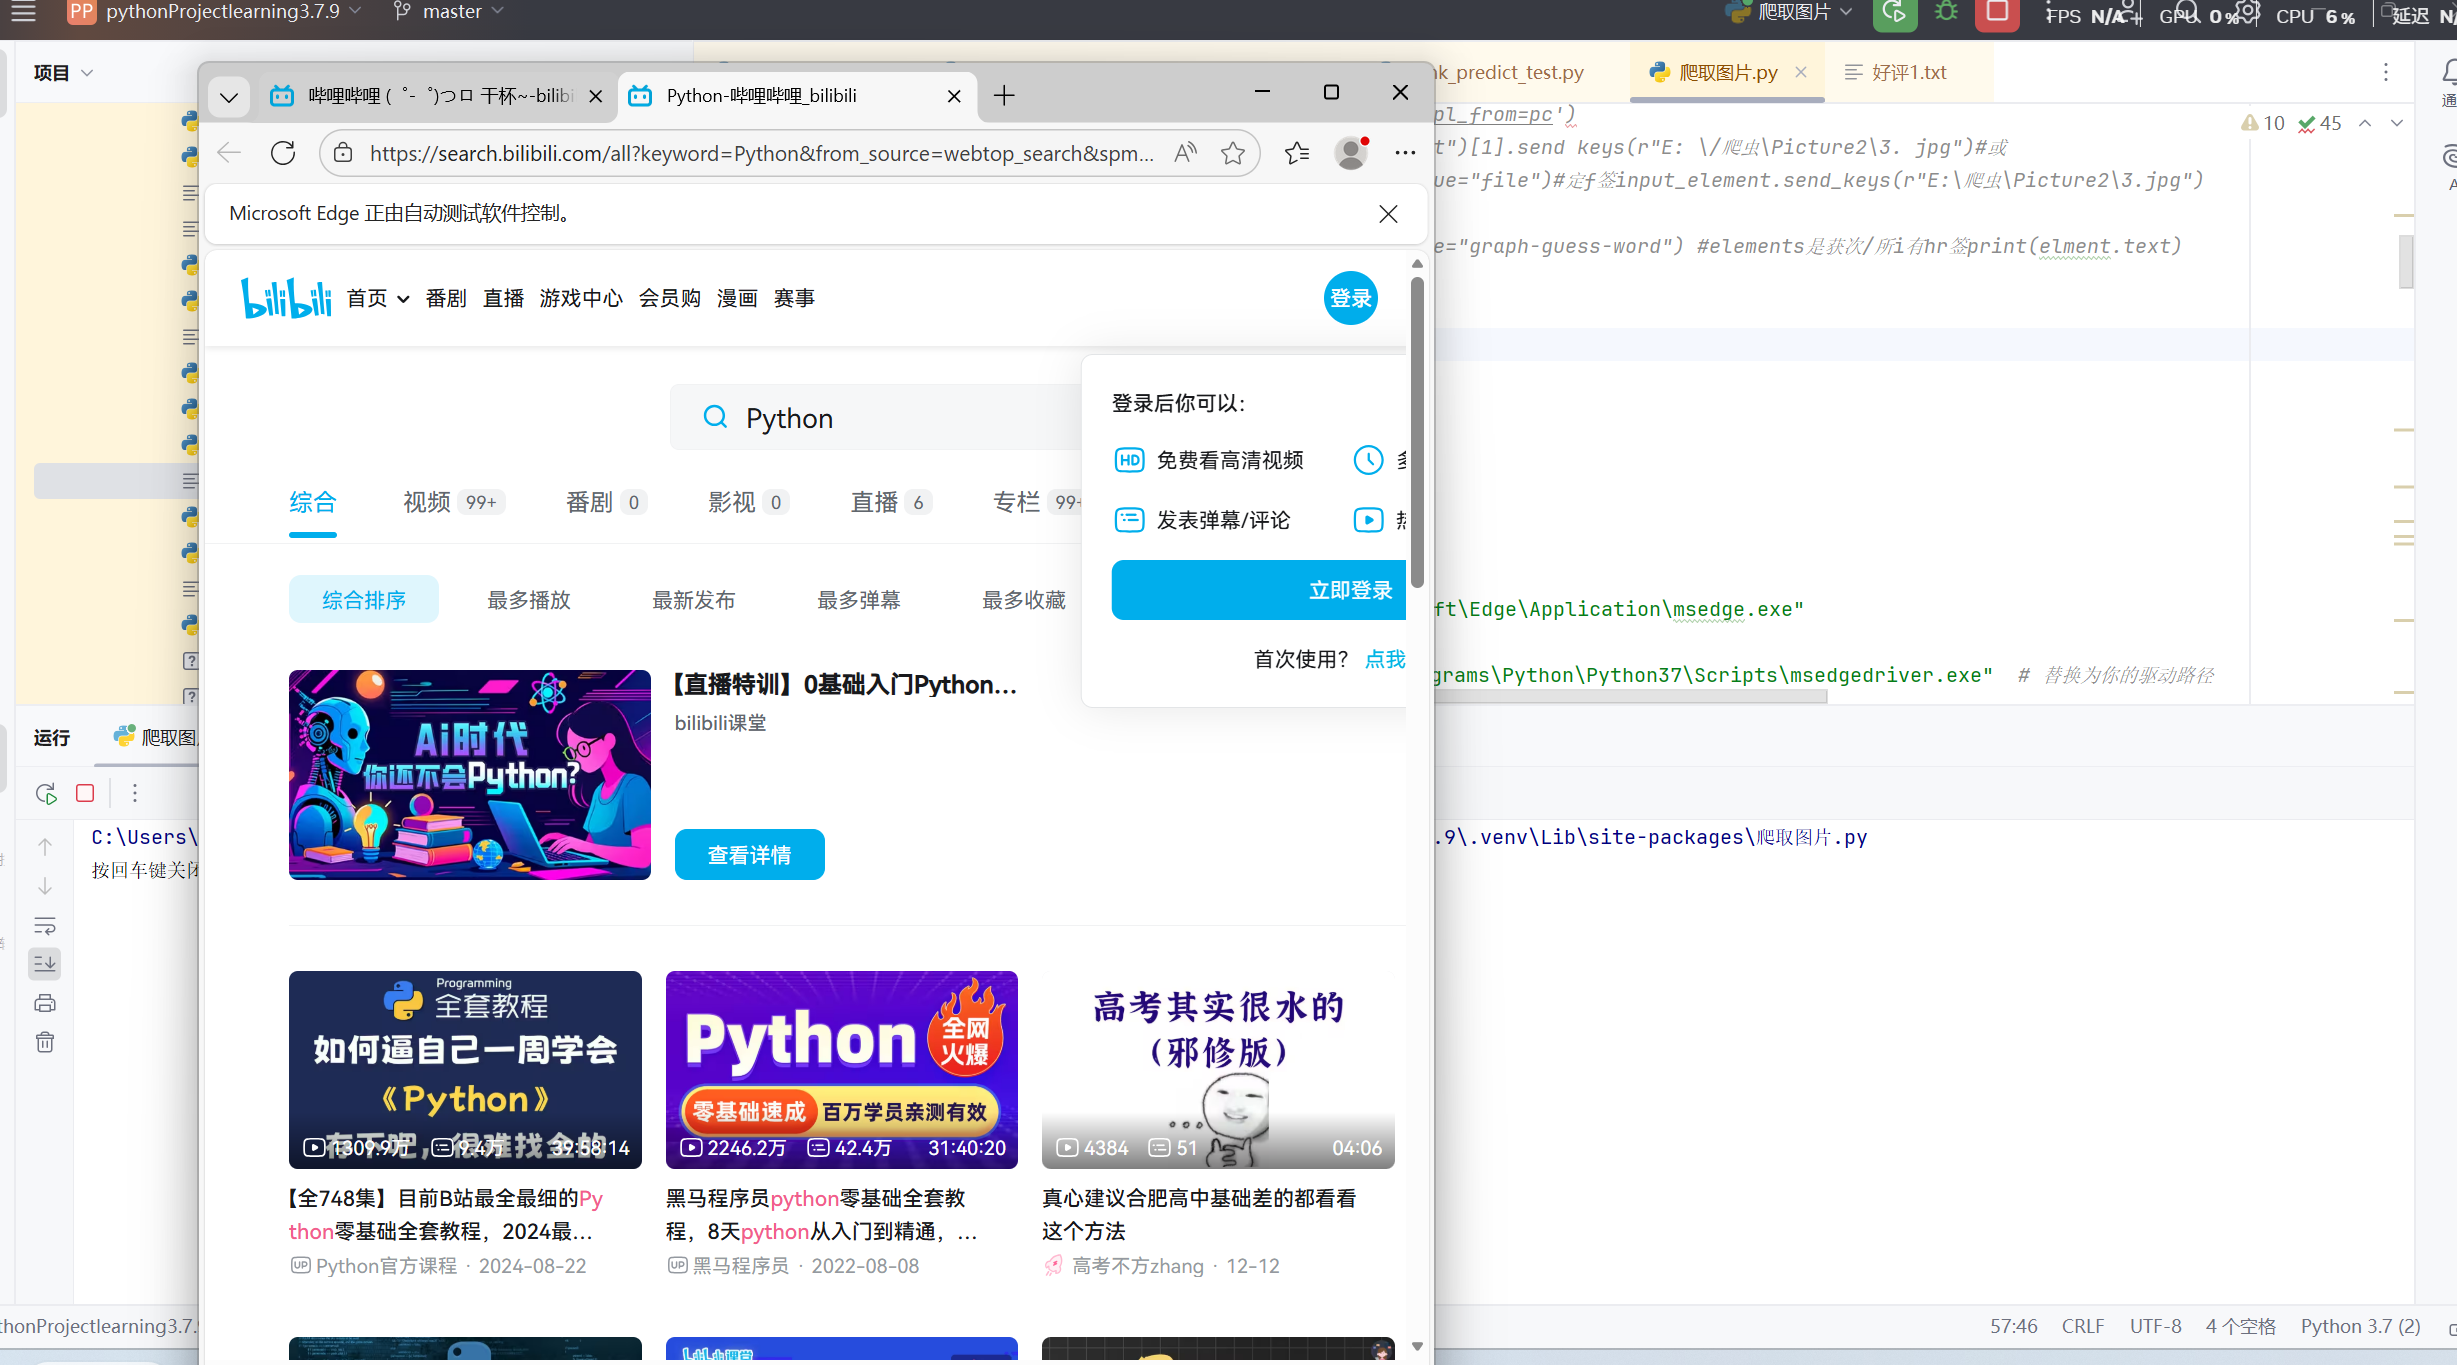
爬取百度搜图图片
python
'''爬取图片(find_element)2.0'''
import requests
import os
import time
if not os.path.exists("./命运二"):
   os.mkdir("./命运二")
#批量化下载网页资源
from selenium import webdriver
from selenium.webdriver.edge.options import Options
from selenium.webdriver.common.by import By
edge_options = Options()
edge_options.binary_location =r"C:\Program Files (x86)\Microsoft\Edge\Application\msedge.exe"
driver=webdriver.Edge(options=edge_options)
driver.get('https://image.baidu.com/search/index?tn=baiduimage&ie=utf-8&word=命运二')#执行JavaScript滚动操作
driver.execute_script("window.scrollTo(0, document.body.scrollHeight);")
time.sleep(5)
img_list=driver.find_elements(By.XPATH, value="//img[@class='img_7rRSL']")# print(img_list)
i=1
for img in img_list:
#获取图片的src属性
   img_url = img.get_attribute("src")
   img_data = requests.get(img_url)
#保存图片到文件
   with open(f"./命运二/{i}.png",'wb') as f:
      f.write(img_data.content)
   i +=1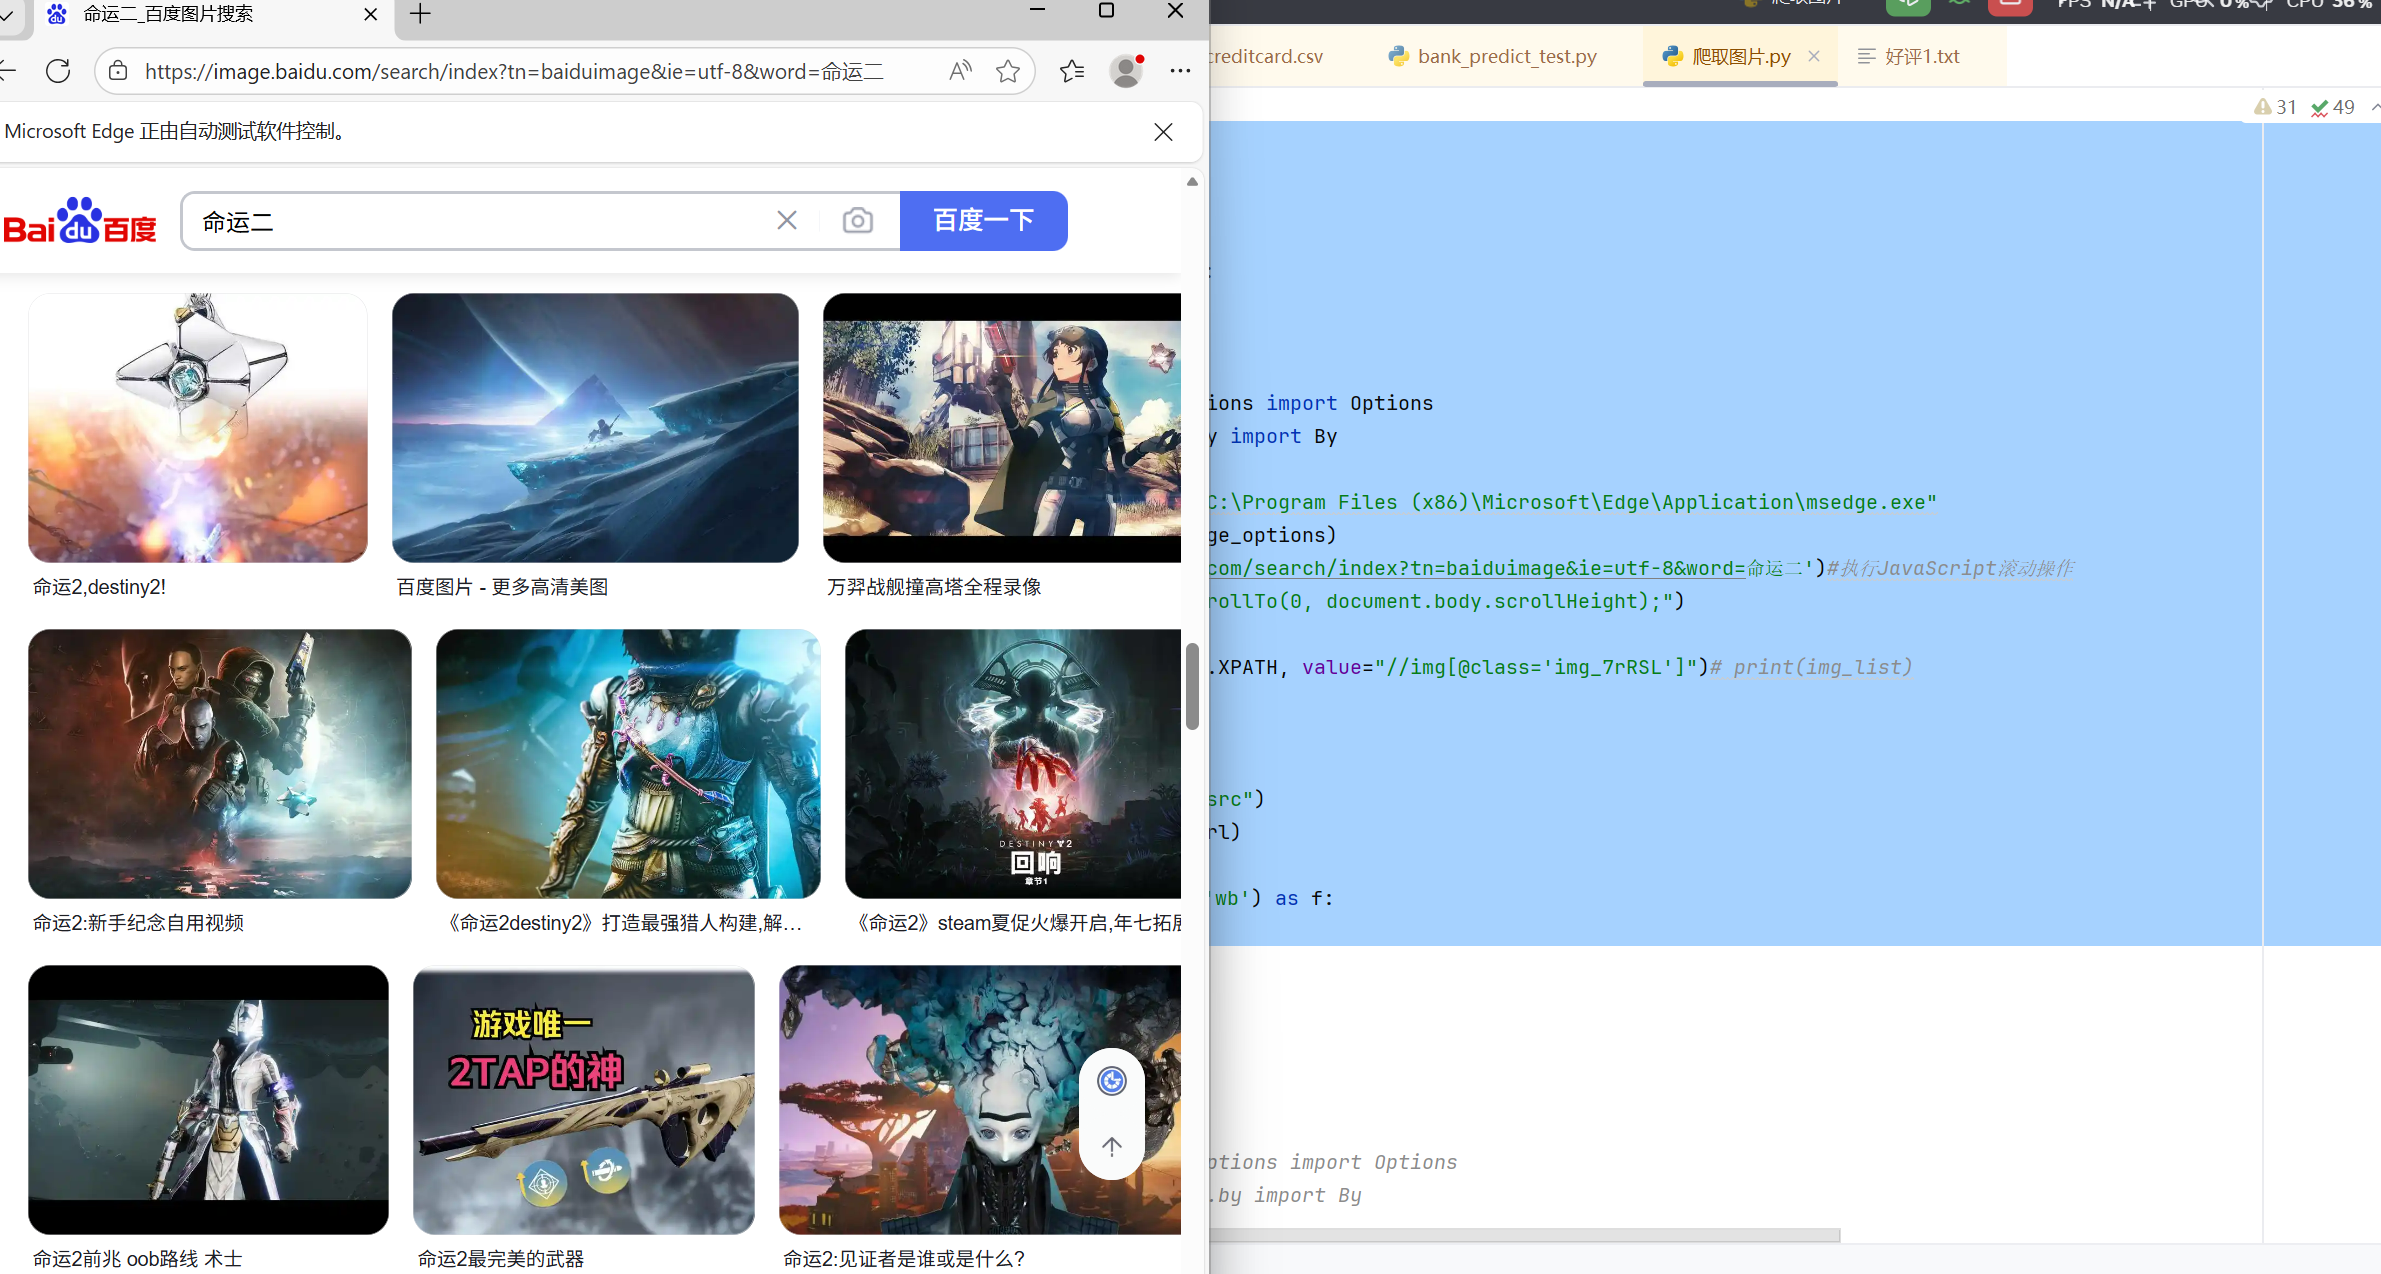
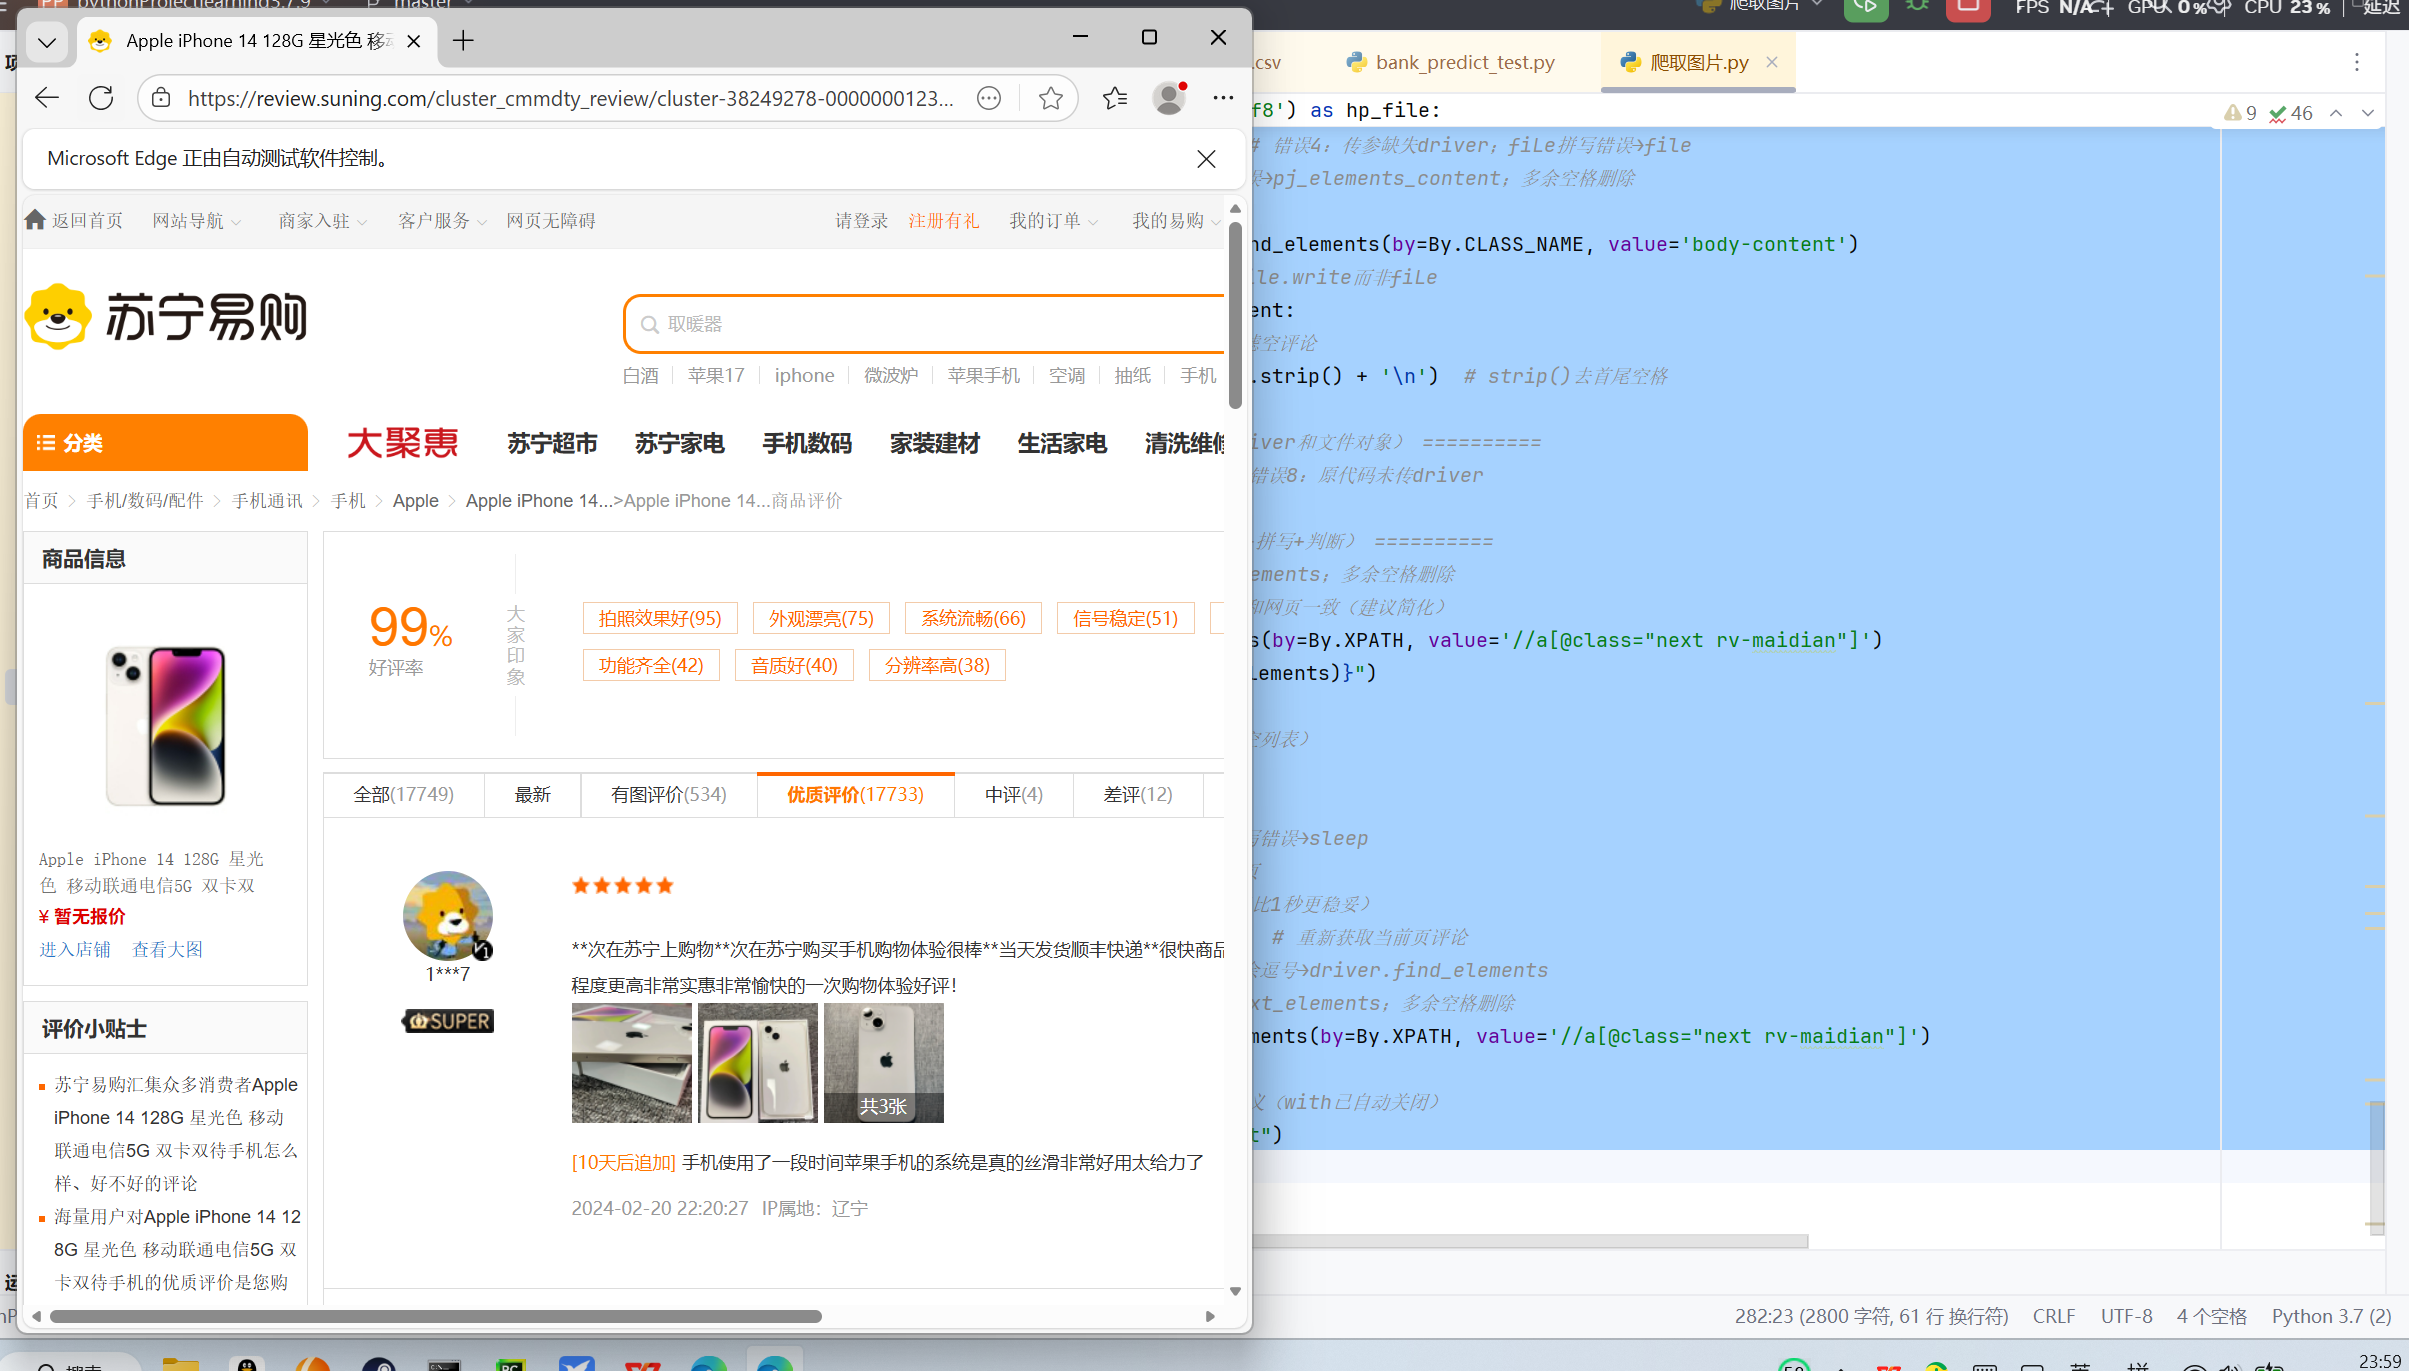
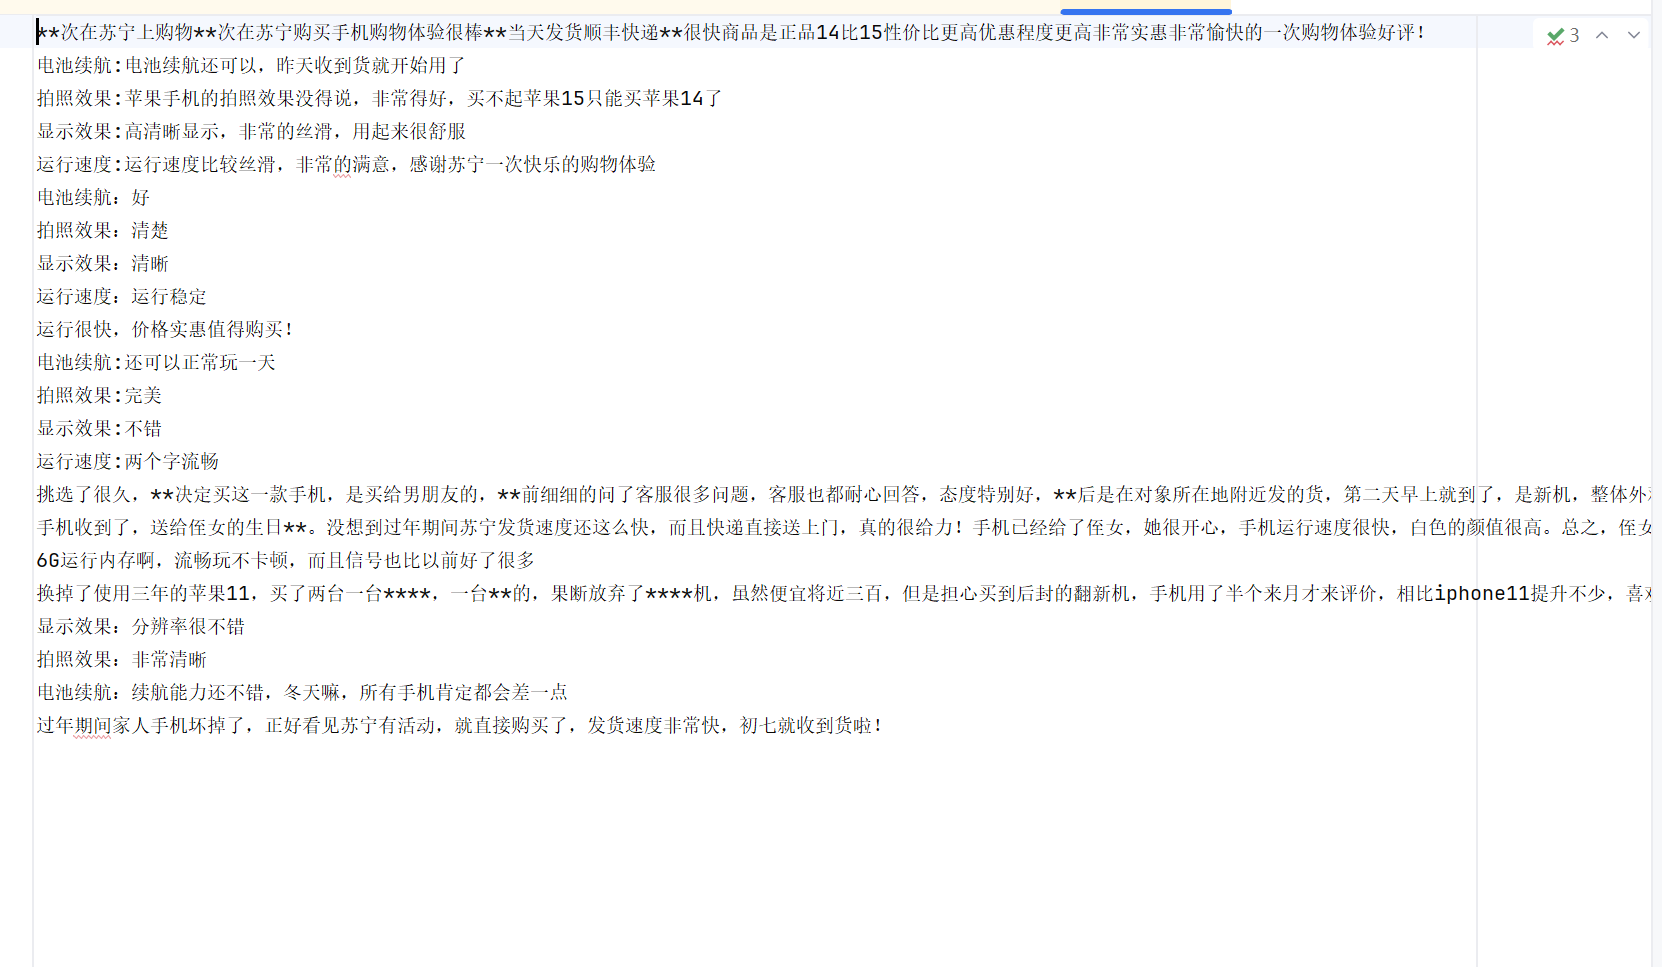
爬取购物网站好评,并变成文档
python
from selenium import webdriver
from selenium.webdriver.edge.options import Options
from selenium.webdriver.common.by import By
import time
import os

# ========== 核心修复1:路径错误 + 驱动配置 ==========
# 错误1:路径多余空格 + AppLication拼写错误(L大写)
EDGE_BROWSER_PATH = r"C:\Program Files (x86)\Microsoft\Edge\Application\msedge.exe"
# 错误2:必须指定EdgeDriver路径(解决找不到驱动问题)
EDGEDRIVER_PATH = r"C:\Users\叶梓聪\AppData\Local\Programs\Python\Python37\msedgedriver.exe"

# ========== 核心修复2:配置Edge浏览器并启动 ==========
edge_options = Options()
edge_options.binary_location = EDGE_BROWSER_PATH  # 正确的浏览器路径
edge_options.add_experimental_option('excludeSwitches', ['enable-logging'])  # 关闭日志干扰
# 临时将驱动路径加入环境变量(避免PATH问题)
os.environ["PATH"] = os.path.dirname(EDGEDRIVER_PATH) + os.pathsep + os.environ["PATH"]

# 启动浏览器(必须先启动driver,才能用driver定位元素)
driver = webdriver.Edge(options=edge_options)
driver.maximize_window()
driver.implicitly_wait(10)  # 元素定位超时时间(防页面加载慢)
# 补充:打开目标网页(你原代码缺失,需替换为实际爬取评论的网址)
driver.get("https://review.suning.com/cluster_cmmdty_review/cluster-38249278-000000012389328846-0000000000-1-good.htm?originalCmmdtyType=general&safp=d488778a.10004.loverRight.166")  # 替换为你要爬取评论的页面URL

# ========== 核心修复3:文件操作(用with更安全) ==========
# 错误3:直接open文件未做容错,改用with上下文管理器(自动关闭)
with open('好评1.txt', 'w', encoding='utf8') as hp_file:
    # ========== 核心修复4:函数定义(传参+拼写+语法) ==========
    def get_py_content(driver, file):  # 错误4:传参缺失driver;fiLe拼写错误→file
        # 错误5:pj_elments_content拼写错误→pj_elements_content;多余空格删除
        # 错误6:driver未传参,需作为参数传入
        pj_elements_content = driver.find_elements(by=By.CLASS_NAME, value='body-content')
        # 错误7:elment拼写错误→element;file.write而非fiLe
        for element in pj_elements_content:
            if element.text:  # 容错:过滤空评论
                file.write(element.text.strip() + '\n')  # strip()去首尾空格

    # ========== 核心修复5:调用函数(传入driver和文件对象) ==========
    get_py_content(driver, hp_file)  # 错误8:原代码未传driver

    # ========== 核心修复6:下一页逻辑(语法+拼写+判断) ==========
    # 错误9:next_elements拼写错误→next_elements;多余空格删除
    # 错误10:XPath中class值末尾多余空格,需和网页一致(建议简化)
    next_elements = driver.find_elements(by=By.XPATH, value='//a[@class="next rv-maidian"]')
    print(f"找到下一页按钮数量:{len(next_elements)}")

    # 错误11:while判断逻辑优化(判断长度而非空列表)
    while len(next_elements) > 0:
        next_element = next_elements[0]
        time.sleep(1)  # 错误12:sLeep拼写错误→sleep
        next_element.click()  # 点击下一页
        time.sleep(2)  # 等待页面加载完成(比1秒更稳妥)
        get_py_content(driver, hp_file)  # 重新获取当前页评论
        # 错误13:driver,find_elements多余逗号→driver.find_elements
        # 错误14:next_eLements拼写错误→next_elements;多余空格删除
        next_elements = driver.find_elements(by=By.XPATH, value='//a[@class="next rv-maidian"]')

# 错误15:原代码hp_file.close()在with外无意义(with已自动关闭)
print("✅ 评论爬取完成,文件已保存为 好评1.txt")
driver.quit()  # 关闭浏览器