yarn向hive提交队列的方式

在YARN集群中,向Hive任务指定提交队列的方式主要通过以下步骤实现:

一、永久性配置(修改Hive配置文件)

  1. 修改 hive-site.xml 文件,添加队列参数:

    mapreduce.job.queuename your_queue_name

此配置对所有Hive会话生效。


二、临时指定(会话级覆盖)

在Hive CLI/Beeline会话中动态设置:

复制代码
SET mapreduce.job.queuename=your_queue_name;

此配置仅对当前会话生效。


三、任务级指定(HiveQL语句中)

在具体查询前添加设置指令:

复制代码
SET mapreduce.job.queuename=high_priority_queue;
SELECT ... FROM ...; -- 实际查询语句

四、验证队列生效

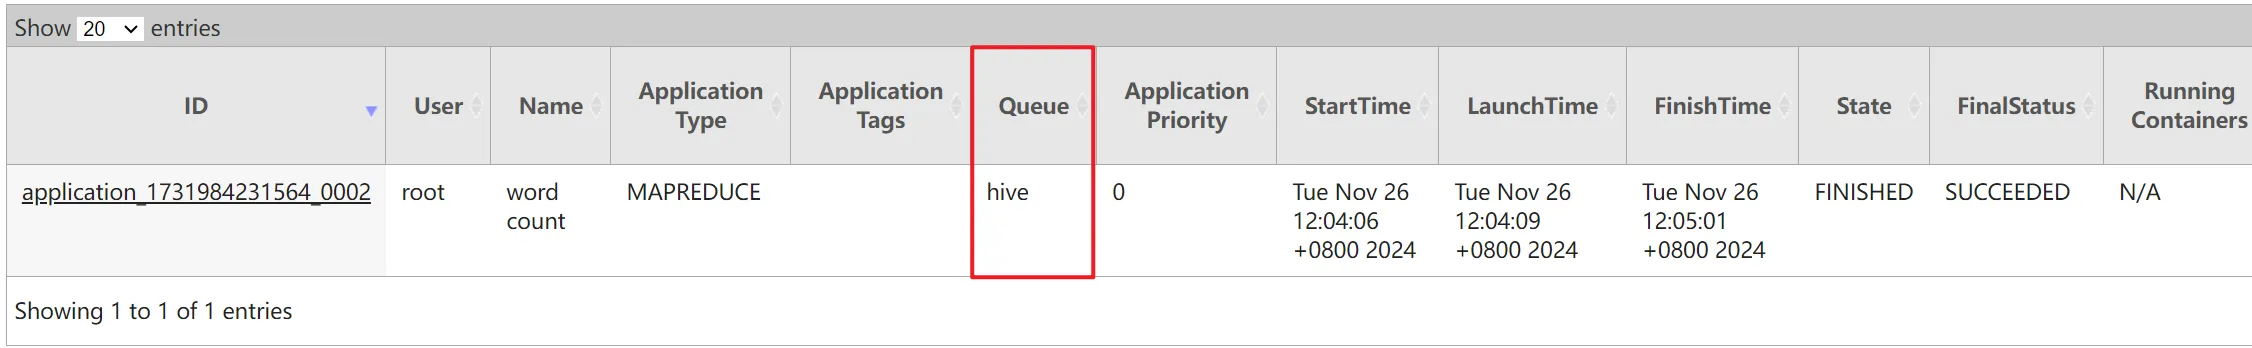
提交任务后,通过YARN ResourceManager UI查看:

  1. 访问 http://<rm-host>:8088/cluster/apps
  2. 在应用列表中确认 Queue 列显示指定队列名

注意事项

  1. 队列名需与YARN中预先配置的队列一致(通过 capacity-scheduler.xml 定义)

  2. 权限要求:用户需具有目标队列的提交权限

  3. 资源限制:队列资源不足时任务可能等待或失败

    示例:提交到名为 "bi_queue" 的队列

    hive -e "SET mapreduce.job.queuename=bi_queue; SELECT COUNT(*) FROM sales;"

相关推荐
茶海棠1 天前
Hadoop+zookeeper+HBase+Kafka集群搭建全流程
hadoop·zookeeper·kafka·hbase
全栈陈序员1 天前
【Git】从入门到精通(二)—— Git安装与初次配置
数据仓库·git
skywalk81631 天前
卡不等于分支:我用 TRAE 宝配合 Hive 跑三张任务卡的一天
运维·人工智能·hive·trae
程序员梅雨1 天前
【从零开始学习数据仓库 | 第三篇】: Flume——数据采集基石
java·大数据·数据仓库·后端·学习·flume
freejackman2 天前
【架构篇】双遍历 + 多栈协同:手撸 SQL 血缘引擎的架构思考
java·大数据·数据库·hive·sql·架构·spark
陈年老古董2 天前
ClickHouse 单机搭建记录
hive·笔记·学习·clickhouse·硬件架构
Gl�ria2 天前
Hadoop 速刷:HDFS / MR / YARN / Spark / Hive
hadoop·hdfs·mr
陈年老古董2 天前
Spark 3.1.3 集群搭建 + Spark-SQL 整合 Hive 记录
hive·sql·spark
FserSuN2 天前
Hive 分区表存储与查询优化学习总结
hive·hadoop·学习
注塑机数据采集联网3 天前
数据采集网关入门:ZK-D1/D3从零开始构建你的数据运用
大数据·数据仓库·人工智能·物联网·数据库架构·注塑机网关