RDMA设计19:RoCE v2 发送及接收模块设计

本博文主要交流设计思路,在本博客已给出相关博文约150篇,希望对初学者有用。注意这里只是抛砖引玉,切莫认为参考这就可以完成商用IP设计。若有NVME或RDMA 产品及项目需求,请看B站视频后联系。

RoCE v2 发送及接收模块负责将用户指令组装为 RoCE v2 数据包或从 RoCE v2数据包中解析出远程主机信息及数据。RoCE v2 发送及接收模块的结构和数据转移方式如图1所示。RoCE v2 发送及接收模块均由五个单元组成,分别为 SEND 单元、READ 单元、WRITE 单元、ACK 单元和 REP 单元。其中 SEND 单元、READ 单元及WRITE 单元负责组装或解析这三种类型的请求包,而 ACK 单元与 REP 单元则负责组装或解析这两种类型的回复包。
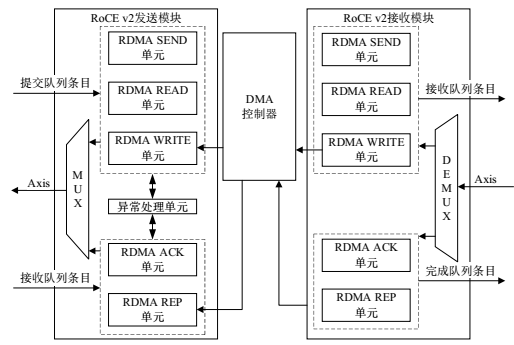
图1 RoCE v2 发送及接收模块结构及数据转移图

在 RoCE v2 协议中,SEND 指令为双边语义,发送及接收均需要远程主机 CPU 参与,数据交换速率相对较慢、延迟相对较高。因此在RoCE v2 发送及接收模块中,SEND 单元只用于进行主机间的信息参数交换,不直接涉及大批量的数据传输操作,可以在一定程度上降低传输延迟、增加数据吞吐量。而DMA 控制器在其中负责数据交换,即把 AXI4 总线接口的数据和 AXI-Stream 总线接口的数据进行相互转换,分别与直接涉及到数据操作的 WRITE 单元和 REP 单元相连接。接下来将分别对 RoCE v2 发送和接收模块的结构设计和工作流程进行具体分析。

B站已给出相关性能的视频,如想进一步了解,请搜索B站用户:专注与守望

https://www.bilibili.com/video/BV1mPV5eCE8z/?spm_id_from=333.337.search-card.all.click\&vd_source=c355545d27a44fe96188b7caefeda6e7

相关推荐
Eloudy1 天前
开源 gpunetio examples 01 解析 gpunetio_verbs_put_bw
gpu·fpga·rdma·roce·doca
Eloudy2 天前
GPUNetIO开源实现与FPGA的 RoCEv2 通信延迟实验
gpu·fpga·rdma·roce·doca
gwf2163 天前
AI训练RDMA性能Profiling:瓶颈定位与调优方法论
芯片设计·rdma·nccl·拥塞控制·ai集群·rnic·gpudirect
Eloudy3 天前
RDMA 乒乓示例:CX5 <-> CX6 DX(QSFP28 直连)
rdma·roce·doca
Eloudy3 天前
cpu rdma 与 gpunetio 的关系
gpu·rdma·roce·doca
HHFQ3 天前
Linux RDMA命令行工具使用手册
rdma
gwf2164 天前
AI RDMA网络的光互联:CPO与硅光子技术前瞻——基于芯片设计验证与系统级协同的深度剖析
rdma·dpu·cpo·ibgda·ai集群网络·硅光子·光互联
gwf2166 天前
RDMA在联邦学习与跨DC训练中的应用:从协议栈到芯片微架构的深度解析
rdma·nccl·硬件加速·rocev2·dcqcn·gpudirect·ai集群网络
gwf2167 天前
AI RDMA流量工程:自适应路由与动态负载均衡 —— 架构篇:从芯片RTL到集群拓扑的算网协同设计
rdma·拥塞控制·dpu·ai集群·gpudirect·rail-optimized·自适应路由
gwf21610 天前
NVMe/RDMA传输层协议深度解析:RDMA原理、Queue Pair映射、内核实现与性能全栈剖析
linux内核·ssd·nvme·性能调优·rdma·存储协议·nvme/rdma