二级页表
前面文件系统部分讲过,磁盘中8个扇区,即一个块,大小为4kb是OS的读写最小单位。内存也是:
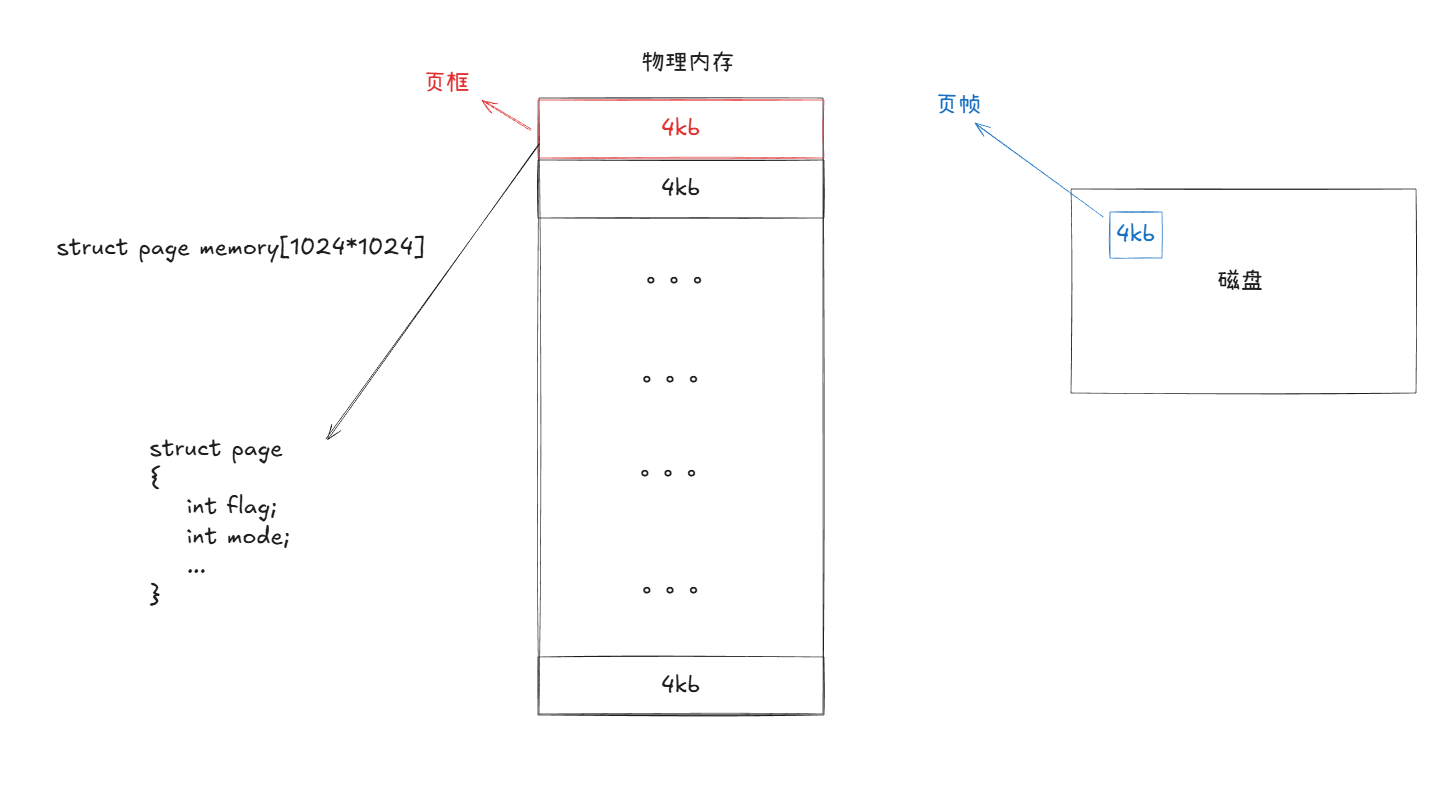
如上,我们将物理内存分成1024*1024个页框,每个页框由对应的结构体struct page管理。然后通过管理struct page的数组来实现管理物理内存。
磁盘中的数据块又称为页帧。
这其实告诉我们一件事情,拷贝都是以4096Byte的整数倍进行的,就算是父子进程写时拷贝一个整型的变量,也会直接拷贝4096个字节。
那么接下来我们再看到我们的虚拟地址的页表:
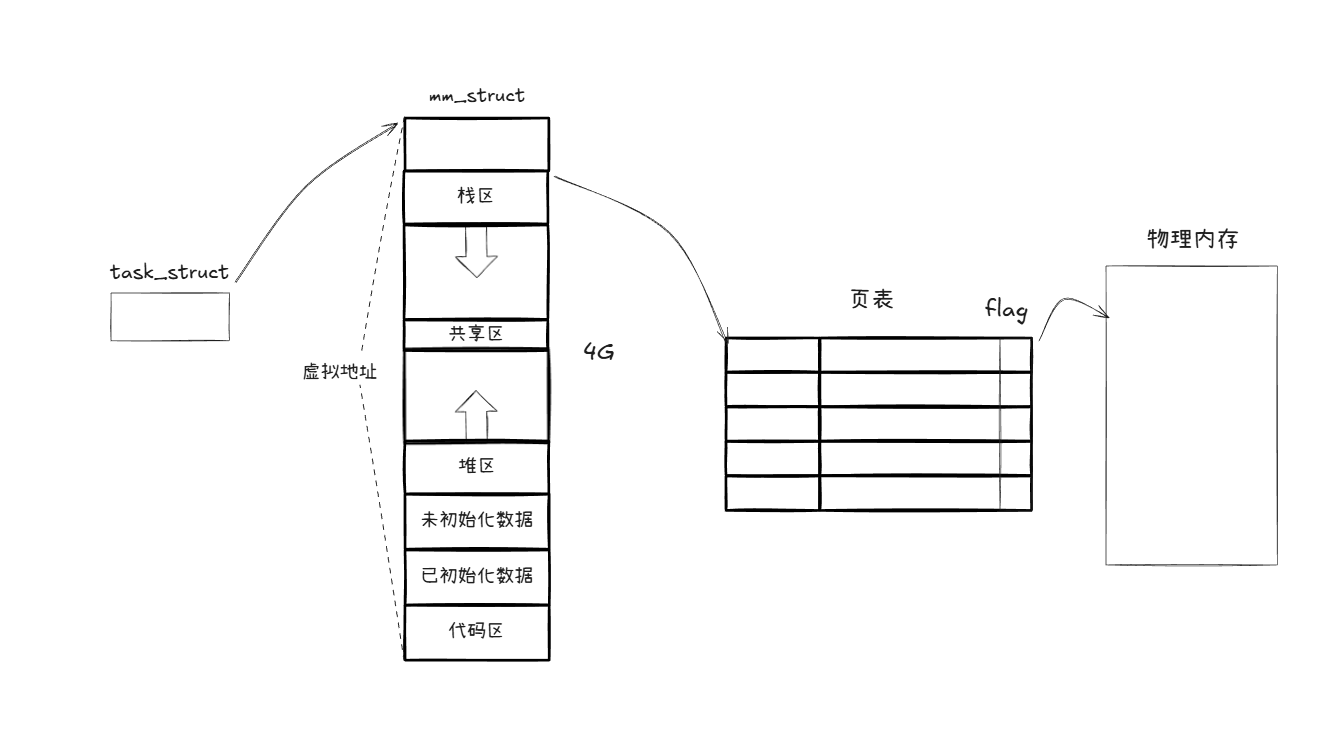
按照我们以前的理解,虚拟内存有4*1024字节即4G,如果每个字节的虚拟地址都在页表上对应一个物理地址再加上标记位。那么我们的页表大小就有9*1024字节,即9G。
这显然是不现实的,这说明页表其实不是简单的这个结构。
事实上我们的虚拟地址如:0b10000000000000000001001000110100分成三个部分,前十位、中间十位、最后十二位:1000000000 0000000001 001000110100.
我们以前十位作为索引生成页目录,页目录里存放二级页表的指针 。中间十位存放页表号。页表存放的是页框的起始地址 和一些标记位 。然后最后十二位就是相对于页框起始地址的偏移量:
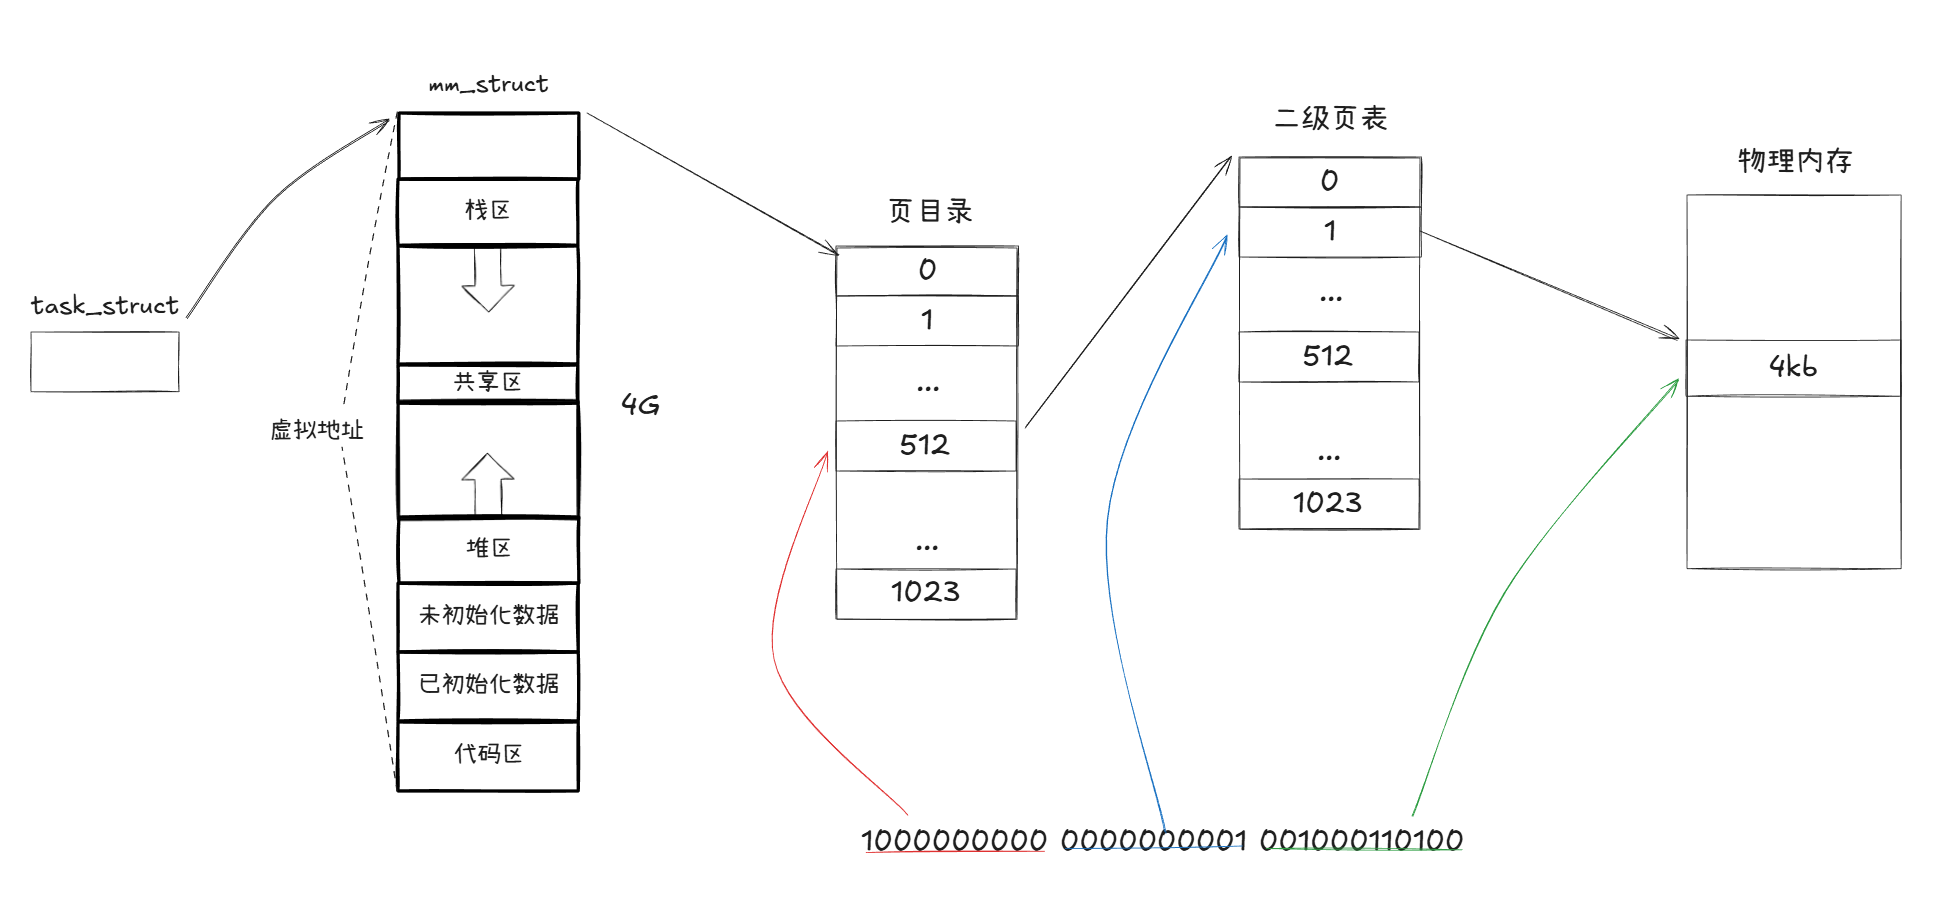
这样我们就能找到虚拟地址对应的物理地址字节地址。然后根据数据类型就能读取对应的字节。
简单来说虚拟地址和物理地址对应关系就是:
物理地址=struct page memory 页目录\[虚拟地址\>\>22\&0x3FF虚拟地址\>\>12\&0x3FF.页框起始地址 ]+虚拟地址&0xFFF
因此一个进程需要维护一个页目录+1024个页表,我们把页表里的标记位看成四个字节。页表+页目录大小为:1024*4+1024*1024*8=8MB+4KB.这个就相当小了。
那么现在我们就知道了进程的虚拟地址和物理地址映射的全过程,首先我们写一个简单函数:
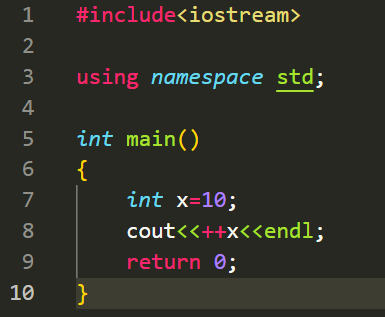
然后编译形成汇编文件:
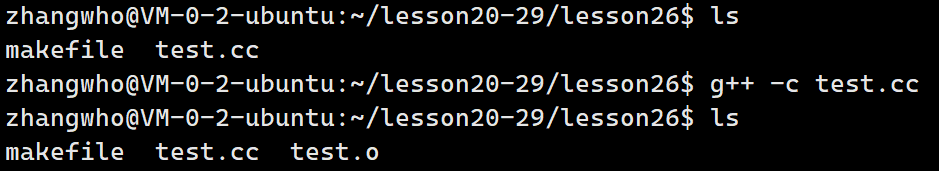
此时我们的虚拟地址以(平坦模式)形成了:
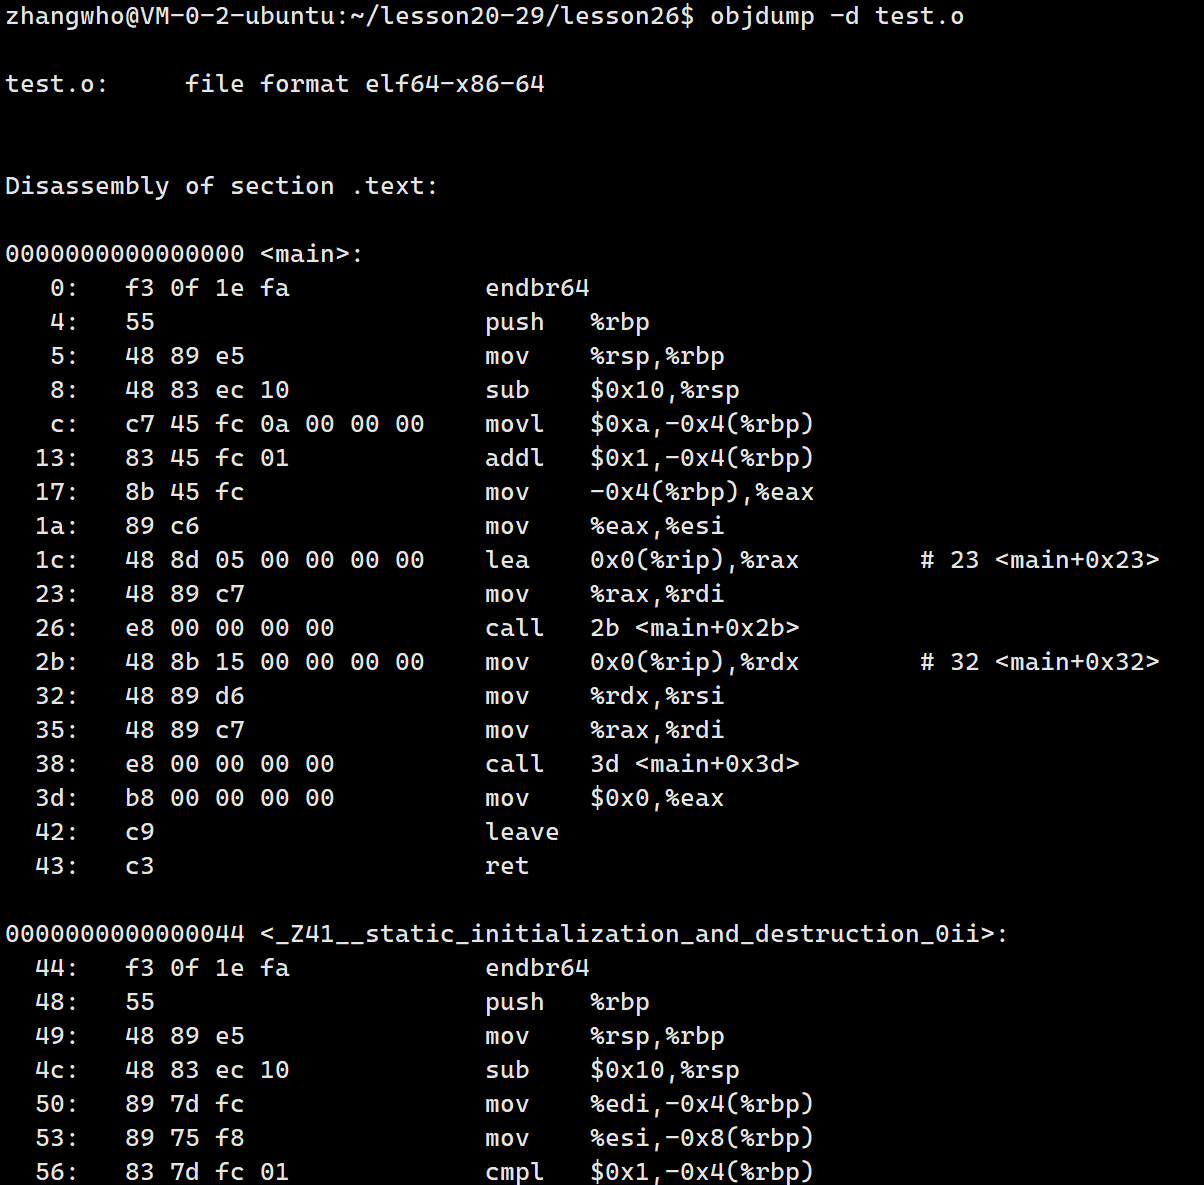
当进程载入内存时,CPU中的内存管理单元MMU就会读取虚拟地址,形成对应的物理地址映射放在页表中。页表地址则存储在另一个寄存器cr3上,页表存储在物理内存中。
从上面的虚拟地址也能看出,我们的函数也是有地址的,他的地址是代码块的起始地址。然后每一行代码也是有地址的,并且看作是连续的虚拟地址。理论上我们可以根据函数拆分页表,将虚拟地址作为一种资源分配给不同的函数。
线程的概念
线程:在进程内部运行,是CPU调度的基本单位
根据上面的理论,我们可以将代码区根据函数拆分成多个部分:
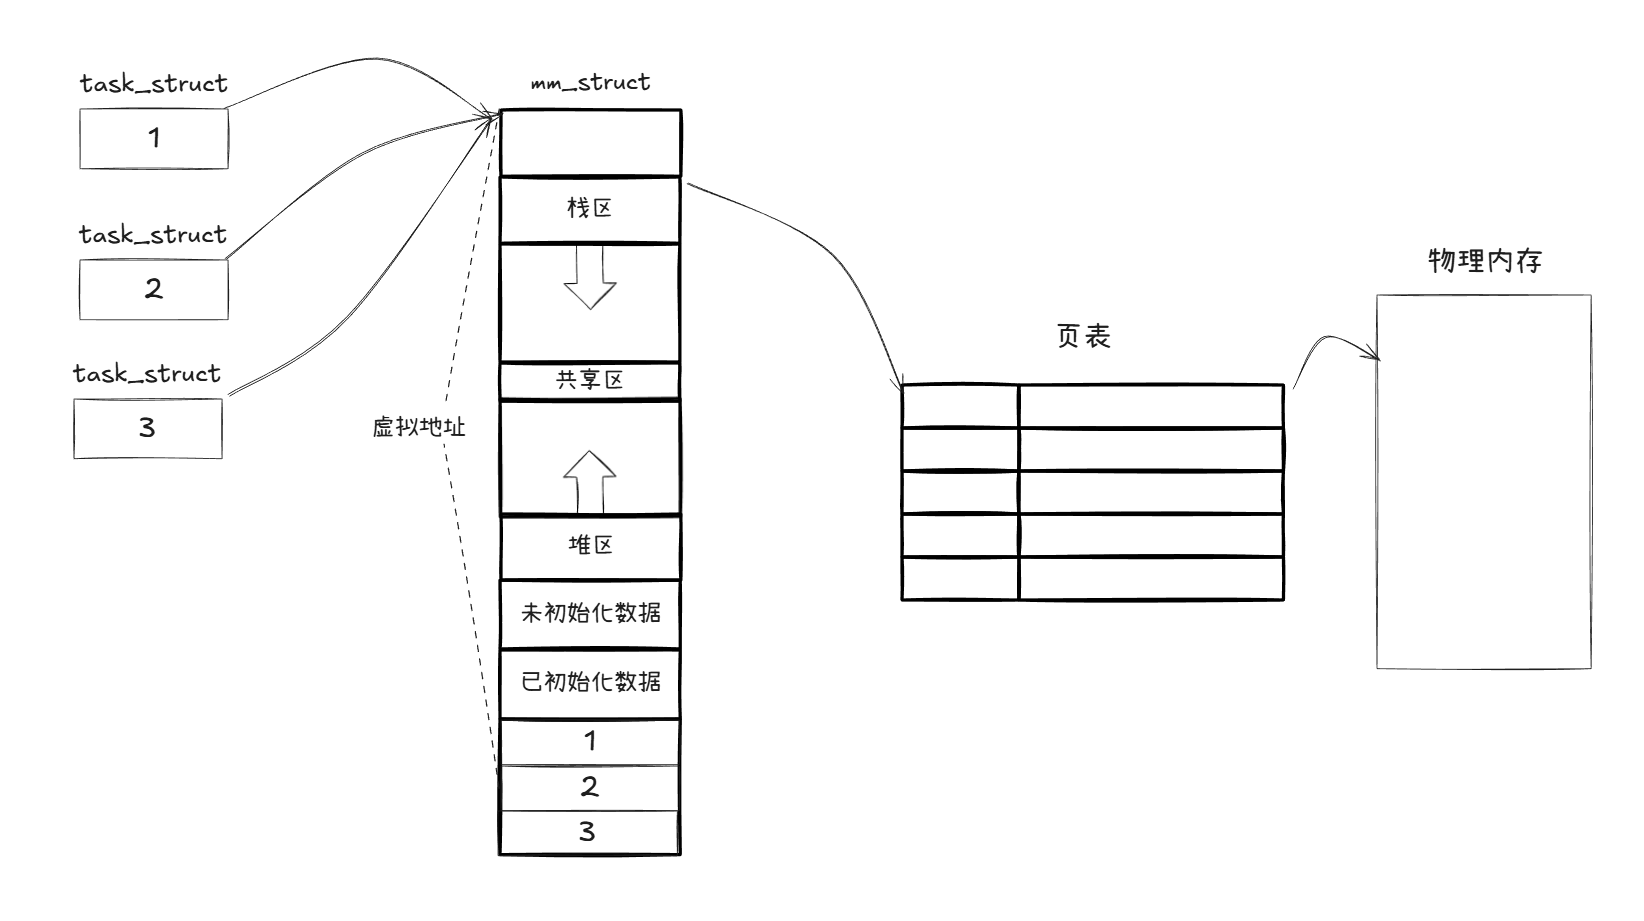
然后我们创建进程时,不创建新的虚拟地址和页表,共用一份页表。不同的进程执行不同的代码部分,称这些进程为执行流,这也就是所谓的线程。
这里我们把所有执行流看成一个进程,就是说进程是承担分配系统资源的基本实体。
Linux上的线程
- 如何管理一个线程?
想必和进程一样需要一个类似pcb的thread control block来管理每个线程,然后线程又要有独立的调度算法、优先级、上下文、对应的进程。
在Windows里面线程就是这样实现的。
注意到tcb里面的内容大多数pcb都有,因此Linux没有单独实现线程,而是将线程都看作进程。
OS将所有进程统一看成执行流,无需理会其是进程还是线程,总之执行就完了。
所以我们将linux上的进程称为轻量级进程。
简单使用线程代码
我们需要创建线程的库函数,pthread_creat:
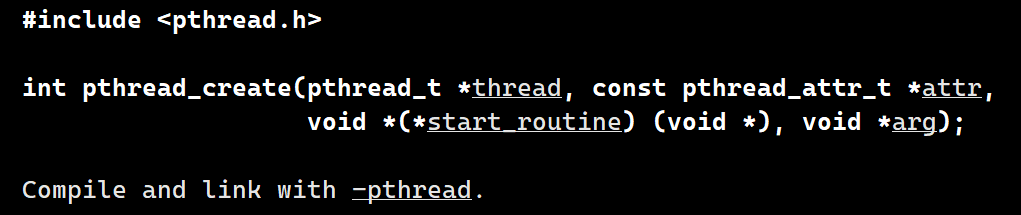
第一个参数是输出型参数,返回线程的tid。
第二个参数是用于设置线程的属性的,我们咱不理会。
第三个参数就是线程要执行的函数的指针,这个函数指针必须是返回void和参数为void 的。
第四个参数就是要传入给第三个参数的函数指针的参数。
使用这个函数我们还要链接第三方库pthread:
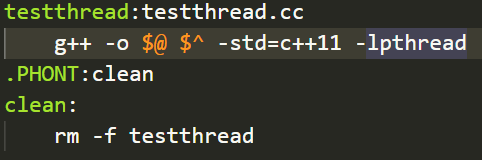
编写一个简单代码:
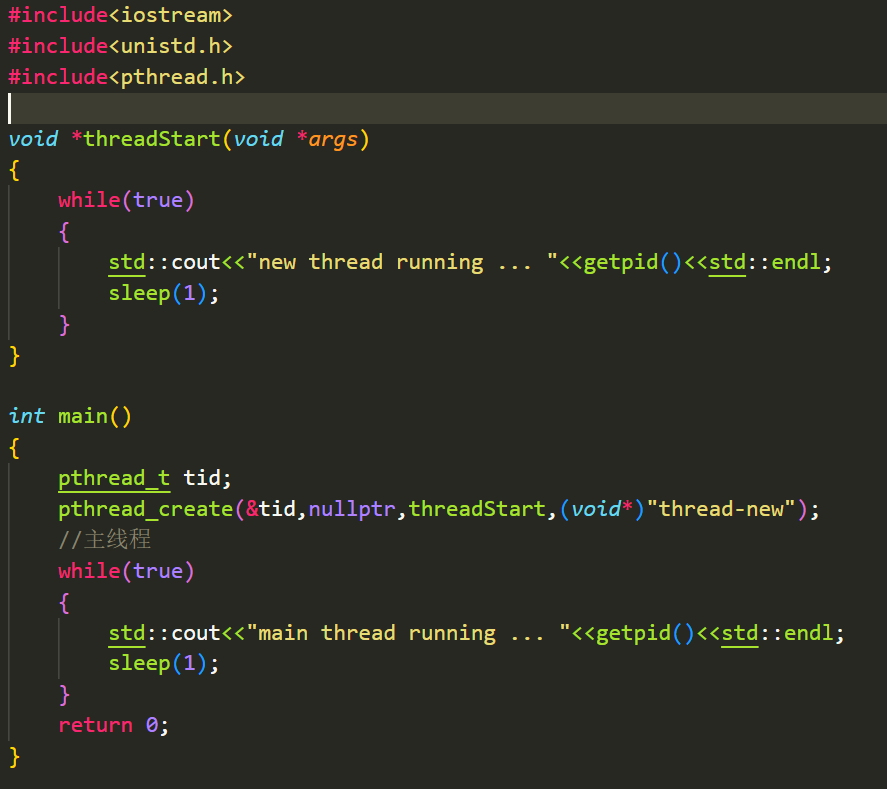
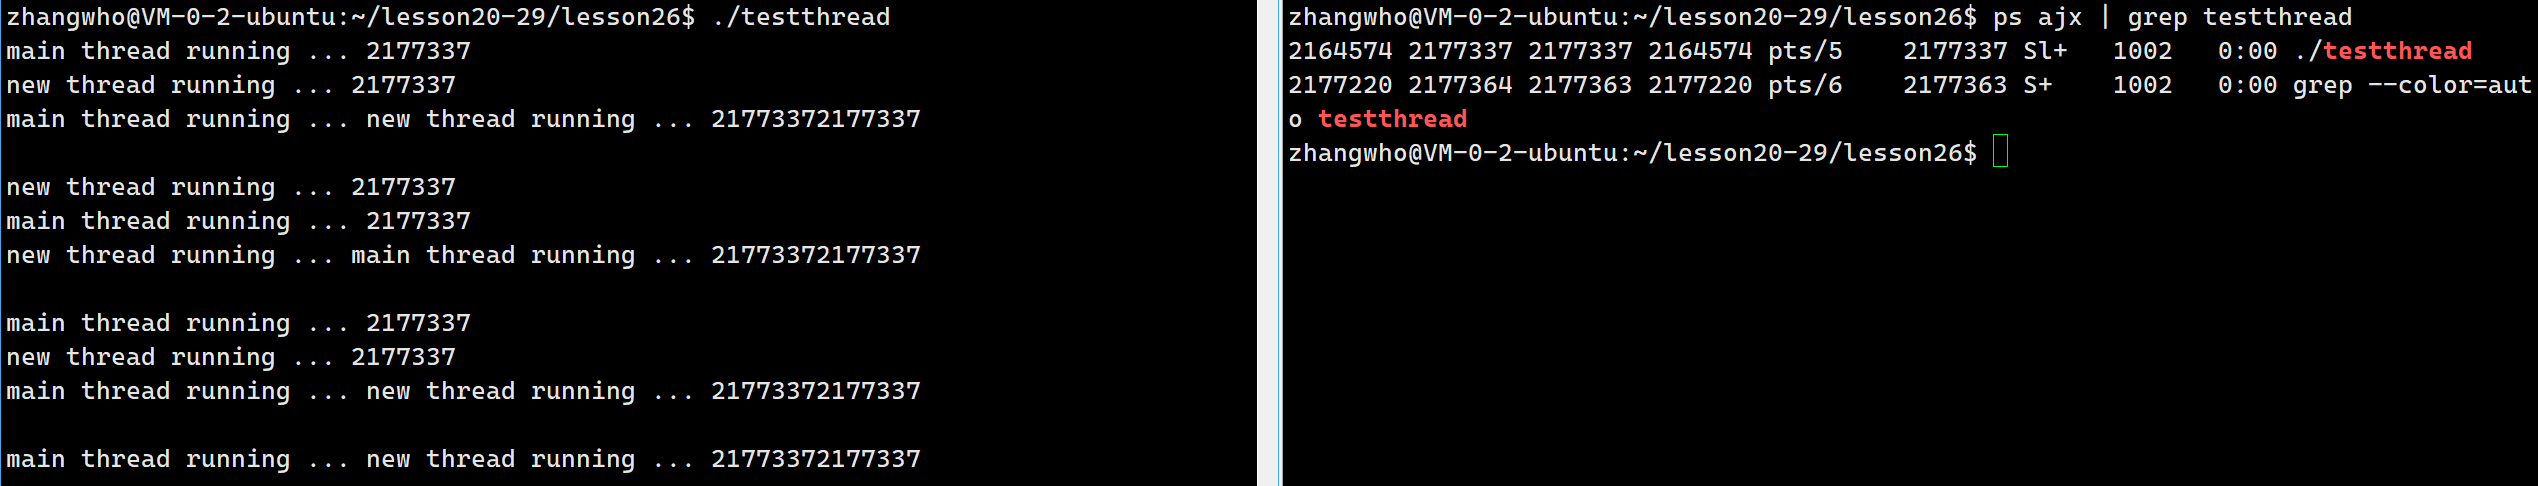
可以看到我们并发执行了两个死循环,并且这两个死循环有着一样的pid。那么OS如何区分他们呢?我们要用ps -aL来查看:
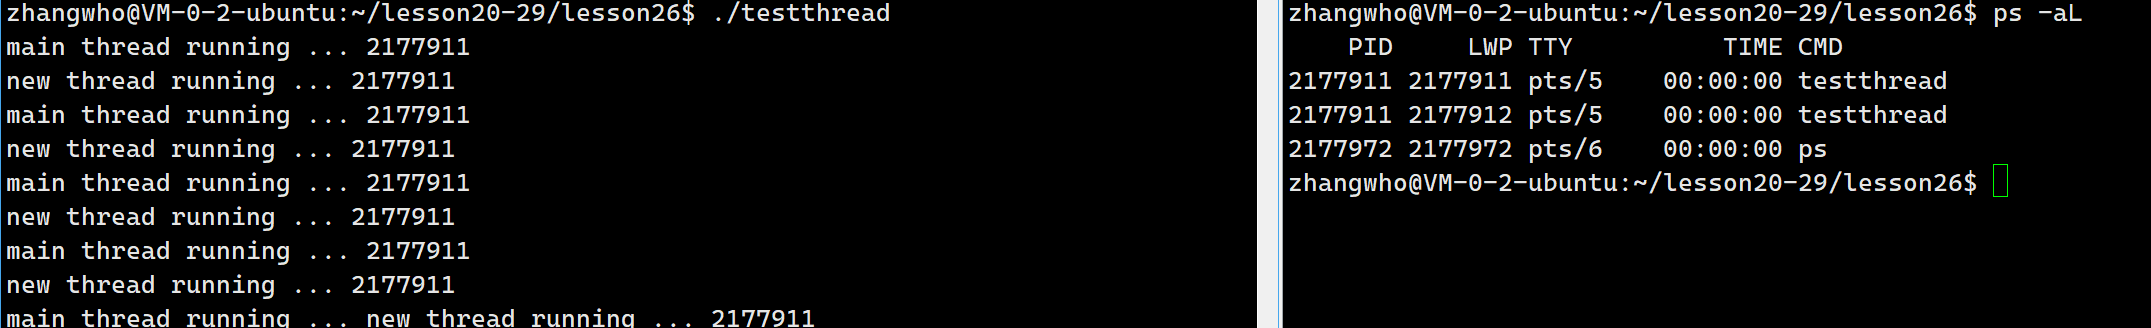
此时我们就看到了线程的pid和左边的对应上了。但是他们的lwp(light weight process 轻量级进程)id不同。所以OS是根据lwp来调度线程的。
我们将pid与lwp相同的线程称为主线程。
线程的优缺点
在linux已经有了进程的情况下为什么还需要线程,同理,在有了线程的情况下为什么还需要进程。这说明线程有其优点和缺点,根据上面线程和进程的不同,我们可以得出线程的以下优缺点。
优点:
- 创建一个新线程的代价要比创建一个新进程小得多
- 与进程之间的切换相比,线程之间的切换需要操作系统做的工作要少很多
- 线程占用的资源要比进程少很多
- 能充分利用多处理器的可并行数量
- 在等待慢速I/O操作结束的同时,程序可执行其他的计算任务
- 计算密集型应用,为了能在多处理器系统上运行,将计算分解到多个线程中实现
- I/O密集型应用,为了提高性能,将I/O操作重叠。线程可以同时等待不同的I/O操作。
缺点:
- 性能损失
一个很少被外部事件阻塞的计算密集型线程往往无法与共它线程共享同一个处理器。如果计算密集型线程的数量比可用的处理器多,那么可能会有较大的性能损失,这里的性能损失指的是增加了额外的同步和调度开销,而可用的资源不变。 - 健壮性降低
编写多线程需要更全面更深入的考虑,在一个多线程程序里,因时间分配上的细微偏差或者因共享了不该共享的变量而造成不良影响的可能性是很大的,换句话说线程之间是缺乏保护的。 - 缺乏访问控制
进程是访问控制的基本粒度,在一个线程中调用某些OS函数会对整个进程造成影响。 - 编程难度提高
编写与调试一个多线程程序比单线程程序困难得多
为什么线程调度成本更低
从软件的角度,线程切换时无需切换虚拟地址和页表。
从硬件的角度,CPU执行代码时,会优先访问CPU内部的一个硬件cache:
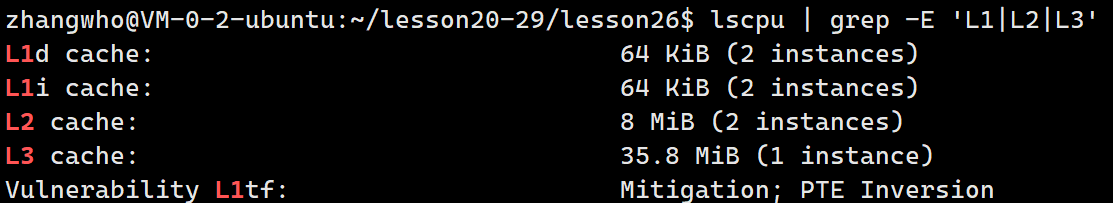
这个硬件也被称为高速缓存,里面存放着热数据也就是最常使用的代码。当cache里没有要执行的代码时才会访问内存,然后将内存上要执行的代码缓存到cache上。
线程调度的时候通常不需要cache拷贝,减少了拷贝花销,因此成本更低。
线程VS进程
- 进程是资源分配的基本单位
- 线程是调度的基本单位
- 线程共享进程数据,但也拥有自己的一部分数据:
- 线程ID
- 一组寄存器
- 栈
- errno
- 信号屏蔽字
- 调度优先级
其中寄存器和栈是显然的,多线程也可以执行同一个函数。如果没有不同的寄存器保存上下文就分不清线程执行到哪。同样的不同线程都要创建临时变量,所以每个线程都应该有自己的栈。
进程的多个线程共享 同一地址空间,因此Text Segment、Data Segment都是共享的,如果定义一个函数,在各线程中都可以调用,如果定义一个全局变量,在各线程中都可以访问到,除此之外,各线程还共享以下进程资源和环境:
- 文件描述符表
- 每种信号的处理方式(SIG_ IGN、SIG_ DFL或者自定义的信号处理函数)
- 当前工作目录
- 用户id和组id
pthread库
我们前面用linux创造线程函数时,编译时要带上第三方库pthread:
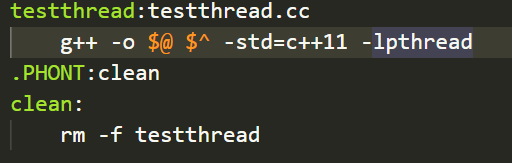
这是因为linux的确没有实现线程,底层是轻量级进程。因此linux没有封装线程相关的系统调用接口。但是大多数用户想要调用线程。因此linux会提供一个原生线程库对轻量级进程封装成线程给用户使用。
线程控制
线程创建
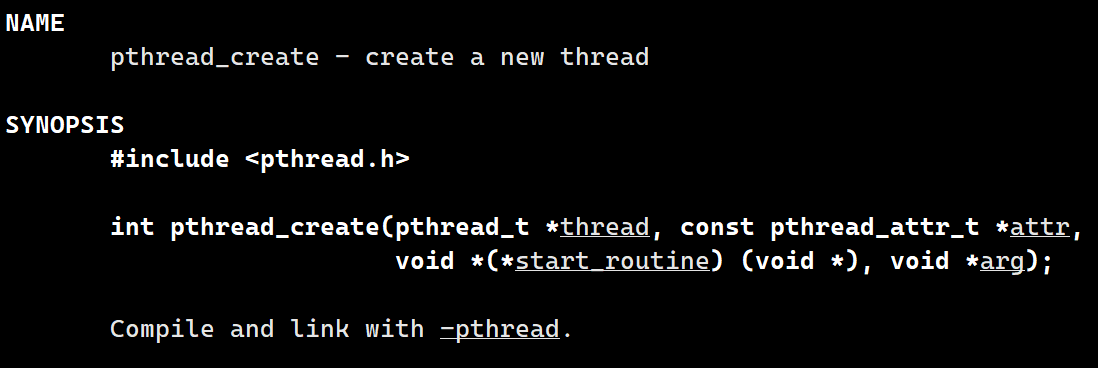
线程创建的具体参数含义上文已经提及,这里不多做赘述。
线程等待
和进程一样,我们的主线程也可以对线程进行等待以回收线程。用到的函数是pthread_join
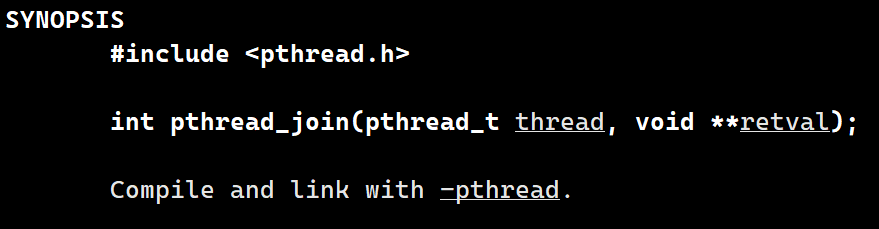

第一个参数是要等待的线程的tid,第二参数是一个输出型参数,返回的是该线程执行的函数的返回值。
等待成功返回值是0.
具体代码
我们先来编写一个简单的多线程代码:
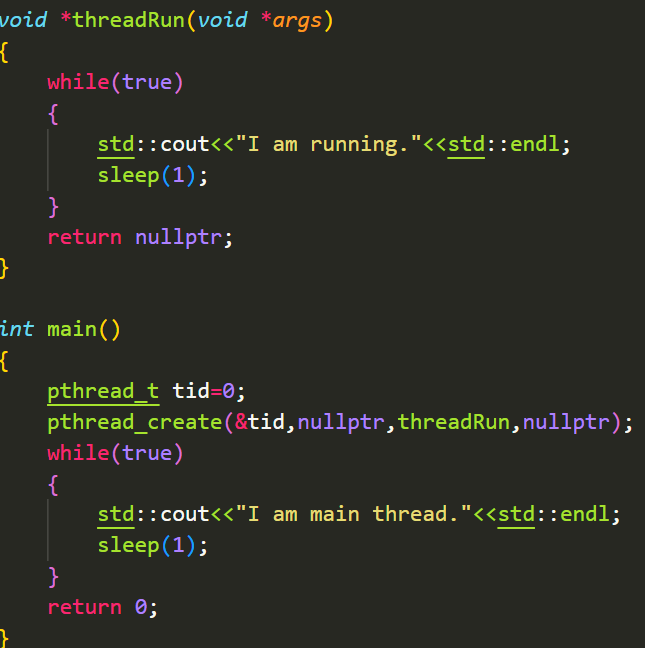
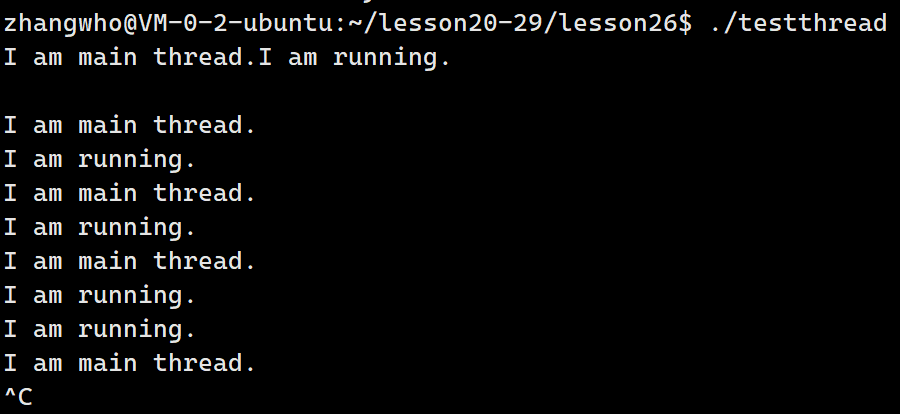
现在我有几个问题:
-
主线程和新线程谁先运行?
答案是不确定,就像多进程,谁先运行都是有可能的:
-
我们希望哪个线程最后退出?
先看下面代码:
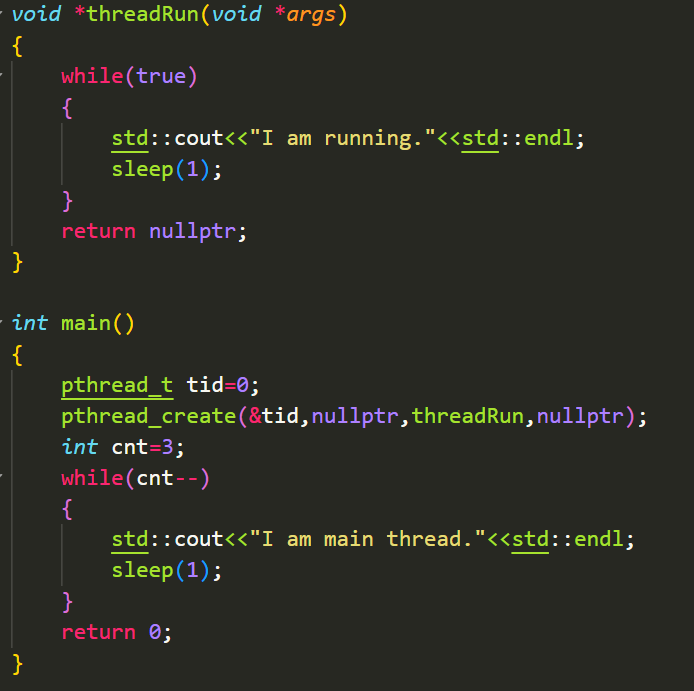
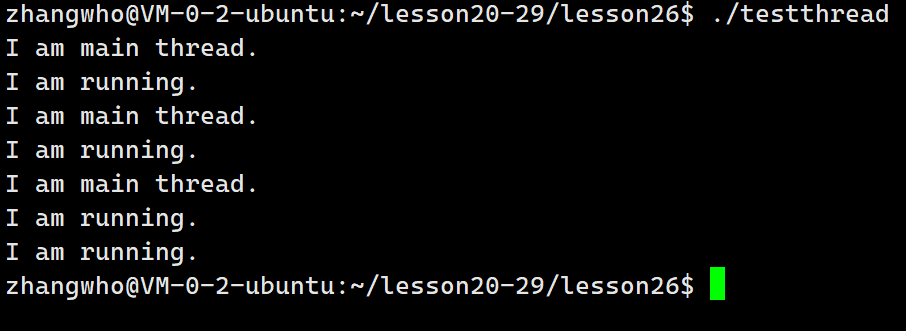
可以看到不管新线程任务有没有完成,主线程一退出,这个进程就结束了,所以其他线程也会跟着退出。
因此我们希望最后退出的是主线程,这又如何保证呢?
自然是对新线程等待:
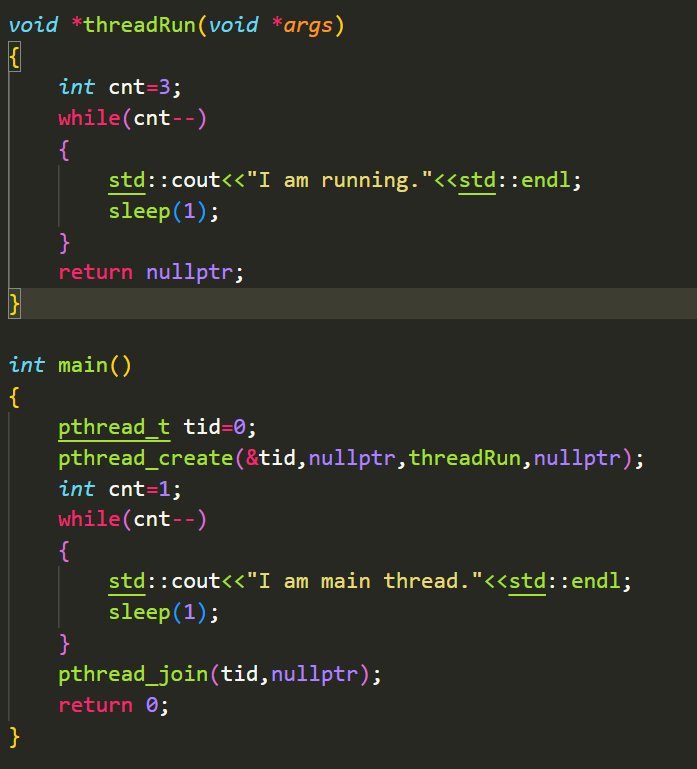
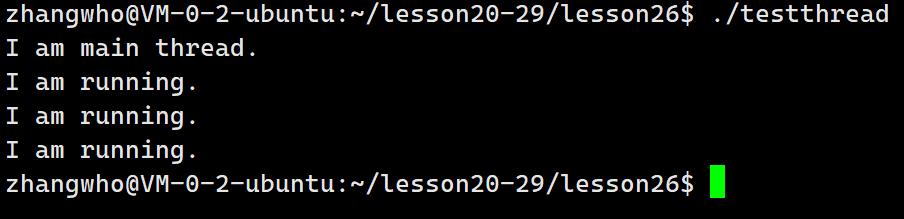
可以看到,当主线程执行完循环体后就对新线程进行等待,并且这一种等待是阻塞等待,主线程会等待新线程退出为止。
-
tid是什么,长什么样。
别的不说我们先打印一下m的信息:
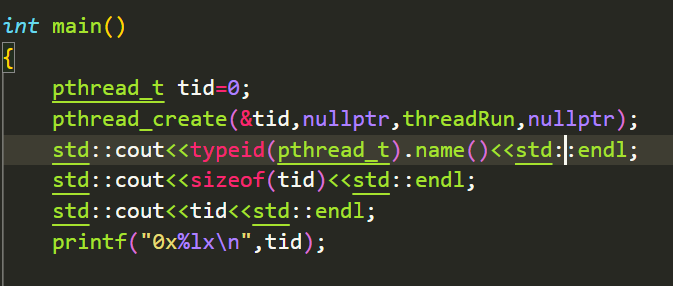
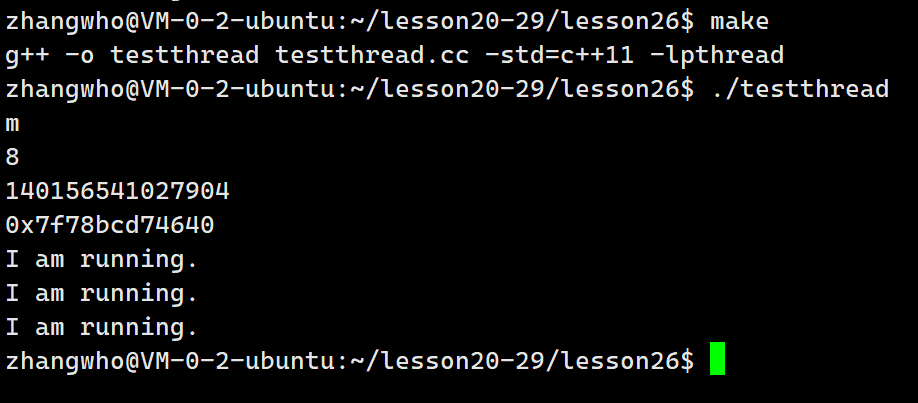
可以看到tid是m类型,在g++编译输出上,unsigned long long重命名为m。因此tid的类型是无符号长长整型。
由于我的linux系统是64位的,虚拟地址有8个字节。
实际上tid是一个地址,这个后面再继续谈论。
- 如何看待线程函数传参?
虽然说只能传一个void*参数,但事实上我们能传入所有类型的参数。只需要一个类或者结构体封装:
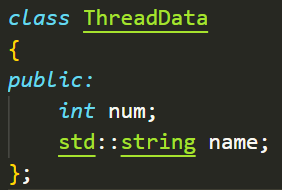
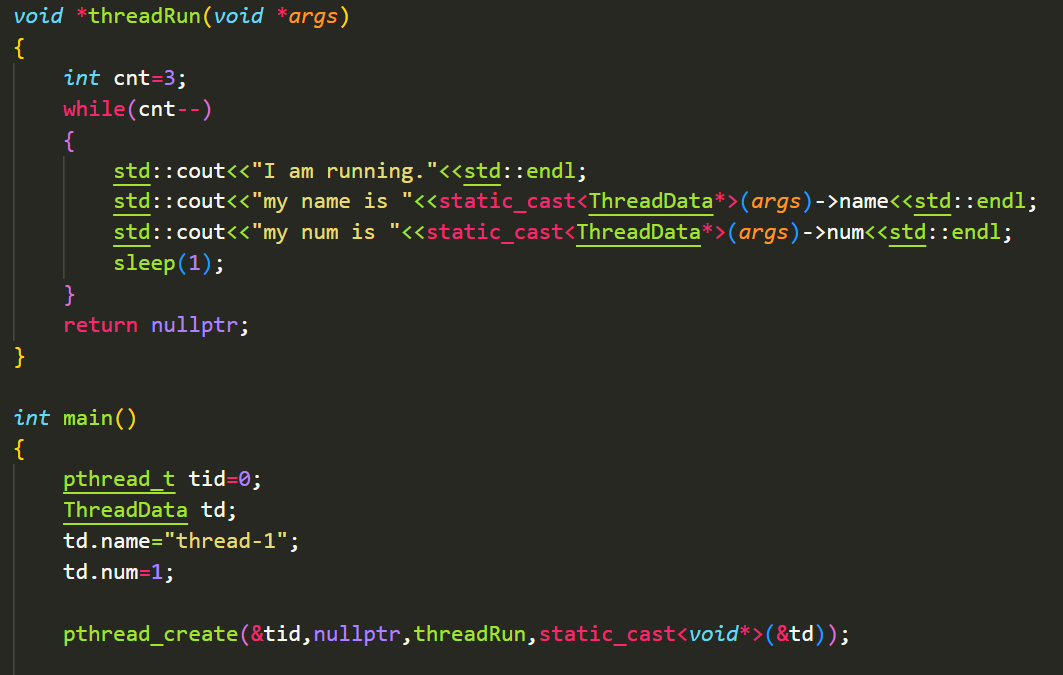
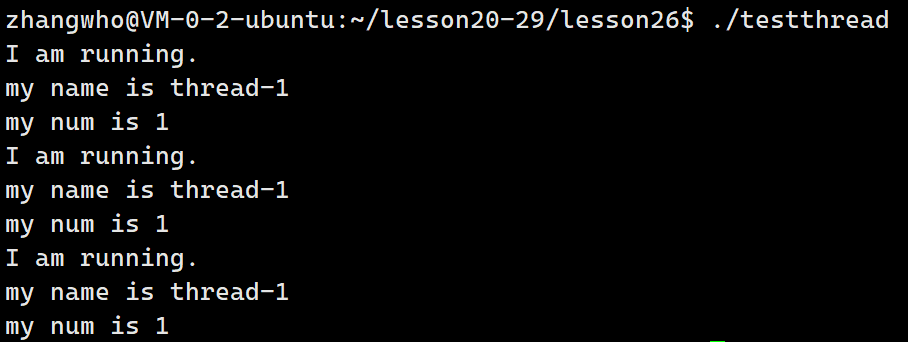
非常完美。
但我们最好不要在主线程上创建临时变量然后传入,这会有不好的效果,比如我们这里创建两个新线程:
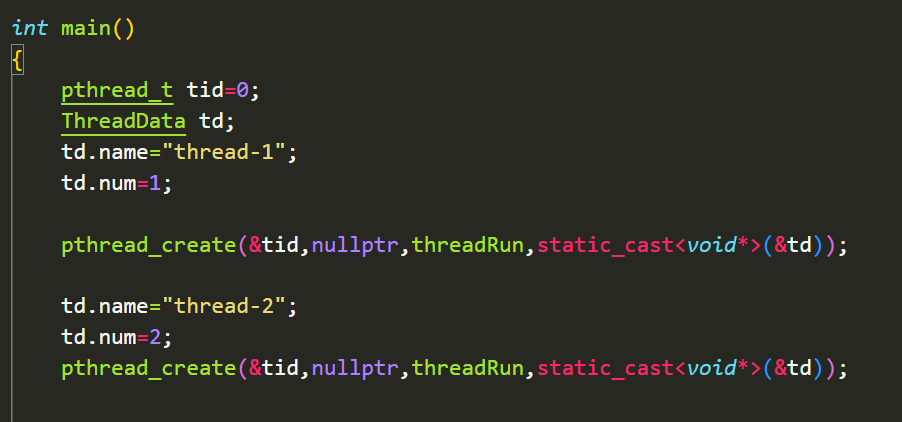
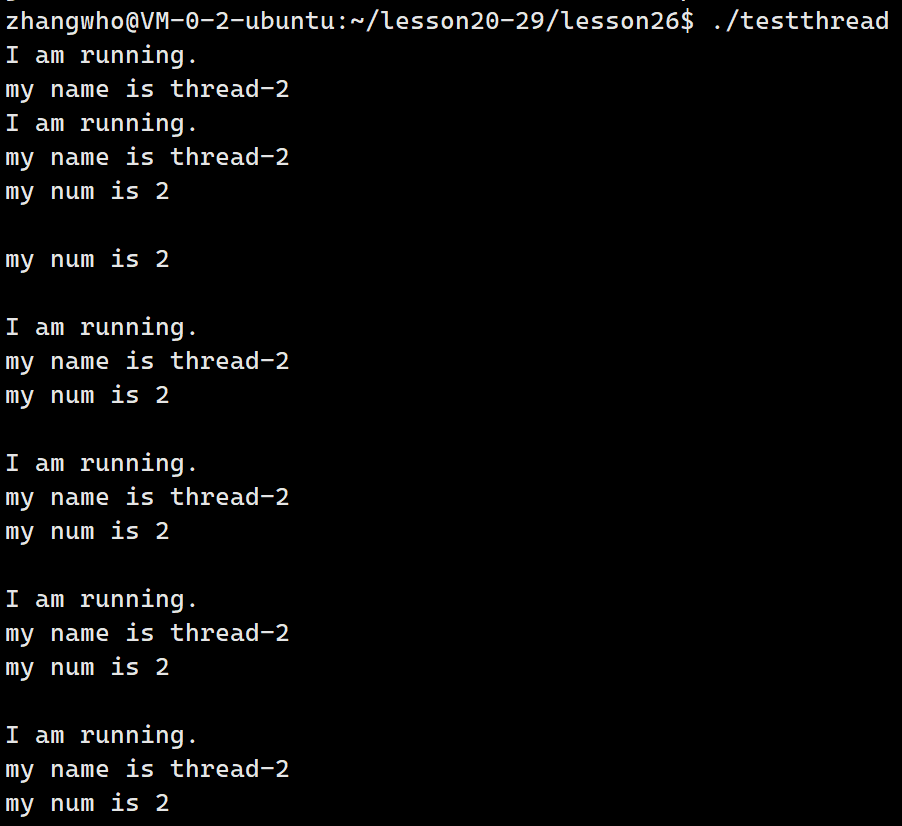
可以看到数据被覆盖了,这是因为我们多线程是共用虚拟地址的。最好的做法是在堆上开辟空间然后传递指针:
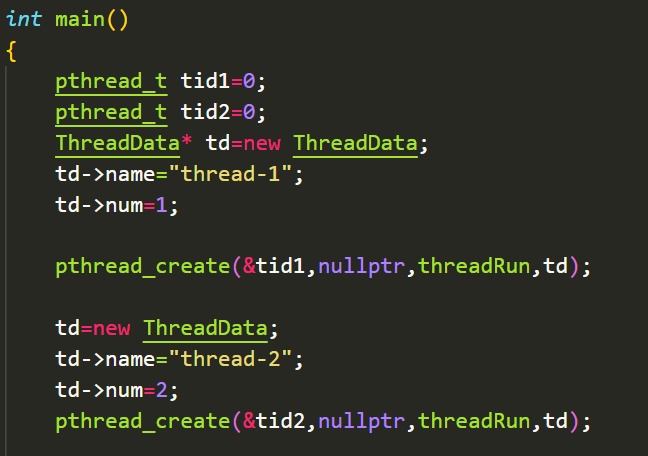
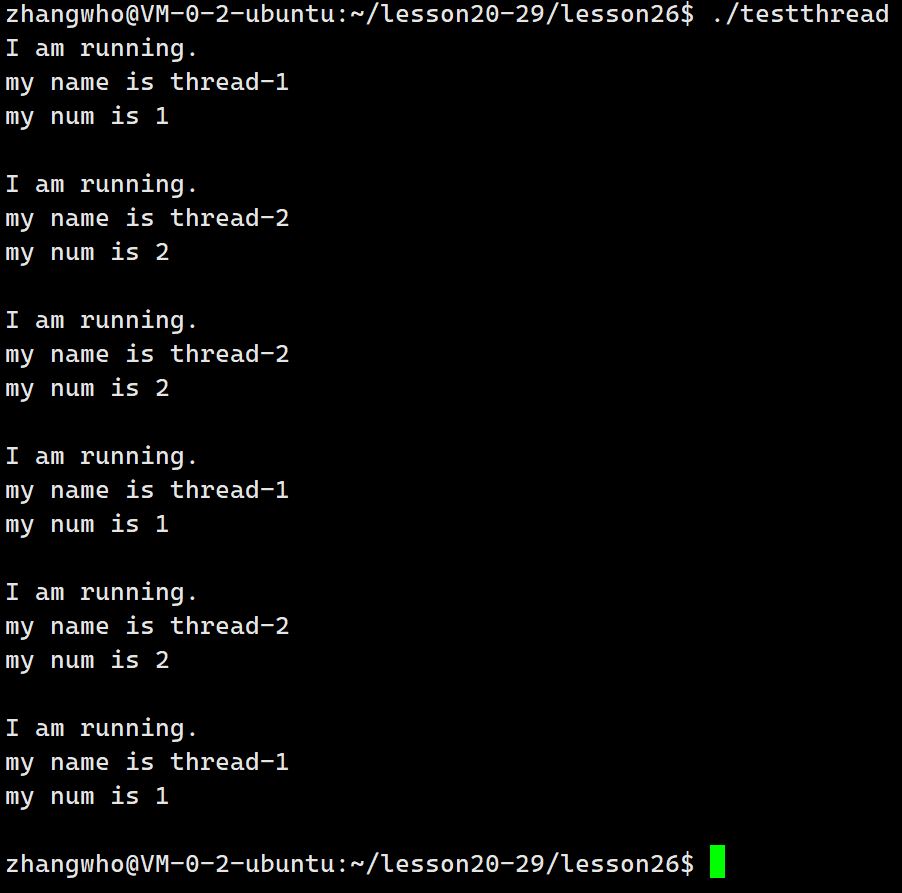
这下才完美执行了预期!
- 如何看待线程函数返回值?
a. 首先呢,我们的确可以将线程函数返回值看成线程退出码。但我们无需考虑线程函数异常,因为线程异常整个进程都挂了,所以一旦收到线程函数的返回值就必然是成功退出了。
b.和参数一样,我们自然可以返回任何类型的参数。只需要用一个类或结构体封装。这里就不做演示了。不过切记不要返回野指针哦!
创建多线程
- 我们要如何创建多线程?
注意前面的细节,我们不要传入临时变量而是传入指针:
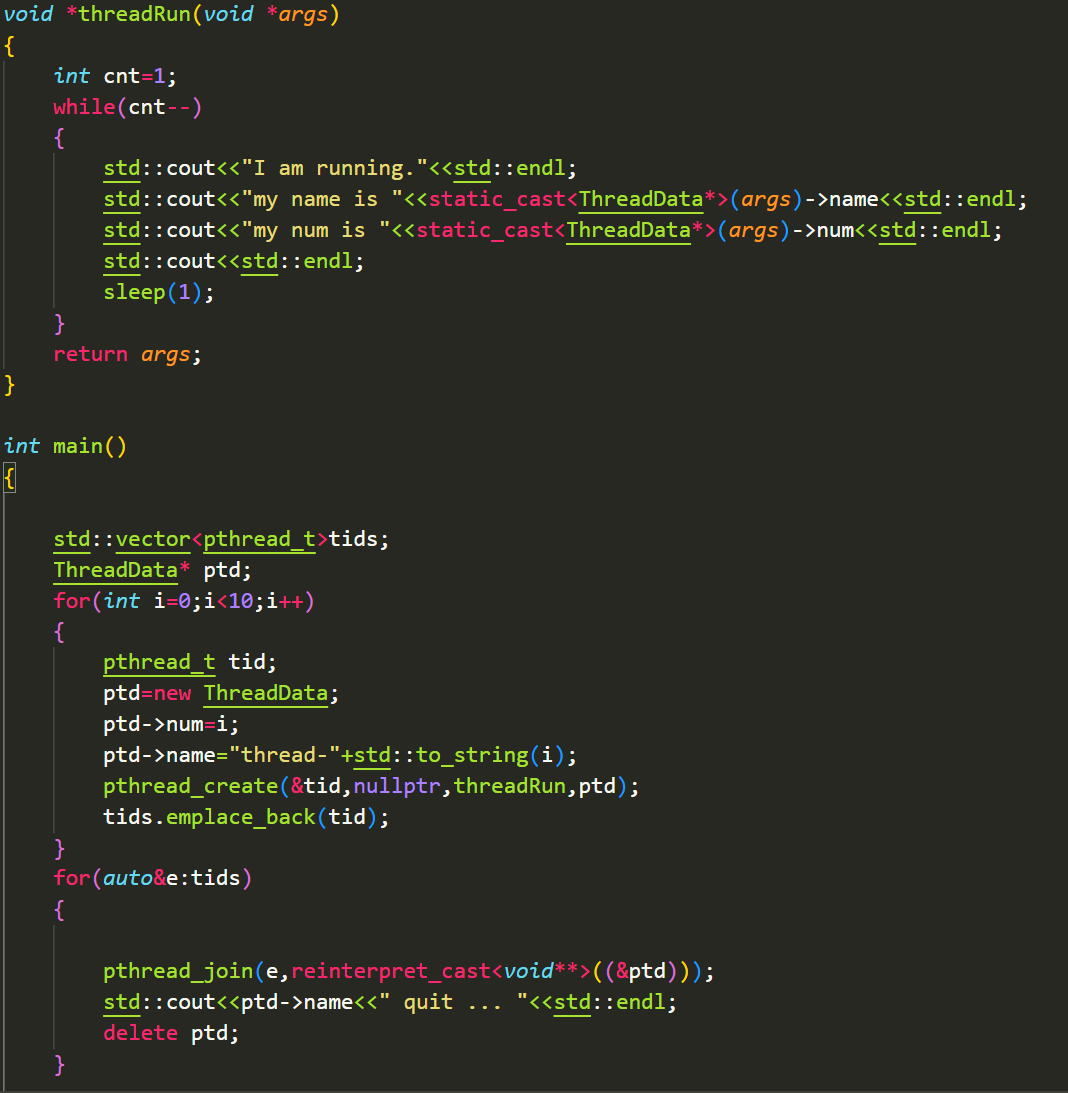
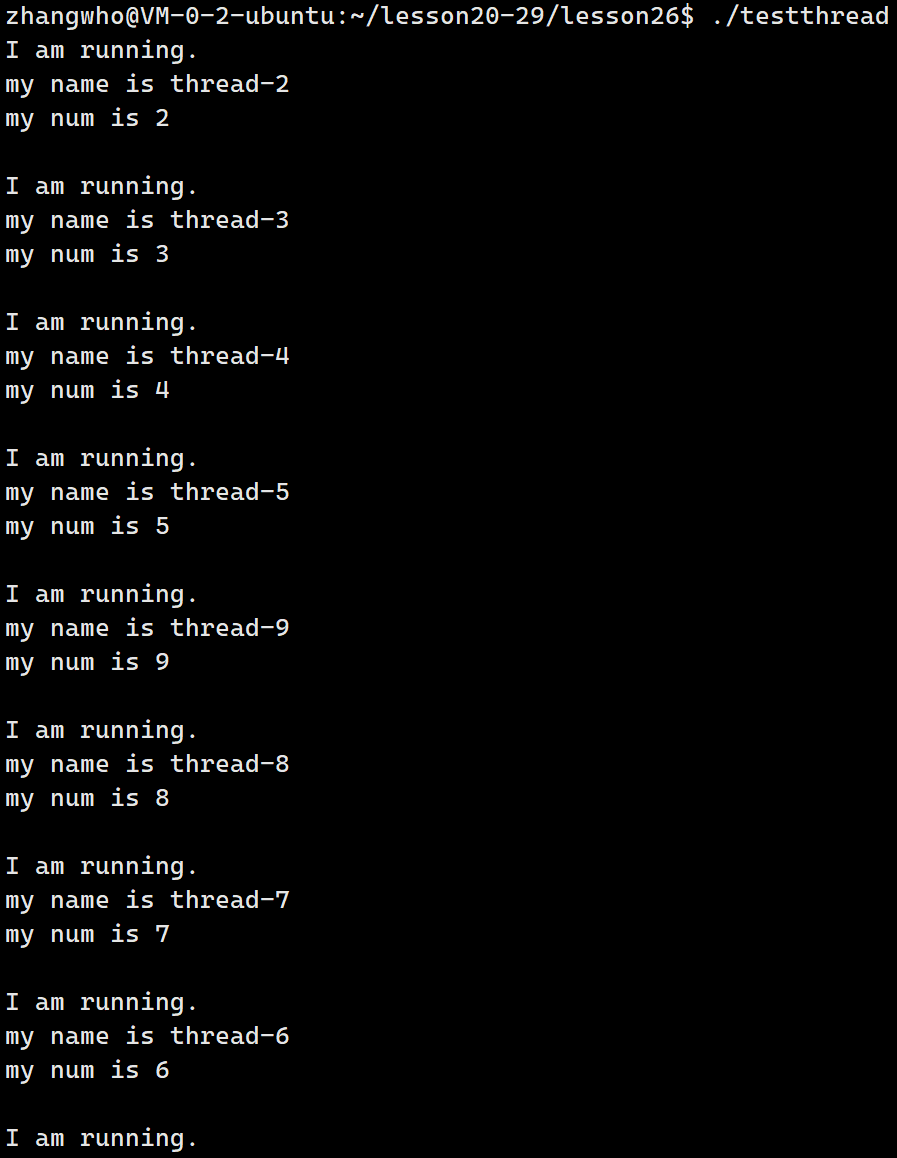
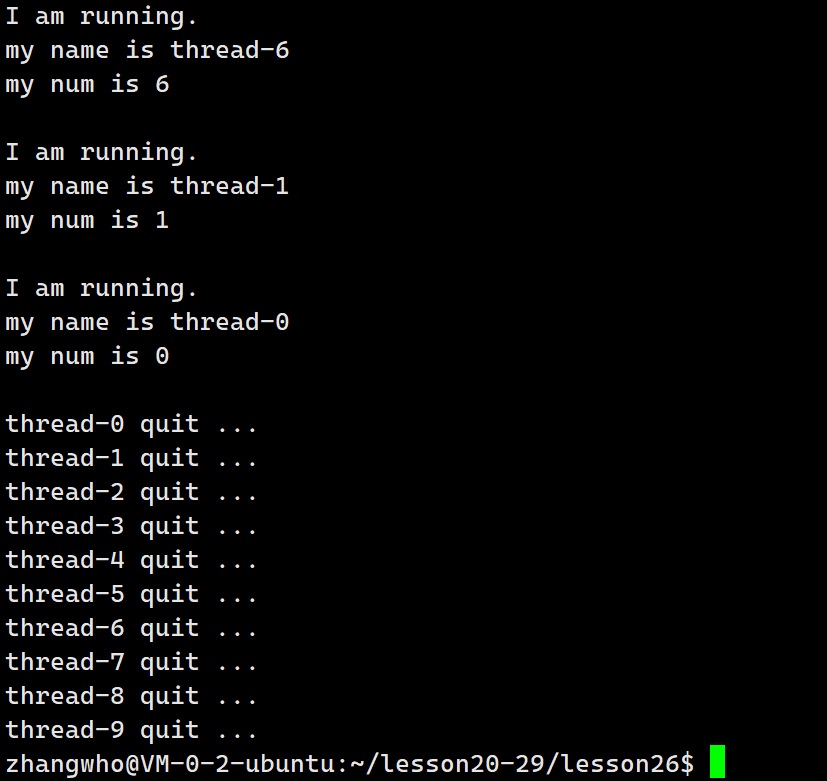
完美达到了预期
线程终止
- 新线程如何终止
a.首先我们知道线程函数执行到return的时候线程就会终止。
b.如果用exit,线程能否终止呢?
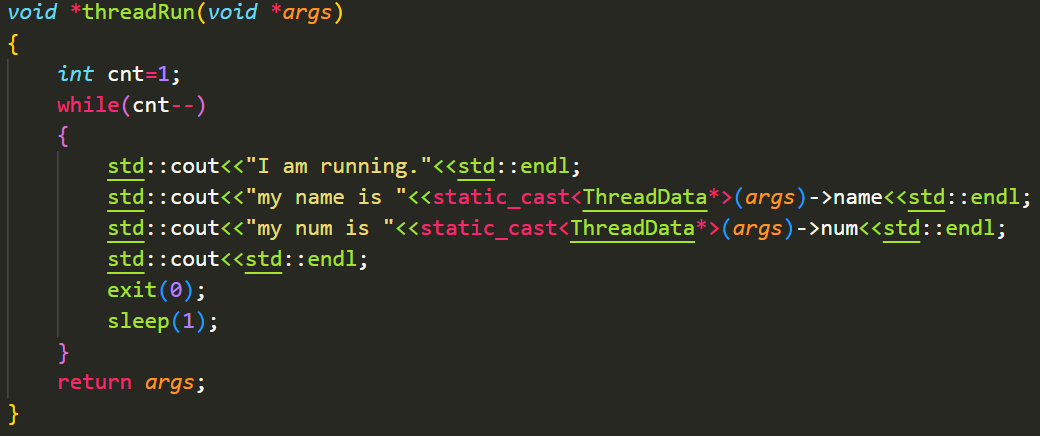
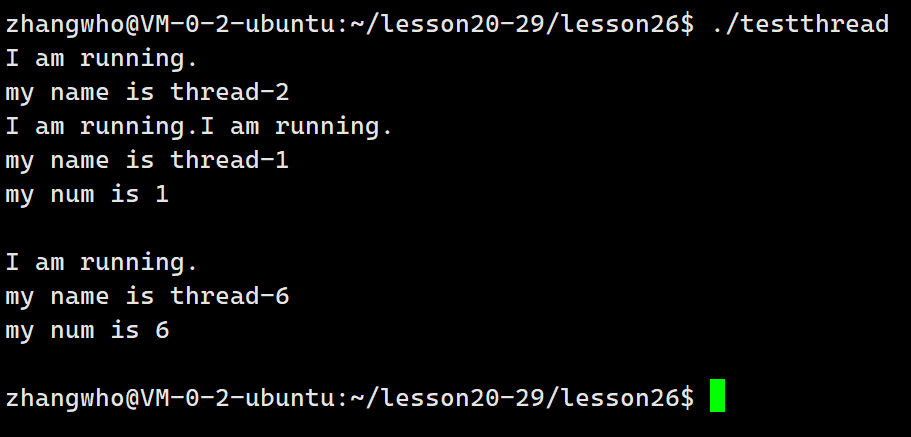
可以是可以,但是exit退出的是整个进程,这回导致其他未执行完的线程也跟着一起退出了。
c.线程也有专门封装的exit:pthread_exit
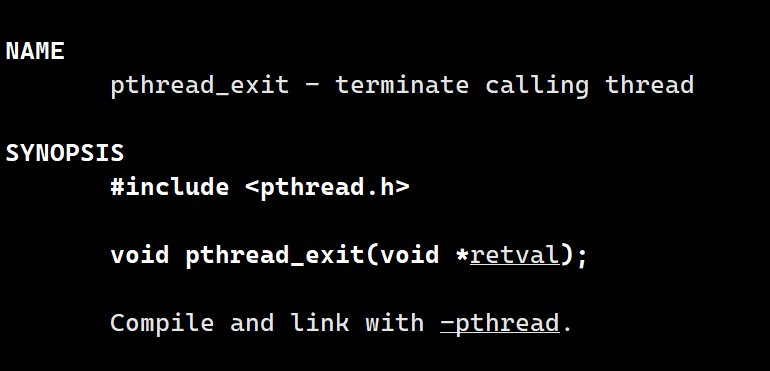
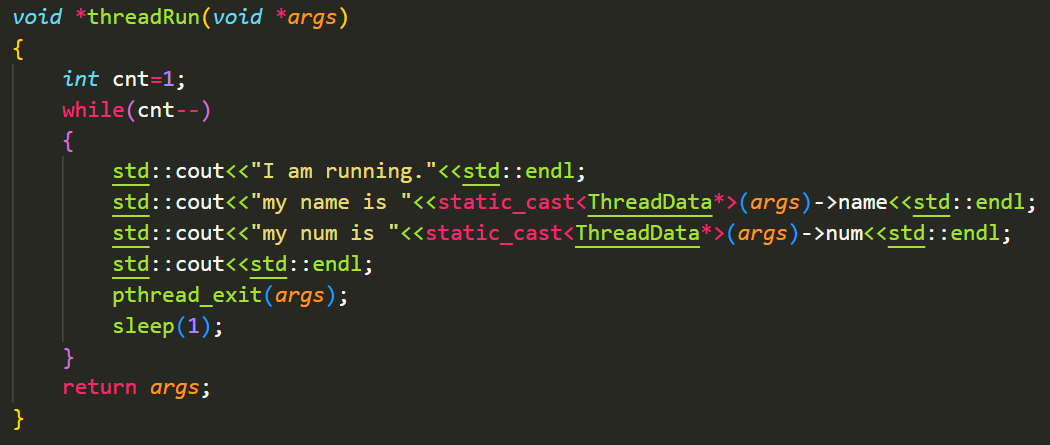
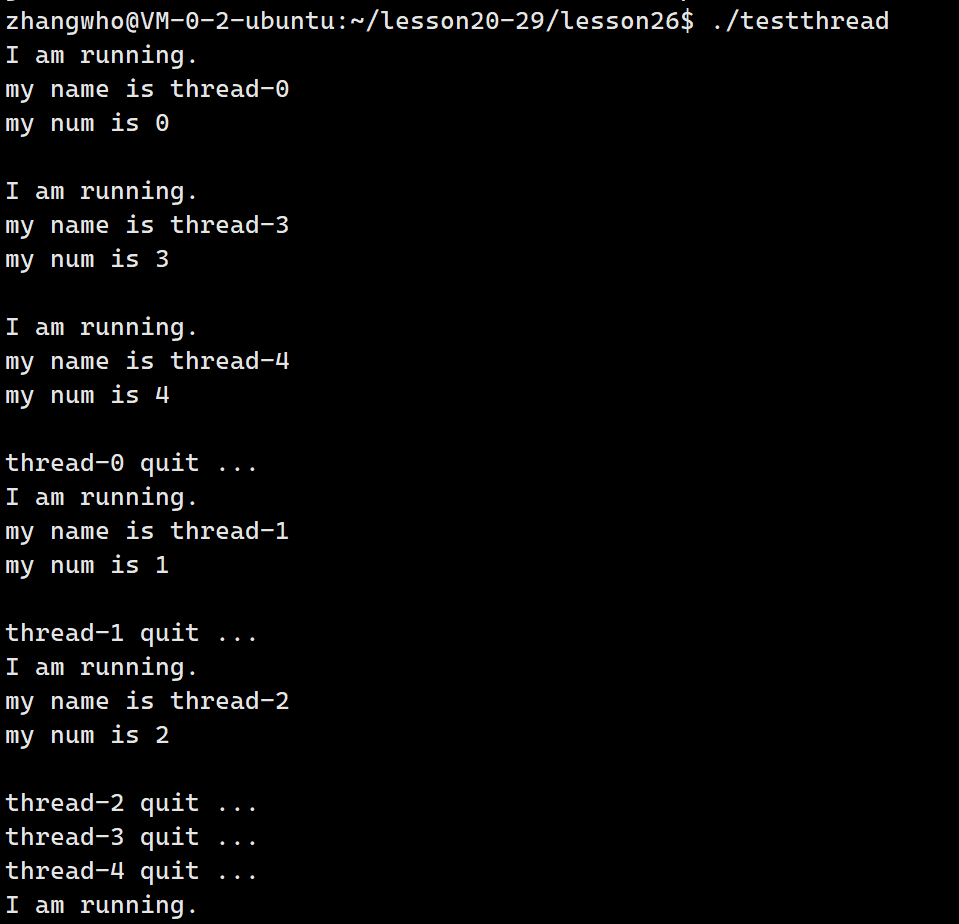
我们调用这个函数就可以让线程退出:
d.我们还可以调用pthread_cancel来退出进程:
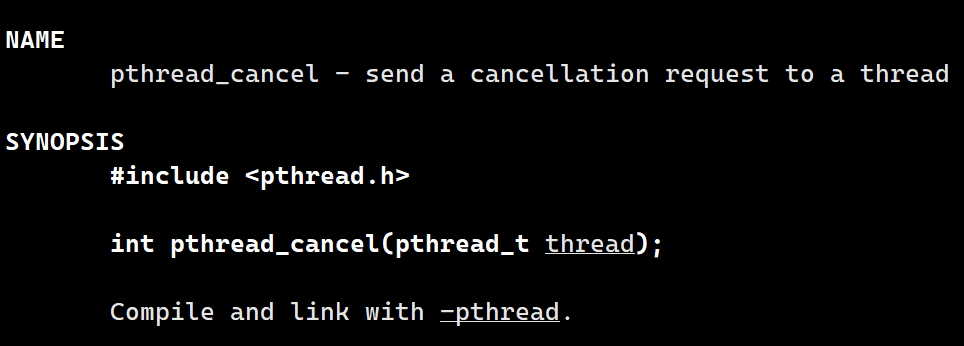
注意这里要传入线程的tid,我们当然也可以通过pthread_self获取自己的tid,达到退出自己的效果:
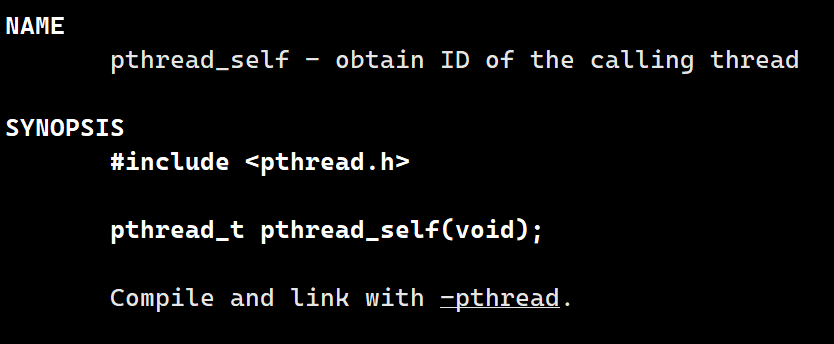
当然这个一般是用于主线程退出其他线程的。
线程分离
- 我们能不能不join线程,让他执行完就自己退出呢?
自然是可以的,但需要注意以下两点:
a.一个线程被创建,默认是joinable的,必须join
b.如果一个线程被分离,线程工作状态分离状态,不需要也不能被join,依旧属于线程内部,但是不需要等待了。
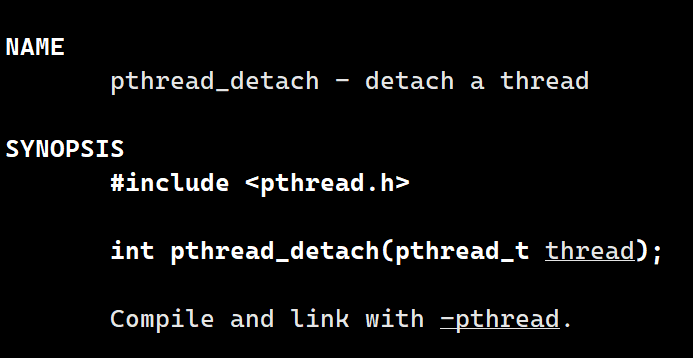
线程分离用的函数是pthread_detach:
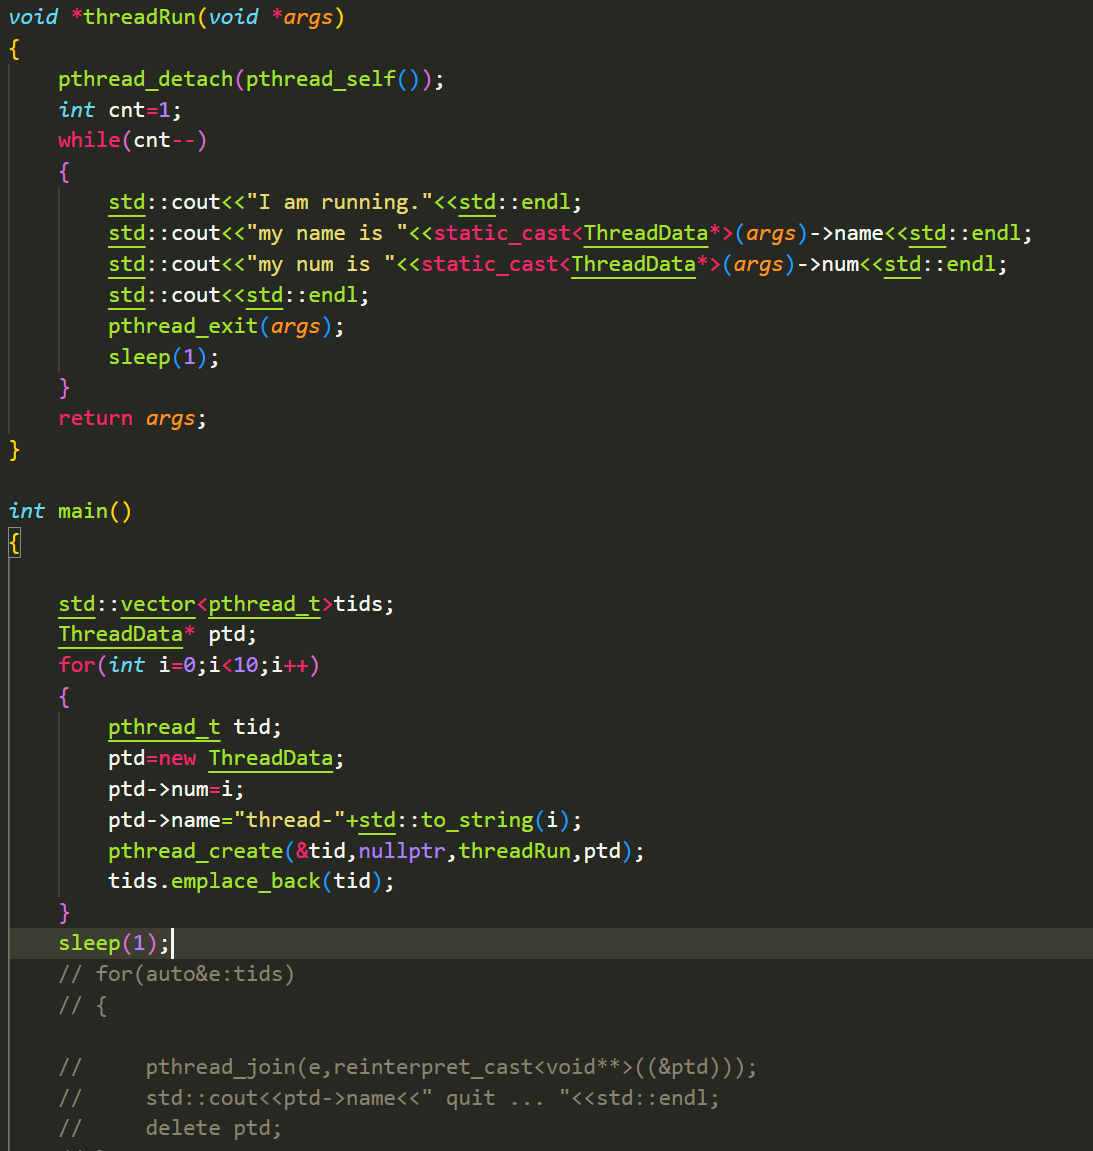
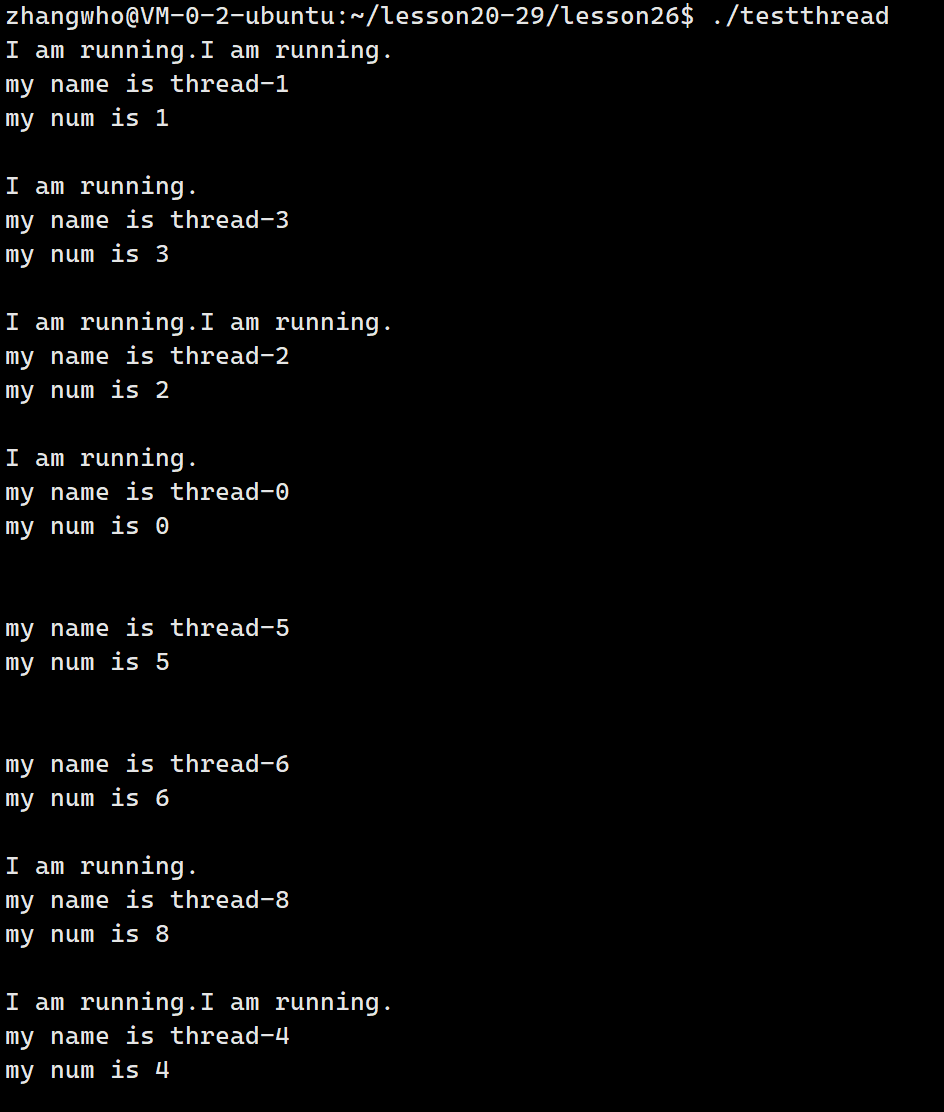
注意到我让主线程sleep了1s,这是防止新线程还没有调用pthread_detach,主线程就退出了。
thread库
c++里面也封装了一个thread库而且还挺好用的:
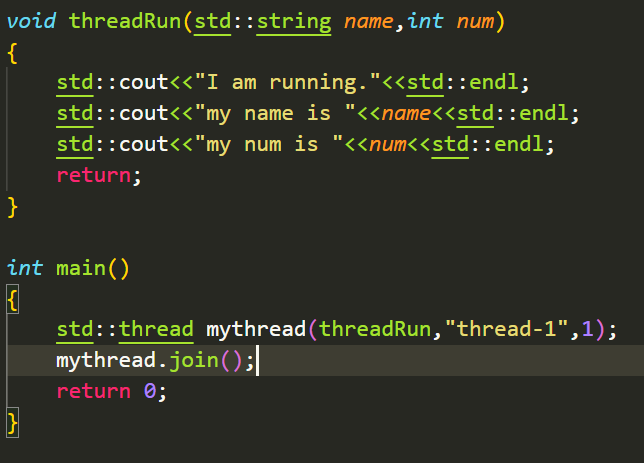
根据前面学过的可变参数模板,我们这里定义线程函数就可以比较随意,是不是非常舒服。
需要注意thread库本质是对pthread的封装,因此编译时依旧需要链接第三方库pthread。
运行代码:
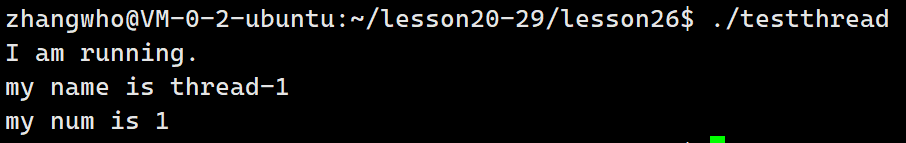
完美!
进一步理解线程id
动态库
前面我们提到pthread_t也就是线程id本质是一个地址,那这是什么地址呢?
这里我们要进一步理解动态库:
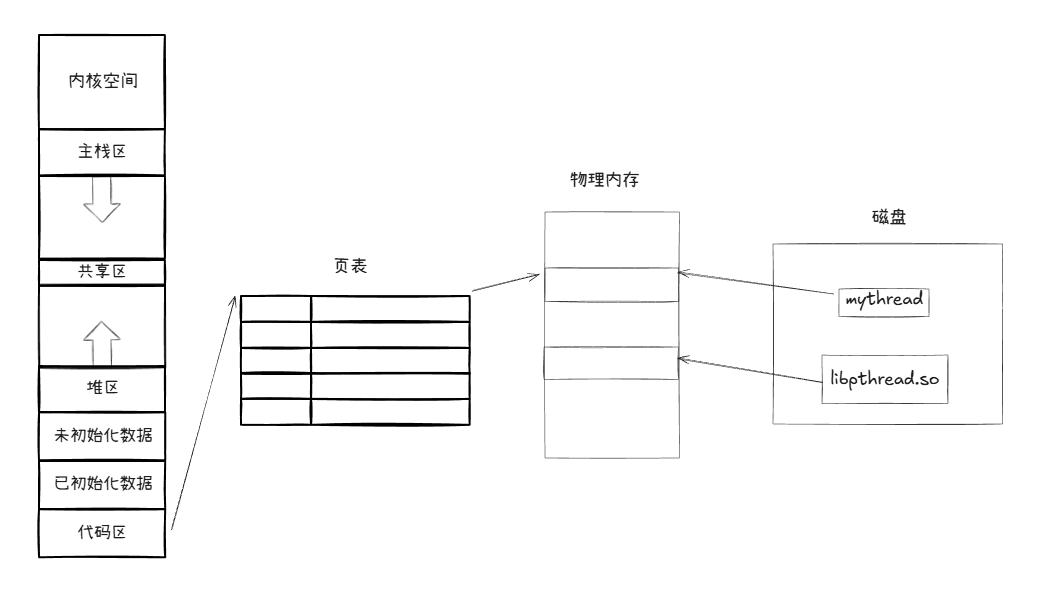
像这样我们编写的代码和动态库分别加载到内存中,那我们的代码如何调用库的函数呢?想必库一定得映射到我们线程的虚拟地址上:
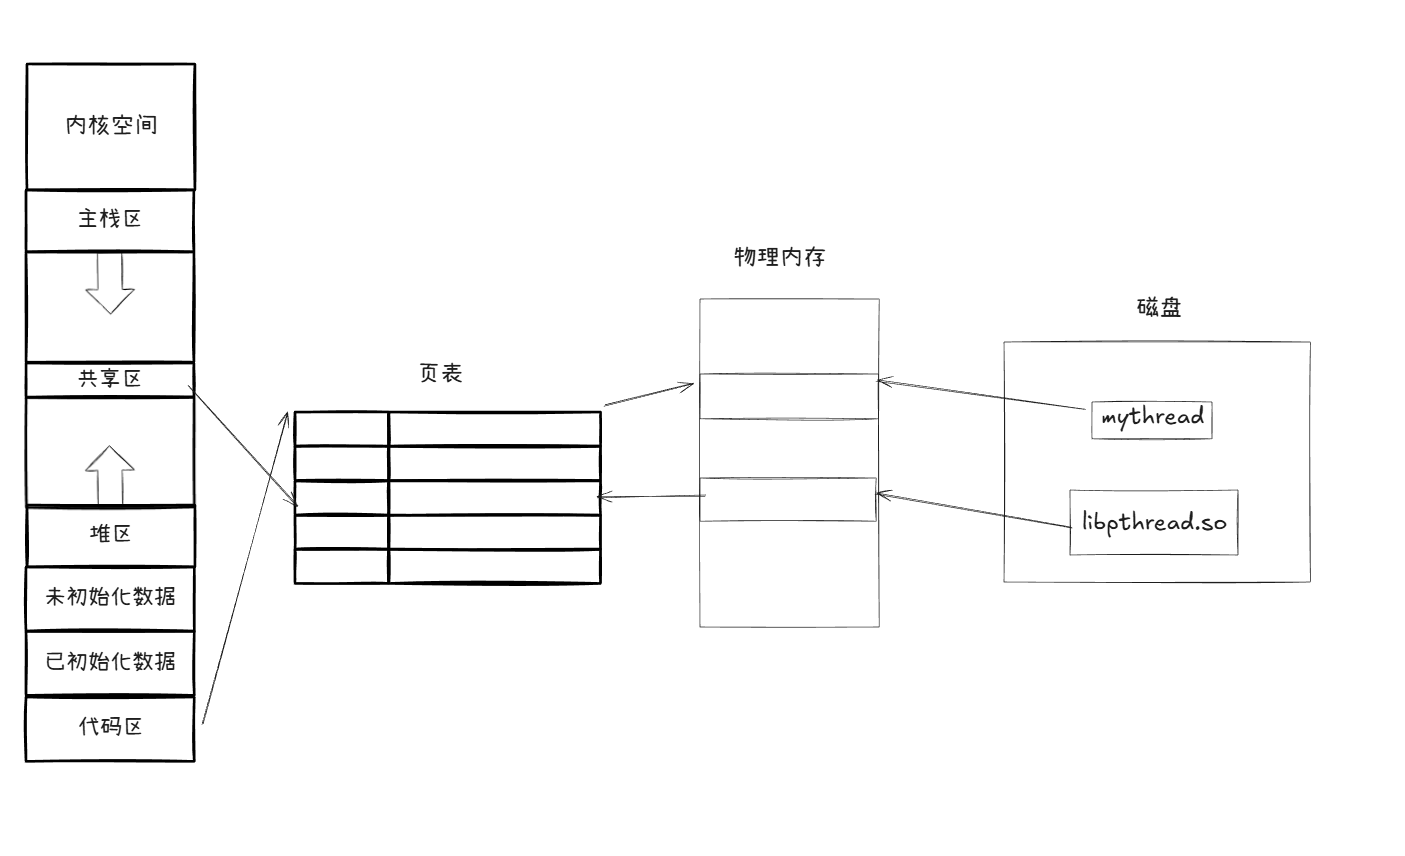
没错,我们的动态库会映射到虚拟地址的共享区,所以动态库在内存所占空间是共享内存。
这意味着里面放的不止一个线程的数据,还有其他:
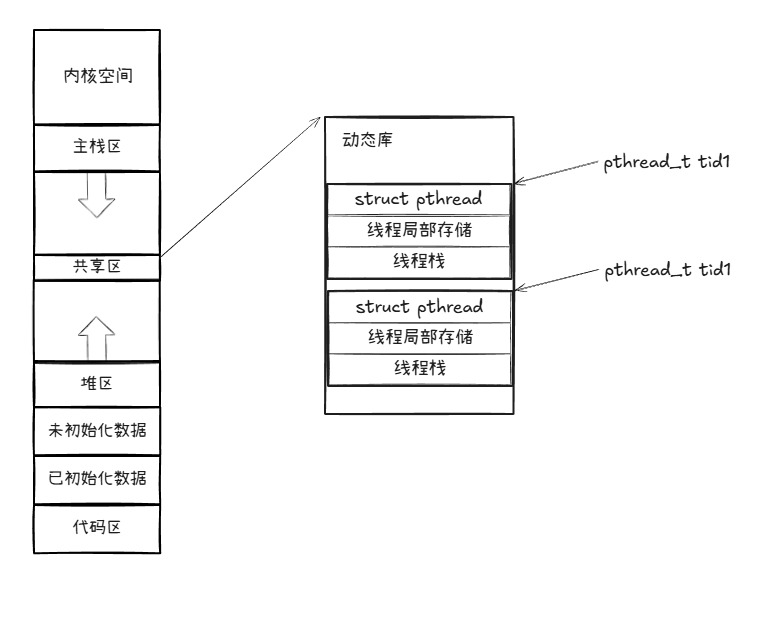
没错我们的动态库内部会维护一份线程的数据,这里有线程相关的属性、线程局部存储、线程栈等。
tid就是指向这份空间的起始地址。
所以说当一个线程结束时,如果不对这个线程等待,他就会一直占用动态库的空间,形成类似僵尸进程的僵尸线程。
回想我们以前学习的fopen:
注意到返回值是FILE的指针,那么FILE在哪呢?
现在我们就理解了,FILE在动态库的线程栈上。
线程局部存储
线程栈我们前面已经讲过了,那线程局部存储是个什么?
先看一段代码:
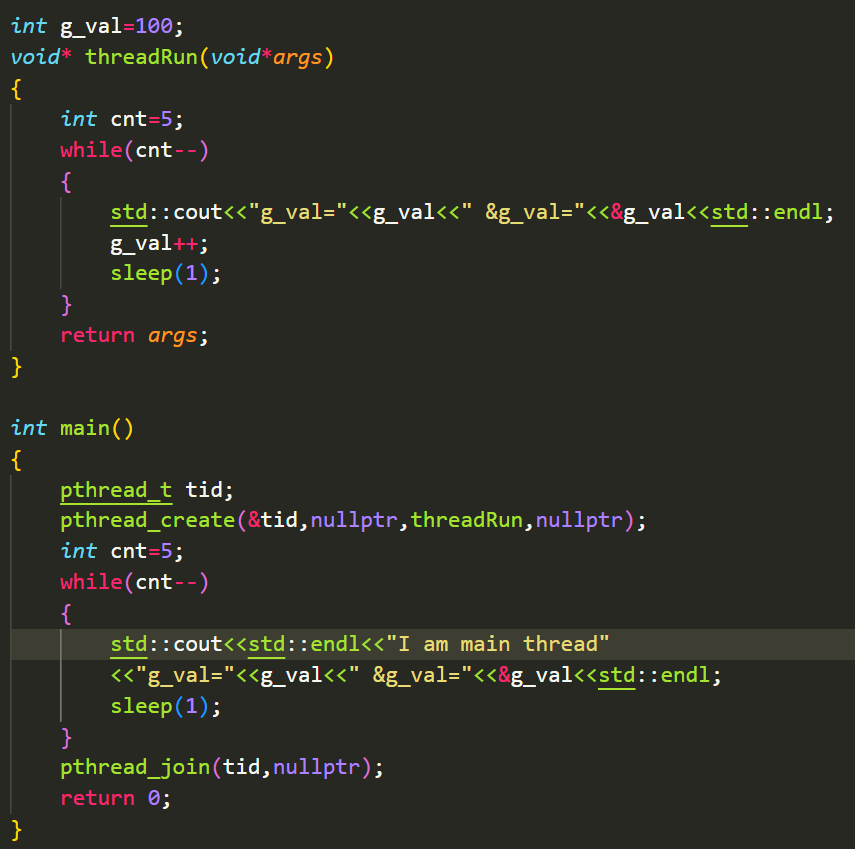
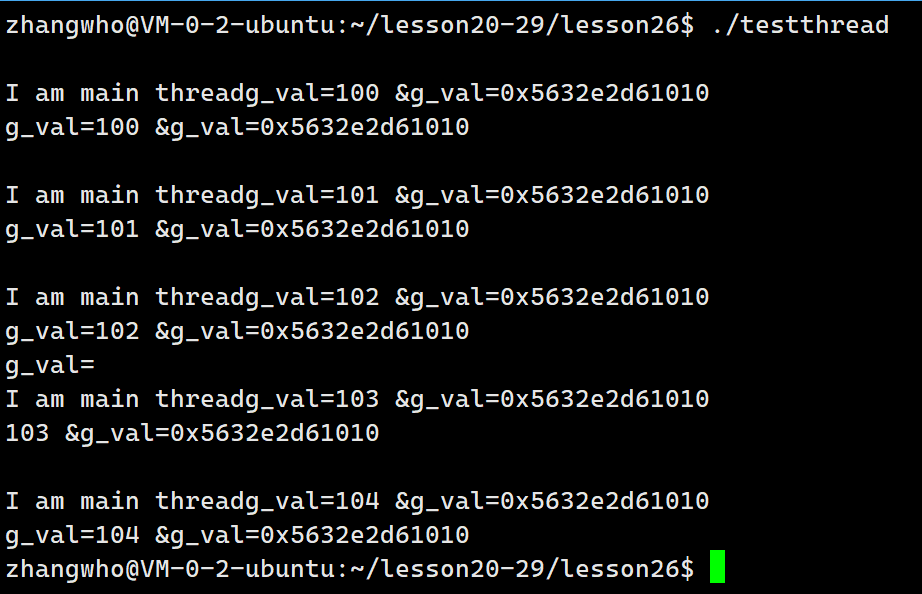
没什么问题,线程共享这个全局变量。
可如果我不想线程共享全局变量,我们可以在int g_val前加上__thread,这样他就会存放在动态库的局部存储上:
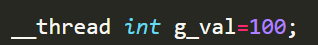
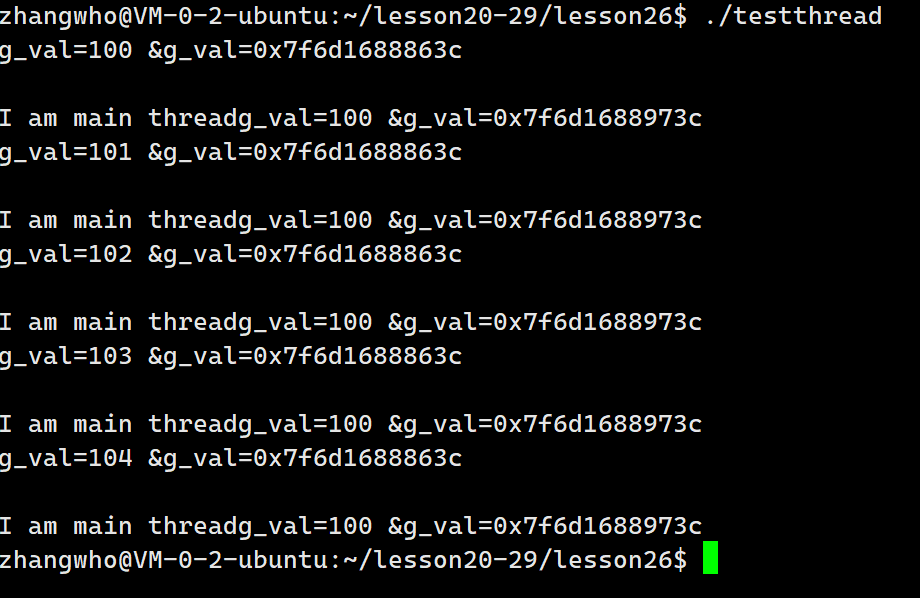
可以看到两个线程的g_val就分开来了。
不过注意,这种方法只在linux有效,而且只能修饰内置类型。
线程的简单封装
经过上面的练习,我们现在就可以对线程进行一个简单的封装:
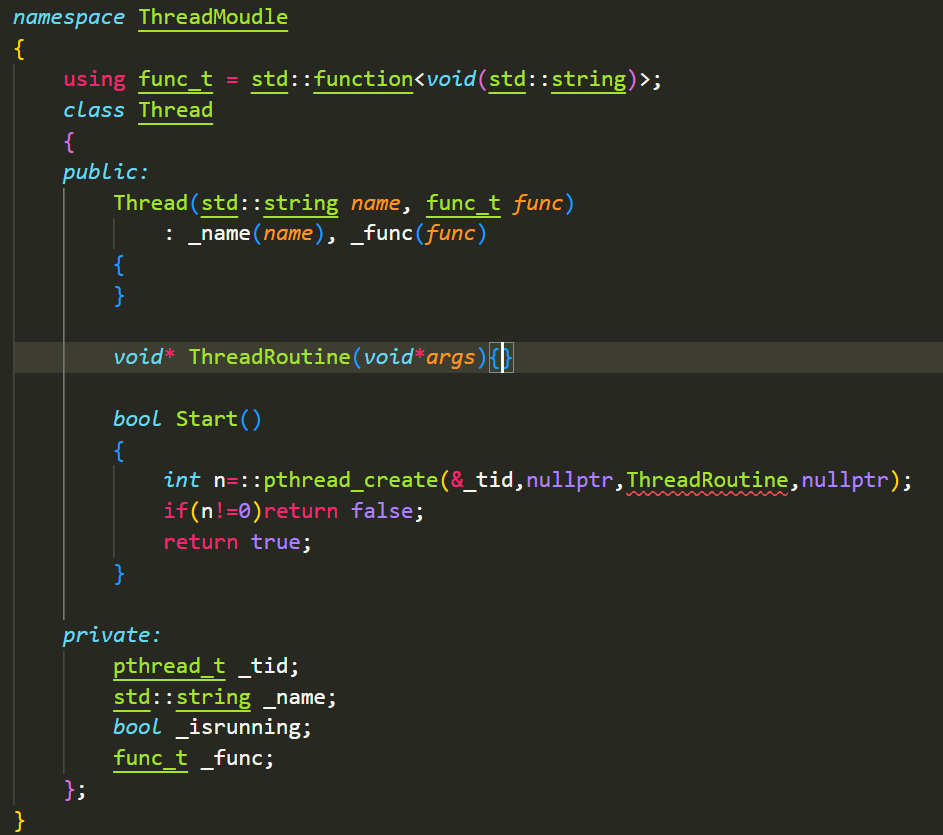
目前我们遇到了第一个问题,为什么ThreaRoutine在报错。
事实上我们的成员函数有一个隐藏的变量就是this指针,所以这里参数不匹配。我们需要将ThreadRoutine改成静态成员函数:
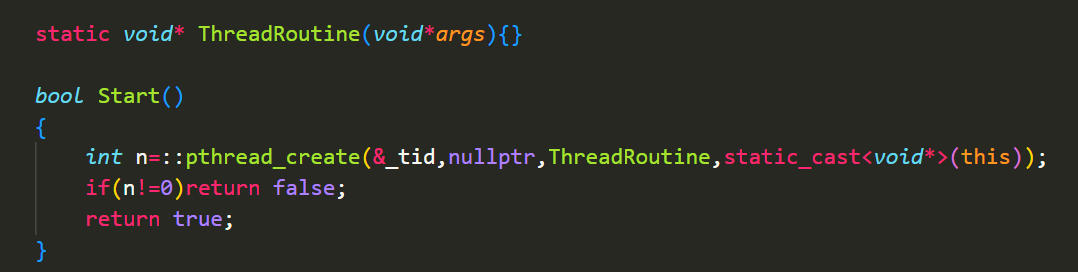
完整代码:
cpp
#pragma once
#include <iostream>
#include <pthread.h>
#include <string>
#include <functional>

namespace ThreadMoudle
{
    using func_t = std::function<void(std::string)>;
    class Thread
    {
    public:
        Thread(std::string name, func_t func)
            : _name(name), _func(func)
        {
        }

        void Excute()
        {
            _isrunning=true;
            _func(_name);
        }

        std::string Name()
        {
            return _name;
        }

        static void *ThreadRoutine(void *args)
        {
            Thread *self = static_cast<Thread *>(args);
            self->Excute();
            return nullptr;
        }

        bool Start()
        {
            int n = ::pthread_create(&_tid, nullptr, ThreadRoutine, static_cast<void *>(this));
            if (n != 0)
                return false;
            return true;
        }

        void Stop()
        {
            if(_isrunning)
            {
                pthread_cancel(_tid);
                _isrunning=false;
            }
        }

        void Join()
        {
            pthread_join(_tid, nullptr);
        }

        ~Thread()
        {

        }

    private:
        pthread_t _tid;
        std::string _name;
        bool _isrunning;
        func_t _func;
    };
}
尝试运行:
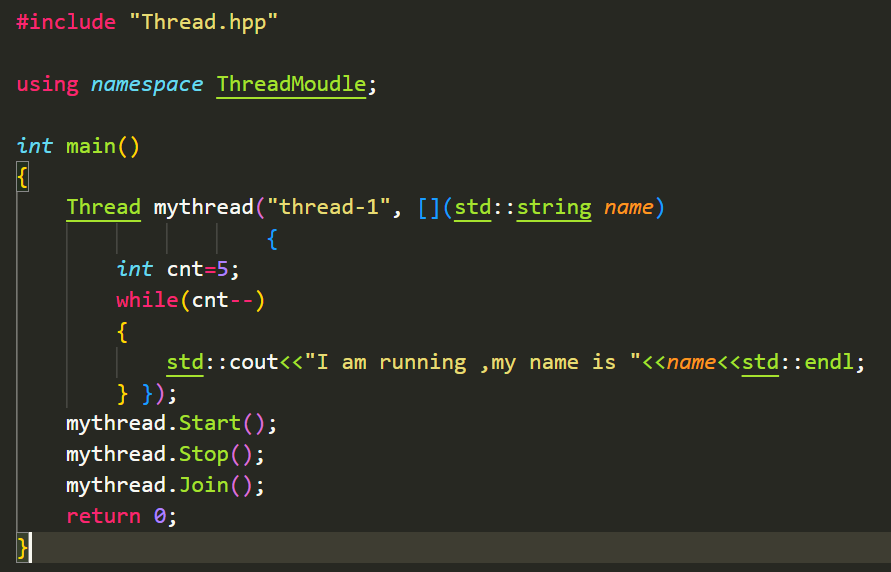
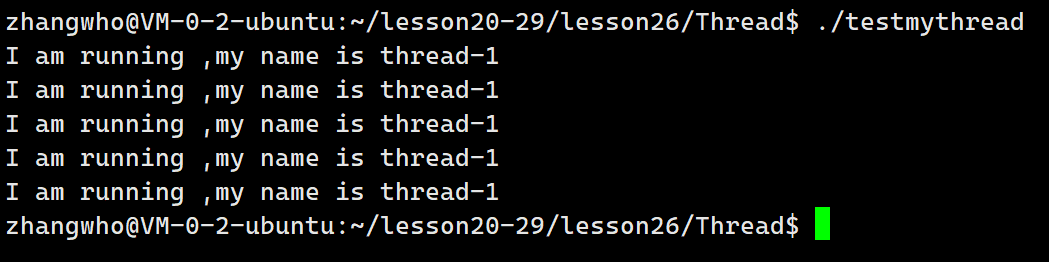
线程互斥
多个线程都能看到的资源,也就是共享资源。在进程间通信里提到过,我们要对共享资源进行保护,保护的方法有互斥和同步。
未经保护的危害
在此之前我们先看看不受保护的资源会怎么样:
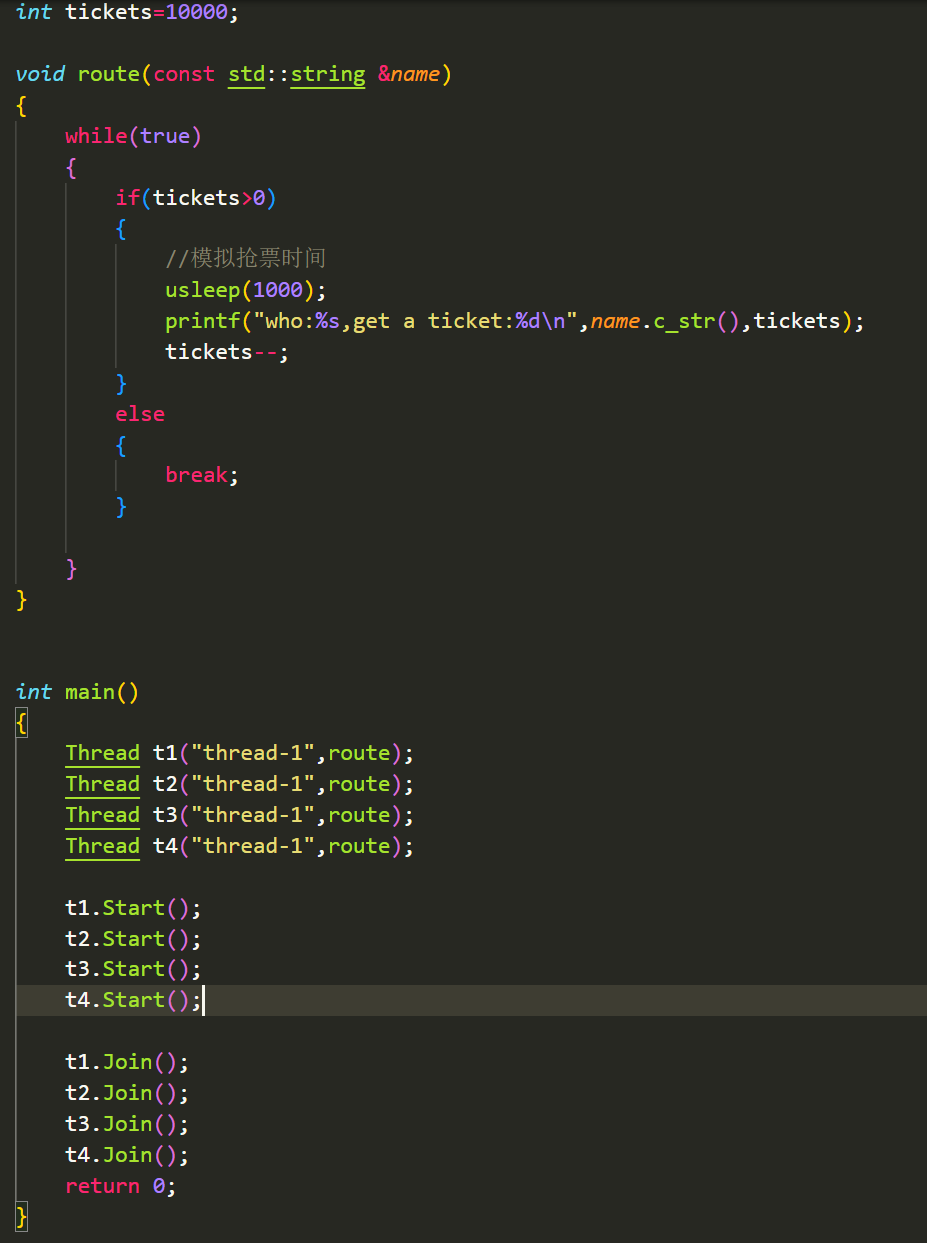
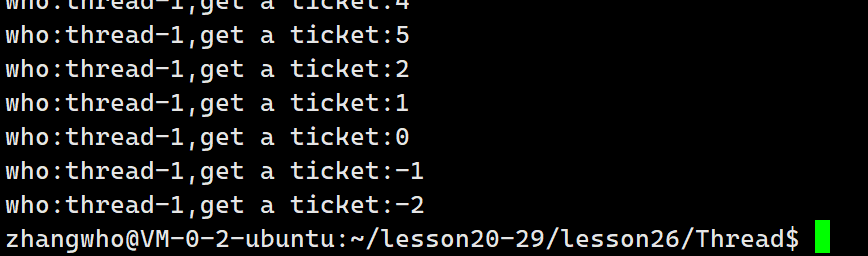
很明显这不对,为什么最后票数会变成负数?
实际上在CPU进行if(ticket>0)和ticket--判断都不是简单的一步:
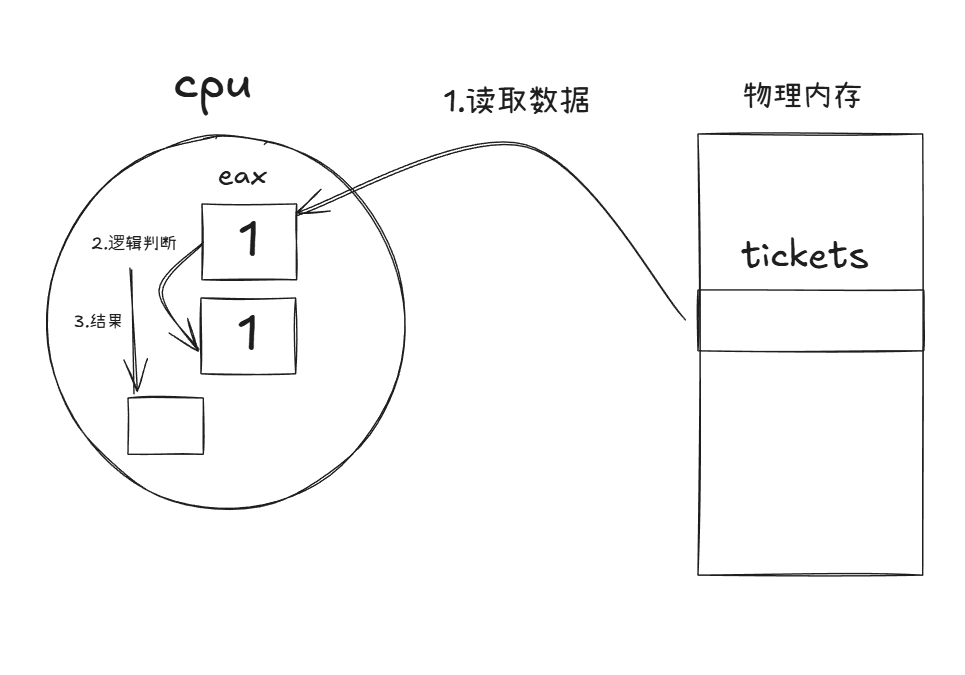
我们的简单逻辑判断首先要将数据载入到寄存器eax中,然后进行判断再记录结果。在这个过程中,线程有可能发生切换,此时寄存器上的数据就被保存带走。下一个线程进来又取得一样得数据。
而且我们在tickets--前还休眠了1ms。可能已经足够四个线程都进到if体内部了。
但是我们的tickets依然不是-3,这除了有意外情况之外,tickets--也不是一步完成的。
他会分成重读数据、--数据、写回数据三步 完成。
在我们写回数据的时候,也有可能发生线程切换,这样其他线程就读到了没写前的数据,最后就会覆盖--。
原子操作
原子操作指在多线程或并发环境中,一个操作不可被中断,要么完全执行,要么完全不执行,不会出现部分执行的状态。
锁
我们回顾上面抢票过程发生bug,主要是因为一些操作不是原子的导致的。因此我们要对这些操作进行保护。
回顾一下进程间通信里提到的概念,我们将访问共享资源的代码称为临界区,不访问共享资源的代码称为非临界区代码。
因此我们要对临界区代码进行保护,使得:
- 代码必须要有互斥行为:当代码进入临界区执行时,不允许其他线程进入该临界区。
- 如果多个线程同时要求执行临界区的代码,并且临界区没有线程在执行,那么只能允许一个线程进入该临界区。
- 如果线程不在临界区中执行,那么该线程不能阻止其他线程进入临界区。
要实现这三点我们需要一把锁,Linux上称这把锁为互斥锁。那么接下来,我们访问临界区代码前申请锁,访问结束后释放锁:
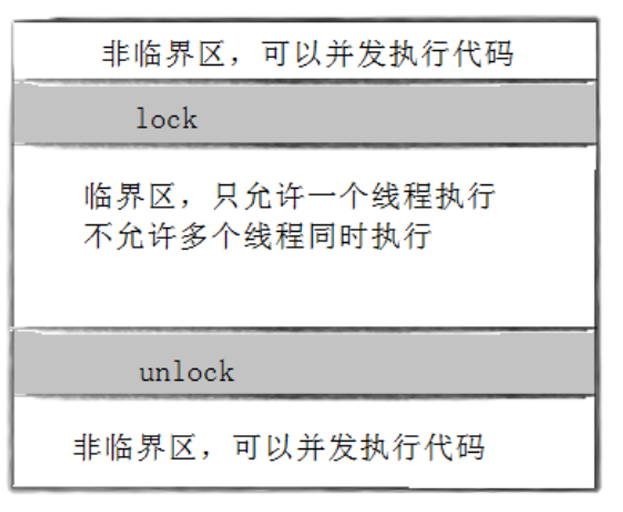
锁的接口和使用
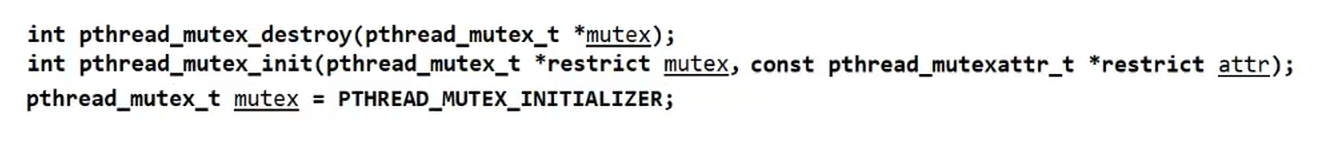
先来看锁的初始化。首先pthread_mutex_t是互斥锁的类型。
如果锁是全局的或者是静态的 ,只需要对其初始化为PTHREAD_MUTEX_INITIALIZER即可。
但如果锁是局部的,我们就需要pthread_mutex_init 初始化,第二个参数是锁的属性,我们咱不理会。并且还需要配合pthread_mutext_destroy来销毁锁。
加锁和解锁:
cpp
int pthread_mutex_lock(pthread_mutex_t *mutex);
int pthread_mutex_unlock(pthread_mutex_t *mutex);
返回值:成功返回0,失败返回错误号
那么现在我们尝试对上面抢票代码修改。
锁的位置是相当考究的,我们能否这样加锁:
1.初试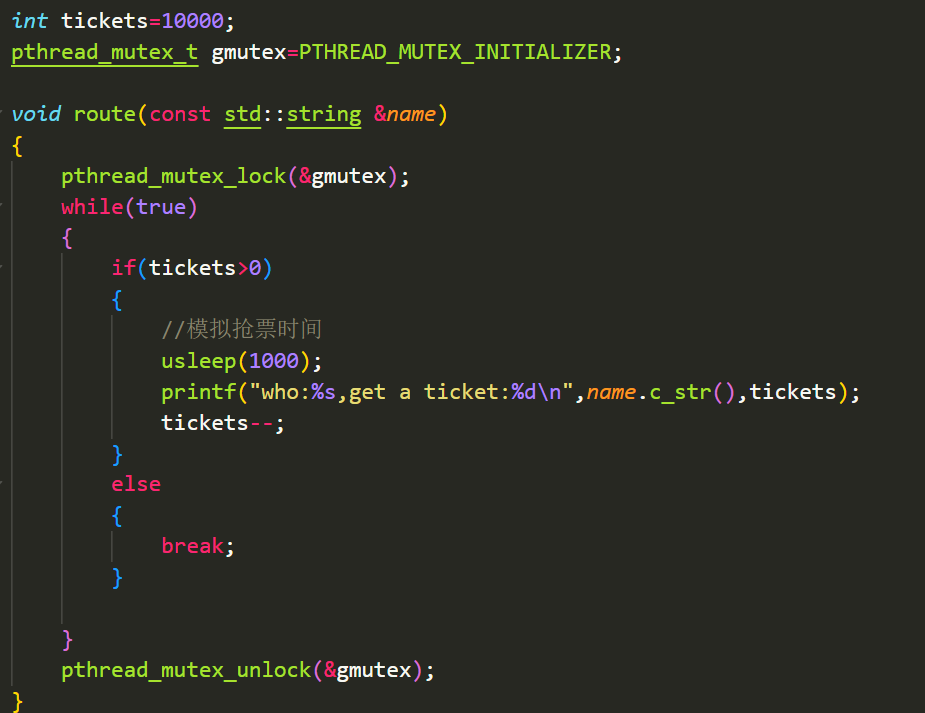
这样虽然让代码没有bug了,但是明显不符合预期,因为只有一个线程能抢到票,并且效率偏下,因此否决。
- 那么能否如此:
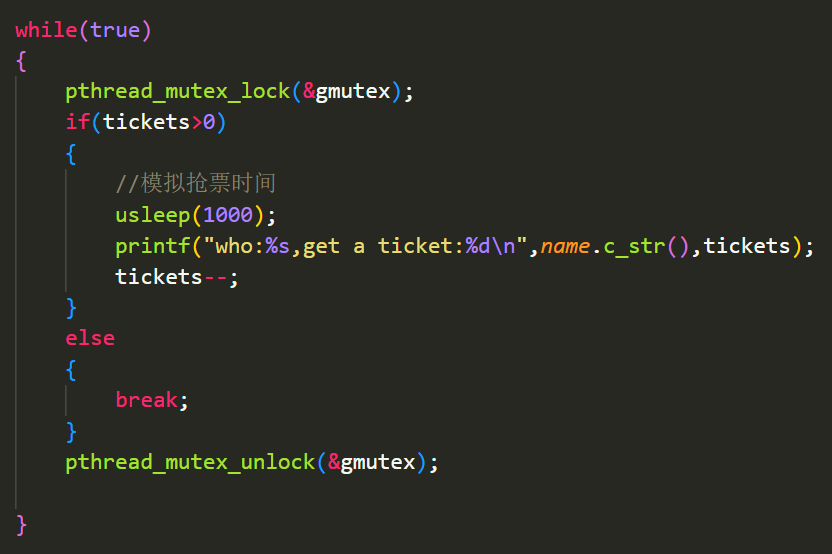
这个表面上看没有问题,但是考虑到没有票的时候就break了。这样就没有释放锁,会导致其他进程阻塞等待。
- 因此应该这样:
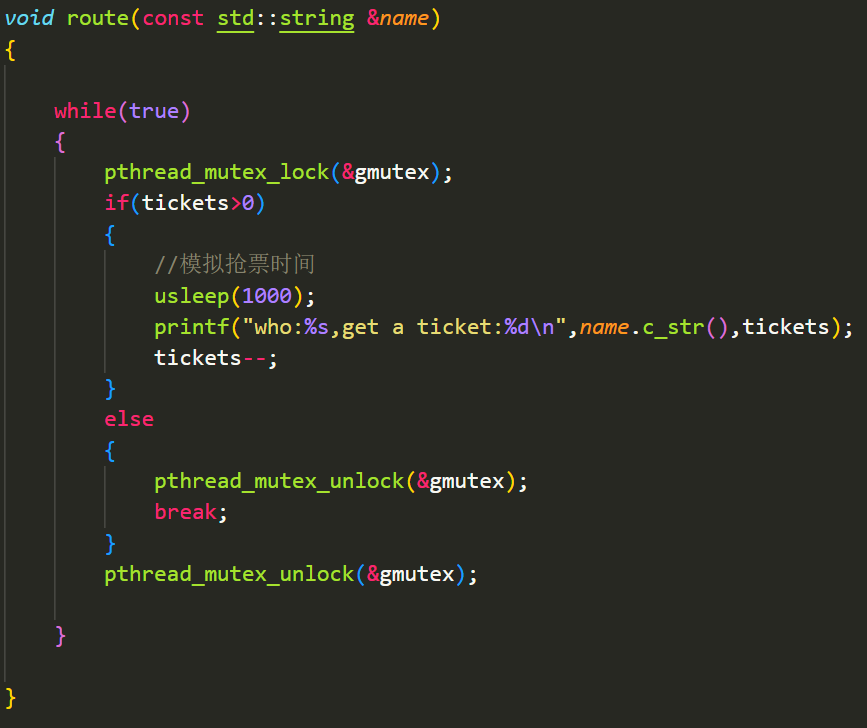
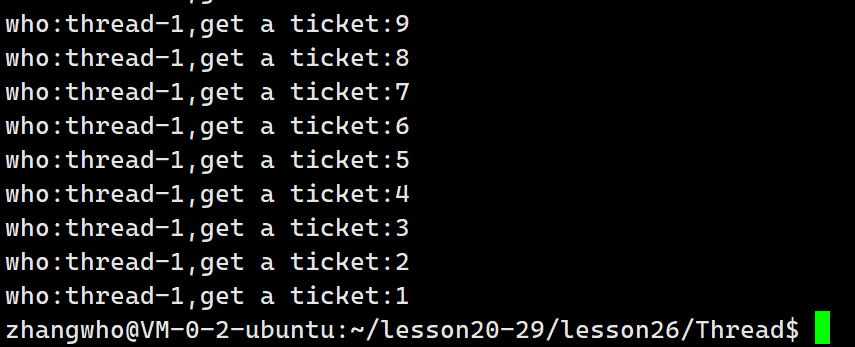
可以看到的确实现了预期。
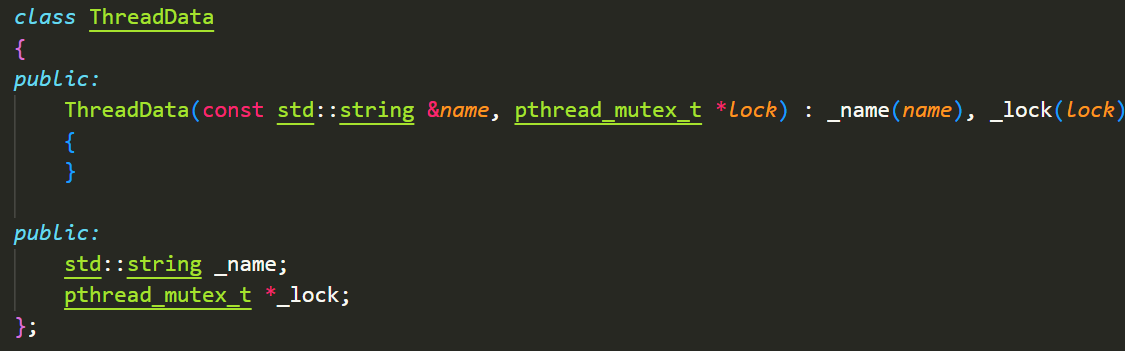
此外我们还可以传入局部变量的锁,首先我们可以设置一个ThreadData:
然后要修改执行的回调函数:
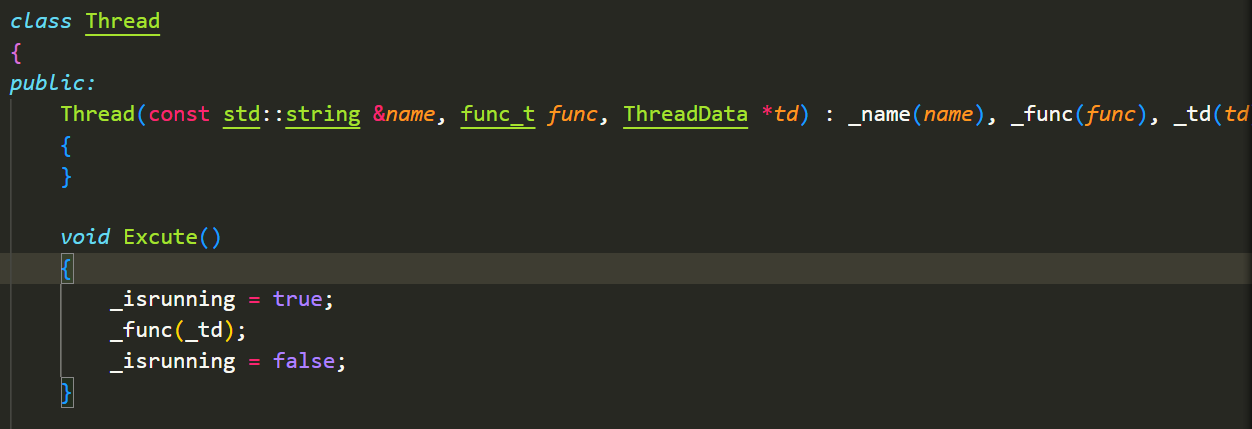
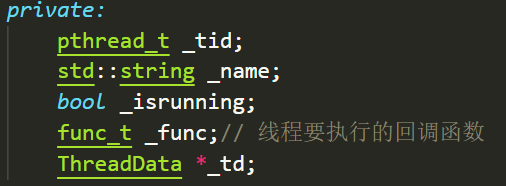
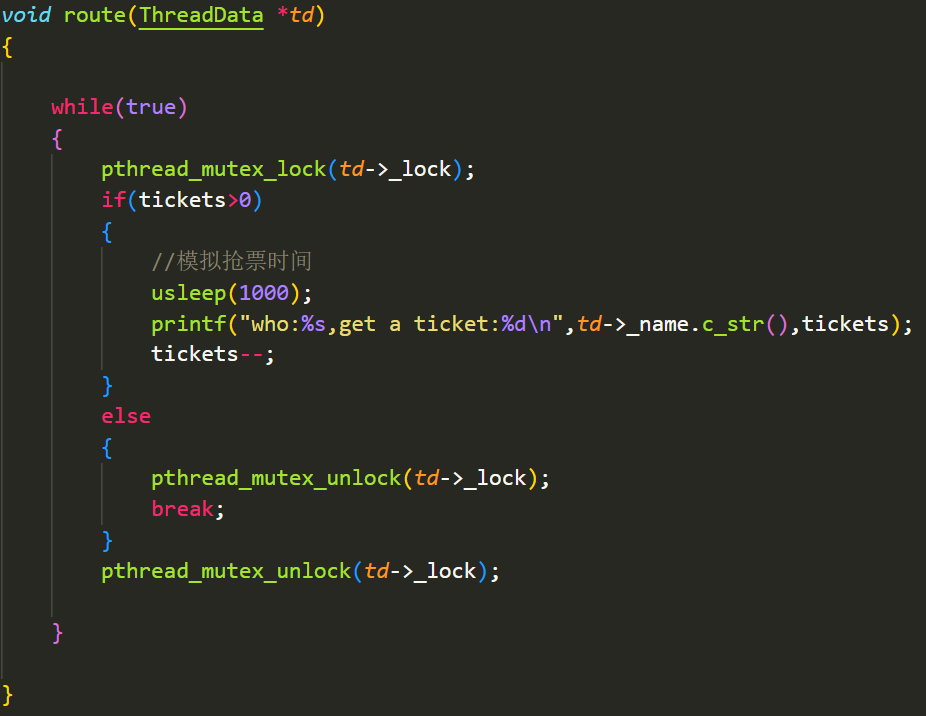
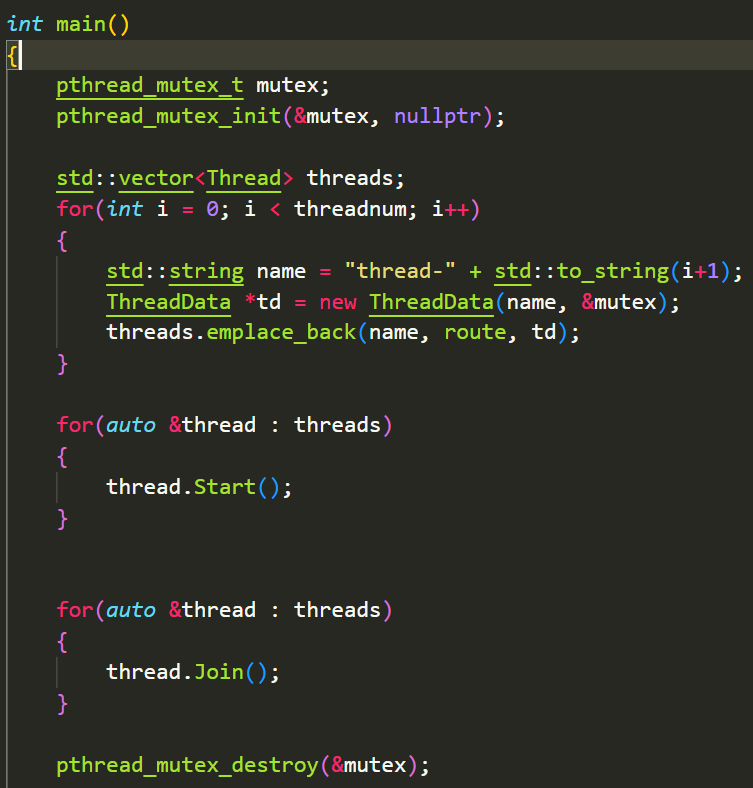
执行代码:
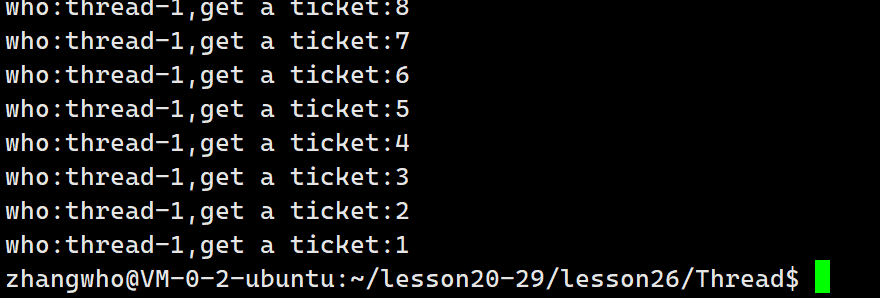
同样完美执行了预期。
LockGuard
在智能指针部分我们已经介绍过RAII技术。我们也可以由此封装一个锁类:
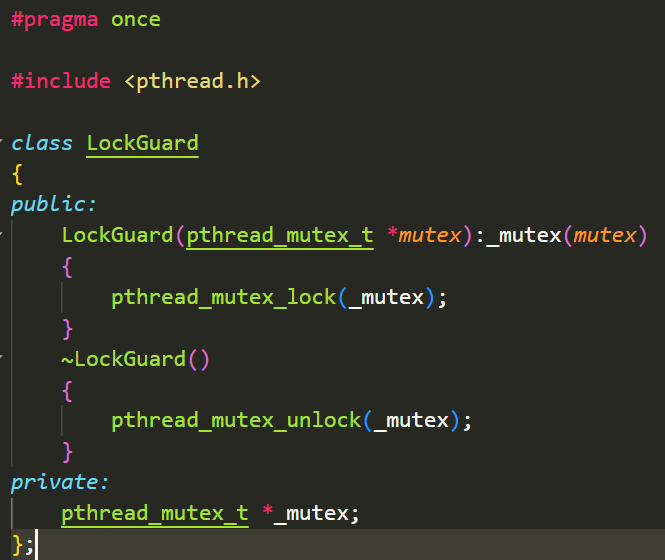
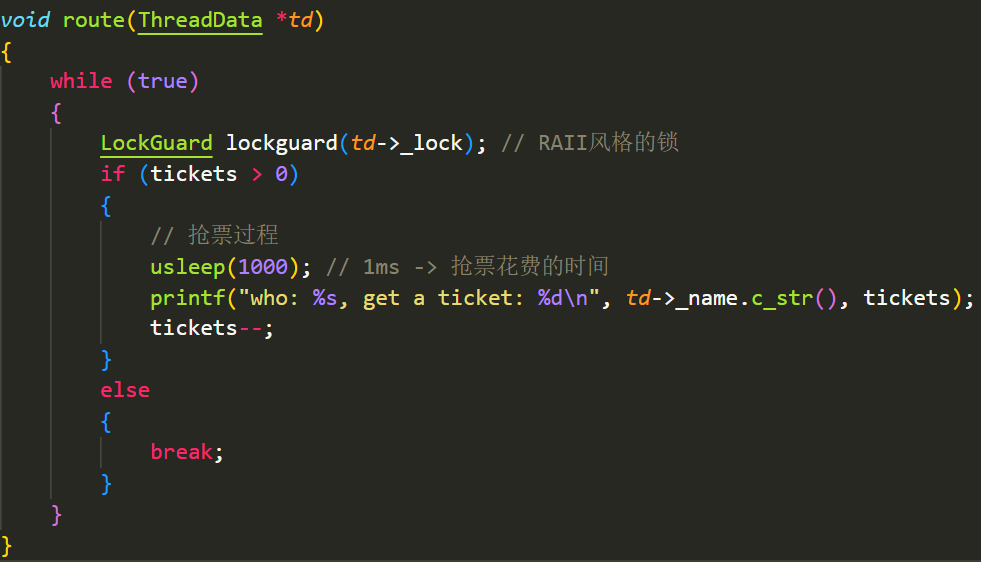
那么锁就会随着Lockguard实例的生命周期,自动上锁和解锁:
对锁的理解
基于上面的操作,我们对锁有了一定的理解:
- 为保证并发效率,加锁的范围,粒度要小,即尽量包含少的代码
- 任何线程要进行抢票前都要加锁,原则上不应该有例外
- 所有线程申请锁的前提是要看到这把锁,因此锁也是共享资源,所以加锁操作必须是原子的
- 如果线程申请锁失败了,线程就要被阻塞
- 如果线程申请锁成功了,继续向后运行
- 线程申请锁成功后,执行临界区代码的时候,依旧有可能发生线程切换
结论:对于其他线程而言,要么我没有申请锁,要么我释放了锁。这意味着我执行临界区代码对于其他线程是原子的。
锁的实现原理
我们要保证加锁的过程是原子的,首先大多数体系结构提供了swap或exchage指令,能够原子地 将寄存器和内存单元的数据交换。这是实现加锁原子性的重要保证,我们来看加锁和解锁的伪代码:
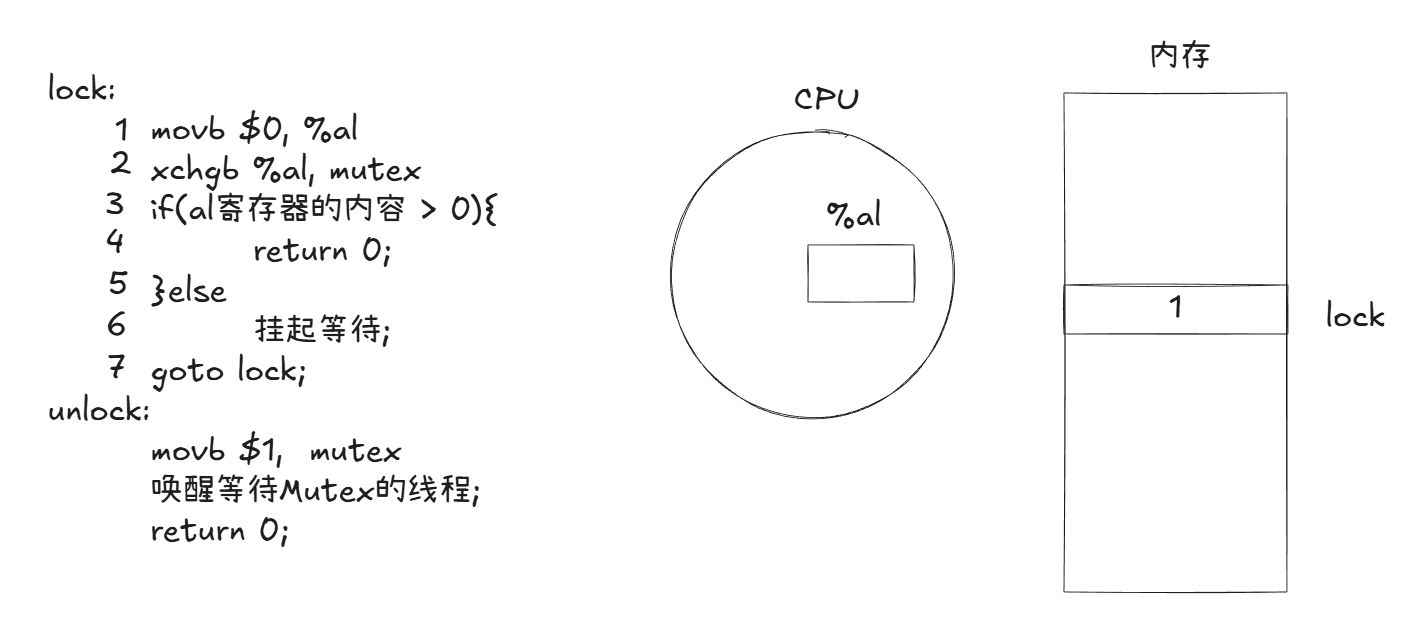
在此之前我们需要明确一个概念:
- CPU的寄存器只有一套,被所有线程共享。但是寄存器内部的数据,属于线程上下文,是线程私有的数据
- CPU执行代码时,一定要有对应的执行体
- 数据在内存中,被所有线程共享
结论:把数据从内存移动到CPU寄存器,本质是将数据从共享,变成私有!
我们来看一个线程执行lock第一条指令:
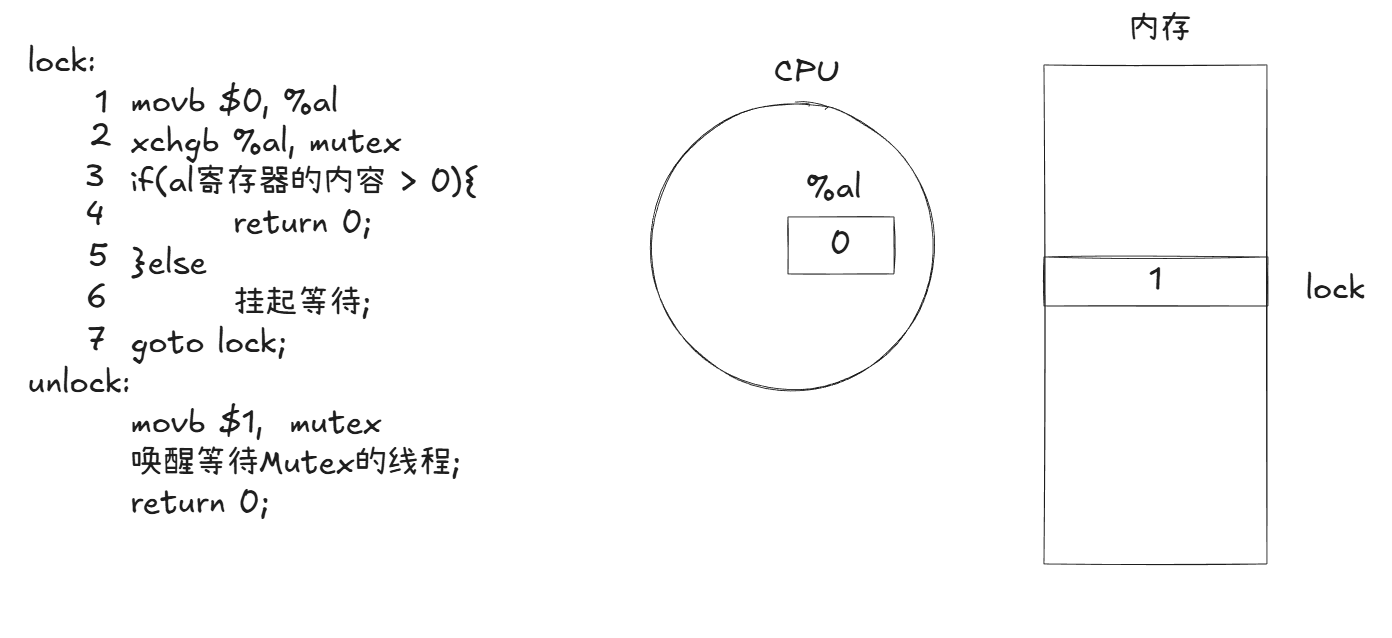
它会将al寄存器清空,然后执行第二条指令:
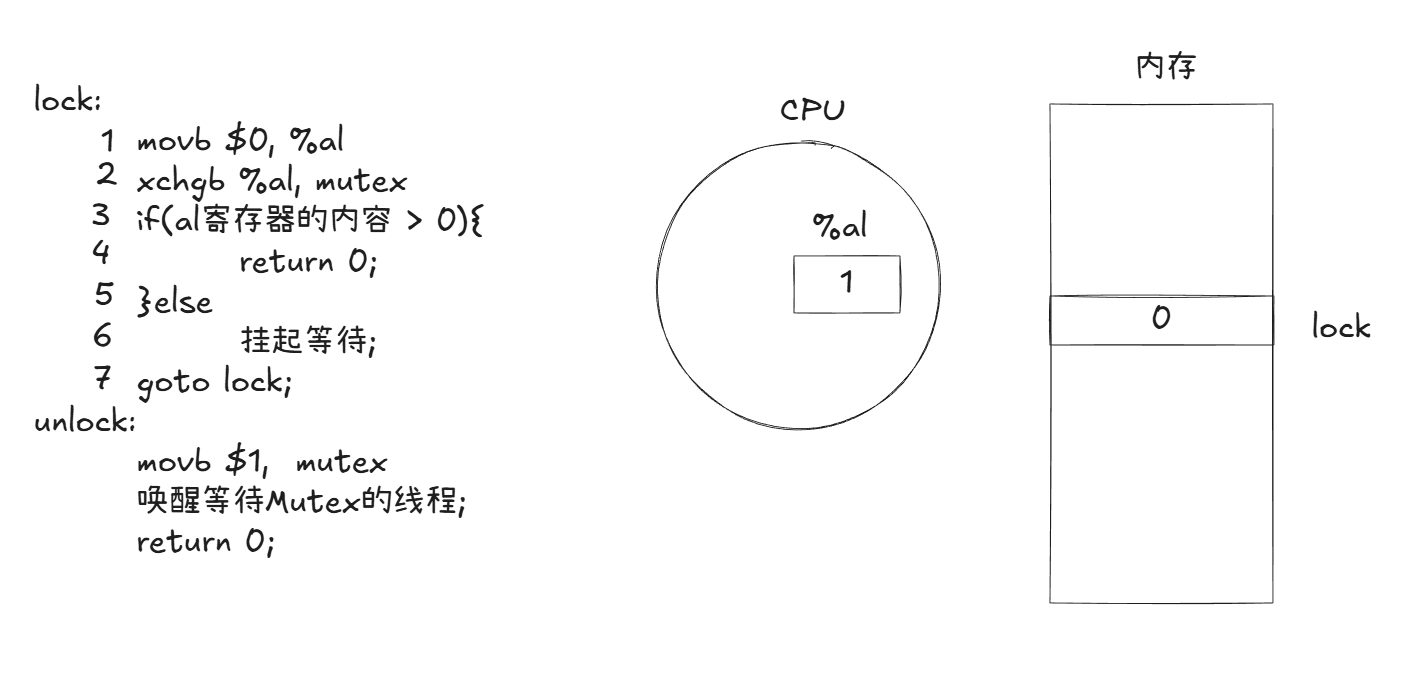
直接交换al和lock的数据。
这时候如果发生了内存切换,当前线程的寄存al里的1会被拷贝走!
然后其他线程进来申请锁,首先就会清空al。然后交换al和lock,可是lock此时是0,因此交换后al里是0,就会申请锁失败。最后阻塞等待。
等到我们的线程调度回来,它会将拷贝之前的1到al上,然后申请锁成功。
因此本质上申请锁最重要的汇编指令就是第二条:
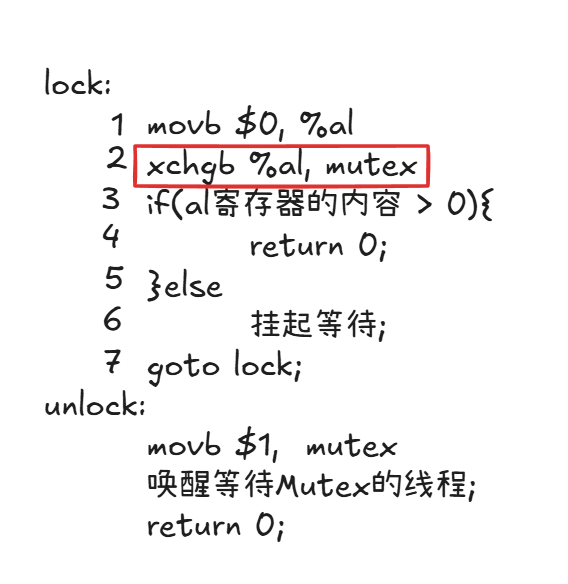
这条指令保证了我们加锁的过程是原子的。
我们持有锁的本质就是持有锁的1.最后解锁的时候只需要将1还给lock即可。
锁的不足
细心的读者可能发现了,我们的加锁粒度已经够小了,但是抢票还是会出现以下现象:
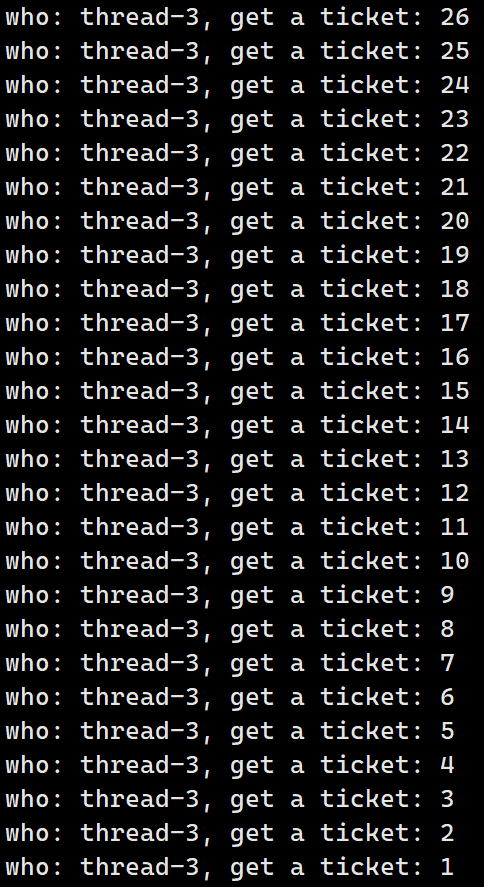
基本上一大段都是同一个线程操作的。就是一个线程解锁之后,又能立刻申请锁,有可能极大减小了其他线程运行效率。
我们其实更想一个线程解锁之后,想要申请锁就必须到一个队列后面排队。
但锁不能保证这一点,下面的条件变量才能保证这点。
死锁
死锁是指在一组进程中的各个进程均占有不会释放的资源,但因互相申请被其他进程所站用不会释放的资源而处于的一种永久等待状态。
下面是一种简单的伪代码形式的死锁:
// 定义两个互斥资源(比如锁A、锁B)
资源:锁A,锁B

// 线程1:先拿锁A,再要锁B
线程1():
    占有(锁A)
    输出("线程1:有锁A,等锁B")
    尝试占有(锁B)  // 此时锁B被线程2占着,卡在这里
    释放(锁B)
    释放(锁A)

// 线程2:先拿锁B,再要锁A
线程2():
    占有(锁B)
    输出("线程2:有锁B,等锁A")
    尝试占有(锁A)  // 此时锁A被线程1占着,卡在这里
    释放(锁A)
    释放(锁B)

// 主流程
主程序():
    启动线程1
    启动线程2
    等待所有线程结束  // 永久等待,因为死锁
死锁的四个必要条件:
• 互斥条件:一个资源每次只能被一个执行流使用
• 请求与保持条件:一个执行流因请求资源而阻塞时,对已获得的资源保持不放
• 不剥夺条件:一个执行流已获得的资源,在末使用完之前,不能强行剥夺
• 循环等待条件:若干执行流之间形成一种头尾相接的循环等待资源的关系
避免死锁:
• 破坏死锁的四个必要条件
• 加锁顺序一致
• 避免锁未释放的场景
• 资源一次性分配
避免死锁的算法:
1.银行家算法
类比银行放贷:银行家(系统)有一定数量的资金(资源),借款人(进程)申请贷款(资源)时,银行家会判断:如果把钱借出去,是否还能保证所有借款人都能顺利还款(进程完成并释放资源)。若能,则处于安全状态,可以分配;否则拒绝分配。
2.死锁检测算法
系统不限制资源申请(允许进程随时申请资源,即使可能导致死锁),而是定期扫描进程和资源的关系,构建 "资源分配图",通过判断图中是否存在循环等待(强连通分量)来检测死锁。
可重入VS线程安全
• 线程安全:多个线程并发同一段代码时,不会出现不同的结果。常见对全局变量或者静态变量进行操作,并且没有锁保护的情况下,会出现该问题。
• 重入:同一个函数被不同的执行流调用,当前一个流程还没有执行完,就有其他的执行流再次进入,我们称之为重入。一个函数在重入的情况下,运行结果不会出现任何不同或者任何问题,则该函数被称为可重入函数,否则,是不可重入函数。
之前信号部分我们就介绍过了不可重入函数的例子。
-
常见的线程不安全的情况
• 不保护共享变量的函数
• 函数状态随着被调用,状态发生变化的函数
• 返回指向静态变量指针的函数
• 调用线程不安全函数的函数
-
常见的线程安全的情况
• 每个线程对全局变量或者静态变量只有读取的权限,而没有写入的权限,一般来说这些线程是安全的
• 类或者接口对于线程来说都是原子操作
• 多个线程之间的切换不会导致该接口的执行结果存在二义性
-
常见不可重入的情况
• 调用了malloc/free函数,因为malloc函数是用全局链表来管理堆的
• 调用了标准I/O库函数,标准I/O库的很多实现都以不可重入的方式使用全局数据结构
• 可重入函数体内使用了静态的数据结构
-
常见可重入的情况
• 不使用全局变量或静态变量
• 不使用用malloc或者new开辟出的空间
• 不调用不可重入函数
• 不返回静态或全局数据,所有数据都有函数的调用者提供
• 使用本地数据,或者通过制作全局数据的本地拷贝来保护全局数据可重入与线程安全联系
• 函数是可重入的,那就是线程安全的
• 函数是不可重入的,那就不能由多个线程使用,有可能引发线程安全问题
• 如果一个函数中有全局变量,那么这个函数既不是线程安全也不是可重入的。
-
可重入与线程安全区别
• 可重入函数是线程安全函数的一种
• 线程安全不一定是可重入的,而可重入函数则一定是线程安全的。
• 如果将对临界资源的访问加上锁,则这个函数是线程安全的,但如果这个重入函数若锁还未释放则会产生死锁,因此是不可重入的。
STL,智能指针和线程安全
STL 中的容器是否是线程安全的?
不是
原因是,STL的设计初衷是将性能挖掘到极致,而一旦涉及到加锁保证线程安全,会对性能造成巨大的影响.
而且对于不同的容器,加锁方式的不同,性能可能也不同(例如hash表的锁表和锁桶).因此STL默认不是线程安全.如果需要在多线程环境下使用,往往需要调用者自行保证线程安全.
智能指针是否是线程安全的?
对于unique_ptr, 由于只是在当前代码块范围内生效,因此不涉及线程安全问题.
对于shared_ptr, 多个对象需要共用一个引用计数变量,所以会存在线程安全问题.但是标准库实现的时候考虑到了这个问题,基于原子操作(CAS)的方式保证shared_ptr能够高效,原子的操作引用计数
线程同步
线程同步是多线程编程中确保多个线程按照预期顺序执行或访问共享资源的机制,避免因竞争条件导致的数据不一致或程序错误。
即线程同步是指不同线程的执行呈现一定的顺序性。
条件变量
- 当一个线程互斥地访问某个变量时,它可能发现在其它线程改变状态之前,它什么也做不了。
- 例如一个线程访问队列时,发现队列为空,它只能等待,只到其它线程将一个节点添加到队列中。这种情况就需要用到条件变量。
多说无益,来看看具体的接口:
初始化
cpp
int pthread_cond_init(pthread_cond_t *restrict cond,const pthread_condattr_t *restrict
attr);
参数:
cond:要初始化的条件变量
attr:NULL
销毁
cpp
int pthread_cond_destroy(pthread_cond_t *cond) 等待条件满足
cpp
int pthread_cond_wait(pthread_cond_t *restrict cond,pthread_mutex_t *restrict mutex);
参数:
cond:要在这个条件变量上等待
mutex:互斥量,后面详细解释
唤醒等待
cpp
int pthread_cond_broadcast(pthread_cond_t *cond);
int pthread_cond_signal(pthread_cond_t *cond);
其中前者表示唤醒所有线程,后者是唤醒一个线程。
条件变量的使用和锁相似,全局或静态的时候只需要初始化为PTHREAD_COND_INITIALIZER.
简单使用一下代码:
cpp
#include <iostream>
#include <string>
#include <unistd.h>
#include <pthread.h>

const int num = 5;
pthread_mutex_t gmutex = PTHREAD_MUTEX_INITIALIZER;
pthread_cond_t gcond = PTHREAD_COND_INITIALIZER;

void *Wait(void *args)
{
    std::string name = static_cast<const char *>(args);
    while (true)
    {
        pthread_mutex_lock(&gmutex);

        pthread_cond_wait(&gcond, &gmutex /*?*/); // 这里就是线程等待的位置
        usleep(10000);
        std::cout << "I am : " << name << std::endl;

        pthread_mutex_unlock(&gmutex);

        // usleep(100000);
    }
}

int main()
{
    pthread_t threads[num];
    for (int i = 0; i < num; i++)
    {
        char *name = new char[1024];
        snprintf(name, 1024, "thread-%d", i + 1);
        pthread_create(threads + i, nullptr, Wait, (void *)name);
        usleep(10000);
    }

    sleep(1);
    // 唤醒其他线程
    while (true)
    {
        pthread_cond_signal(&gcond);
        //pthread_cond_broadcast(&gcond);
        std::cout << "唤醒一个线程...." << std::endl;
        sleep(2);
    }

    for (int i = 0; i < num; i++)
    {
        pthread_join(threads[i], nullptr);
    }

    return 0;
}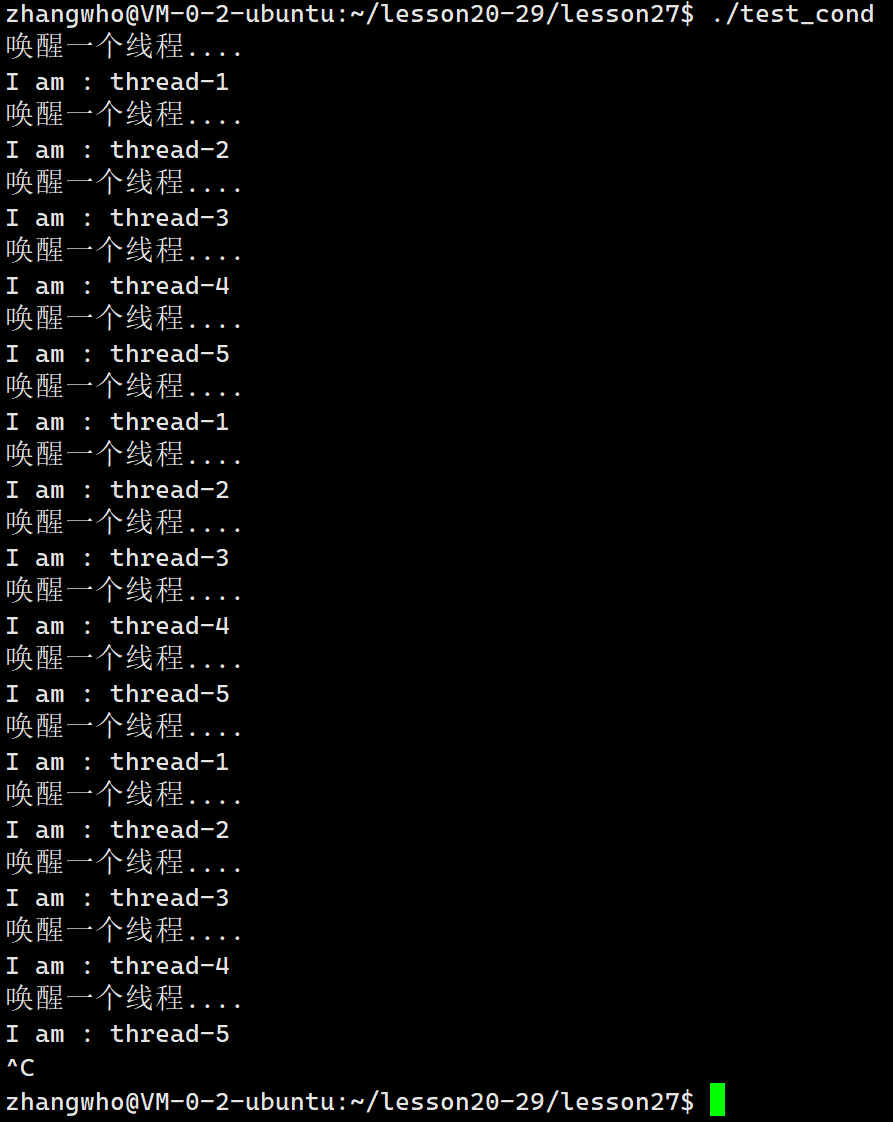
可以看到我们的线程的确呈一定的顺序性进行。
生产者消费者模型
看到生产者消费者第一时间想到的是生态系统呢,没想到还能作用在计算机上。
事实上,生产者消费者模型是常用的多线程模型,如下:

生产者线程将相应的资源生产到仓库(共享内存),消费者线程从仓库中获取资源。
那么我们为什么要有生产者消费者模型呢?
生产者消费者模式就是通过一个容器来解决生产者和消费者的强耦合问题。生产者和消费者彼此之间不直接通讯,而通过阻塞队列来进行通讯,所以生产者生产完数据之后不用等待消费者处理,直接扔给阻塞队列,消费者不找生产者要数据,而是直接从阻塞队列里取,阻塞队列就相当于一个缓冲区,平衡了生产者和消费者的处理能力。这个阻塞队列就是用来给生产者和消费者解耦的。
因此生产者消费者模型具有以下优点:
• 解耦
• 效率高
• 支持忙闲不均
编写生产者消费者模型,我们只需关注"321"原则。
- 一个交易场所(特定数据结构形式存在的一段内存空间)
- 两种角色关系(生产角色,消费角色)生产线程和消费线程
- 三种关系(生产和生产、消费和消费、生产和消费),这三种关系都是互斥关系,但其中生产和消费要保持一定同步。
基于BlockingQueue的生产者消费者模型编写
在多线程编程中阻塞队列(BlockingQueue)是一种常用于实现生产者和消费者模型的数据结构。其与普通的队列区别在于,当队列为空时,从队列获取元素的操作将会被阻塞,直到队列中被放入了元素;当队列满时,往队列里存放元素的操作也会被阻塞,直到有元素被从队列中取出
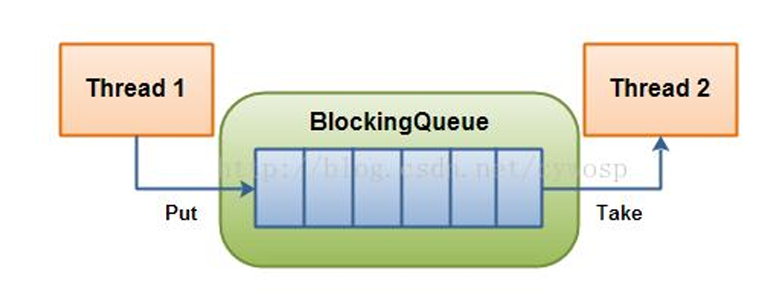
接下我们来封装我们的阻塞队列,先考虑单生产者、单消费者情况。
我们的主函数的调用思路肯定是这样的:
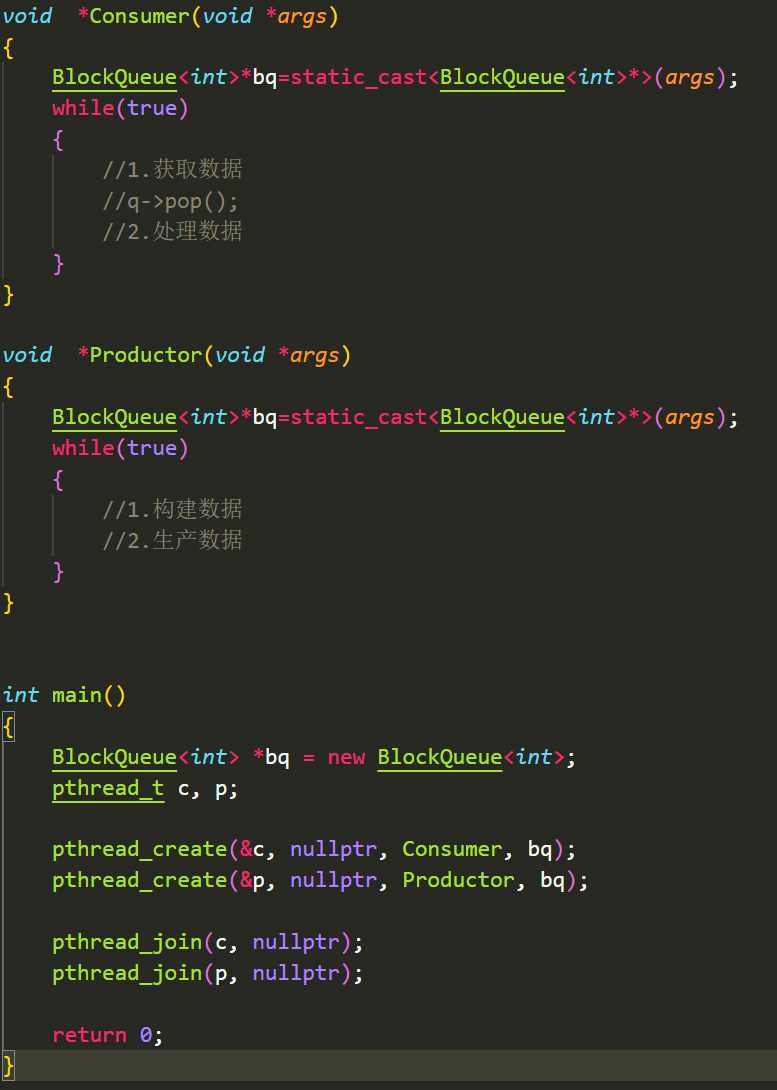
接下来就是BlockQueue类怎么写。首先明确成员变量肯定要有队列、最大容量、锁、条件变量。
这里我们要考虑需要几个条件变量。条件变量的目的是,当阻塞队列为空时,要阻塞消费者,生产者生产资料后,唤醒消费者;当阻塞队列满时,要阻塞生产者,消费者消耗资料后,唤醒生产者。
这样看来我们至少需要两个条件变量。
cpp
const static int  defaultcap=5;

template <typename T>
class BlockQueue
{
public:
    BlockQueue(int cap=defaultcap)
        :_cap(cap)
    {
        pthread_mutex_init(_mutex);
        pthread_cond_init(_p_cond);
        pthread_cond_init(_c_cond);
    }

    ~BlockQueue()
    {
        pthread_mutex_destroy(_mutex);
        pthread_cond_destroy(_p_cond);
        pthread_cond_destroy(_c_cond);
    }
private:
    std::queue<T> _block_queue;
    // 最大容量
    int _max_cap;
    pthread_mutex_t _mutex;
    pthread_cond_t _p_cond;
    pthread_cond_t _c_cond;
};
接下来我们自然就要编写入队列和出队列:
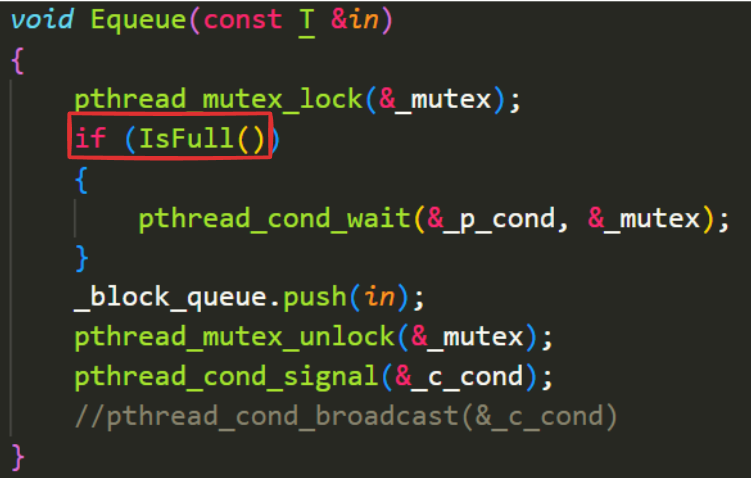
先看简单的入队列逻辑。
首先我们谈谈前面条件变量没有讲的,为什么条件变量等待需要传入一个锁。
我们的代码逻辑是,判断阻塞队列有没有满,如果满了就等待。那么这个判断不是原子的,所以要在前面加锁。
因此我们阻塞等待的部分是临界区,当我们阻塞归来时也是临界区。
所以当我们阻塞的时候,自然要先释放当前的锁,返回的时候又加上锁。这样才能保证临界区代码的保护。
因此当我们的条件变量阻塞等待的时候在wait代码处,抢夺到锁回来后也是在wait代码处,这会引起我标红的if判断的一个bug。等我们先写完出队列的代码再来细说。
出队列:
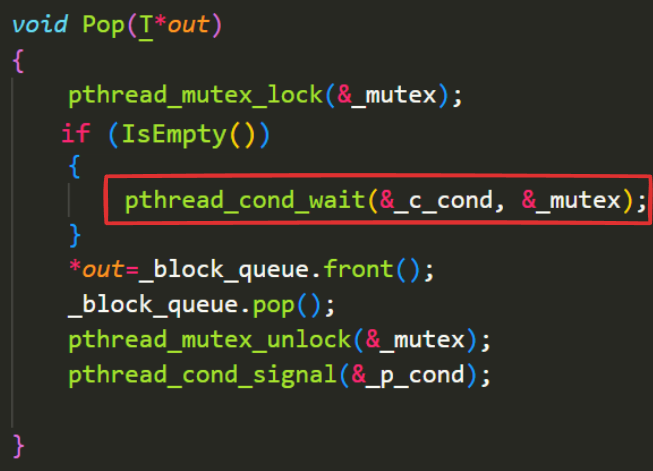
假如我们现在有两个消费者,判断阻塞队列是空,都在这里阻塞等待。然后我们生产者生产完资料后,唤醒所有消费者。这时第一个消费者抢到了锁,优先唤醒,消耗了资源,归还锁。这时候问题来了,我们的第二个消费者有可能立刻抢到锁,然后从wait处开始运行,但是现在队列是空的,所以就会发生段错误。这种情况称为伪唤醒
因此判断都需要改为while:
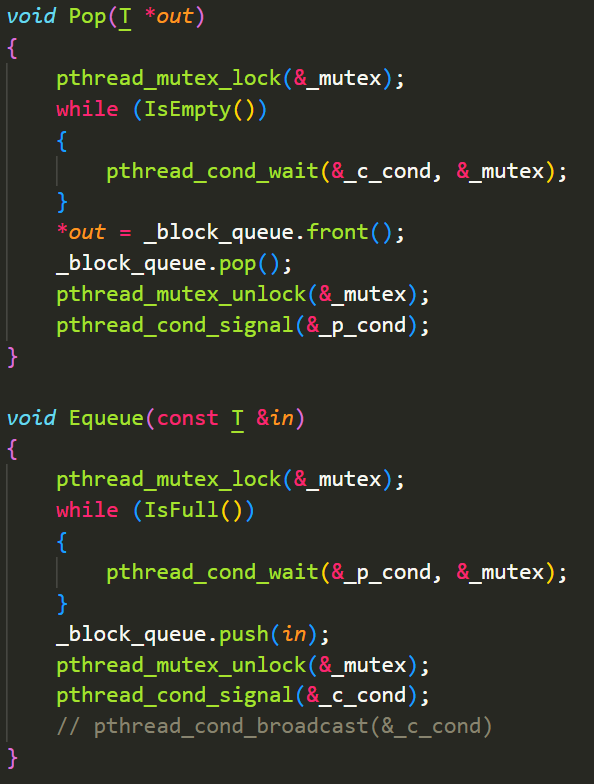
那么现在我们可以实现简单的调用了:
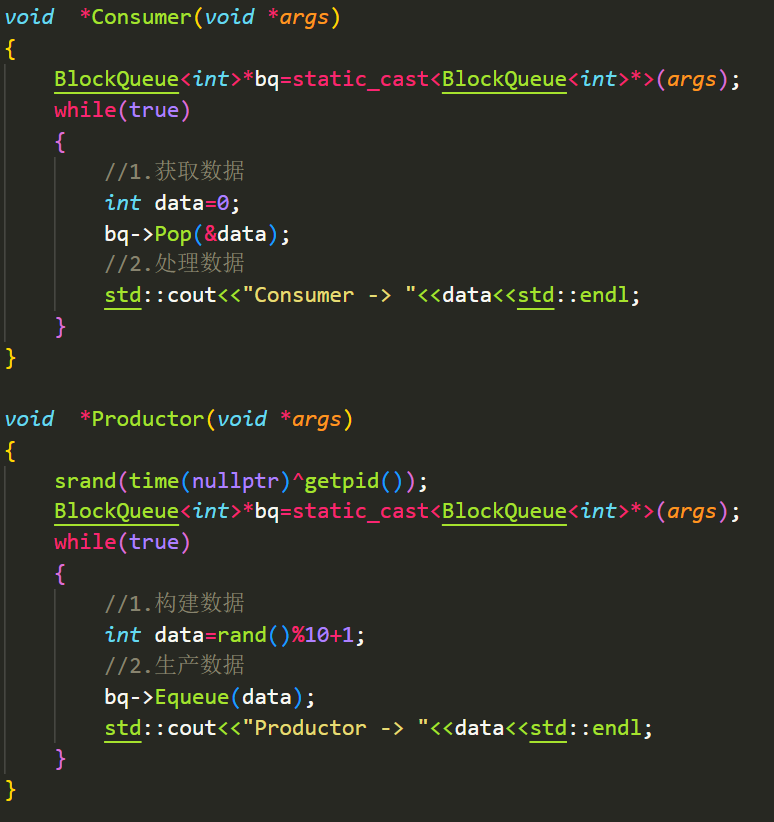
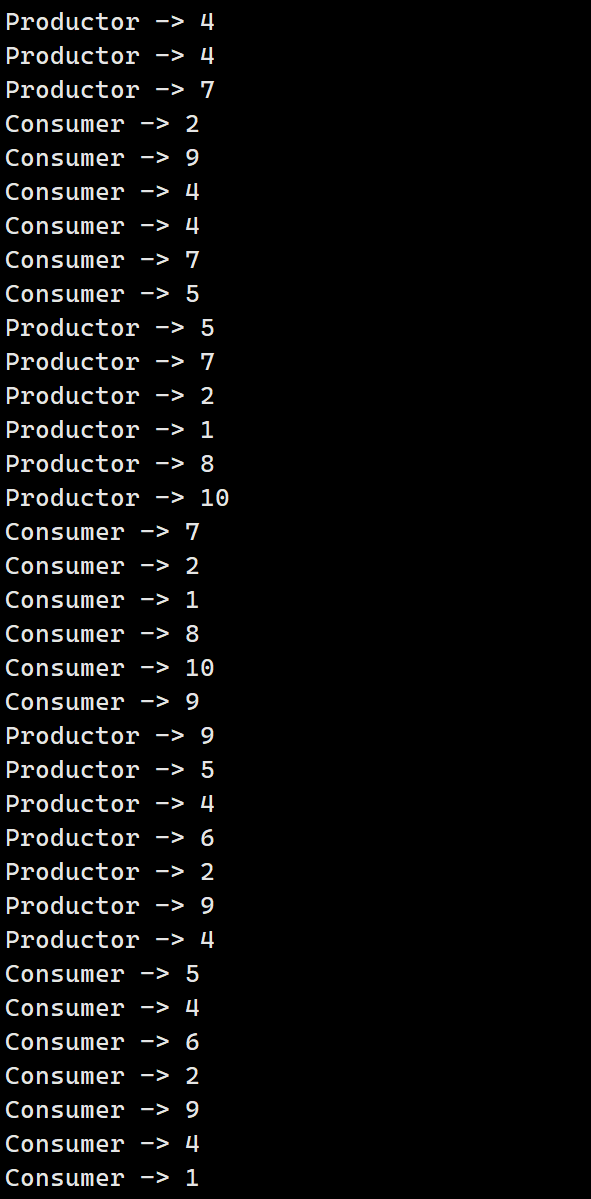
实现的还是挺完美的。但是只能传int这样的代码还是太捞了。我们可以传递一些任务给他们。
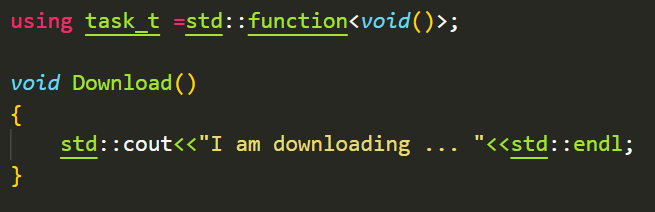
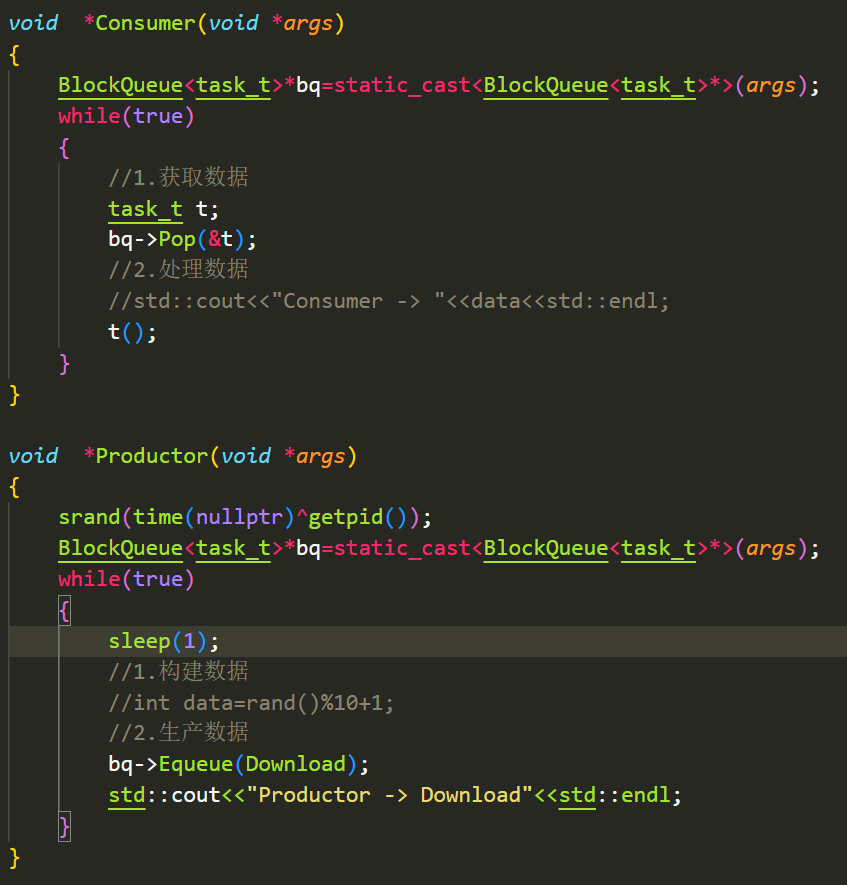
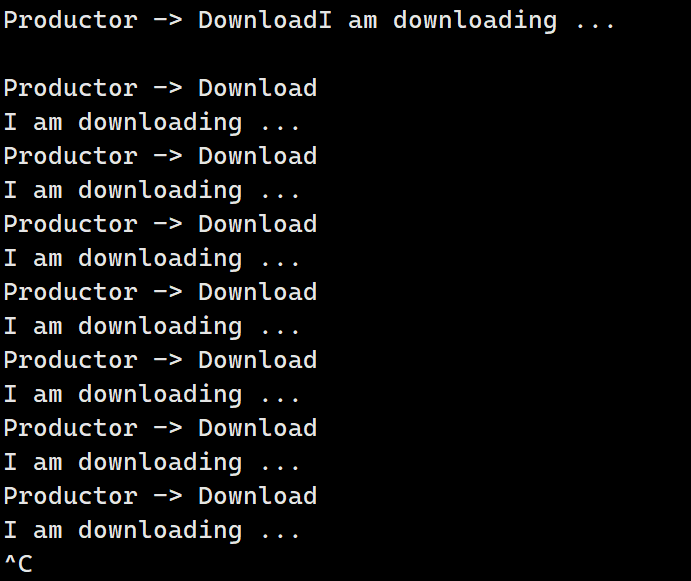
非常完美!
那么接下来就到多生产多消费的情况编写了。
真的需要编写吗?
其实我们刚才编写的代码已经满足多生产多消费的情况啦!
可能有读者会感到疑惑,这个资源获取和生产都是串行的,效率高在哪?
那不要忘记,我们生产资源和消费资源都是需要时间的!在一个消费者正在消费资源的时候,其他消费者就可以去获取资源了。同理生成者在生产资源时,其他生产者就可以在队列里放资源。达到并发的效果。
完整代码
BlockQueue
cpp
#pragma once

#include <iostream>
#include <queue>
#include <pthread.h>

const static int defaultcap = 5;

template <typename T>
class BlockQueue
{
private:
    bool IsFull()
    {
        return _block_queue.size() == _max_cap;
    }

    bool IsEmpty()
    {
        return _block_queue.empty();
    }

public:
    BlockQueue(int cap = defaultcap)
        : _max_cap(cap)
    {
        pthread_mutex_init(&_mutex,nullptr);
        pthread_cond_init(&_p_cond,nullptr);
        pthread_cond_init(&_c_cond,nullptr);
    }

    void Pop(T *out)
    {
        pthread_mutex_lock(&_mutex);
        while (IsEmpty())
        {
            pthread_cond_wait(&_c_cond, &_mutex);
        }
        *out = _block_queue.front();
        _block_queue.pop();
        pthread_mutex_unlock(&_mutex);
        pthread_cond_signal(&_p_cond);
    }

    void Equeue(const T &in)
    {
        pthread_mutex_lock(&_mutex);
        while (IsFull())
        {
            pthread_cond_wait(&_p_cond, &_mutex);
        }
        _block_queue.push(in);
        pthread_mutex_unlock(&_mutex);
        pthread_cond_signal(&_c_cond);
        // pthread_cond_broadcast(&_c_cond)
    }

    ~BlockQueue()
    {
        pthread_mutex_destroy(&_mutex);
        pthread_cond_destroy(&_p_cond);
        pthread_cond_destroy(&_c_cond);
    }

private:
    std::queue<T> _block_queue;
    // 最大容量
    int _max_cap;
    pthread_mutex_t _mutex;
    pthread_cond_t _p_cond;
    pthread_cond_t _c_cond;
};
POSIX信号量
BlockingQueue有两点不足之处:
- 要先判断是否存在资源再阻塞等待
- 整个阻塞队列看作一个整体互斥
对于1我们能否将判断资源是否存在和阻塞等待合二为一呢?
对于2我们能否将阻塞队列细分成多个资源块,对访问其中一个资源块的时候互斥,其他资源块还能被其他线程访问?
没错,这种场景和我们的信号量使用场景一致,不过我们之前的System V信号量只适用于进程间通信,这里的POSIX信号量适用于线程间通信。
我们再回顾一下信号量是什么,信号量就是一个有着原子加减操作的计数器 ,对于共享空间:
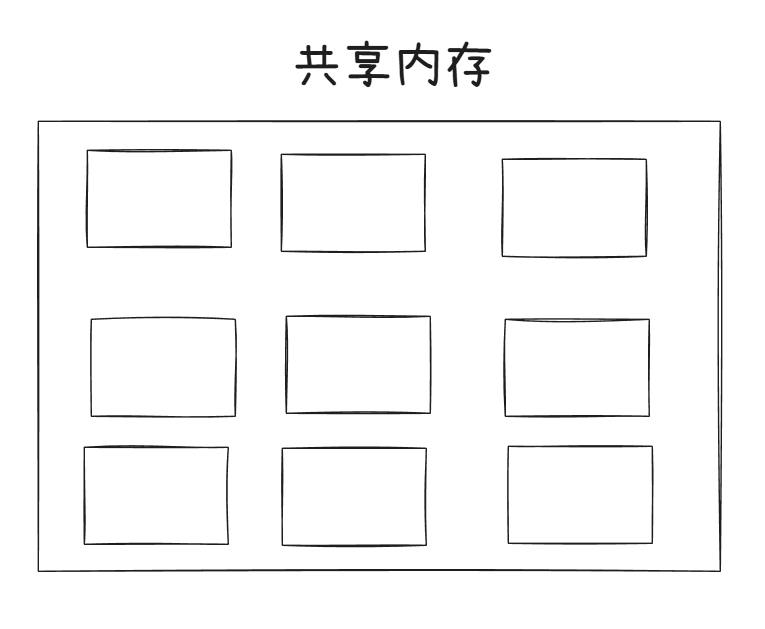
我们可以将内部空间分成九分,就可以初始化信号量为9.
当访问该内存空间,我们要先对信号量减减,即P操作。这相当于我们在电影院看电影的时候,先买票预定位置。
当访问完毕,就对信号量加加,即V操作。相当于将该座位归还给影院,让其他人也可以预定。
当信号量为0的时候,P操作就会阻塞等待。
我们来看看POSIX信号量的接口:
头文件:
cpp
#include <semaphore.h> 初始化:
cpp
int sem_init(sem_t *sem, int pshared, unsigned int value);
参数:
pshared:0表示线程间共享,非零表示进程间共享
value:信号量初始值
销毁:
cpp
int sem_destroy(sem_t *sem); P操作:
cpp
功能:等待信号量,会将信号量的值减1
int sem_wait(sem_t *sem); //P()
V操作:
cpp
功能:发布信号量,表示资源使用完毕,可以归还资源了。将信号量值加1。
int sem_post(sem_t *sem);//V()
是不是非常简洁。
为了模拟实现用信号量的场景,我们这里用环形队列实现生产者消费者模型。
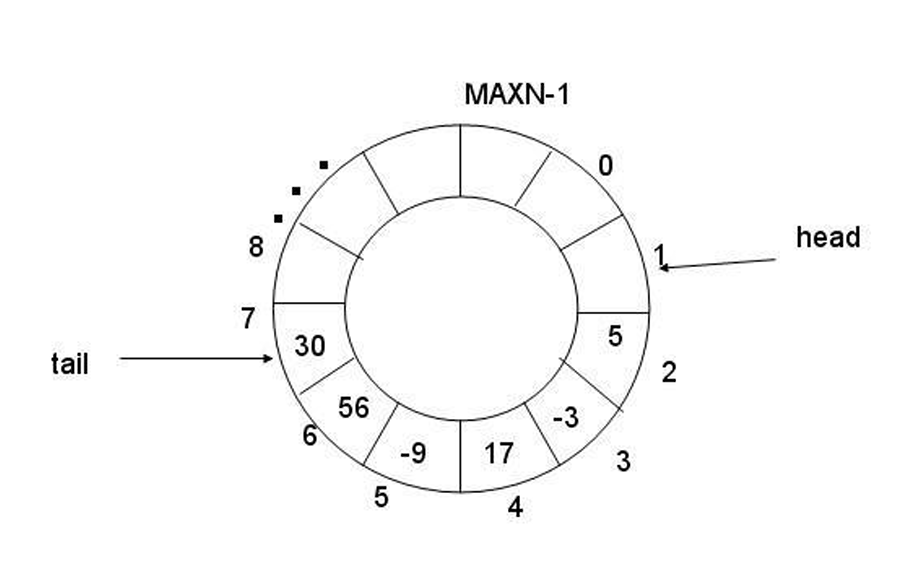
首先环形队列里面要有两个下标head、tail对应消费者下标和生产者下标。
这两个下标分别有三种状态也就是对应环形队列的三种状态:
- 空,消费者阻塞
- 满,生产者阻塞
- 非空非满,消费者和生产者并发执行
那么要实行上面三点,就要引入信号量。但是我们要知道生产者和消费者需要的资源是不同的:
生产者需要的是空间资源,消费者需要的是数据资源。
刚开始空间资源是满的,数据资源是空的。
每当生产者生产,空间资源减少、数据资源增加;每当消费者消费,数据资源减少,空间资源增加。
这意味着我们需要维护两个信号量。
那么我们来尝试编写单生产单消费模型:
基本成员变量:
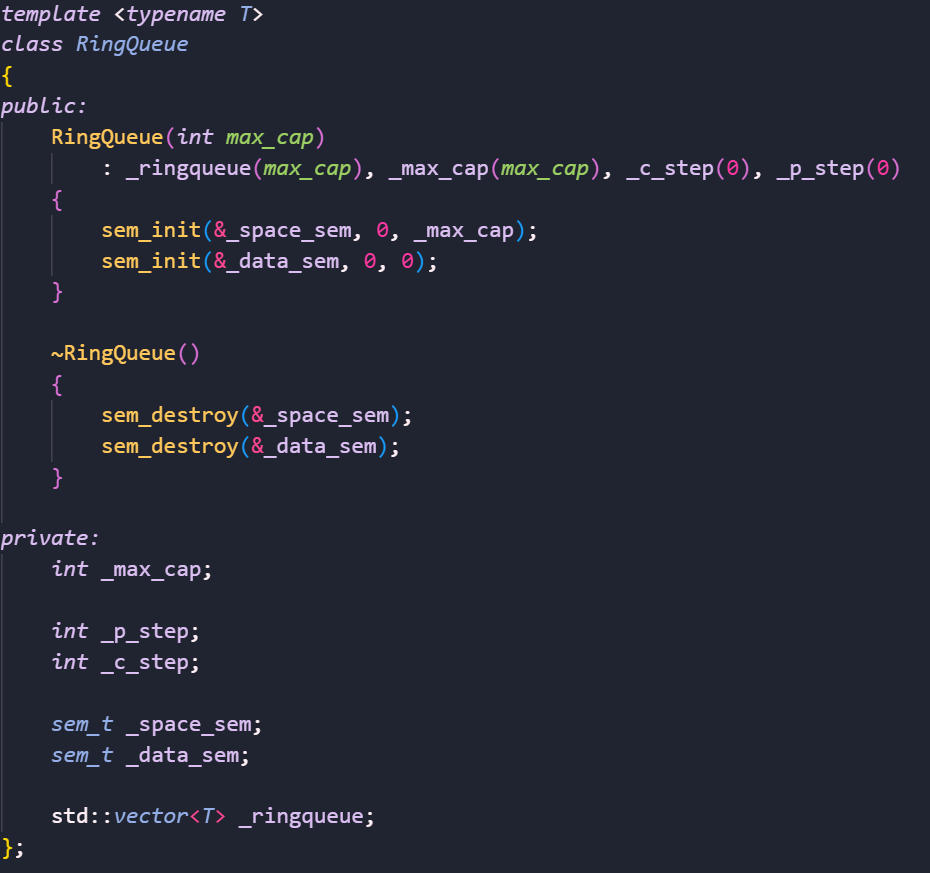
push和pop:
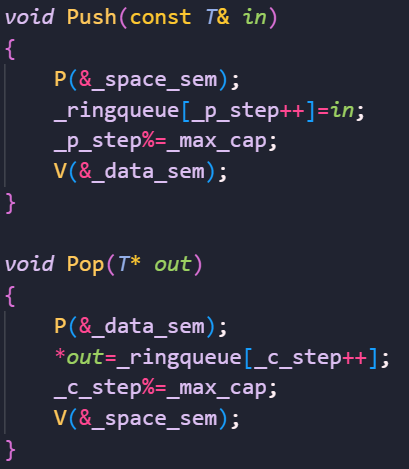
根据我们在BlockQuue编写的经验,这里已经满足单生产单消费了。
那么该如何改进为多生产多消费呢?
很显然我们需要维护生产者之间、消费者之间的互斥关系,因此我们需要互斥锁。
具体需要几把互斥锁呢?
我们不是希望生产的时候能并发消费吗,因此两个线程应该互不影响,故需要维护两把锁。
那么接下来我们该考虑是在申请信号前上锁还是之后上锁?
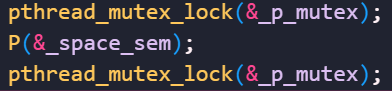
显然当我们先上锁的话,申请信号量就变成了串行。
但如果我们后上锁的话,申请信号量就变成了并发。
通俗来说,先上锁就相当于先排队进电影院,然后再去买票。后上锁相当于,先网购了电影票,然后再排队进电影院。很显然后者效率更高。
那么完整代码奉上:
cpp
#pragma once
#include <vector>
#include <semaphore.h>
#include<pthread.h>

template <typename T>
class RingQueue
{
private:
    void P(sem_t* sem)
    {
        sem_wait(sem);
    }

    void V(sem_t* sem)
    {
        sem_post(sem);
    }
public:
    RingQueue(int max_cap)
        : _ringqueue(max_cap), _max_cap(max_cap), _c_step(0), _p_step(0)
    {
        sem_init(&_space_sem, 0, _max_cap);
        sem_init(&_data_sem, 0, 0);
        pthread_mutex_init(&_p_mutex,nullptr);
        pthread_mutex_init(&_c_mutex,nullptr);
    }

    void Push(const T& in)
    {
        P(&_space_sem);
        pthread_mutex_lock(&_p_mutex);
        _ringqueue[_p_step++]=in;
        _p_step%=_max_cap;
        pthread_mutex_unlock(&_p_mutex);
        V(&_data_sem);
    }

    void Pop(T* out)
    {
        P(&_data_sem);
        pthread_mutex_lock(&_c_mutex);
        *out=_ringqueue[_c_step++];
        _c_step%=_max_cap;
        pthread_mutex_unlock(&_c_mutex);
        V(&_space_sem);
    }

    ~RingQueue()
    {
        sem_destroy(&_space_sem);
        sem_destroy(&_data_sem);
        pthread_mutex_destroy(&_p_mutex);
        pthread_mutex_destroy(&_c_mutex);
    }
private:
    int _max_cap;

    int _p_step;
    int _c_step;

    sem_t _space_sem;
    sem_t _data_sem;

    pthread_mutex_t _p_mutex;
    pthread_mutex_t _c_mutex;

    std::vector<T> _ringqueue;
};
线程池
线程池:
一种线程使用模式。线程过多会带来调度开销,进而影响缓存局部性和整体性能。而线程池维护着多个线程,等待着监督管理者分配可并发执行的任务。这避免了在处理短时间任务时创建与销毁线程的代价。线程池不仅能够保证内核的充分利用,还能防止过分调度。可用线程数量应该取决于可用的并发处理器、处理器内核、内存、网络sockets等的数量。
应用场景:
-
需要大量的线程来完成任务,且完成任务的时间比较短。 WEB服务器完成网页请求这样的任务,使用线程池技术是非常合适的。因为单个任务小,而任务数量巨大,你可以想象一个热门网站的点击次数。 但对于长时间的任务,比如一个Telnet连接请求,线程池的优点就不明显了。因为Telnet会话时间比线程的创建时间大多了。
-
对性能要求苛刻的应用,比如要求服务器迅速响应客户请求。
-
接受突发性的大量请求,但不至于使服务器因此产生大量线程的应用。突发性大量客户请求,在没有线程池情况下,将产生大量线程,虽然理论上大部分操作系统线程数目最大值不是问题,短时间内产生大量线程可能使内存到达极限,出现错误.
根据我们前面编写进程池的经验,线程池自然是手到擒来。
而且不难发现,我们的线程池其实就是一个单生产多消费模型。我们可以用前面封装的thread库来编写我们的简易线程池。
首先我们最基本的成员变量、构造函数和析构函数就是如此:
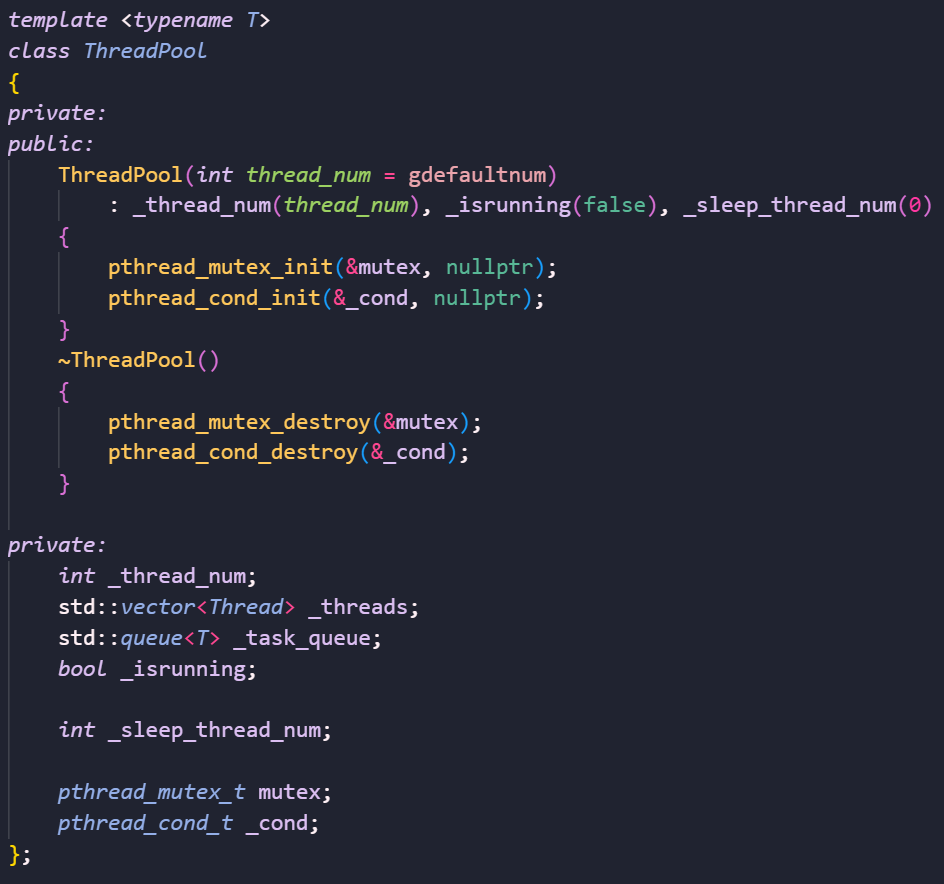
接下来的话我们要实现初始化、入队列、开始、停止等功能,这些都是轻车熟路了就不多做赘述。
我们来看看有什么需要注意的点。
为了让我们输出更直观,这里我们将Thread里的func_t改为:

然后还记得我们传入的类成员函数,由于有一个默认的this指针,导致参数不匹配。之前的解决方法是将this指针传给pthread_create。这个方法多少有点low了,我们现在改用包装器bind,将第一个参数绑定成this指针即可:
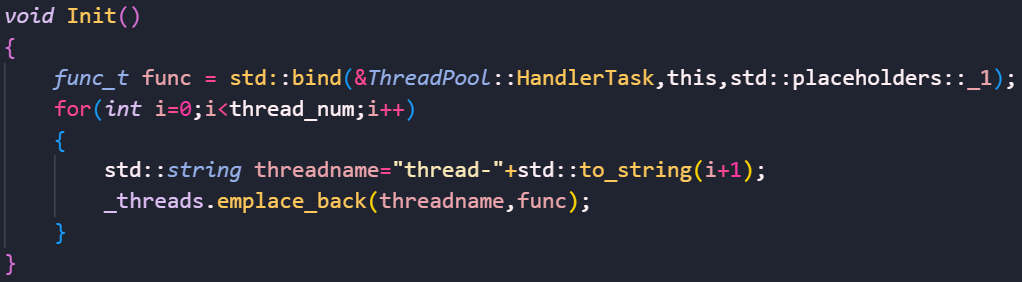
然后还需要注意Stop:
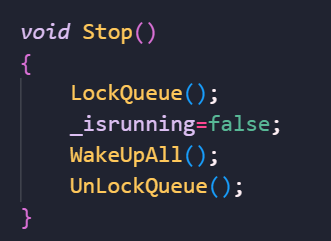
我们首先将运行状态变为假,此外还要唤醒所有在阻塞的队列。并且,我们最好让线程池先将任务队列清空再停下:
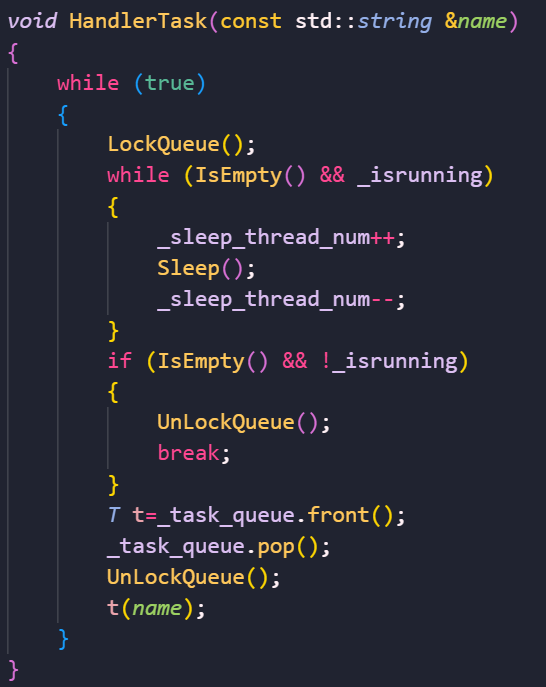
即需判断当前任务队列是否为空,不为空就要继续执行任务。
这个HandlerTask需要注意,千万不要将执行任务放在临界区,不然你写多线程来干什么,任务全都串行了!!
日志
我们以前的信息都是直接打印到显示器上的,还有有点low了。现在我们来封装一个简易的日志,让我们的信息能够选择打印到显示器还是输出到文档之中。
首先,我们要规定好日志内容的格式:
日志等级pidfilenamefilenumbertime 日志内容(支持可变参数)
这里filenumber是当前行号。
我们的日志等级主要分为:
DEBUG,INFO,WARNING,ERROR,FATAL。
有了这些信息就开始编写日志吧,其实还是非常简单的。
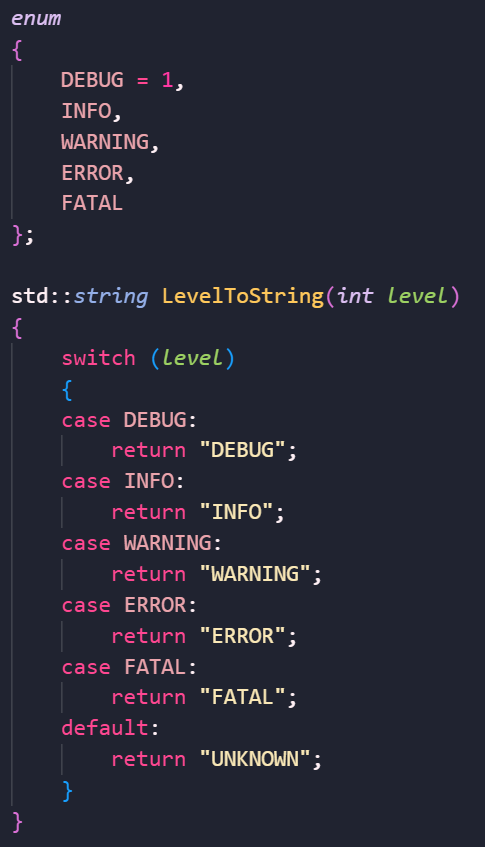
首先我们可以宏定义我们的日志等级,然后转化为string:
随后,我们要通过调用time
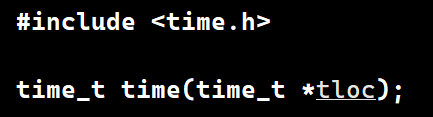
获取当前时间戳。
再通过localtime获取tm结构体:

然后就可以从里面获取时间了:
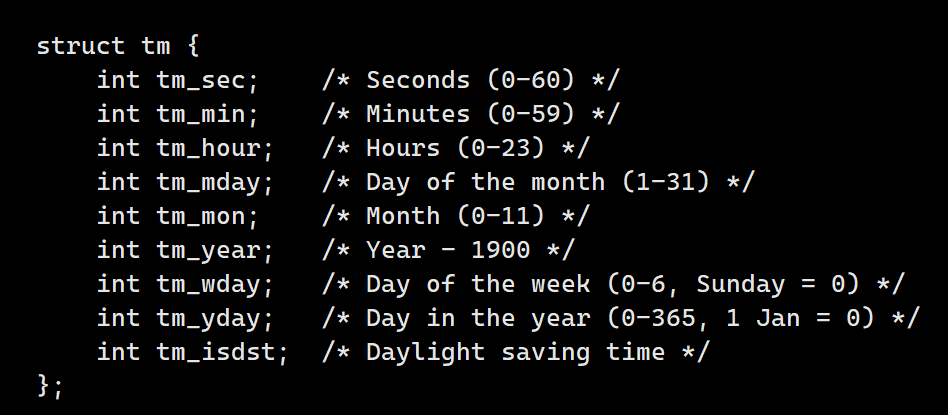
这里需要注意年是-1900的,月是0-11的,我们要修正回来:
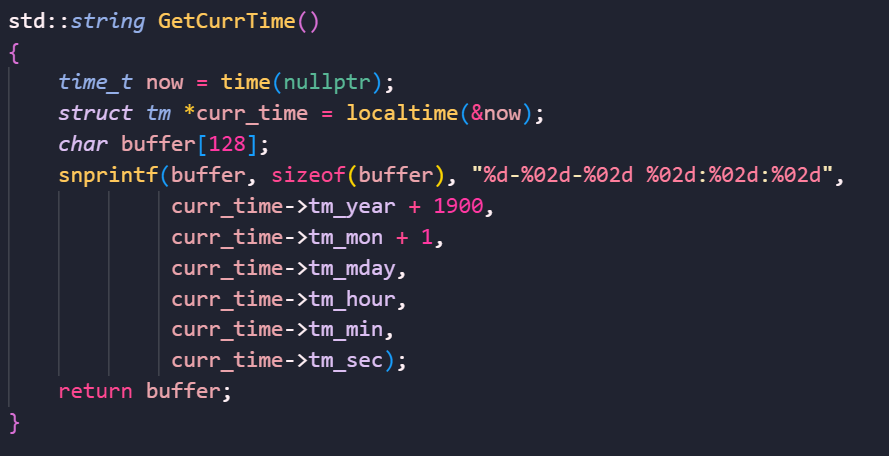
然后封装一个日志信息类:
cpp
class logmessage
    {
    public:
        std::string _level;
        pid_t _id;
        std::string _filename;
        int _filenumber;
        std::string _curr_time;
        std::string _message_info;
    };
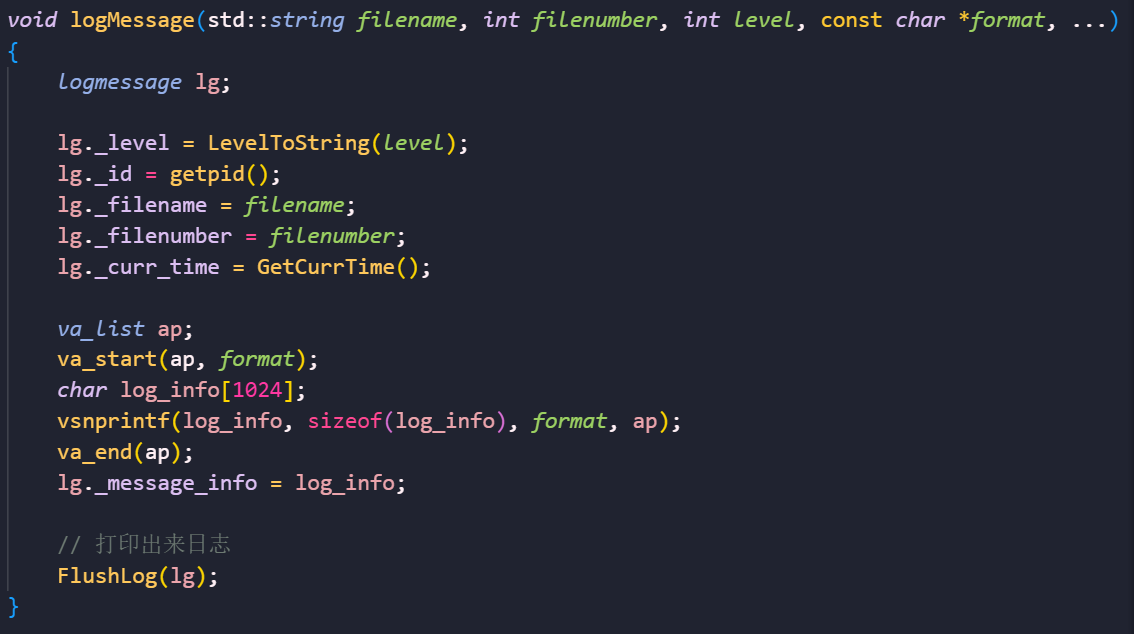
然后就要开始封装日志类了,这里关键是载入日志信息,我们可以用C语言的可变参数列表加上vsnprintf:
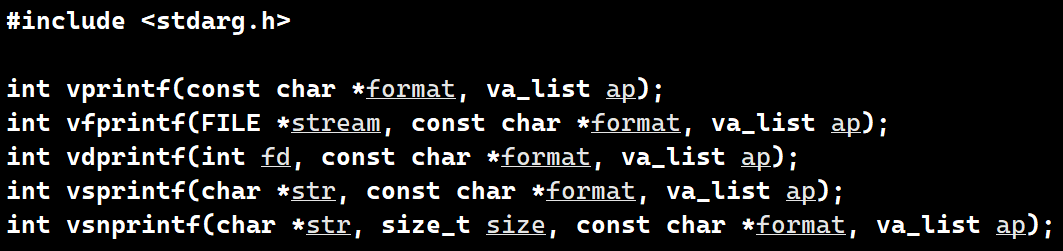
来实现可传入可变参数的载入信息函数:
不过我们这样调用载入信息还得手动传入文件名和行号,这多少有点丑陋了,我们可以封装一些宏函数,让其调用更加优雅:
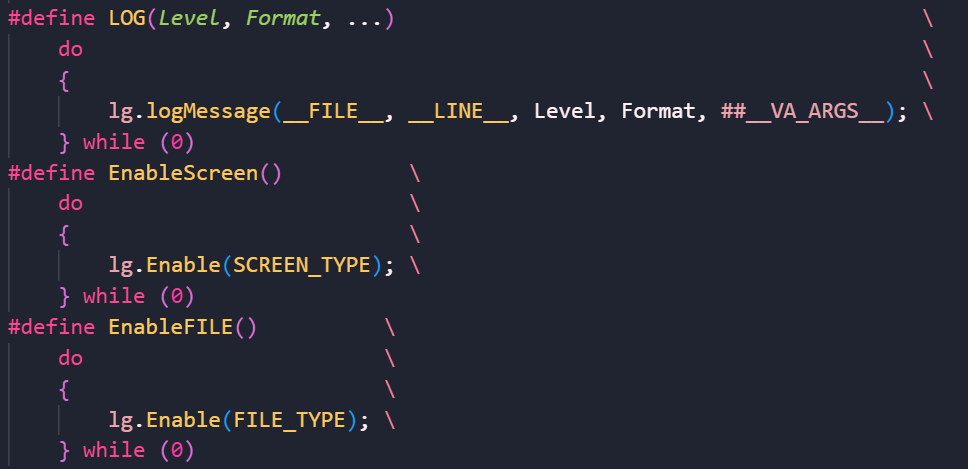
没错,我们的宏函数也是可以传入可变参数的。
这里__FILE__和__LINE__就是C语言提供给我们的宏定义,能转换为当前文件名和当前行号。
这样我们记录日志信息就优雅多了。
日志完整代码
cpp
#pragma once

#include <iostream>
#include <sys/types.h>
#include <unistd.h>
#include <ctime>
#include <cstdarg>
#include <fstream>
#include <cstring>
#include <pthread.h>
#include <string>
#include "LockGuard.hpp"

namespace log_ns
{
    enum
    {
        DEBUG = 1,
        INFO,
        WARNING,
        ERROR,
        FATAL
    };

    std::string LevelToString(int level)
    {
        switch (level)
        {
        case DEBUG:
            return "DEBUG";
        case INFO:
            return "INFO";
        case WARNING:
            return "WARNING";
        case ERROR:
            return "ERROR";
        case FATAL:
            return "FATAL";
        default:
            return "UNKNOWN";
        }
    }

    std::string GetCurrTime()
    {
        time_t now = time(nullptr);
        struct tm *curr_time = localtime(&now);
        char buffer[128];
        snprintf(buffer, sizeof(buffer), "%d-%02d-%02d %02d:%02d:%02d",
                 curr_time->tm_year + 1900,
                 curr_time->tm_mon + 1,
                 curr_time->tm_mday,
                 curr_time->tm_hour,
                 curr_time->tm_min,
                 curr_time->tm_sec);
        return buffer;
    }

    class logmessage
    {
    public:
        std::string _level;
        pid_t _id;
        std::string _filename;
        int _filenumber;
        std::string _curr_time;
        std::string _message_info;
    };

#define SCREEN_TYPE 1
#define FILE_TYPE 2

    const std::string glogfile = "./log.txt";
    pthread_mutex_t glock = PTHREAD_MUTEX_INITIALIZER;
    class Log
    {
    public:
        Log(const std::string &logfile = glogfile) : _logfile(logfile), _type(SCREEN_TYPE)
        {
        }

        void Enable(int type)
        {
            _type = type;
        }

        void FlushLogToScreen(const logmessage &lg)
        {
            printf("[%s][%d][%s][%d][%s] %s",
                   lg._level.c_str(),
                   lg._id,
                   lg._filename.c_str(),
                   lg._filenumber,
                   lg._curr_time.c_str(),
                   lg._message_info.c_str());
        }

        void FlushLogToFile(const logmessage &lg)
        {
            std::ofstream out(_logfile, std::ios::app);
            if (!out.is_open())
                return;
            char logtxt[2048];
            snprintf(logtxt, sizeof(logtxt), "[%s][%d][%s][%d][%s] %s",
                     lg._level.c_str(),
                     lg._id,
                     lg._filename.c_str(),
                     lg._filenumber,
                     lg._curr_time.c_str(),
                     lg._message_info.c_str());
            out.write(logtxt, strlen(logtxt));
            out.close();
        }

        void FlushLog(const logmessage &lg)
        {
            // 加过滤逻辑 --- TODO

            LockGuard lockguard(&glock);
            switch (_type)
            {
            case SCREEN_TYPE:
                FlushLogToScreen(lg);
                break;
            case FILE_TYPE:
                FlushLogToFile(lg);
                break;
            }
        }

        void logMessage(std::string filename, int filenumber, int level, const char *format, ...)
        {
            logmessage lg;

            lg._level = LevelToString(level);
            lg._id = getpid();
            lg._filename = filename;
            lg._filenumber = filenumber;
            lg._curr_time = GetCurrTime();

            va_list ap;
            va_start(ap, format);
            char log_info[1024];
            vsnprintf(log_info, sizeof(log_info), format, ap);
            va_end(ap);
            lg._message_info = log_info;

            // 打印出来日志
            FlushLog(lg);
        }

        ~Log()
        {
        }

    private:
        int _type;
        std::string _logfile;
    };
#define LOG(Level, Format, ...)                                          \
    do                                                                   \
    {                                                                    \
        lg.logMessage(__FILE__, __LINE__, Level, Format, ##__VA_ARGS__); \
    } while (0)
#define EnableScreen()          \
    do                          \
    {                           \
        lg.Enable(SCREEN_TYPE); \
    } while (0)
#define EnableFILE()          \
    do                        \
    {                         \
        lg.Enable(FILE_TYPE); \
    } while (0)
};
完善线程池和完整代码
我们的线程池可以实现为单例模式.为了效率,我们采取懒汉模式的单例模式设计,具体内容就参考那篇特殊类设计。
然后既然实现了日志,我们就可以在线程池上加上日志功能。
最后完整代码奉上!