推理过程的差异

在前面我们完整地讲解了训练过程的操作,建议可以先看看前文:
词嵌入和位置编码(超详细+图解)https://blog.csdn.net/Drise_/article/details/155502880?fromshare=blogdetail&sharetype=blogdetail&sharerId=155502880&sharerefer=PC&sharesource=Drise_&sharefrom=from_linkhttps://blog.csdn.net/Drise_/article/details/155502880?fromshare=blogdetail&sharetype=blogdetail&sharerId=155502880&sharerefer=PC&sharesource=Drise_&sharefrom=from_link

编码器详解(超详细+图解)https://blog.csdn.net/Drise_/article/details/155556414?fromshare=blogdetail&sharetype=blogdetail&sharerId=155556414&sharerefer=PC&sharesource=Drise_&sharefrom=from_link

解码器详解(训练过程)https://blog.csdn.net/Drise_/article/details/155804075?fromshare=blogdetail&sharetype=blogdetail&sharerId=155804075&sharerefer=PC&sharesource=Drise_&sharefrom=from_link

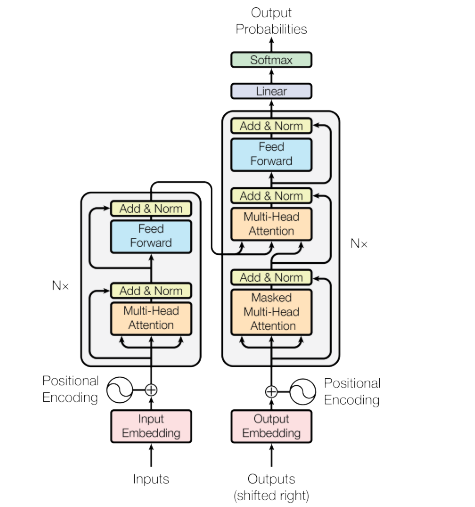
以下为***《Attention Is All You Need》*** 的transformer结构,本文会对解码器部分进行介绍:
训练过程的作用

之前我们对编码器和解码器在训练过程的操作进行了讲解,那么训练过程对模型有什么作用?

基于论文中的翻译任务,训练过程的作用那就是让模型学会从输入到输出的映射关系,通过优化参数使模型能够准确预测或生成目标序列,也就是让模型 "学会翻译"。

推理过程

推理过程与训练过程的差异

在推理过程的目的是通过源文本推理出目标文本,例如在中英文翻译在,源文本为 "I love you ",目标文本就是 我爱你。

那么推理过程与训练过程有什么相同之处和不同之处呢?

其实推理过程和训练过程大体是一样的,在训练过程我们在编码器部分输入源文本,在解码器部分输入源文本对应的目标文本,但是有两个地方的不同要关注到。

首先是在解码器的token预测的方式不同,在训练过程,从前文我们可以知道,经过一次编码器堆栈可以得到各个位置的目标token的概率,但是在Transformer推理时,必须经过多次解码器堆栈的前向传播,一次只能预测下一个token,也就是说,每次通过一整个解码器堆栈,只能生成一个token,token是串行推理生成的。
第二点是在解码器部分的输入训练和推理过程存在不同,在推理过程我们需要推理出目标文本,并不像训练过程一样存在一个目标文本的正确答案,所以在推理过程中解码器部分的输入是一个空文本,为了辨识开头,最终输入到解码器堆栈的实际上是一个只包含开始token,也就是只包含<s>的token序列。

如此沿用训练过程编码器和解码器**处理模式,**我们就可以推理得到每一个目标token,再转换为目标文本即可。

​

相关推荐
一起学安全技术17 小时前
拆大模型 03|注意力的一句话版本:不用论文讲清 Attention
深度学习·算法·语言模型·transformer
风巽·剑染春水17 小时前
【Generative AI综述】生成式人工智能在医学影像中的应用(ACME-2026)
人工智能·transformer·gan·vae·生成模型·扩散模型·医学影像
机器学习之心19 小时前
5 个特征、2 个输出:让 DBO 替 CNN-Transformer 挑结构,再用 SHAP 把黑箱撬开
人工智能·cnn·transformer·cnn-transformer
bryant_meng2 天前
【TNT】《Transformer in Transformer》
人工智能·深度学习·transformer·word embedding·tnt·sentence embed
布吉岛的石头4 天前
Java 程序员第 50 阶段14:灾难性遗忘与回放
人工智能·深度学习·transformer
weixin_468466854 天前
视觉Transformer的“第二次革命”:ViT³如何用测试时训练重构注意力范式
人工智能·深度学习·机器学习·ai·重构·transformer·vit
DevOps老兵5 天前
Transformer拆解13:现代大模型改了什么,RoPE、RMSNorm、SwiGLU与GQA
transformer·gqa·rope·rmsnorm·swiglu
飞猫的边缘AI8 天前
边缘AI芯片的规则变了:从跑CNN到跑LLM和VLM
人工智能·语言模型·cnn·transformer·边缘ai
DevOps老兵8 天前
Transformer拆解06:Self-Attention,一句话里的词怎样互相看见
大模型·transformer·自注意力·self-attention·注意力矩阵
秋秋小事9 天前
transformer基础 RNN + LSTM
rnn·lstm·transformer