聚合函数是对一组数据进行汇总,输入是一组数据的集合,输出是单个数据值。
1、聚合函数介绍
聚合函数不能嵌套调用,例如不能出现 AVG(SUM(字段名称))等形式。
1.1 AVG和SUM函数
可以对数值型数据 使用AVG(平均) 和 SUM (求和)函数。SUM在使用时也会自动屏蔽NULL。
sql
SELECT AVG(salary),SUM(salary),AVG(salary)*107
FROM employees;
1.2 MIN和MAX函数
可以对任意数据类型的数据使用 MIN (最小)和 MAX(最大) 函数。
sql
# 数值类型
SELECT MAX(salary),MIN(salary)
FROM employees;# 24000 2100
# 字符串
SELECT MAX(hire_date),MIN(hire_date)
FROM employees; # 2000-04-21  1987-06-17
1.3 COUNT函数
作用:计算指定字段在查询结果中出现的个数。
- COUNT(*)返回表中记录总数,适用于任意数据类型。
sql
# 查询表中多少条记录
SELECT COUNT(employee_id),COUNT(salary),COUNT(1)
FROM employees;# 107 107 107

SELECT COUNT(*)
FROM employees
WHERE department_id = 50; # 45- COUNT(expr) 返回expr不为空的记录总数。(commission_pct 存在值为NULL的结果)
sql
SELECT COUNT(commission_pct)
FROM employees; # 35- 公式:AVG = SUM / COUNT 一直适用,无论是否含有 NULL。
sql
SELECT AVG(commission_pct),SUM(commission_pct)/COUNT(commission_pct),SUM(commission_pct)/107
FROM employees; # 0.222857 0.222857  0.072897
1.4 COUNT 的SQL 优化方案
需求:统计表中的记录数,使用COUNT(*)、COUNT(1)、COUNT(具体字段)哪个效率更高?
- 如果使用 MyISAM 引擎,三者的效率相同,都是O(1)
- 如果使用 InnoDB 引擎,三者的执行效率:COUNT(*)= COUNT(1)> COUNT(具体字段),复杂度是O(n)直接读取行数
2、GROUP BY
2.1 基本用法
定义:可以使用GROUP BY子句将表中的数据分成若干组。
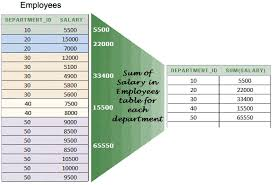
若要求出员工表中各个部门 的平均工资,则要使用 GROUP BY 子句将表中数据分为若干组。
sql
SELECT department_id,AVG(salary),SUM(salary)
FROM employees
GROUP BY department_id;
代码模板:
sql
SELECT column, group_function(column)
FROM table
[WHERE	condition] # where 如果有 则一定紧跟from之后
[GROUP BY group_by_expression]
[ORDER BY column];
2.2 多个列分组
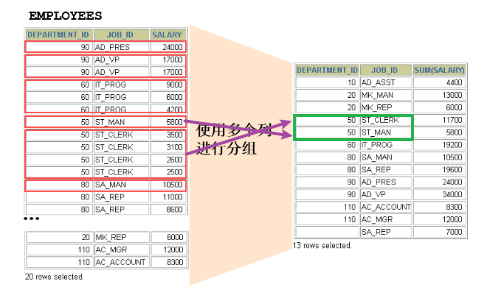
进一步细分,同一个组内不同的工种又可以分为一个组。实现部门之间的大组以及部门内的小组。
sql
SELECT department_id dept_id,job_id,AVG(salary)
FROM employees
GROUP BY department_id,job_id
ORDER BY department_id;
# 两个表达等价 与排序字段的先后顺序无关
SELECT department_id dept_id,job_id,AVG(salary)
FROM employees
GROUP BY job_id,department_id
ORDER BY department_id;- 包含在 GROUP BY 子句中的列不必包含在SELECT 列表中(可以为了更直观表示在select字段加入额外的查询字段)
- 在SELECT列表中所有未包含在组函数中的列都应该包含在 GROUP BY子句中!!!(以下示例是错误的)
sql
# 错误写法 job_id不在分组语句中
SELECT department_id,job_id,AVG(salary)
FROM employees
GROUP BY department_id;
2.3 WITH ROLLUP 的使用
使用 WITH ROLLUP关键字之后,在所有查询出的分组记录之后增加一条记录 ,该记录计算查询出的所有记录的总和,即统计记录数量。其后不应使用ORDER BY。
sql
SELECT department_id,AVG(salary)
FROM employees
GROUP BY department_id WITH ROLLUP;
3、HAVING
3.1 基本使用
用于过滤数据:

需求:查询各个部门中最高工资比10000高的部门信息
sql
SELECT department_id,MAX(salary)
FROM employees
GROUP BY department_id
HAVING MAX(salary)>10000; # 声明在GROUP BY的后面- 非法使用聚合函数 : 不能在 WHERE 子句中使用聚合函数 。
sql
# 错误示例
SELECT department_id,AVG(salary)
FROM employees
WHERE AVG(salary) > 8000
GROUP BY department_id;
要求:过滤分组
- 行已经被分组
- 使用了聚合函数
- 满足 HAVING 子句的分组被查找出来
- HAVING 不能单独使用,要与 GROUP BY 一起使用
3.2 WHERE 和 HAVING 的对比
需求:查询部门id为10,20,30,40中最高工资比10000高的部门信息
sql
# 方式一(推荐)
SELECT department_id,MAX(salary)
FROM employees
WHERE department_id IN (10,20,30,40)
GROUP BY department_id
HAVING MAX(salary)>10000;
# 方式二
SELECT department_id,MAX(salary)
FROM employees
GROUP BY department_id
HAVING MAX(salary)>10000 AND department_id IN (10,20,30,40);
对于上述两种方式我们发现过滤部门编号的语句在 WHERE 和 HAVING 中均可,那么我们该如何选择呢?下面是该问题的答案:
- 当过滤条件中有聚合函数时,此过滤条件必须声明在 HAVING 中;
- 当过滤条件中没有聚合函数时,此过滤条件在哪个里面都可以,建议声明在 WHERE 中;
因此可以得到:HAVING 的应用范围更大;WHERE 只能解决没有聚合函数的过滤条件,但是WHERE 的效率更高。
| 优点 | 缺点 | |
|---|---|---|
| WHERE | 先筛选数据再关联,执行效率高 | 不能使用分组中的计算函数进行筛选 |
| HAVING | 可以使用分组中的计算函数 | 在最后的结果集中进行筛选,执行效率较低 |
4、SELECT 执行过程
4.1 完整的查询结构
sql
#方式1:SQL92
SELECT ...,....,...(存在聚合函数)
FROM ...,...,....
WHERE 多表的连接条件 AND 不包含组函数的过滤条件
GROUP BY ...,...
HAVING 包含组函数的过滤条件
ORDER BY ... ASC/DESC
LIMIT ...,...

#方式2:SQL99
SELECT ...,....,...
FROM ...(LEFT/RIGHT) JOIN ...
ON 多表的连接条件
(LEFT/RIGHT) JOIN ... ON ...
WHERE 不包含组函数的过滤条件
AND/OR 不包含组函数的过滤条件
GROUP BY ...,...
HAVING 包含组函数的过滤条件
ORDER BY ... ASC/DESC
LIMIT ...,...
4.2 执行顺序
(1)关键字的编写顺序
sql
SELECT ... FROM ... WHERE ... GROUP BY ... HAVING ... ORDER BY ... LIMIT...(2)SELECT 语句执行顺序
sql
FROM -> WHERE -> GROUP BY -> HAVING -> SELECT 的字段 -> DISTINCT -> ORDER BY -> LIMIT在 SELECT 语句执行这些步骤的时候,每个步骤都会产生一个虚拟表,然后将这个虚拟表传入下一个步骤中作为输入。