(1)插入数据
批量插入:
insert into tb_test values(1, 'Tom'),(2,'Cat'),(3,'jerry');
手动提交事务
start transaction;
insert into tb_test values(1, 'Tom'),(2,'Cat'),(3,'jerry');
insert into tb_test values(4, 'Tom'),(5,'Cat'),(6,'jerry');
insert into tb_test values(7, 'Tom'),(8,'Cat'),(9,'jerry');
commit;
大批量插入数据
如果一次性需要插入大批量数据,使用insert语句插入性能较低,此时可以使用MySQL数据库提供的load指令进行插入,操作如下:
#客户端连接服务端时,加上参数 ---local-infile
mysql --local-infile -u root -p
#设置全局参数local_infile为1,开启从本地加载文件导入数据的开关
set global local_infile=1;
#执行load指令将准备好的数据,加载到表结构中
load data local infile '/root/sql1.log' into table 'tb_user' fields terminated by ',' lines terminated by '\n';
(2)主键优化
页分裂
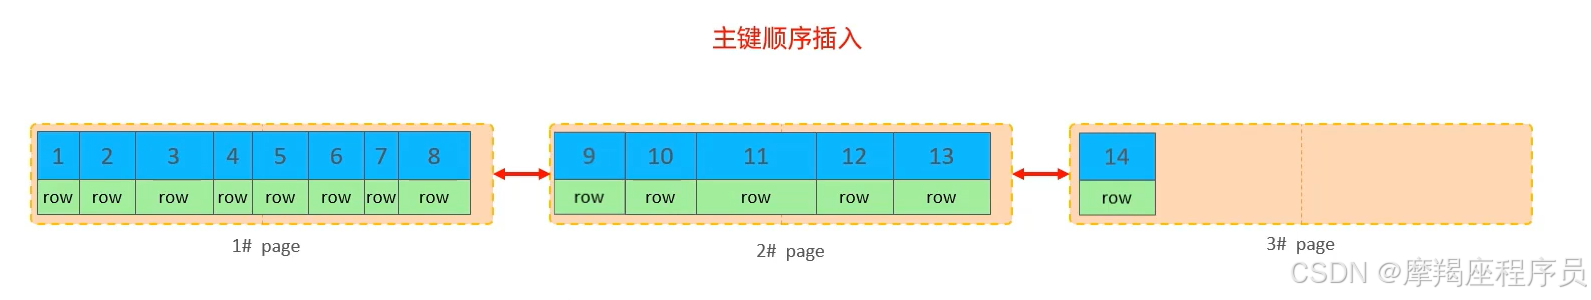
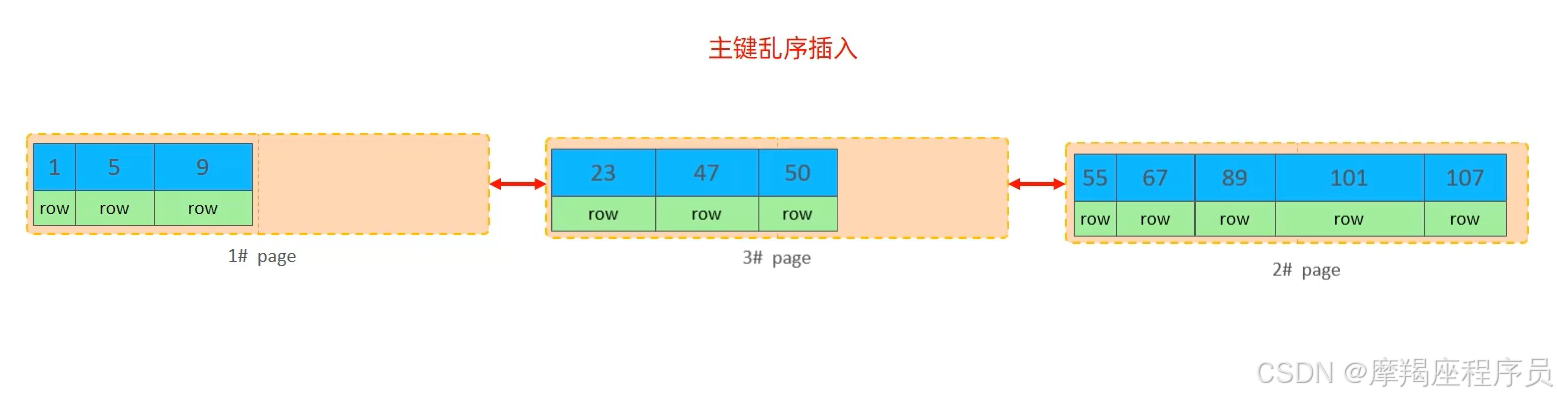
页可以为空,也可以填充一半,也可以填充100%。每个页包含了2-N行数据(如果一行数据过大,会行溢出),根据主键排列
页合并:
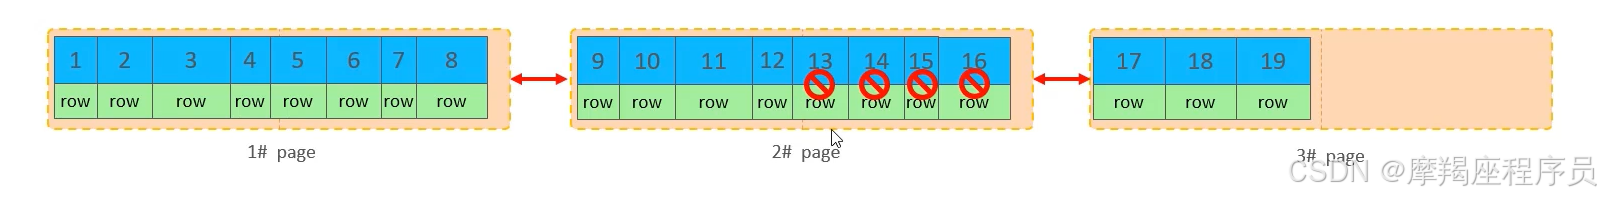
当删除一行记录时,实际上记录并没有被物理删除,只是记录被标记(flaged)为删除并且它的空间变得允许被其他记录声明使用。当页中删除的记录达到MERGE_THRESHOLD(默认为页的50%),InnoDB会开始寻找最靠近的页(前或后)看看是否可以将两个页合并以优化空间使用。
主键设计原则
满足业务需求的情况下,尽量降低主键的长度。
插入数据时,尽量选择顺序插入,选择使用AUTO_INCREMENT自增主键。
尽量不要使用UUID做主键或者是其他自然主键,如身份证号
业务操作时,避免对主键的修改。
(3)order by优化
-
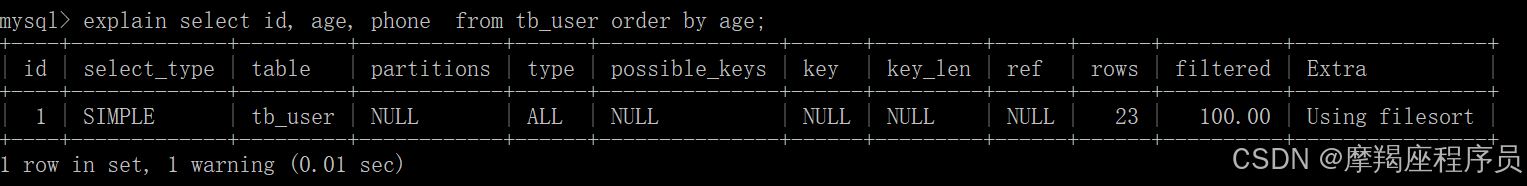
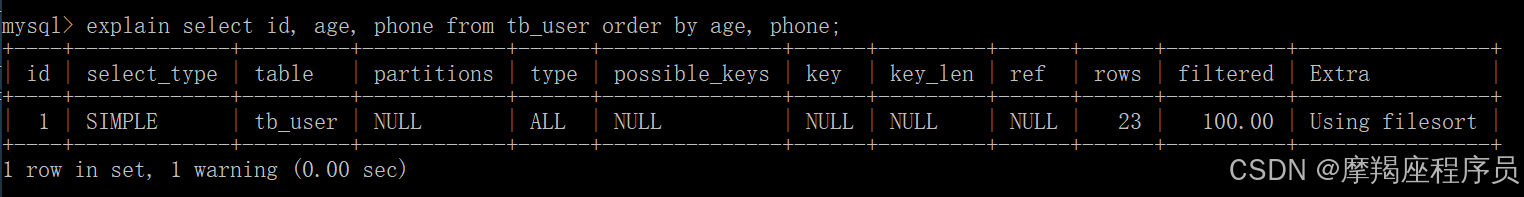
Using filesort: 通过表的索引或全表扫描,读取满足条件的数据行,然后在排序缓冲区sort buffer中完成排序操作,所有不是通过索引直接返回排序结果的排序都叫filesort排序。
-
using index: 通过有序索引顺序扫描直接返回有序数据,这种情况即为using index,不需要额外排序,操作效率高。
explain select id, age, phone from tb_user order by age;
explain select id, age, phone from tb_user order by age, phone;
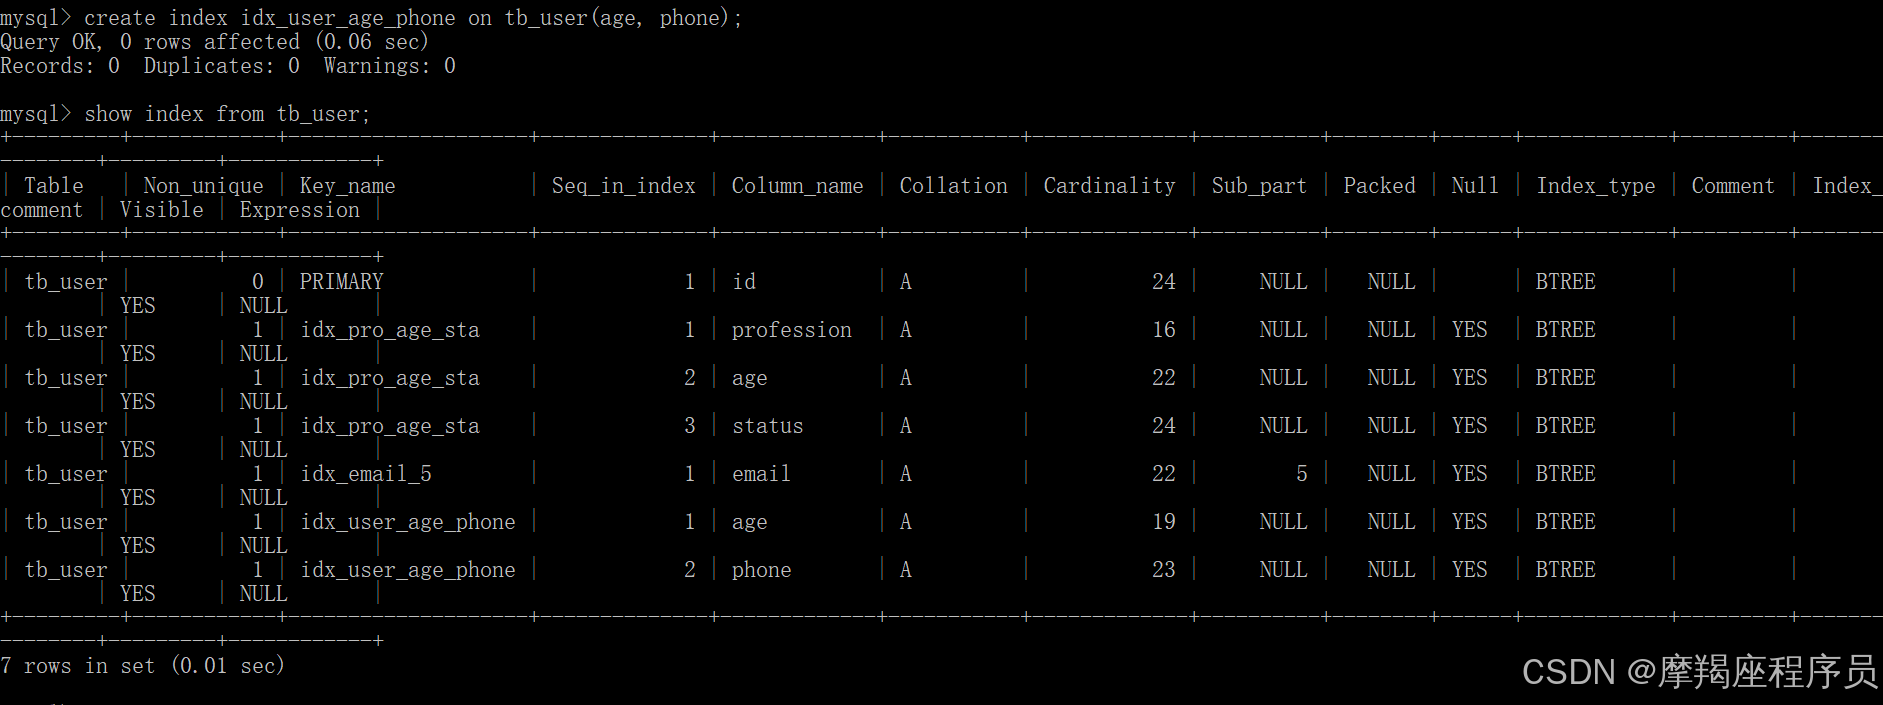
创建age,phone的联合索引
create index idx_user_age_phone on tb_user(age, phone);
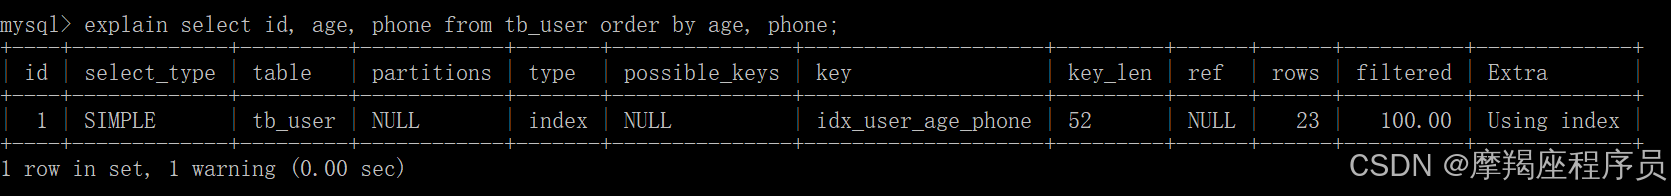
创建索引后,再来查看执行计划
explain select id, age, phone from tb_user order by age, phone; 这次变成了using index;
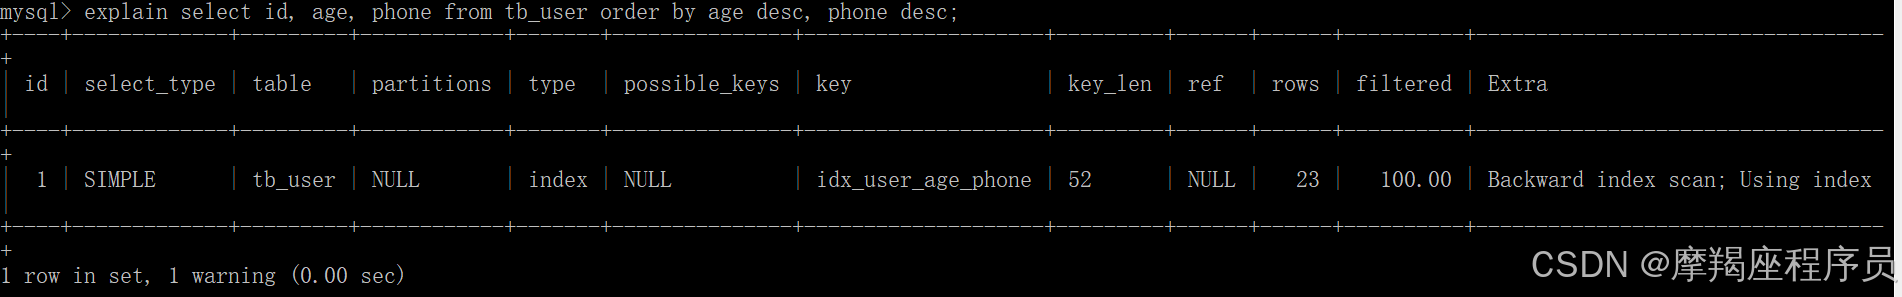
explain select id, age, phone from tb_user order by age, phone desc; 这次变成了backwar index scan; using index
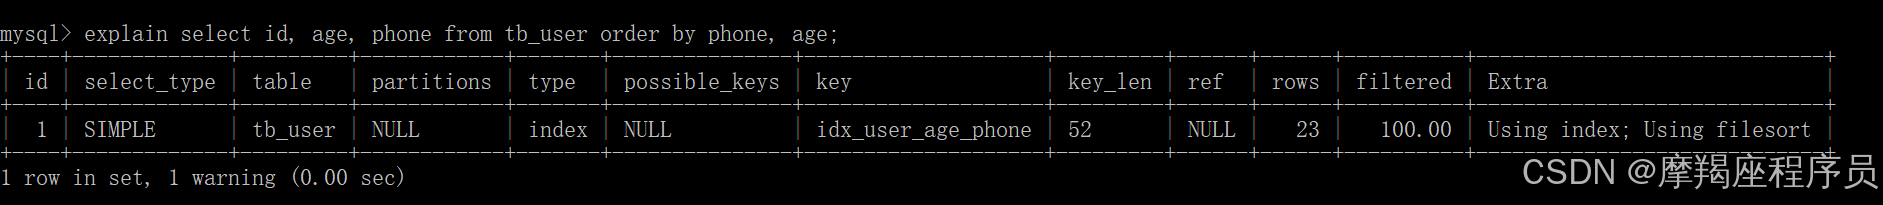
explain select id, age, phone from tb_user order by phone, age; 这次变成了using index, using filesort; 这是因为order by phone, age 违背了最左前缀法则。
a) 根据排序字段建立合适的索引,多字段排序时,页遵循最左前缀法则
b) 尽量使用覆盖索引
c) 多字段排序,一个升序一个降序,此时需要注意联合索引再创建时的规则(ASC/DESC)
d) 如果不可避免的出现filesort,大数据量排序时,可以适当增大排序缓冲区大小sort_buffer_size(默认256k)。
(4)group by优化
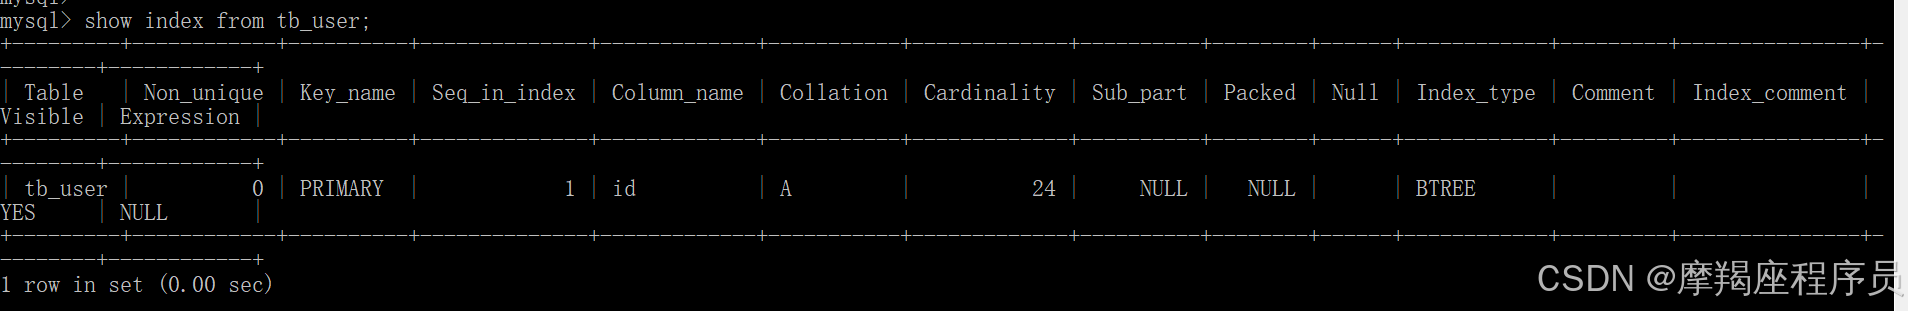
表里只有主键索引
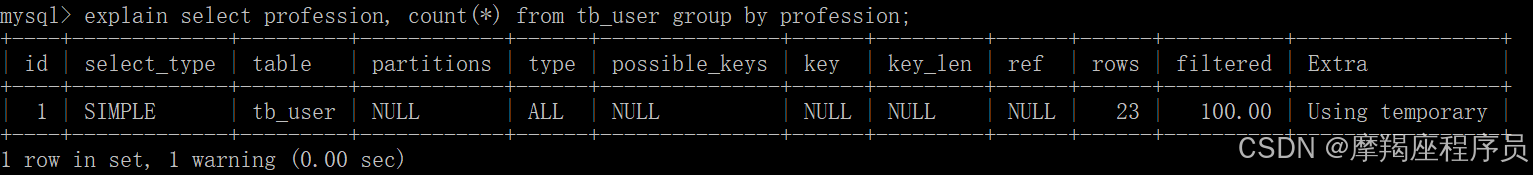
explain select profession, count(*) from tb_user group by profession; 使用了临时表,性能很低。
创建索引之后,再来查看性能
create index idx_user_pro_age_sta on tb_user(profession, age, status);
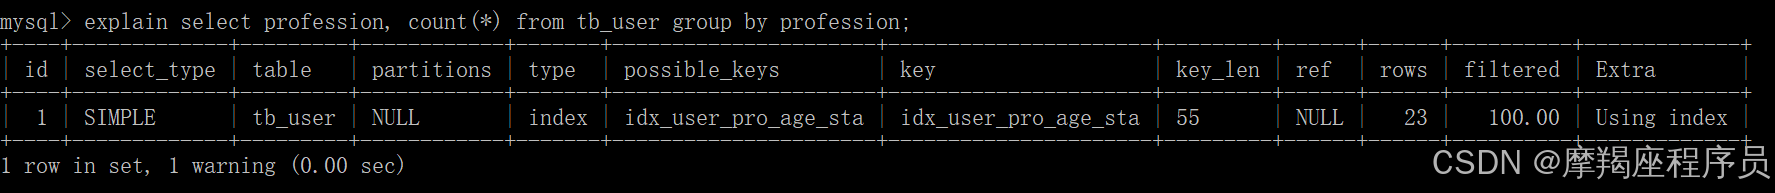
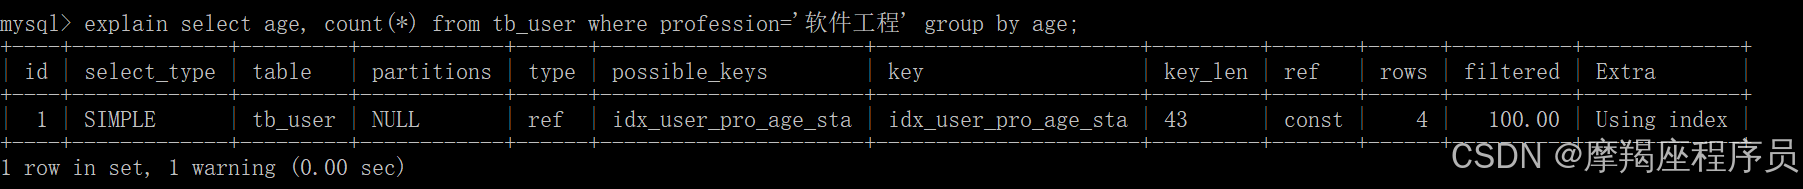
explain select age, count(*) from tb_user where profession='软件工程' group by age; 这是满足最左前缀法则的。