import torch
import torch.nn as nn
import torch.optim as optim
from torchvision import datasets, transforms
from torch.utils.data import DataLoader
import matplotlib.pyplot as plt
import numpy as np
from torch.optim.lr_scheduler import ReduceLROnPlateau, CosineAnnealingLR

# 设置中文字体支持
plt.rcParams["font.family"] = ["SimHei"]
plt.rcParams['axes.unicode_minus'] = False  # 解决负号显示问题

# 1. 增强的数据预处理和数据增强
transform_train = transforms.Compose([
    transforms.RandomCrop(32, padding=4),          # 随机裁剪
    transforms.RandomHorizontalFlip(p=0.5),        # 随机水平翻转
    transforms.RandomRotation(15),                 # 随机旋转
    transforms.ColorJitter(brightness=0.2, contrast=0.2, saturation=0.2),  # 颜色抖动
    transforms.ToTensor(),                         # 转换为张量
    transforms.Normalize((0.4914, 0.4822, 0.4465), (0.2470, 0.2435, 0.2616))  # CIFAR-10标准归一化
])

transform_test = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.4914, 0.4822, 0.4465), (0.2470, 0.2435, 0.2616))
])

# 2. 加载CIFAR-10数据集
train_dataset = datasets.CIFAR10(
    root='./data',
    train=True,
    download=True,
    transform=transform_train
)

test_dataset = datasets.CIFAR10(
    root='./data',
    train=False,
    transform=transform_test
)

# 3. 创建数据加载器(调整batch_size)
batch_size = 128  # 增大batch_size
train_loader = DataLoader(train_dataset, batch_size=batch_size, shuffle=True, num_workers=0)
test_loader = DataLoader(test_dataset, batch_size=batch_size, shuffle=False, num_workers=0)

# 4. 改进的MLP模型(添加批归一化和更多层)
class ImprovedMLP(nn.Module):
    def __init__(self, hidden_layers=[1024, 512, 256], dropout_rate=0.3):
        super(ImprovedMLP, self).__init__()
        self.flatten = nn.Flatten()

        layers = []
        input_size = 3072  # 3*32*32

        # 动态构建隐藏层
        for i, hidden_size in enumerate(hidden_layers):
            layers.append(nn.Linear(input_size, hidden_size))
            layers.append(nn.BatchNorm1d(hidden_size))  # 添加批归一化
            layers.append(nn.ReLU(inplace=True))
            layers.append(nn.Dropout(dropout_rate))
            input_size = hidden_size

        # 输出层
        layers.append(nn.Linear(input_size, 10))

        self.network = nn.Sequential(*layers)

    def forward(self, x):
        return self.network(self.flatten(x))


# 检查GPU是否可用
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
print(f"使用设备: {device}")

# 初始化模型(选择其中一个)
model = ImprovedMLP(hidden_layers=[2048, 1024, 512, 256], dropout_rate=0.4)
# model = MLPWithResidual()

model = model.to(device)

# 参数统计
total_params = sum(p.numel() for p in model.parameters())
trainable_params = sum(p.numel() for p in model.parameters() if p.requires_grad)
print(f"总参数数量: {total_params:,}")
print(f"可训练参数数量: {trainable_params:,}")

# 使用标签平滑的损失函数
class LabelSmoothingCrossEntropy(nn.Module):
    def __init__(self, smoothing=0.1):
        super(LabelSmoothingCrossEntropy, self).__init__()
        self.smoothing = smoothing

    def forward(self, x, target):
        log_probs = torch.nn.functional.log_softmax(x, dim=-1)
        nll_loss = -log_probs.gather(dim=-1, index=target.unsqueeze(1))
        nll_loss = nll_loss.squeeze(1)
        smooth_loss = -log_probs.mean(dim=-1)
        loss = (1 - self.smoothing) * nll_loss + self.smoothing * smooth_loss
        return loss.mean()

# 选择损失函数
criterion = LabelSmoothingCrossEntropy(smoothing=0.1)  # 或使用 nn.CrossEntropyLoss()

# 优化器调参
optimizer = optim.AdamW(model.parameters(),
                       lr=0.001,
                       weight_decay=1e-4,  # 权重衰减
                       betas=(0.9, 0.999))

# 学习率调度器
scheduler = CosineAnnealingLR(optimizer, T_max=50, eta_min=1e-6)
# scheduler = ReduceLROnPlateau(optimizer, mode='max', factor=0.5, patience=3, verbose=True)

# 6. 增强的训练函数
def train(model, train_loader, test_loader, criterion, optimizer, scheduler, device, epochs):
    model.train()

    train_losses = []
    test_losses = []
    train_accuracies = []
    test_accuracies = []
    all_iter_losses = []
    iter_indices = []

    best_accuracy = 0.0

    for epoch in range(epochs):
        # 训练阶段
        model.train()
        running_loss = 0.0
        correct = 0
        total = 0

        # 使用混合精度训练(如果可用)
        scaler = torch.cuda.amp.GradScaler() if device.type == 'cuda' else None

        for batch_idx, (data, target) in enumerate(train_loader):
            data, target = data.to(device), target.to(device)

            optimizer.zero_grad()

            if scaler:
                # 混合精度训练
                with torch.cuda.amp.autocast():
                    output = model(data)
                    loss = criterion(output, target)

                scaler.scale(loss).backward()
                scaler.step(optimizer)
                scaler.update()
            else:
                output = model(data)
                loss = criterion(output, target)
                loss.backward()
                optimizer.step()

            # 记录损失
            iter_loss = loss.item()
            all_iter_losses.append(iter_loss)
            iter_indices.append(epoch * len(train_loader) + batch_idx + 1)

            running_loss += iter_loss
            _, predicted = output.max(1)
            total += target.size(0)
            correct += predicted.eq(target).sum().item()

            # 梯度裁剪
            if scaler:
                scaler.unscale_(optimizer)
                torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
            else:
                torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)

            if (batch_idx + 1) % 50 == 0:
                acc = 100. * correct / total
                print(f'Epoch: {epoch+1}/{epochs} | Batch: {batch_idx+1}/{len(train_loader)} '
                      f'| 损失: {iter_loss:.4f} | 准确率: {acc:.2f}%')

        # 计算训练统计
        epoch_train_loss = running_loss / len(train_loader)
        epoch_train_acc = 100. * correct / total
        train_losses.append(epoch_train_loss)
        train_accuracies.append(epoch_train_acc)

        # 测试阶段
        model.eval()
        test_loss = 0
        correct_test = 0
        total_test = 0

        with torch.no_grad():
            for data, target in test_loader:
                data, target = data.to(device), target.to(device)
                output = model(data)
                test_loss += criterion(output, target).item()
                _, predicted = output.max(1)
                total_test += target.size(0)
                correct_test += predicted.eq(target).sum().item()

        epoch_test_loss = test_loss / len(test_loader)
        epoch_test_acc = 100. * correct_test / total_test
        test_losses.append(epoch_test_loss)
        test_accuracies.append(epoch_test_acc)

        # 更新学习率
        if isinstance(scheduler, ReduceLROnPlateau):
            scheduler.step(epoch_test_acc)
        else:
            scheduler.step()

        # 保存最佳模型
        if epoch_test_acc > best_accuracy:
            best_accuracy = epoch_test_acc
            torch.save({
                'epoch': epoch,
                'model_state_dict': model.state_dict(),
                'optimizer_state_dict': optimizer.state_dict(),
                'accuracy': best_accuracy,
            }, 'best_model.pth')

        # 打印epoch总结
        current_lr = optimizer.param_groups[0]['lr']
        print(f'Epoch {epoch+1}/{epochs} 完成 | '
              f'训练损失: {epoch_train_loss:.4f} | 训练准确率: {epoch_train_acc:.2f}% | '
              f'测试损失: {epoch_test_loss:.4f} | 测试准确率: {epoch_test_acc:.2f}% | '
              f'学习率: {current_lr:.6f}')
        print('-' * 80)

    # 绘制结果
    plot_results(train_losses, test_losses, train_accuracies, test_accuracies, all_iter_losses, iter_indices)

    return best_accuracy

# 7. 绘制综合结果
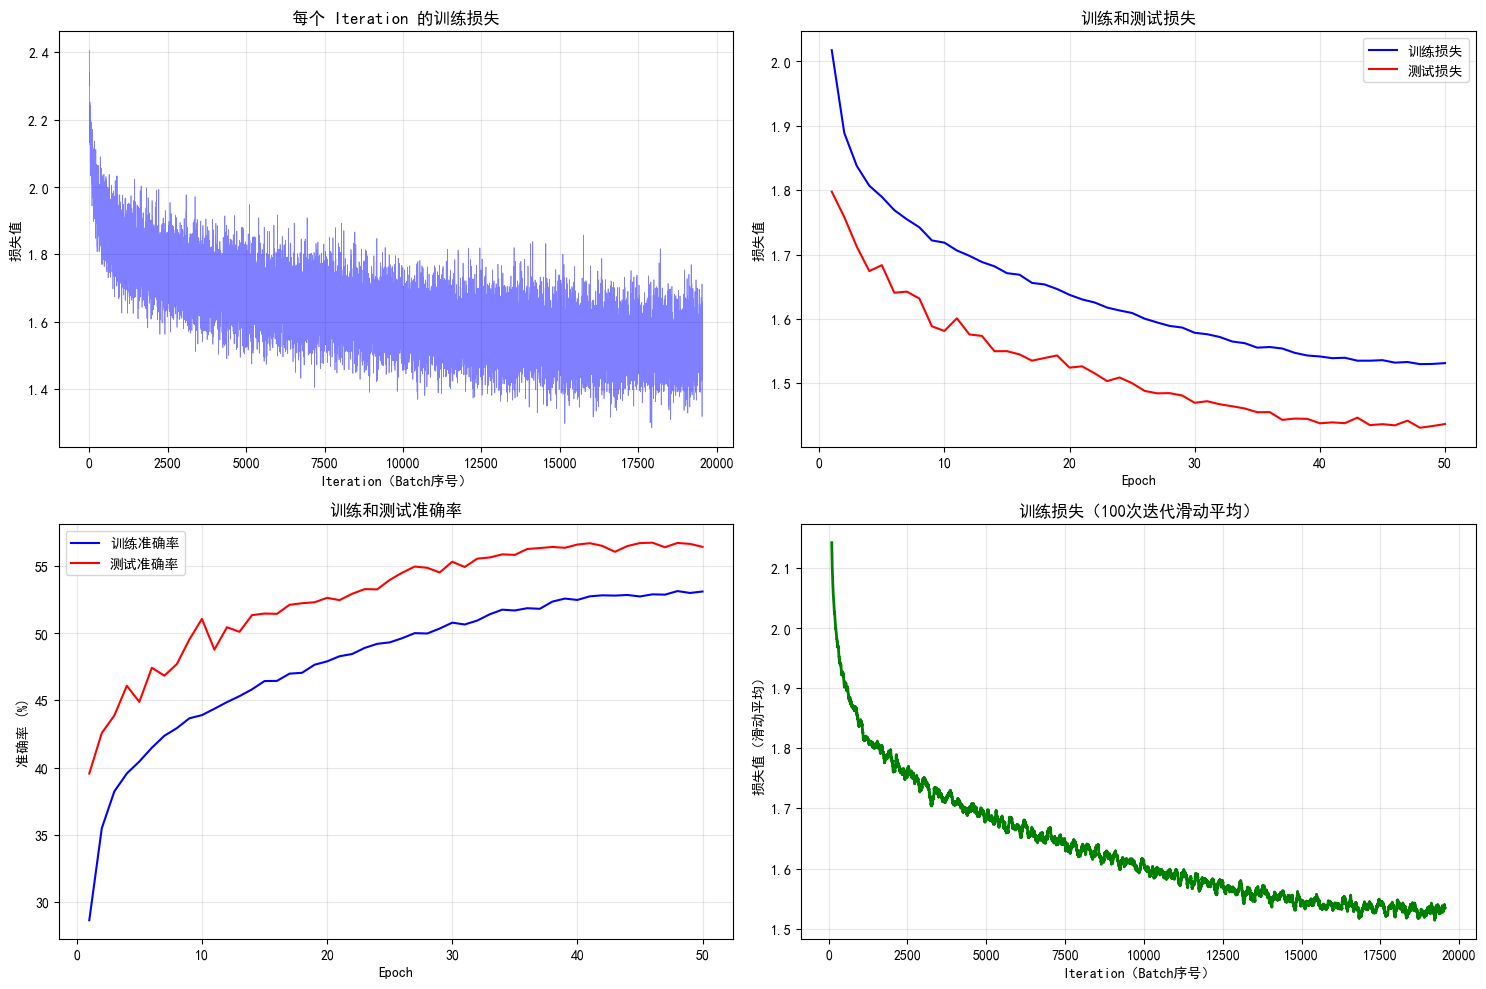
def plot_results(train_losses, test_losses, train_accs, test_accs, iter_losses, iter_indices):
    fig, axes = plt.subplots(2, 2, figsize=(15, 10))

    # 1. 迭代损失
    axes[0, 0].plot(iter_indices, iter_losses, 'b-', alpha=0.5, linewidth=0.5)
    axes[0, 0].set_xlabel('Iteration(Batch序号)')
    axes[0, 0].set_ylabel('损失值')
    axes[0, 0].set_title('每个 Iteration 的训练损失')
    axes[0, 0].grid(True, alpha=0.3)

    # 2. 每个epoch的训练和测试损失
    epochs = range(1, len(train_losses) + 1)
    axes[0, 1].plot(epochs, train_losses, 'b-', label='训练损失')
    axes[0, 1].plot(epochs, test_losses, 'r-', label='测试损失')
    axes[0, 1].set_xlabel('Epoch')
    axes[0, 1].set_ylabel('损失值')
    axes[0, 1].set_title('训练和测试损失')
    axes[0, 1].legend()
    axes[0, 1].grid(True, alpha=0.3)

    # 3. 每个epoch的训练和测试准确率
    axes[1, 0].plot(epochs, train_accs, 'b-', label='训练准确率')
    axes[1, 0].plot(epochs, test_accs, 'r-', label='测试准确率')
    axes[1, 0].set_xlabel('Epoch')
    axes[1, 0].set_ylabel('准确率 (%)')
    axes[1, 0].set_title('训练和测试准确率')
    axes[1, 0].legend()
    axes[1, 0].grid(True, alpha=0.3)

    # 4. 损失和准确率的滑动平均
    window_size = 100
    smoothed_losses = np.convolve(iter_losses, np.ones(window_size)/window_size, mode='valid')
    smoothed_indices = iter_indices[window_size-1:]

    axes[1, 1].plot(smoothed_indices, smoothed_losses, 'g-', linewidth=2)
    axes[1, 1].set_xlabel('Iteration(Batch序号)')
    axes[1, 1].set_ylabel('损失值(滑动平均)')
    axes[1, 1].set_title(f'训练损失({window_size}次迭代滑动平均)')
    axes[1, 1].grid(True, alpha=0.3)

    plt.tight_layout()
    plt.show()


def train_single_fold(model, train_loader, val_loader, criterion, optimizer, scheduler, device, epochs, fold_num):
    best_acc = 0.0

    for epoch in range(epochs):
        model.train()
        for data, target in train_loader:
            data, target = data.to(device), target.to(device)

            optimizer.zero_grad()
            output = model(data)
            loss = criterion(output, target)
            loss.backward()
            optimizer.step()

        scheduler.step()

        # 验证
        model.eval()
        correct = 0
        total = 0
        with torch.no_grad():
            for data, target in val_loader:
                data, target = data.to(device), target.to(device)
                output = model(data)
                _, predicted = output.max(1)
                total += target.size(0)
                correct += predicted.eq(target).sum().item()

        val_acc = 100. * correct / total
        if val_acc > best_acc:
            best_acc = val_acc

        print(f'Fold {fold_num} | Epoch {epoch+1}/{epochs} | 验证准确率: {val_acc:.2f}%')

    return best_acc

# 9. 主执行部分
if __name__ == "__main__":
    # 选择训练模式
    training_mode = "normal"  # 可选: "normal", "kfold"

    if training_mode == "normal":
        # 正常训练
        epochs = 50
        print("开始训练模型...")
        best_accuracy = train(model, train_loader, test_loader, criterion, optimizer, scheduler, device, epochs)
        print(f"训练完成!最佳测试准确率: {best_accuracy:.2f}%")

        # 加载最佳模型并测试
        checkpoint = torch.load('best_model.pth')
        model.load_state_dict(checkpoint['model_state_dict'])
        model.eval()

        # 最终测试
        correct = 0
        total = 0
        with torch.no_grad():
            for data, target in test_loader:
                data, target = data.to(device), target.to(device)
                output = model(data)
                _, predicted = output.max(1)
                total += target.size(0)
                correct += predicted.eq(target).sum().item()

        final_acc = 100. * correct / total
        print(f"最终测试准确率: {final_acc:.2f}%")