scrapy的暂停与重启

进入项目的目录:

新建一个目录,目录名为job_info:因为要暂停爬虫,所以需要保存许多中间状态,这个目录就是为了保存状态

打开命令行cmder

进入虚拟环境

因为要暂停爬虫,所以需要保存许多中间状态

以lagou爬虫为例:

第一点:不同的spider是不能共用同一个spider的,所以要在job_info 下新建一个文件夹,名为001

第二点:不同的spider在run的时候也不能共用同一个目录

cmd 复制代码
scrapy crawl  cnblogs -s JOBDIR=job_info/001

执行命令后启动指定爬虫,且记录状态到指定目录

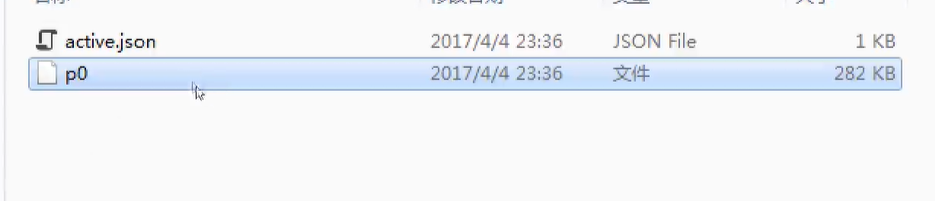
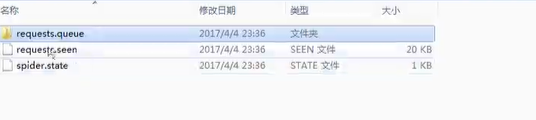
爬虫现已运行,能按键盘上的Ctrl+C停止爬虫,停止后再看看记录文件夹,会多出3个文件,其中的requests.queue文件夹里的p0文件就是url记录文件,有该文件就表示还有没有完成的url,在全部url完成后会自动删除该文件

再重新执行命令:

cmder 复制代码
scrapy crawl cnblogs -s JOBDIR=zant/001 

时爬虫会按照p0文件从停止的地方开始再次爬取。
相关推荐
云南新人和数采集团6 天前
开源项目吐槽大会:一篇技术文章的大纲设计
python·scrapy·开源
万粉变现经纪人8 天前
如何解决 pip install 安装报错 检测到 yanked 版本需更换可用版本 问题
人工智能·python·scrapy·numpy·pandas·pyqt·pip
B2_Proxy9 天前
Scrapy 代理 IP 调度进阶:基于 Redis 与中间件的高可用架构实战
python·scrapy·1024程序员节
傻啦嘿哟20 天前
天气数据爬虫:基于Scrapy爬取全国天气,做可视化大屏
c++·爬虫·scrapy
小白学大数据22 天前
拼多多反爬对抗实战:Scrapy 中间件化采集架构解析
开发语言·scrapy·中间件·架构
毕业设计70323 天前
(免费领源码)django空气净化器销售系统09218- java、PHP、python、C#、小程序、大数据、单片机、网络工程等)
python·scrapy·mysql·pycharm·django·flask·pandas
v:PLLucky201 个月前
农作物病虫害检测识别系统
深度学习·scrapy·算法·百度·微信公众平台
TomEval1 个月前
【测AI】第05篇:Python 爬虫进阶 —— 动态页面爬取与 Scrapy 框架
人工智能·爬虫·python·scrapy·自动化
Data_Journal2 个月前
使用 AutoScraper 进行网页抓取:分步教程
大数据·开发语言·数据库·python·scrapy
Data_Journal2 个月前
如何将网页抓取用于机器学习
大数据·开发语言·数据库·python·scrapy