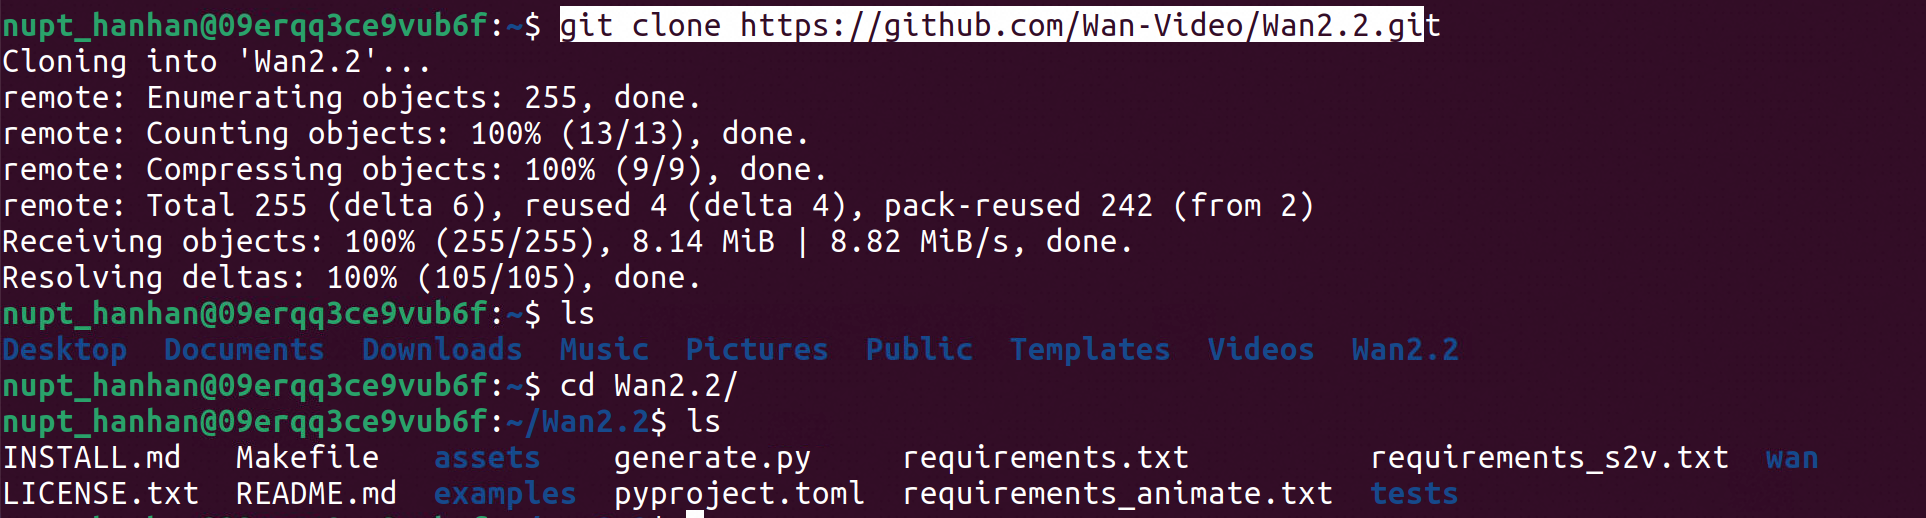
部署参考:
https://github.com/Wan-Video/Wan2.2/tree/main
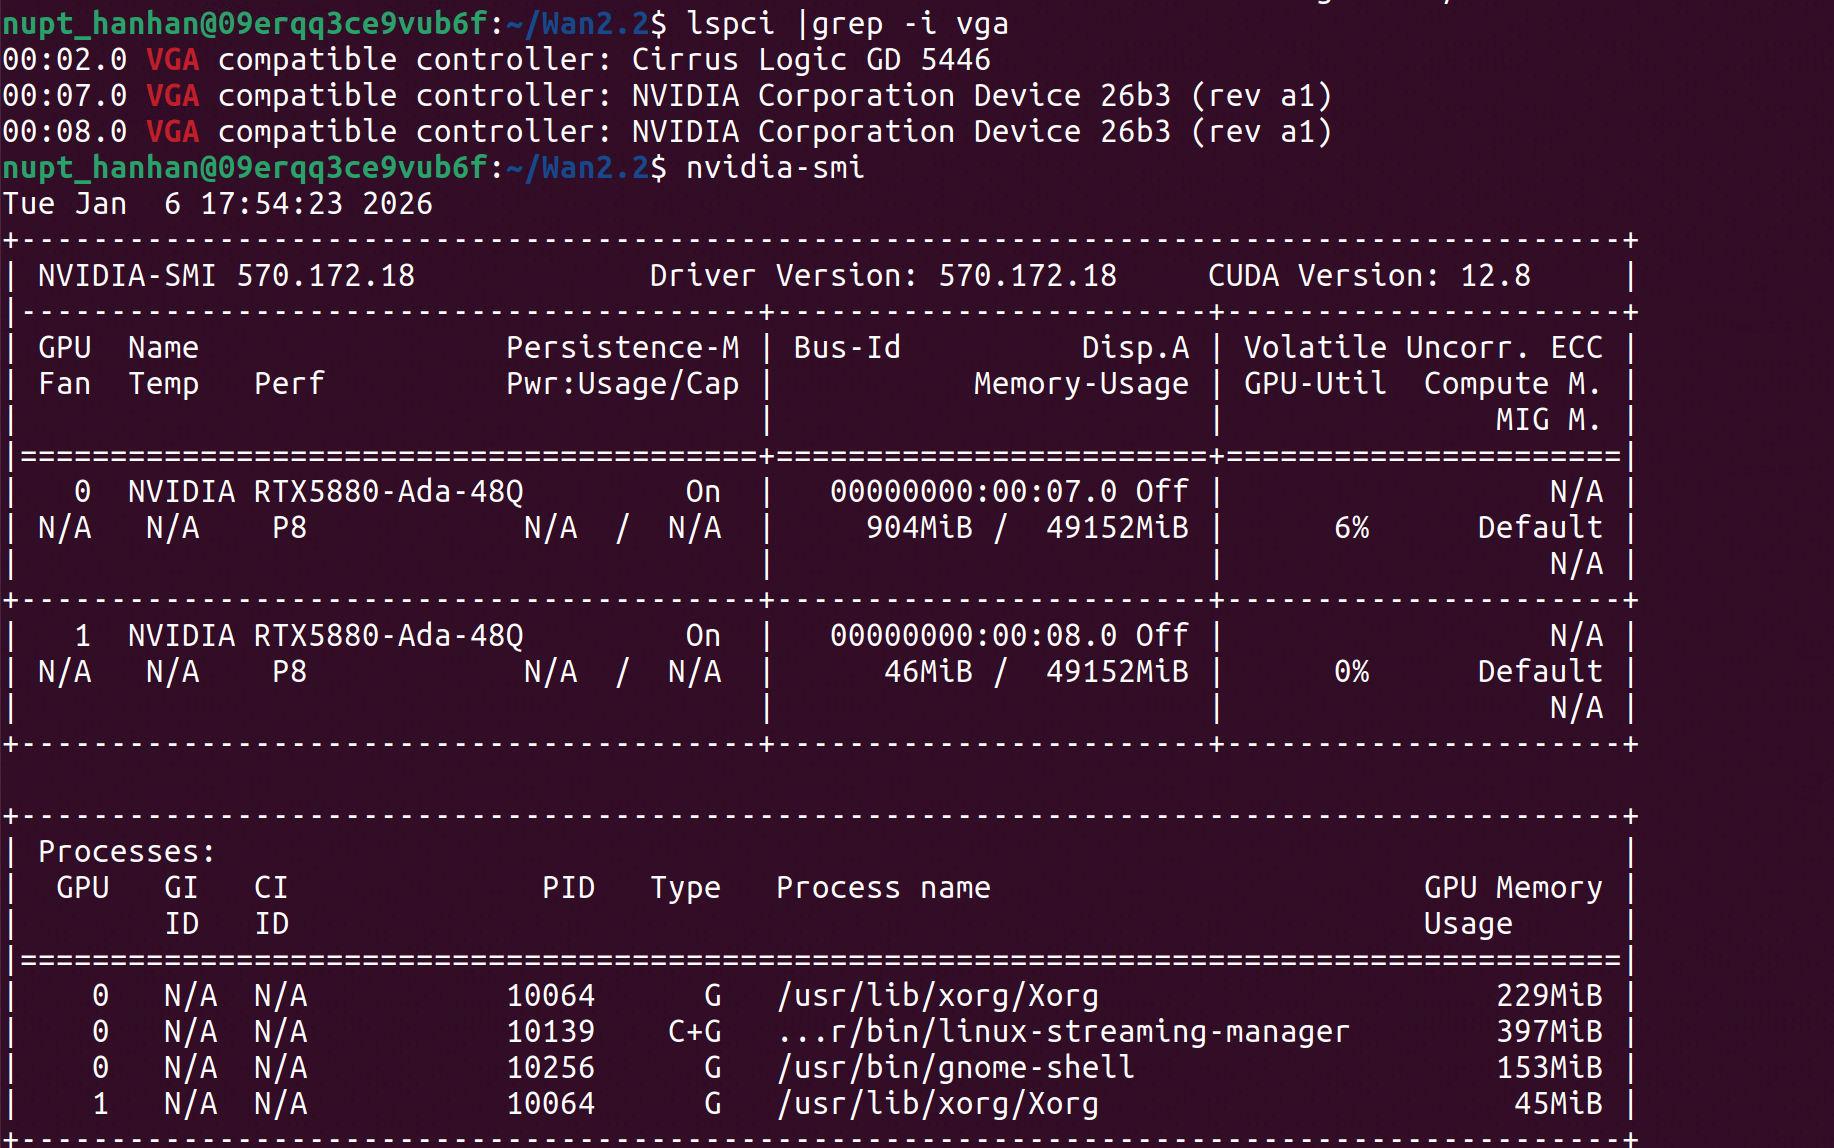
部署模型:T2V-A14B
资源开通:
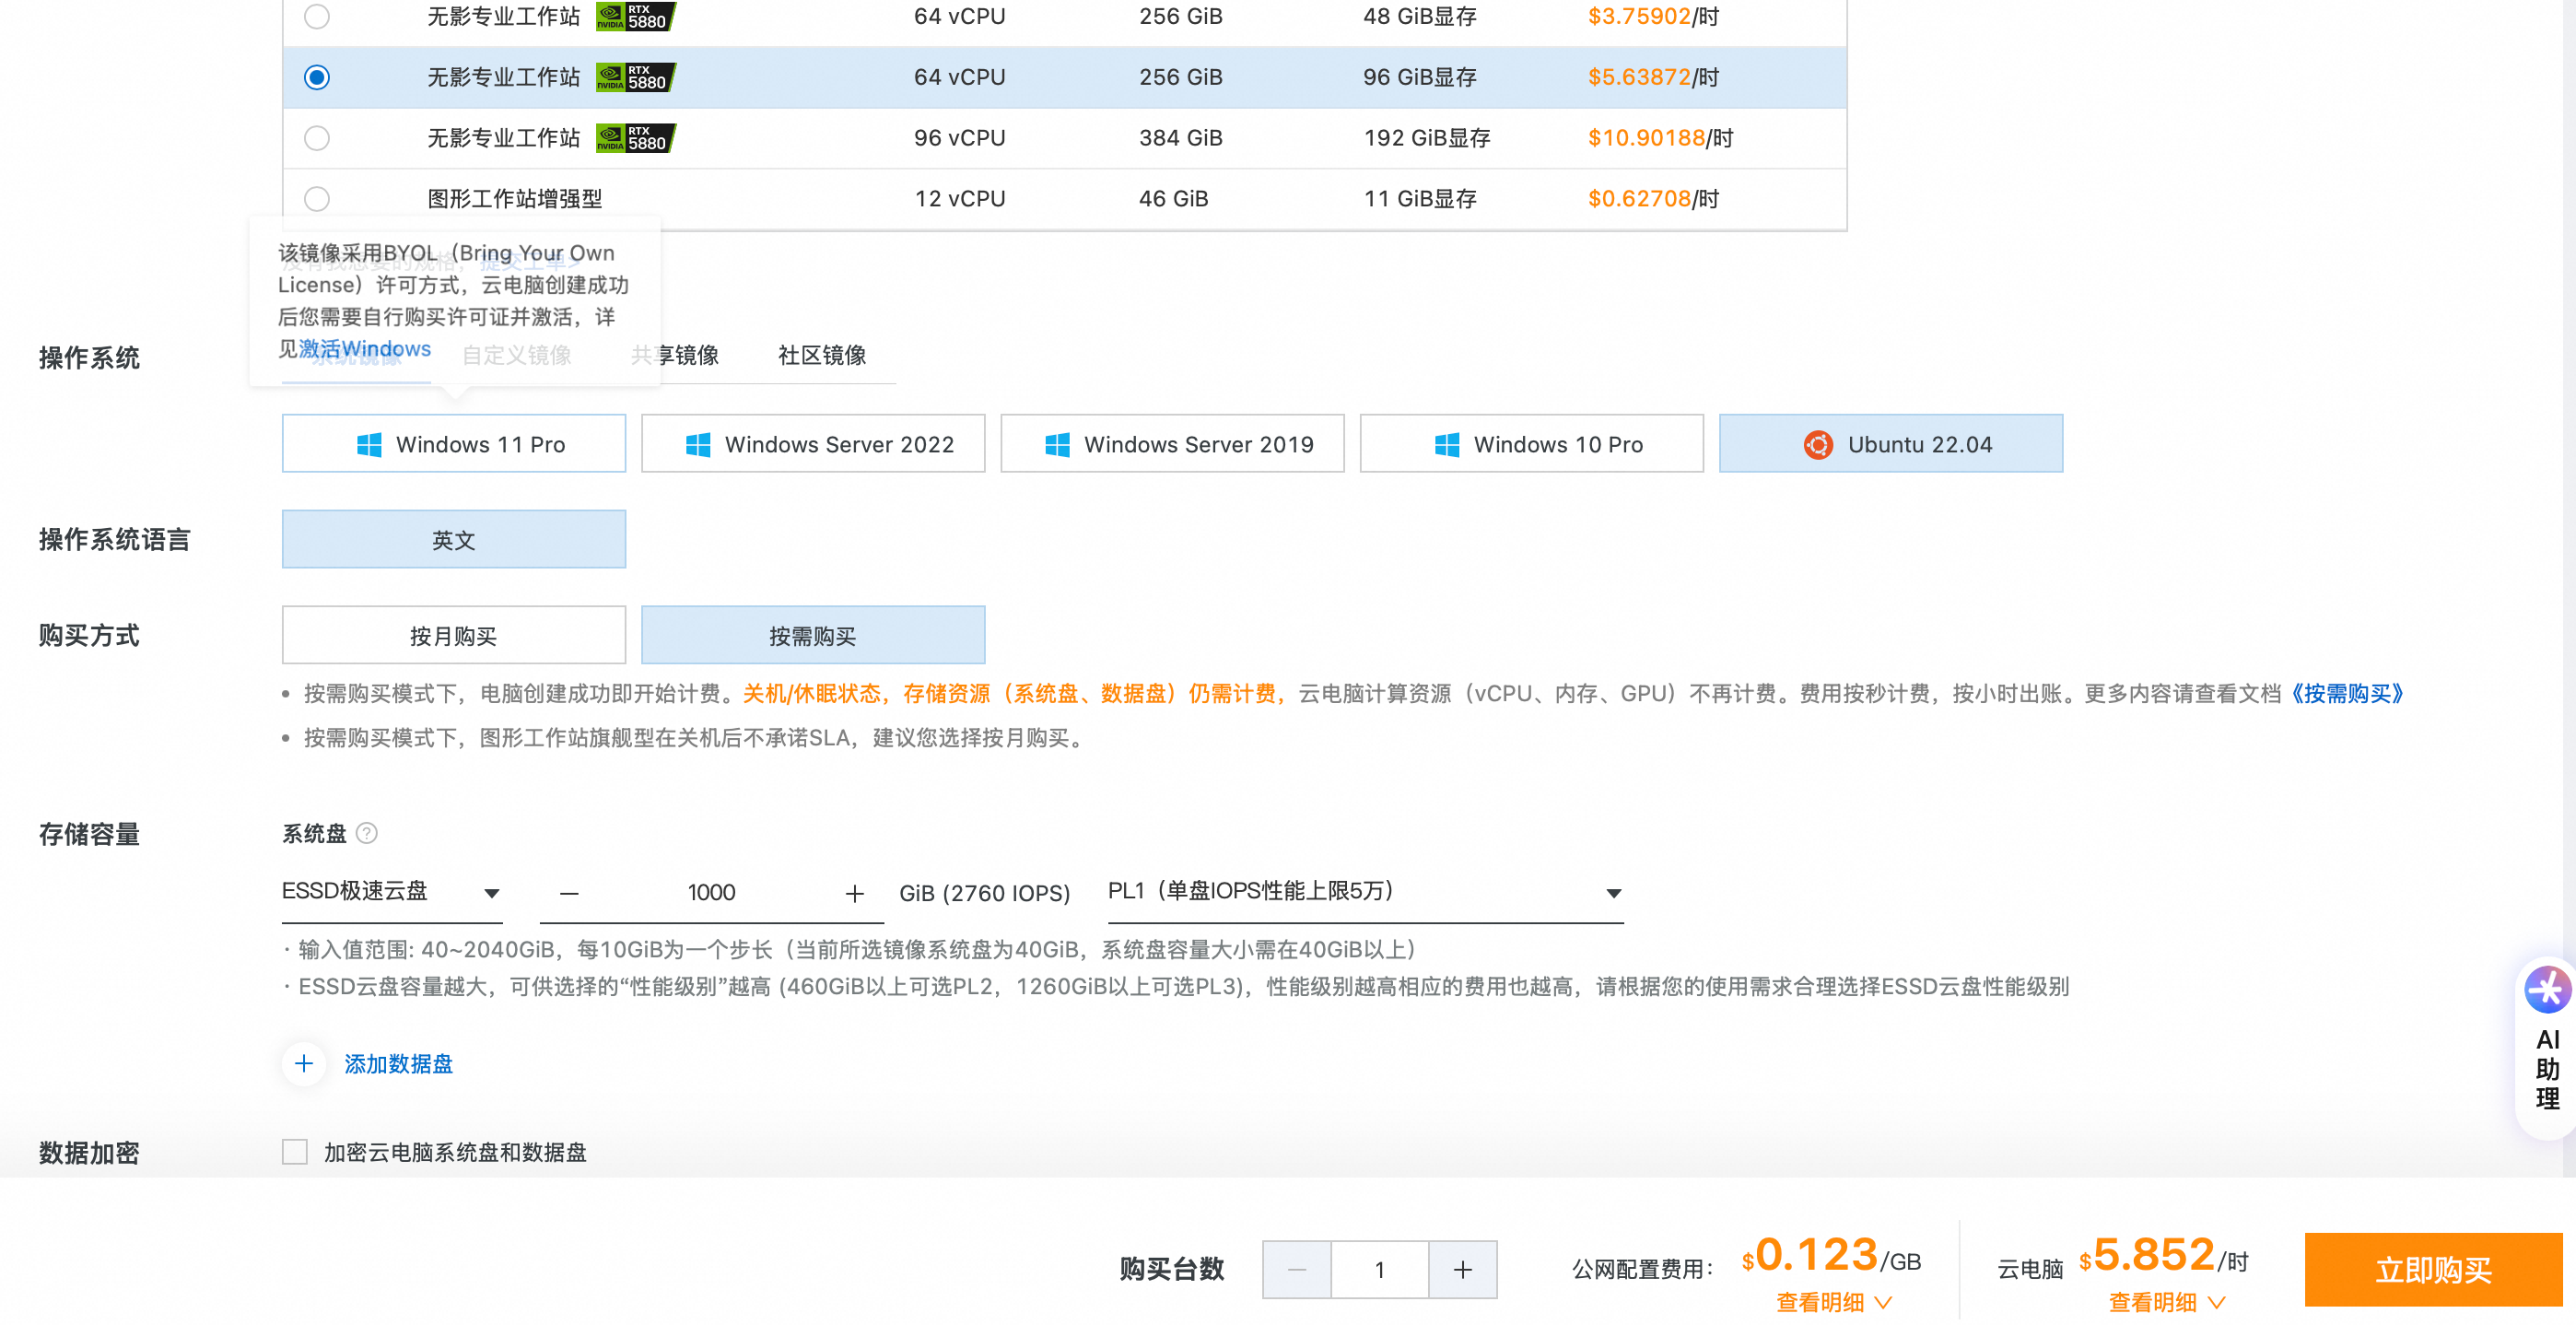
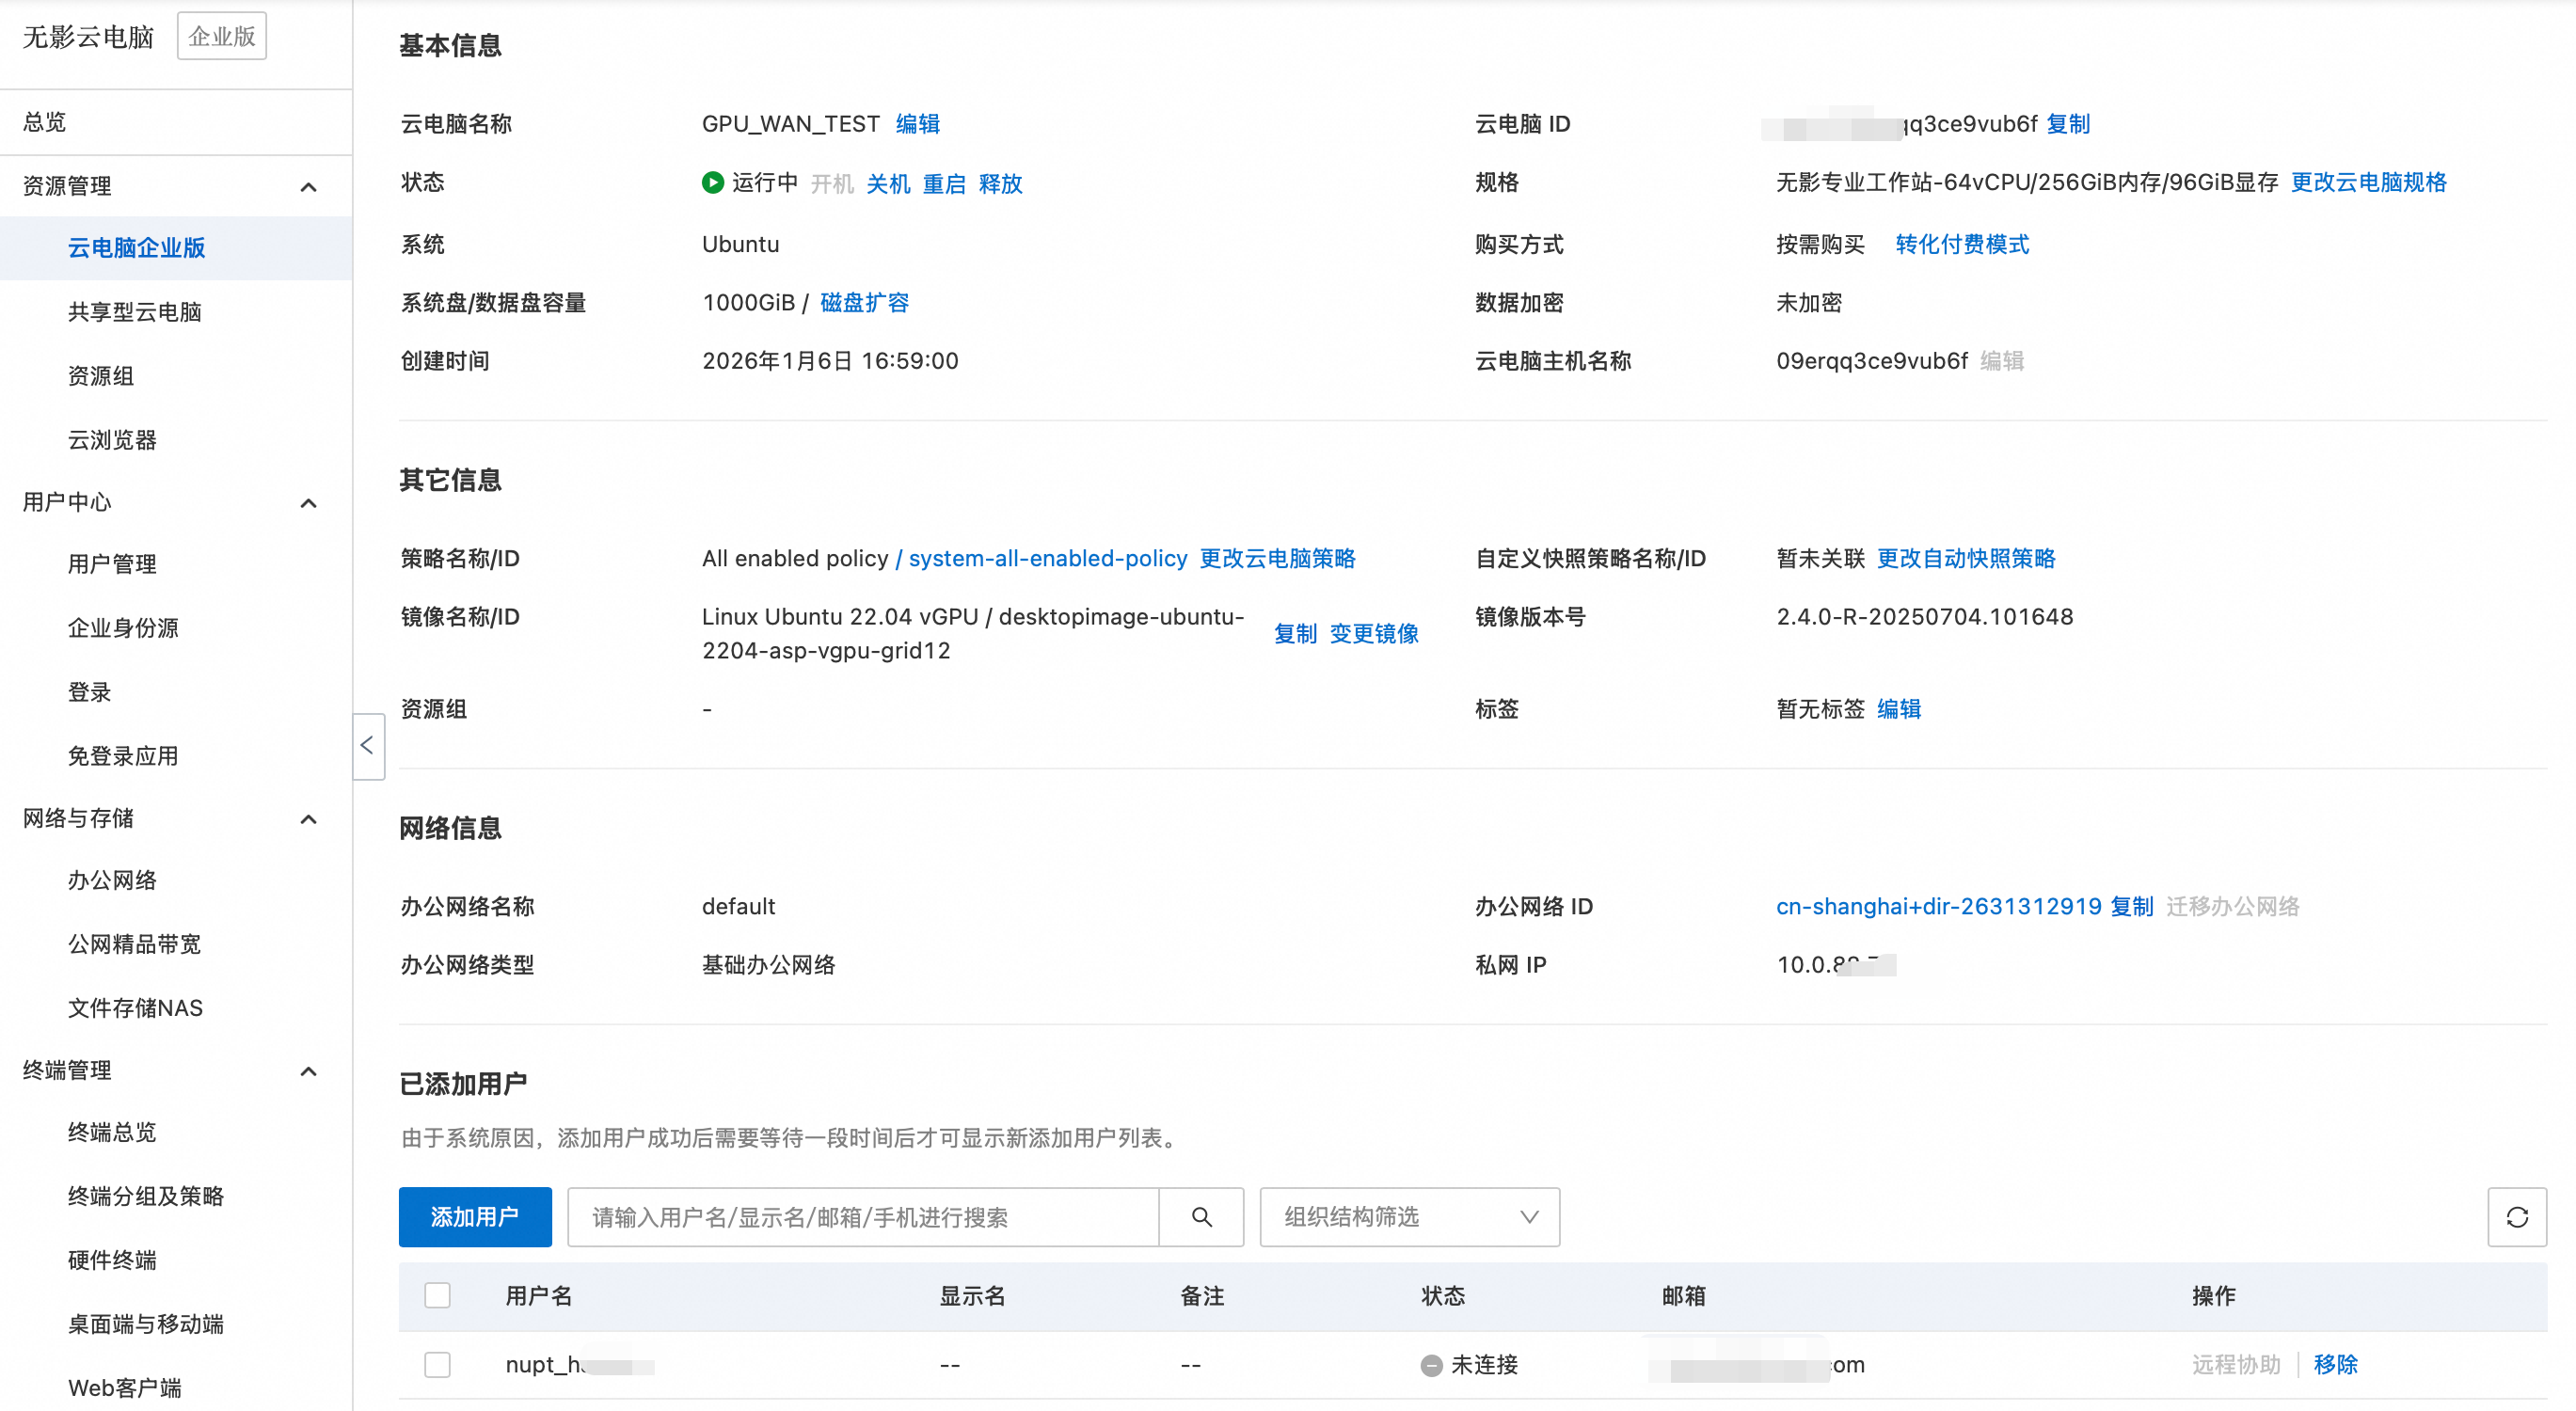
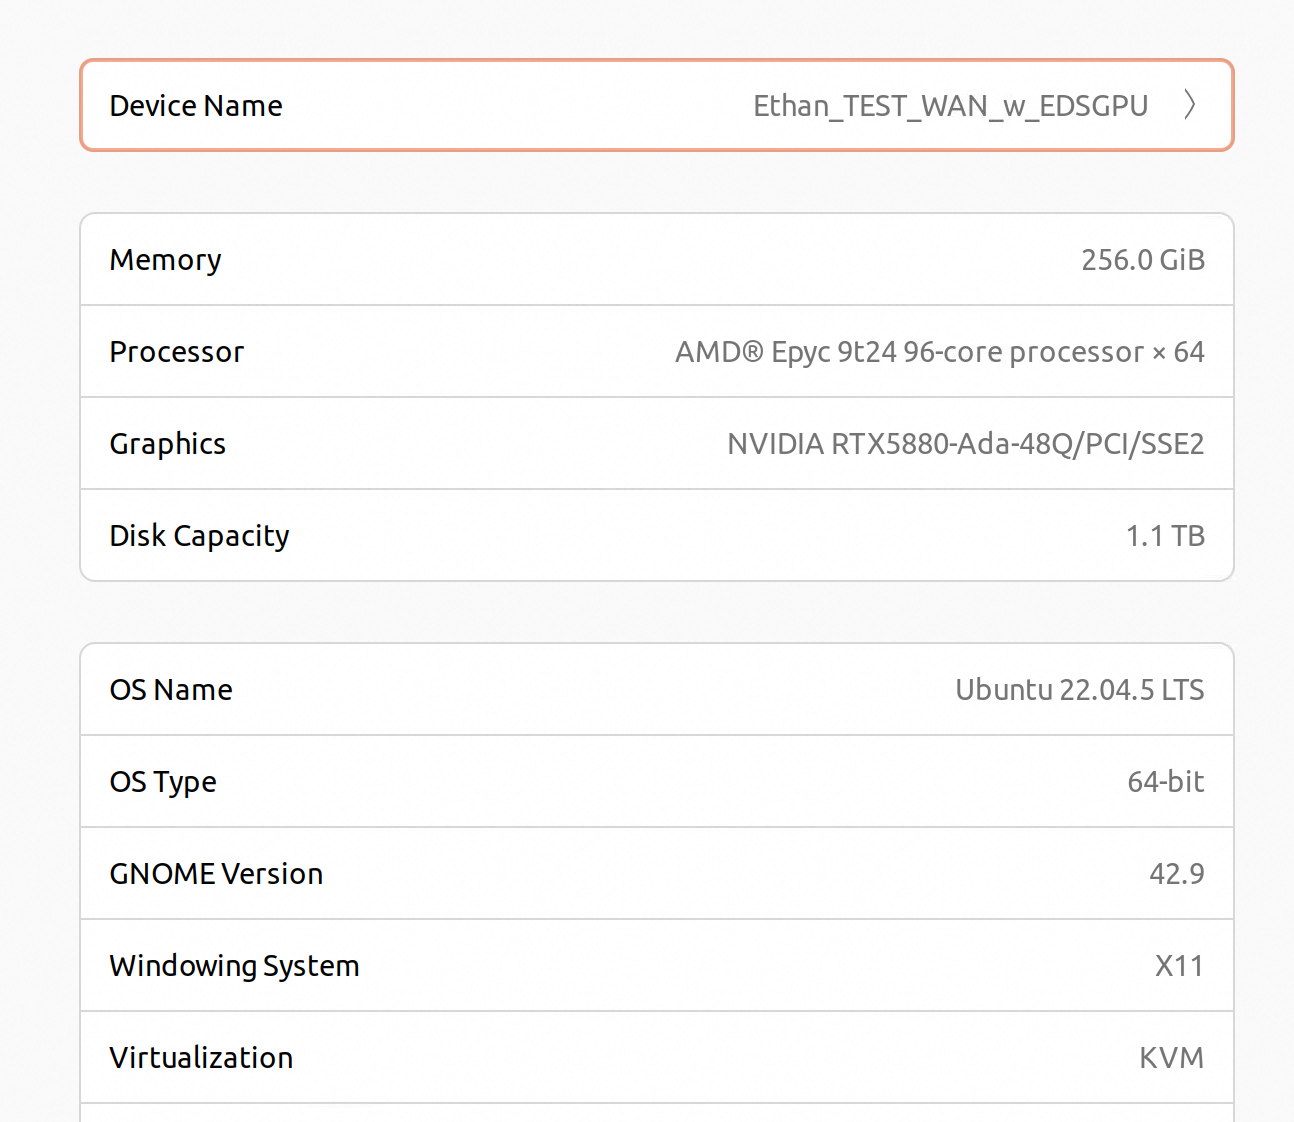
登陆无影
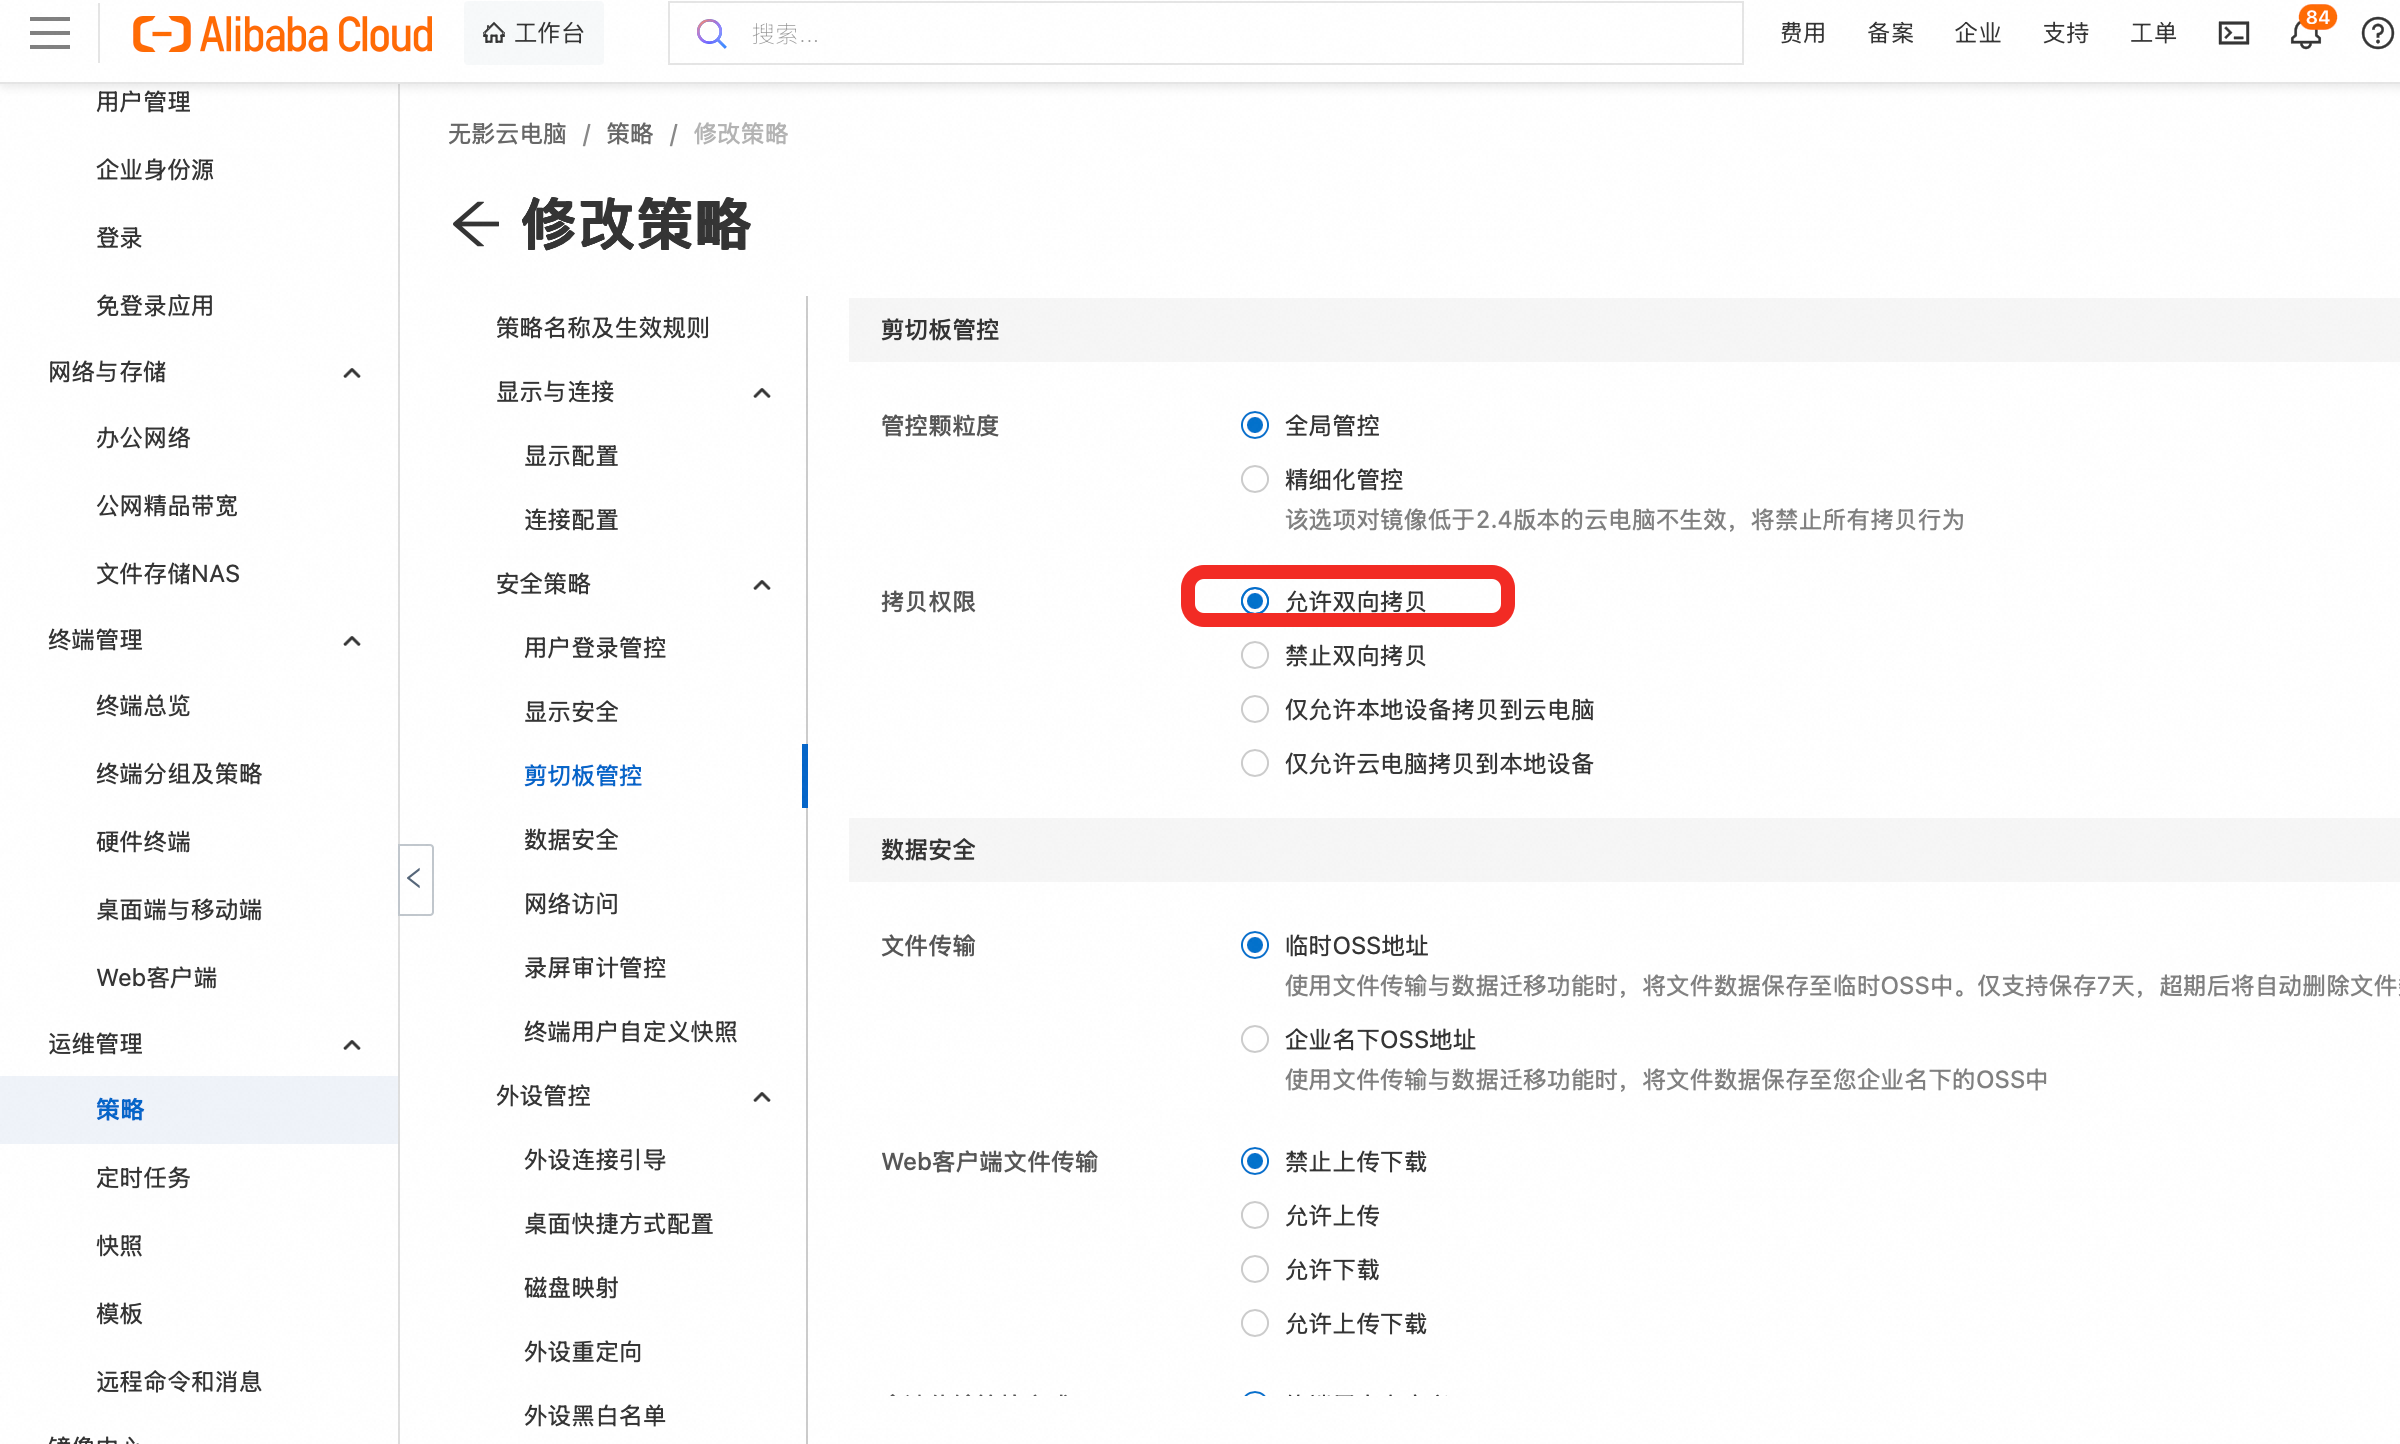
修改策略以支持复制内容到ubuntu执行,需要替换这个instance的策略为新的:
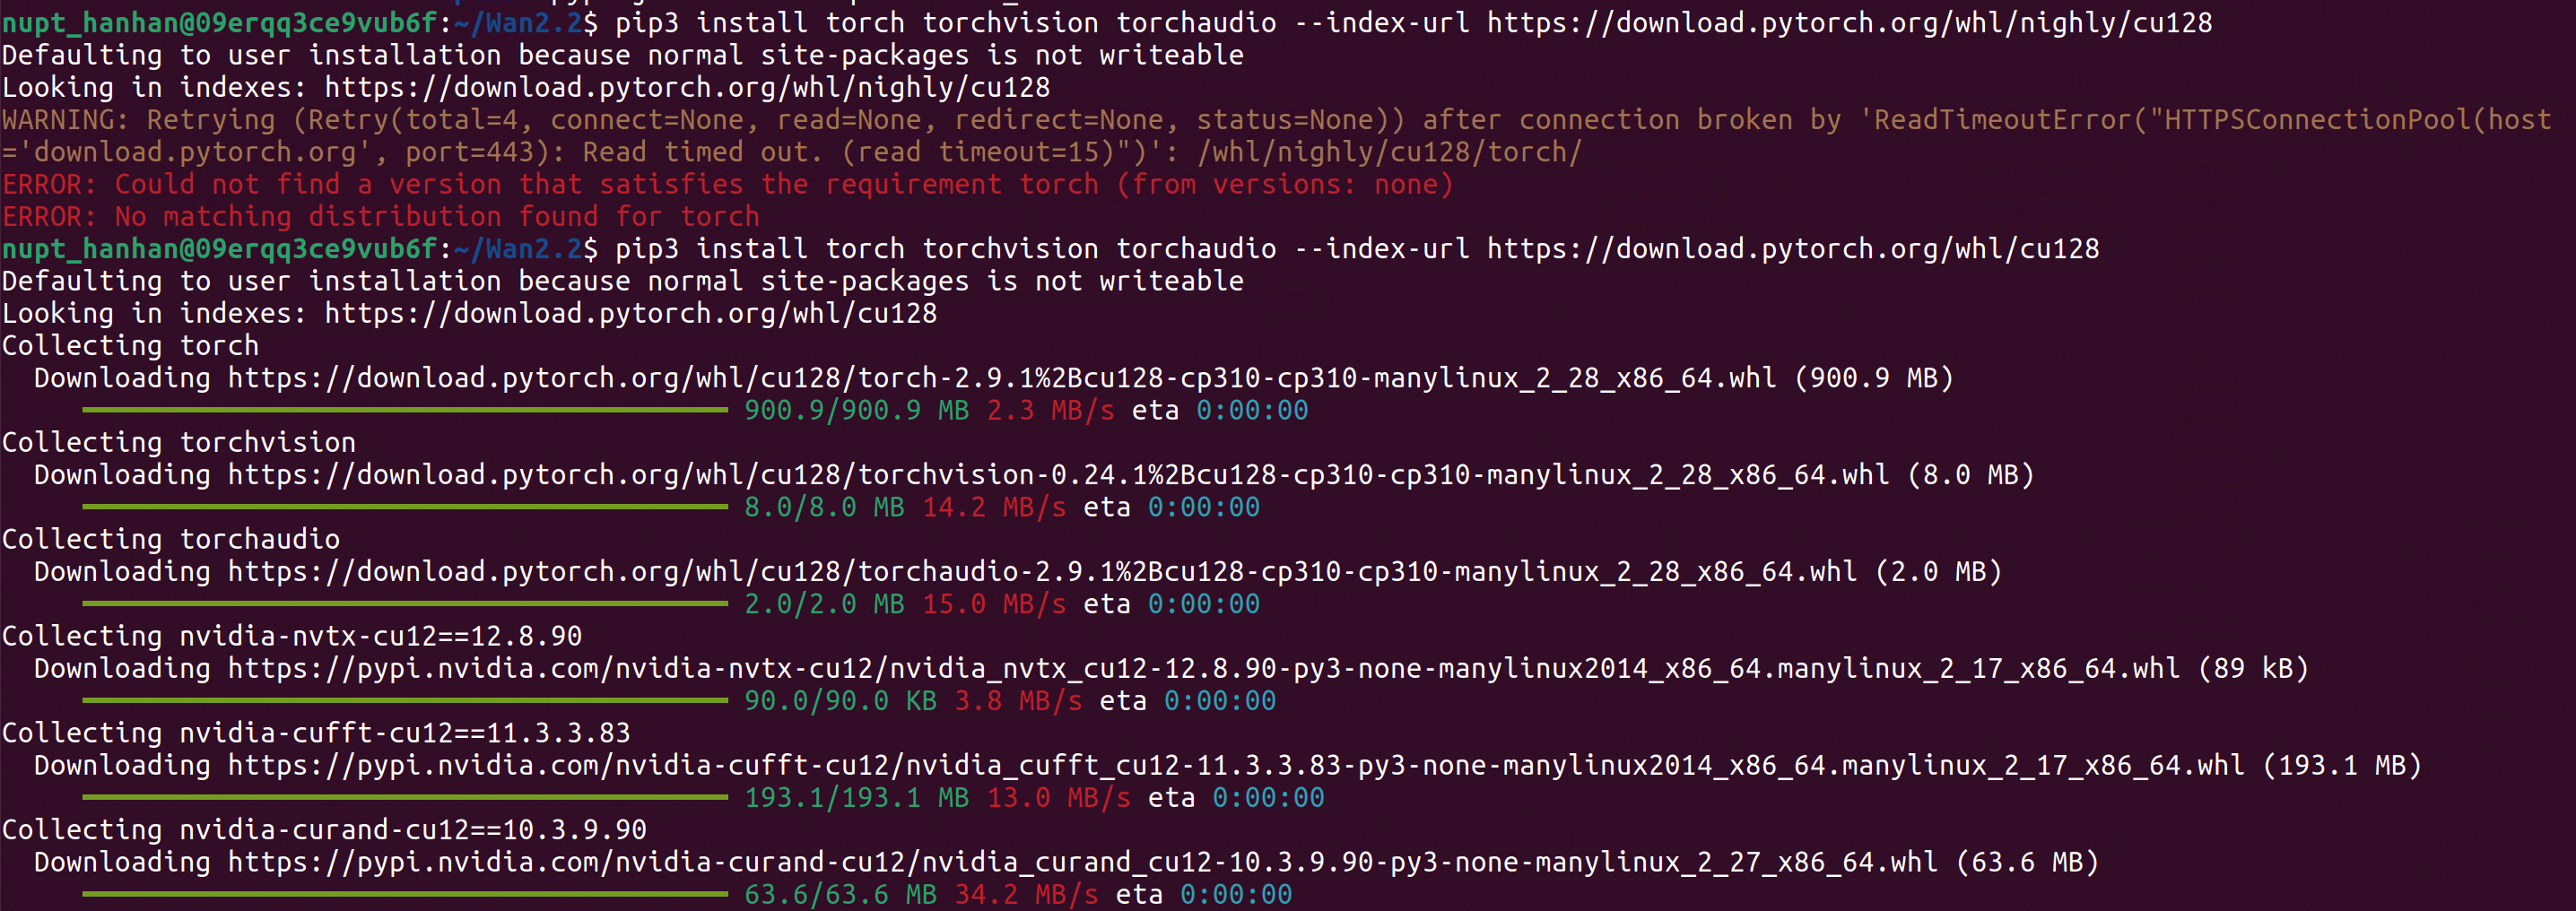
Ensure torch >= 2.4.0
If the installation of flash_attn fails, try installing the other packages first and install flash_attn last
pip install -r requirements.txt
flash_attn依赖torch,先安装torch:
pip install -r requirements.txt 后继续报错
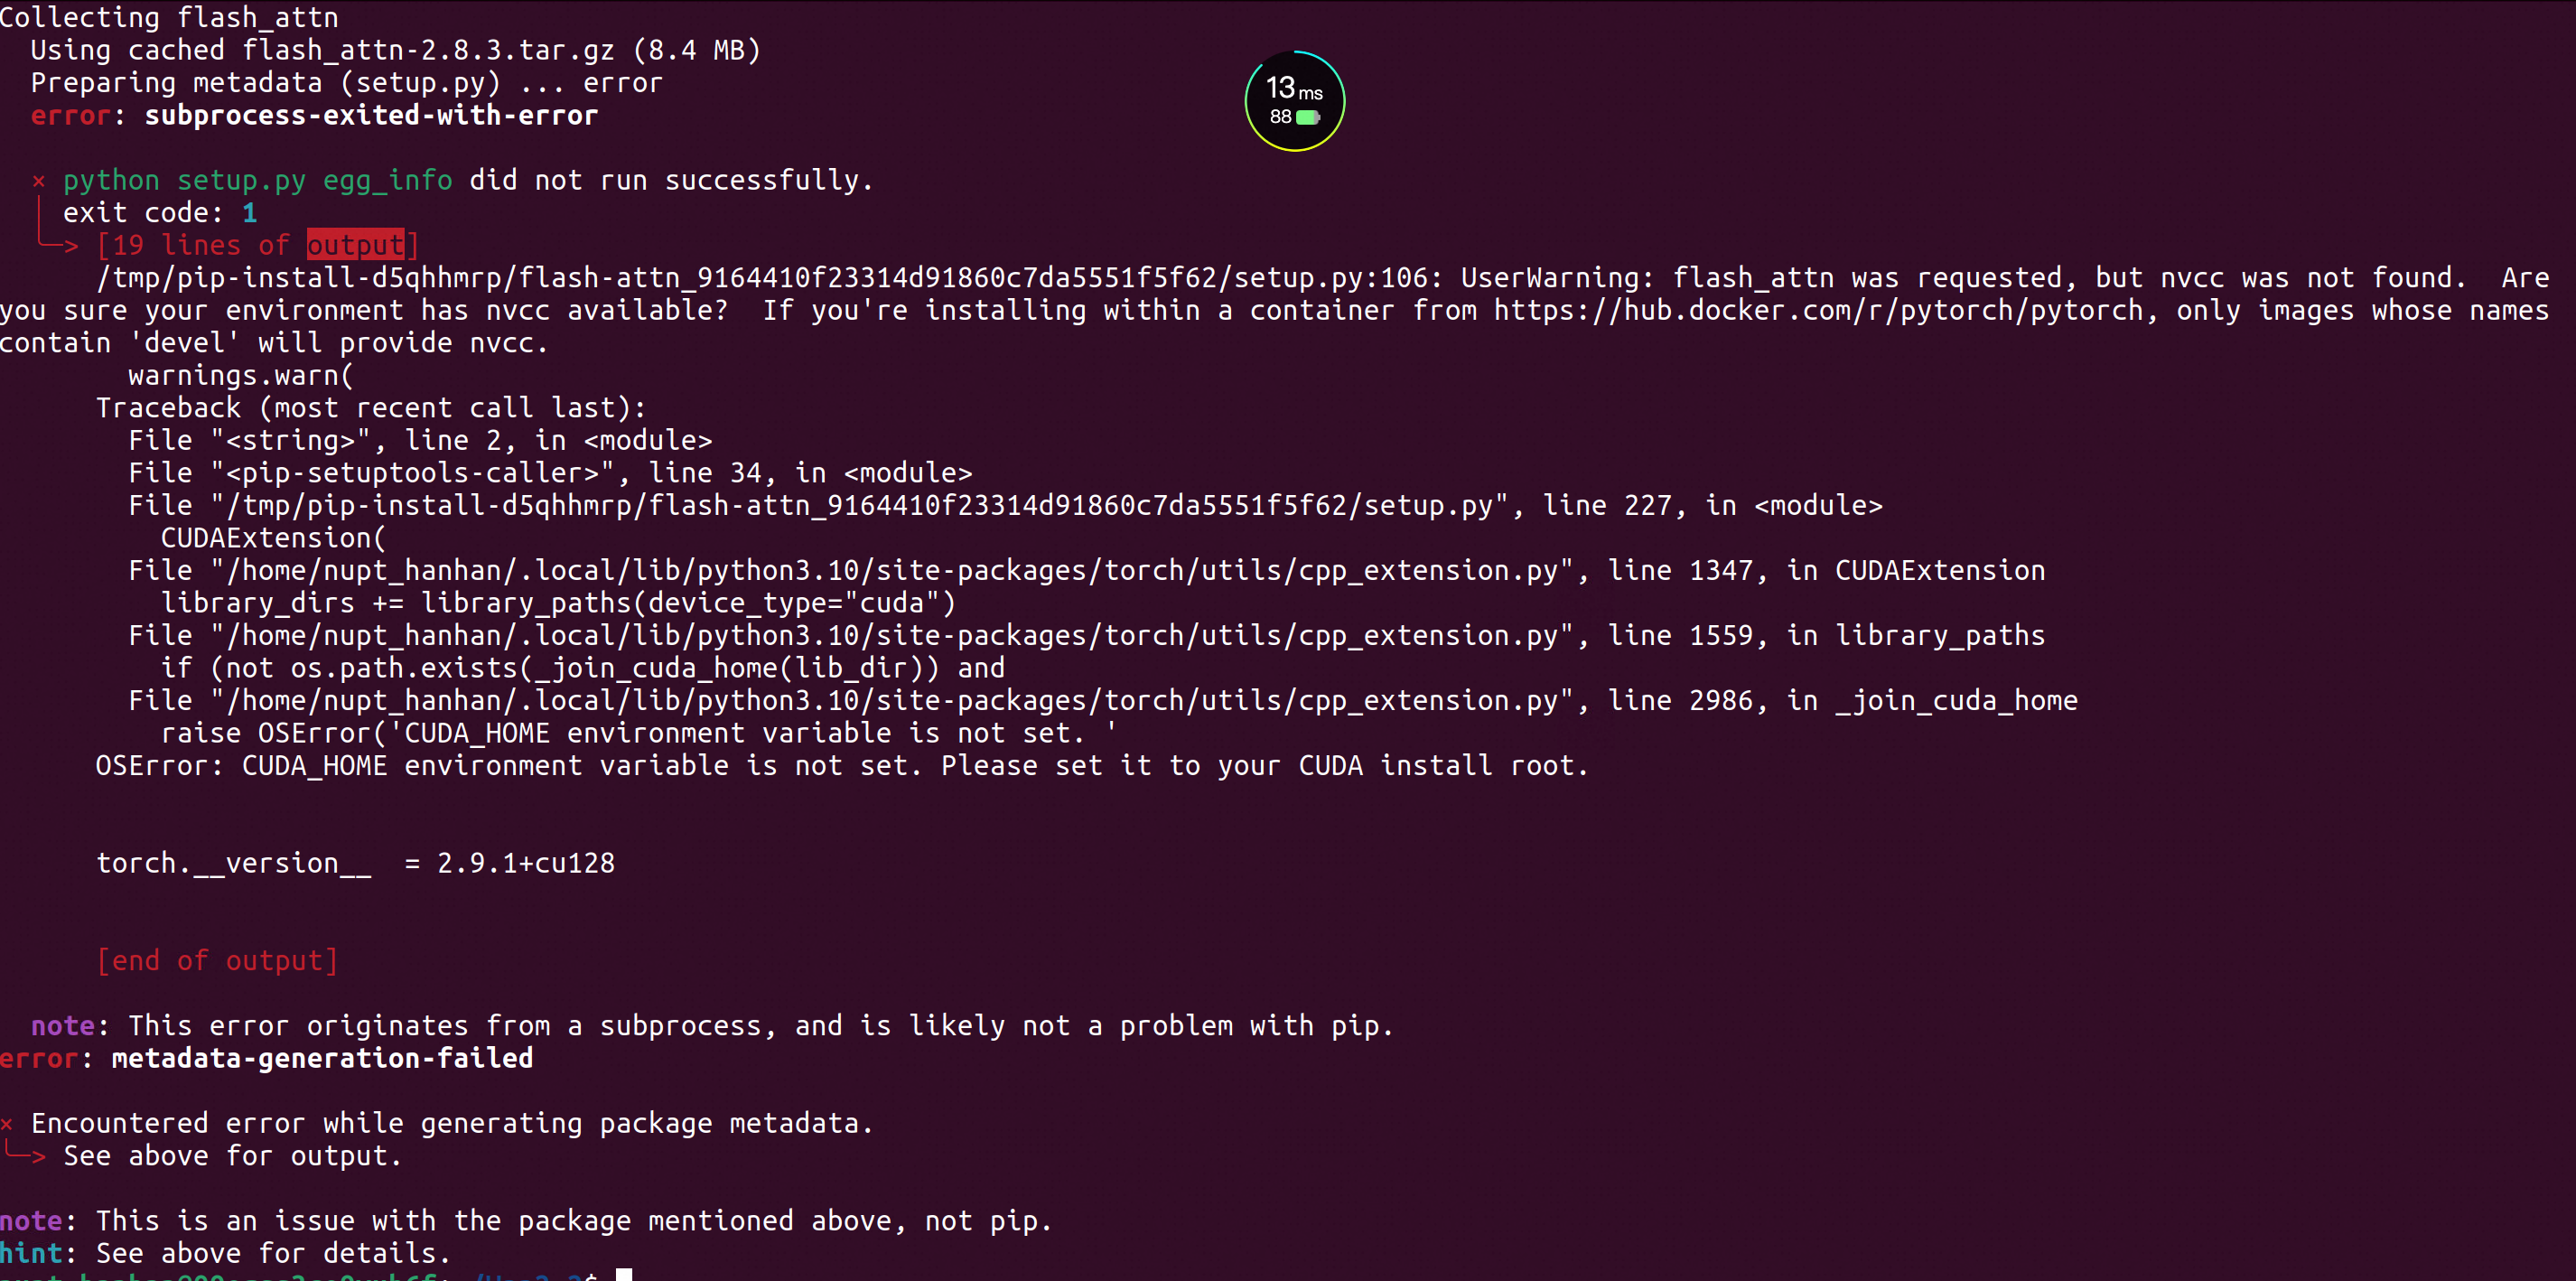
flash-attn 是阿里 Wan2.2 模型能跑起来的关键。它能极大减少显存占用并提高生成视频的速度。如果没有它,即使你模型跑起来了,显存也会瞬间爆掉(OOM)
截图问题的核心非常明确:你只有 GPU 驱动,但缺少 CUDA Toolkit(开发套件),导致系统找不到 nvcc 编译器。
apt-get install nvidia-cuda-toolkit
#一般别apt, 版本太旧且容易乱,引发报错。直接wget官网https://developer.download.nvidia.com/compute/cuda/12.\*\*\*\*
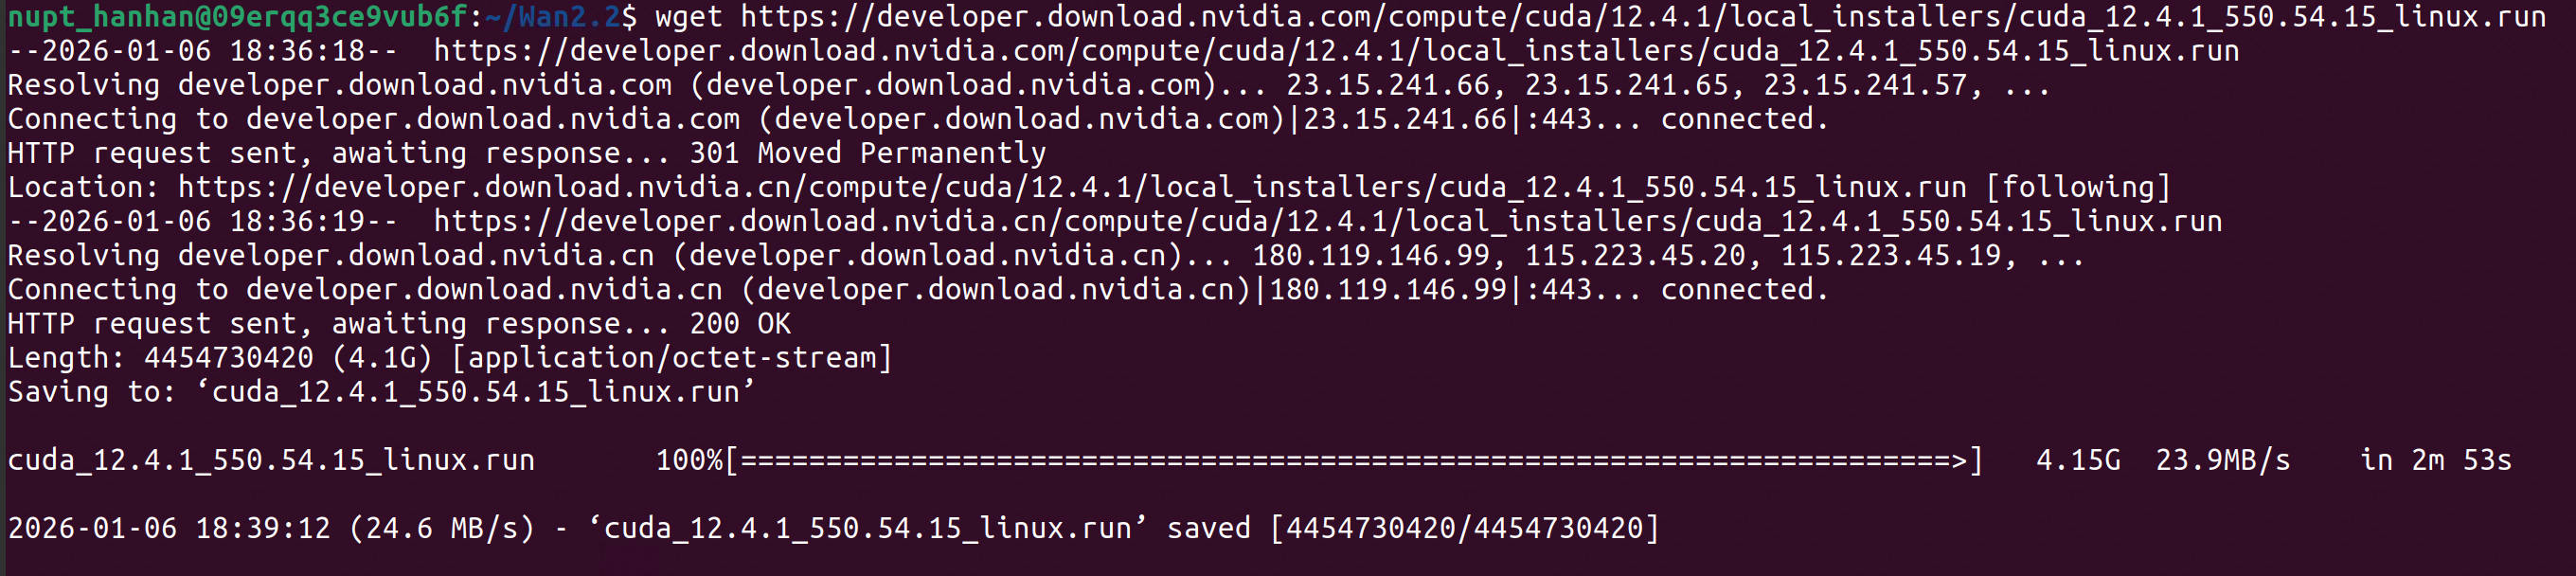
sudo sh cuda_12.4.1_550.54.15_linux.run
安装时的选项操作(一定要看):
输入 accept 后回车。
【重点】 在出现的菜单里,你会看到 X Driver。
请按空格键,把它变成 Driver。(取消勾选驱动,我们只装 Toolkit)。
确保 X CUDA Toolkit 12.4 是勾选状态。
移动光标到 Install,按回车。
Driver:你已经取消了驱动勾选,这样就不会覆盖你现有的 12.8 驱动,保证了系统的安全。
X CUDA Toolkit 12.4:你勾选了开发套件,这会安装我们急需的 nvcc 编译器。
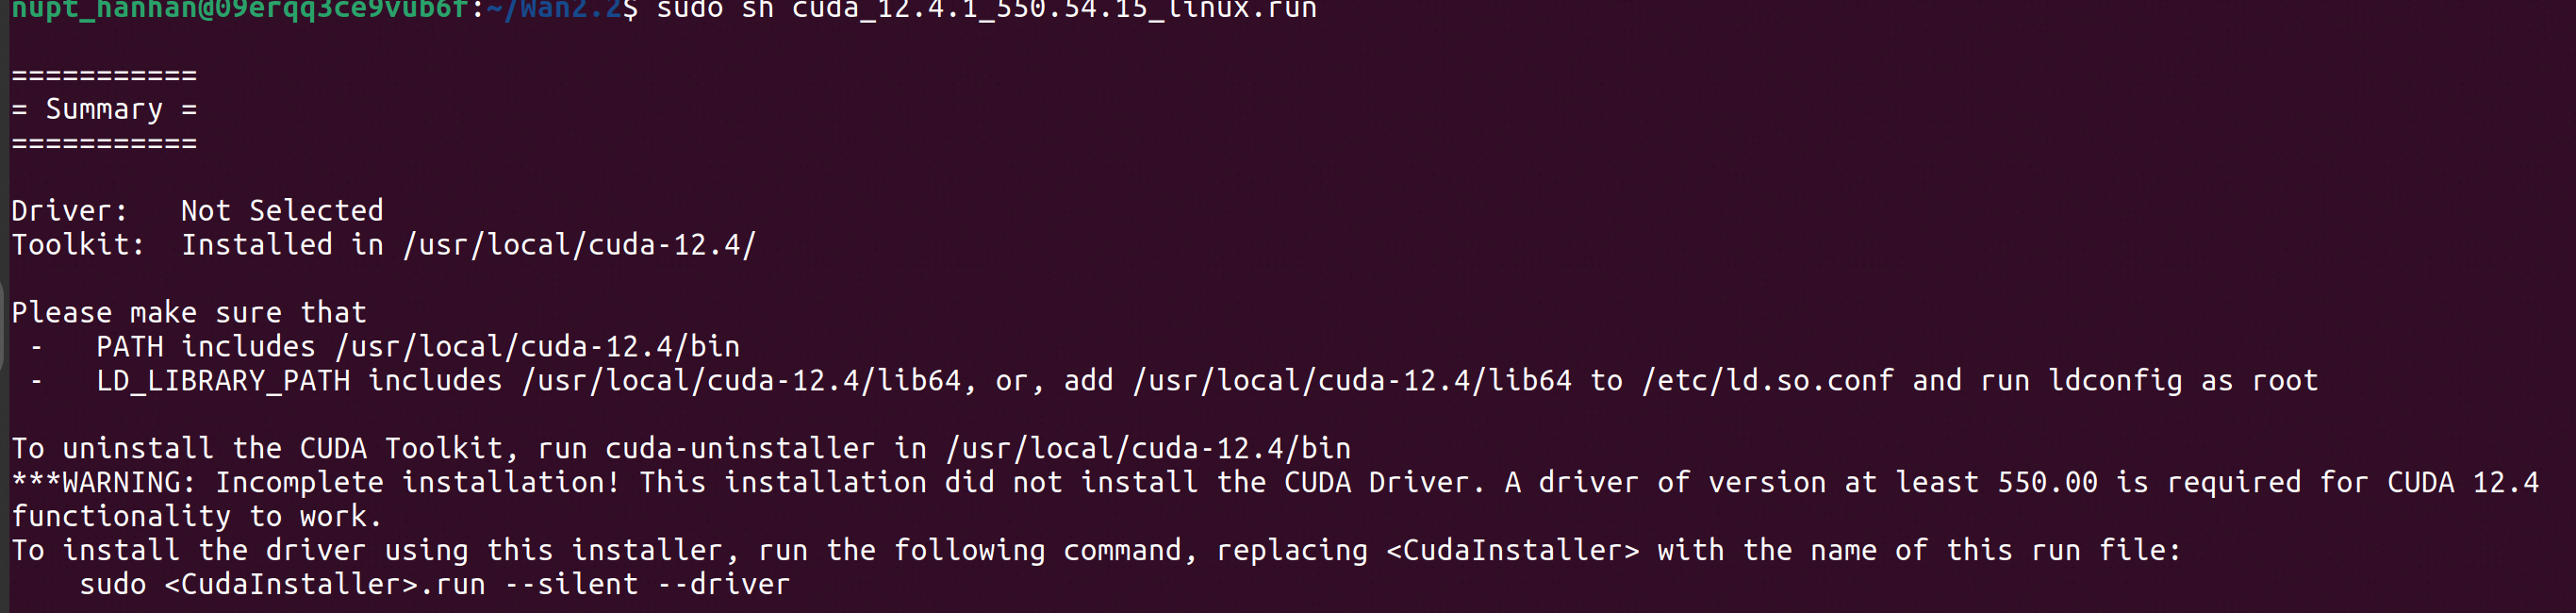
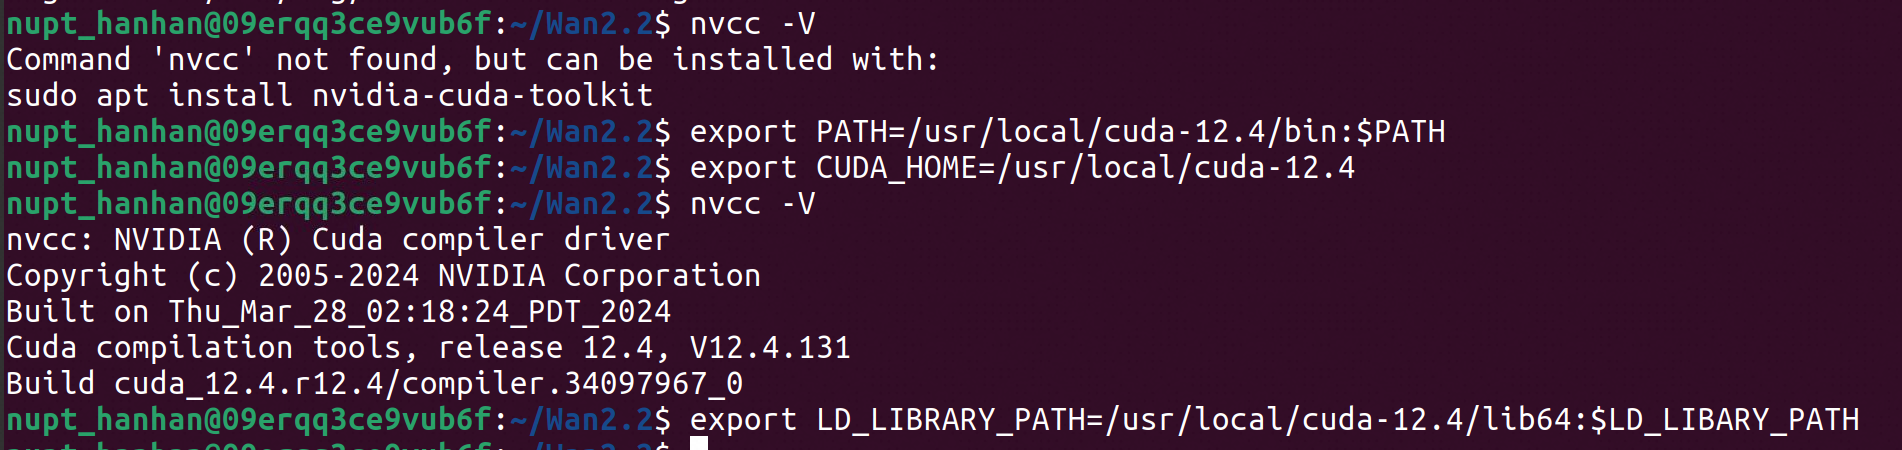
pip install flash-attn 是出了名的慢
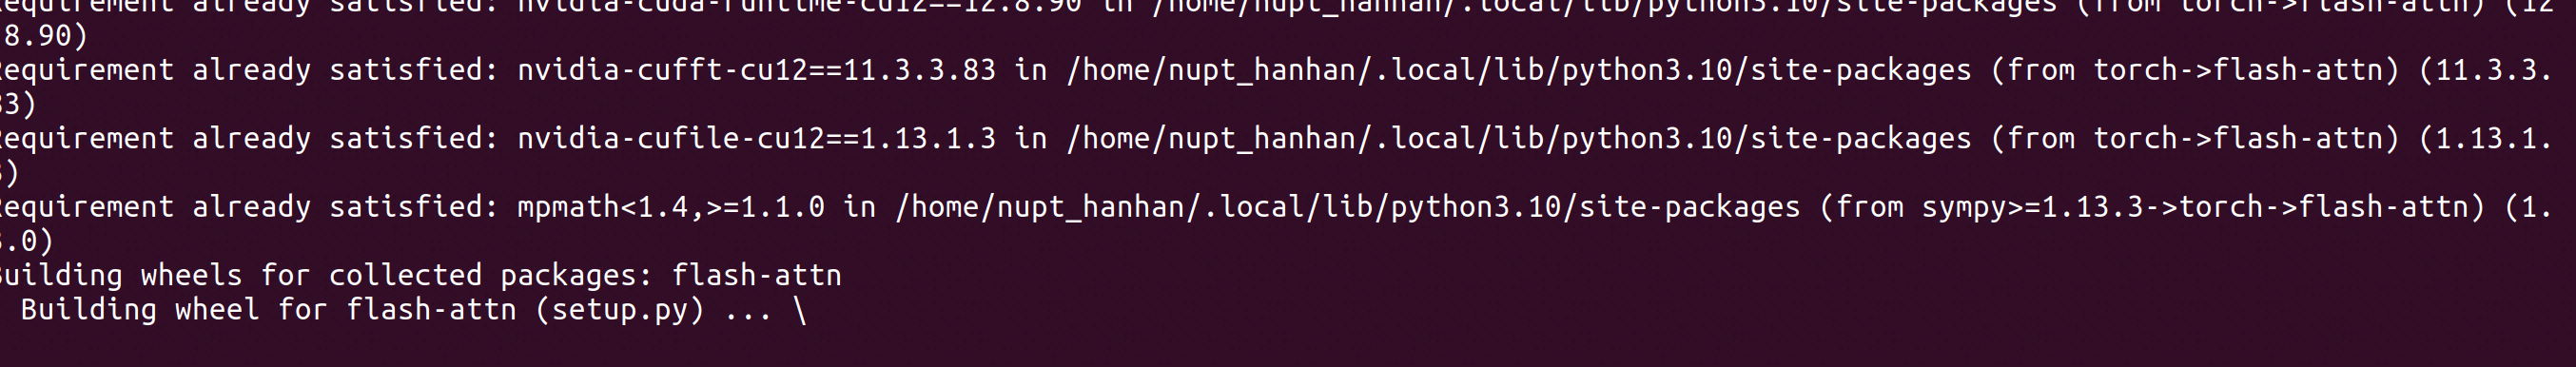
因为 flash-attn 包含大量的底层 CUDA 内核代码。当你执行这条命令时,你的机器正在:
调用你刚装好的 nvcc 编译器。
针对你的显卡架构,现场把几万行 C++/CUDA 代码编译成二进制。
这个过程极度消耗 CPU 和内存。
---上海的机器似乎有github墙
PyTorch 版本需要慎重考虑。如果选择太新的话,配套包跟不上。