推荐直接网站在线阅读:aicoting AI算法面试学习在线网站
特征工程(Feature Engineering) 是机器学习流程中将原始数据转换为适合模型学习的特征的关键步骤。它直接决定了模型能否高效捕捉数据中的规律。好的特征可以显著提升模型性能,而差的特征即使模型再复杂也难以取得好效果。
特征工程的核心目标是:
- 提取有效信息:将原始数据中有价值的信号转化为模型可以理解的特征;
- 减少冗余与噪声:去掉无关或多余的特征,使模型更简洁、更泛化;
- 增强表达能力:通过构造、组合或降维生成新的特征,使模型能够更好地捕捉数据的复杂关系;
- 提高训练效率:减少特征维度、统一尺度,使模型训练更快、收敛更稳定。
特征工程通常包括三个主要环节:
- 特征选择:识别并保留对预测任务最有贡献的特征;
- 特征构造:基于现有特征生成新的、更具信息量的特征,例如多项式特征、交互特征;
- 特征降维:通过方法如 PCA、LDA、ICA,将高维特征压缩到低维空间,同时保留主要信息。
特征工程在机器学习中与算法本身同等重要。这也是机器学习和深度学习的最大区别所在,通过合理的特征处理,可以让简单的模型也取得出色的效果,为后续模型训练和优化打下坚实基础。
下面我们来看一下特征降维。
什么是特征降维?
特征降维是指在 保留数据主要信息的前提下,将高维特征映射到低维空间 的过程。它在机器学习中非常重要,尤其面对高维数据时,可以:
- 减少计算成本和存储空间;
- 降低过拟合风险,提高模型泛化能力;
- 消除特征冗余和噪声,提高训练效率。
特征降维的基本思路
特征降维通常有两个目标:
- 保持数据的主要信息(方差/信息量);
- 降低维度,简化模型结构。 在数学上,给定原始数据矩阵 ,通过降维方法得到低维表示 ,其中 。
特征降维方法分类
1.主成分分析(PCA, Principal Component Analysis)
原理:PCA 通过线性变换,将原始特征投影到方差最大的方向(主成分),保留数据中最重要的信息。
步骤如下:
- 均值中心化:
- 计算协方差矩阵:
- 特征值分解:
- 选择前 k 个特征向量 构成投影矩阵 W,得到降维结果:
python
import numpy as np
from sklearn.decomposition import PCA

# 构造数据
X = np.array([[2.5, 2.4],
              [0.5, 0.7],
              [2.2, 2.9],
              [1.9, 2.2]])

# PCA 降到 1 维
pca = PCA(n_components=1)
X_pca = pca.fit_transform(X)
print(X_pca)
输出如下:
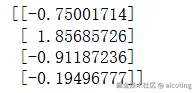
PCA常用于高维数据可视化、噪声去除,作为特征预处理,提高模型效率。
2.线性判别分析(LDA, Linear Discriminant Analysis)
原理:LDA 是一种监督降维方法,通过最大化类间方差、最小化类内方差,将数据投影到低维空间,增强类别可分性。
- 类内散度矩阵 :
- 类间散度矩阵 :
- 求解广义特征值问题:
python
# 用的是 iris 数据集
from sklearn.datasets import load_iris
from sklearn.discriminant_analysis import LinearDiscriminantAnalysis

data = load_iris()
X = data.data   # shape (150, 4)
y = data.target # shape (150,)

lda = LinearDiscriminantAnalysis(n_components=1)
X_lda = lda.fit_transform(X, y)
print(X_lda.shape)
输出如下:
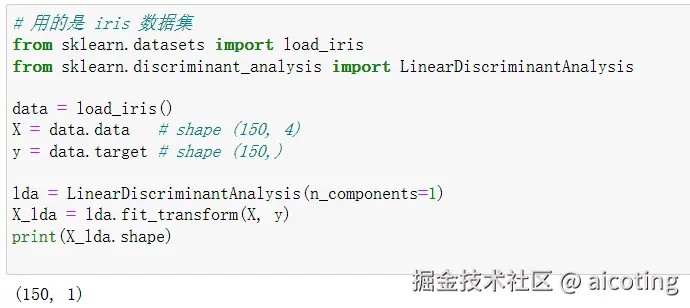
LDA常用于分类任务特征降维,提高模型的类别可分性,适合类别标签已知的数据集。
3.独立成分分析(ICA, Independent Component Analysis)
原理:ICA 假设观测数据是若干独立非高斯信号的线性混合,通过寻找独立成分分解原始特征。 优点:
- 去除混合噪声;
- 可用于信号分离(如 EEG、音频源分离)。
python
from sklearn.decomposition import FastICA

ica = FastICA(n_components=2)
X_ica = ica.fit_transform(X)
print(X_ica)
输出如下:
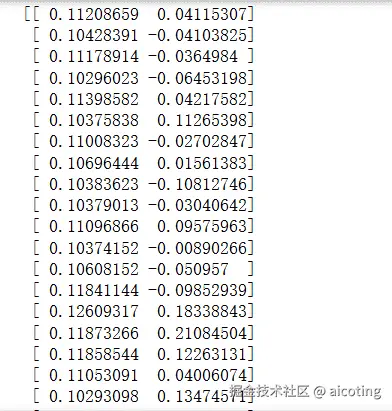
ICA常用于信号处理、音频源分离等任务,通过独立成分分析,将混合信号分离为原始独立信号。
4.非线性降维方法
- t-SNE:适合高维数据可视化,保留局部结构;
- UMAP:保留局部和全局结构,速度快,可扩展性好。
python
from sklearn.manifold import TSNE

tsne = TSNE(n_components=2, random_state=42)
X_tsne = tsne.fit_transform(X)
print(X_tsne.shape)
t-SNE常用于高维数据可视化,将数据映射到 2D 或 3D 空间,展示数据分布和聚类结构。
特征降维的部分到此就结束啦,是不是也没有那么难,你现在已经知道了特征降维是 特征工程的重要环节,与特征选择和特征构造结合,可以让模型在高维数据中保持高效和稳定。
最新的文章都在公众号aicoting更新,别忘记关注哦!!