机器学习-过拟合&欠拟合问题

欠拟合

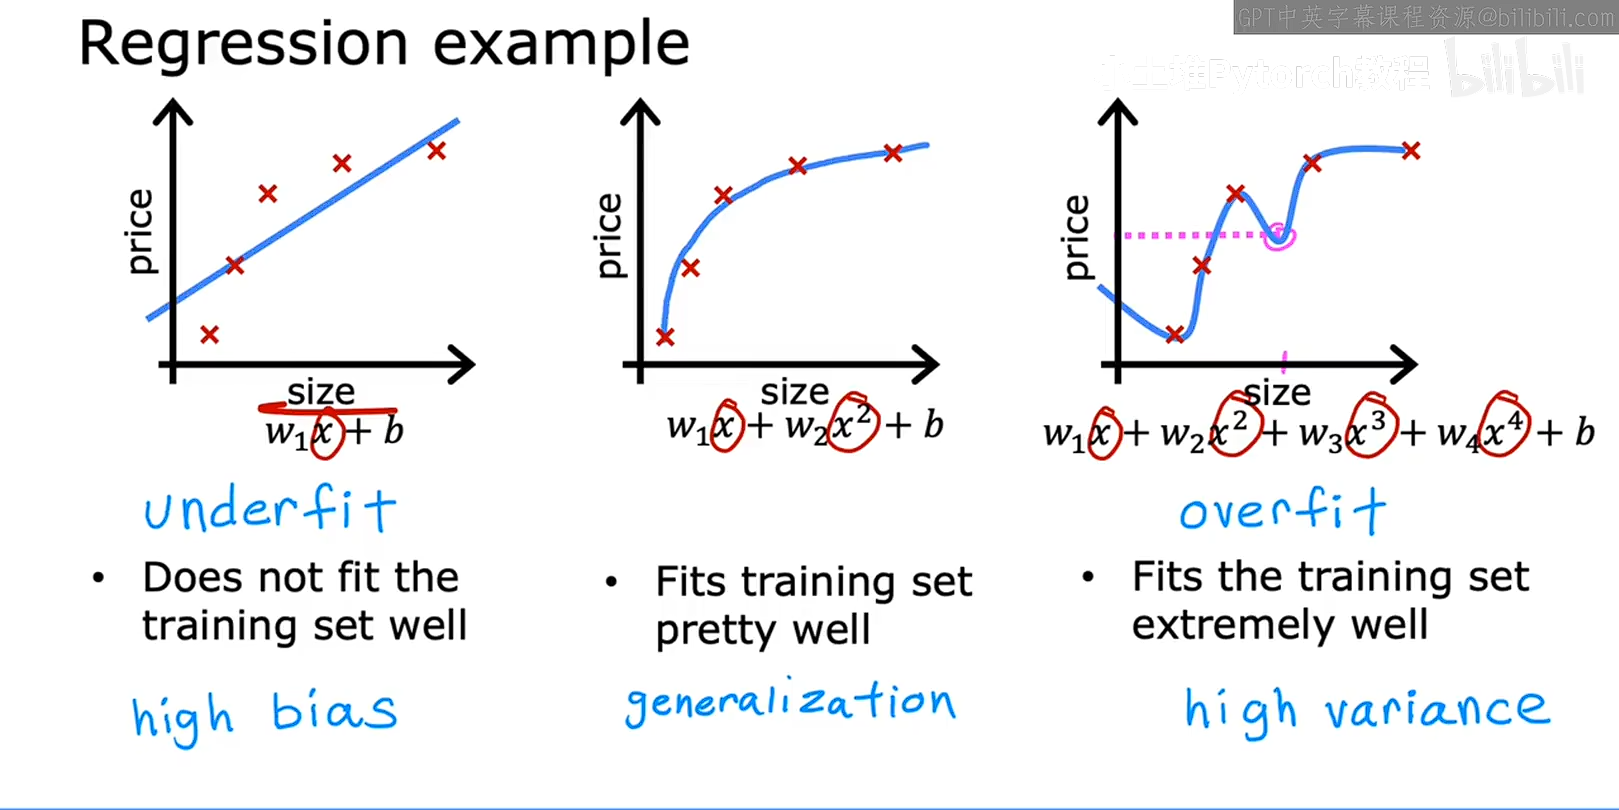
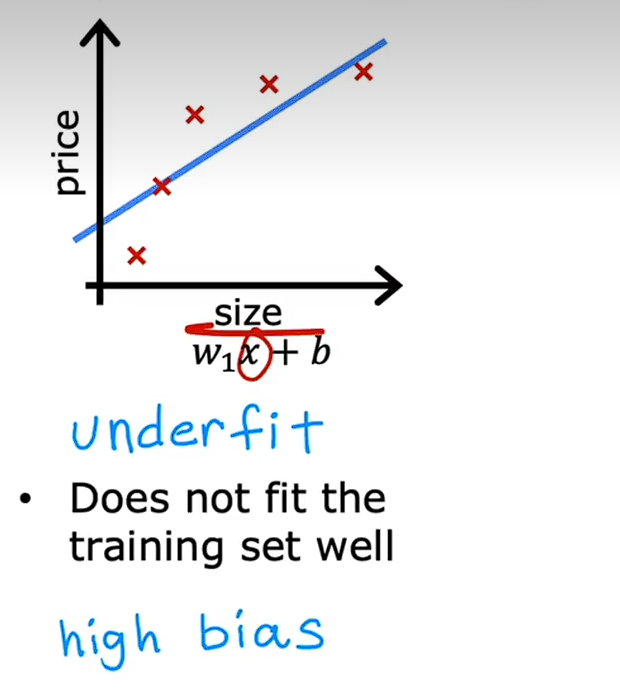
还是回到线性回归欠拟合的例子,如下图,我们得到的模型是房屋的大小和模型,可以看到随着房屋面积的表达,模型并没有,所以模型并没有很好的拟合训练数据,这个技术数据就是欠拟合另一个数据就是算法具有高偏差,

欠拟合意味着算法无法很好的拟合训练集,训练数据中有一个明显的模式,但是算法无法捕捉到
在上图中,第二个数据集合的刚刚好,泛化能力也不错,如果说在训和练测试的数据集之外的其他数据集中,模型拟合这些数据的能力也不错,这叫做泛化,我们说希望你的学习算法可以更好的泛化,这意味着,即使在他从未见过的数据集上也能做错良好的预测,对新样本有很好的泛化能力。

看一下上图同的第三个图,这条曲线非常完美的拟合了训练数据,因为他恰好通过了所有的训练数据,可以通过选择参数,使得这个模型的代价函数刚好等于使他这五个样本中的误差刚好等于0,

这是一条非常曲折的曲线,在各处上下波动,在某些地方,房子相比面积很小,但是房价更贵,所以可以认为这不是一个很好的房价预测模型。技术术语会说这个模型过拟合了这些数据,或者说模型存在过拟合问题,虽然他拟合了所有的数据,但是拟合的太好了,属于死记硬背,看起来也不具备非常好的泛化能力,另一个属于就是算法具有高方差,

中间的是模型刚刚好,他既不过拟合,也不欠拟合,几部高偏差,也不高方差,目前为止还没有也定的术语,我们也可以看到,机器学习就是在寻找一个既不过拟合也不欠拟合的模型,
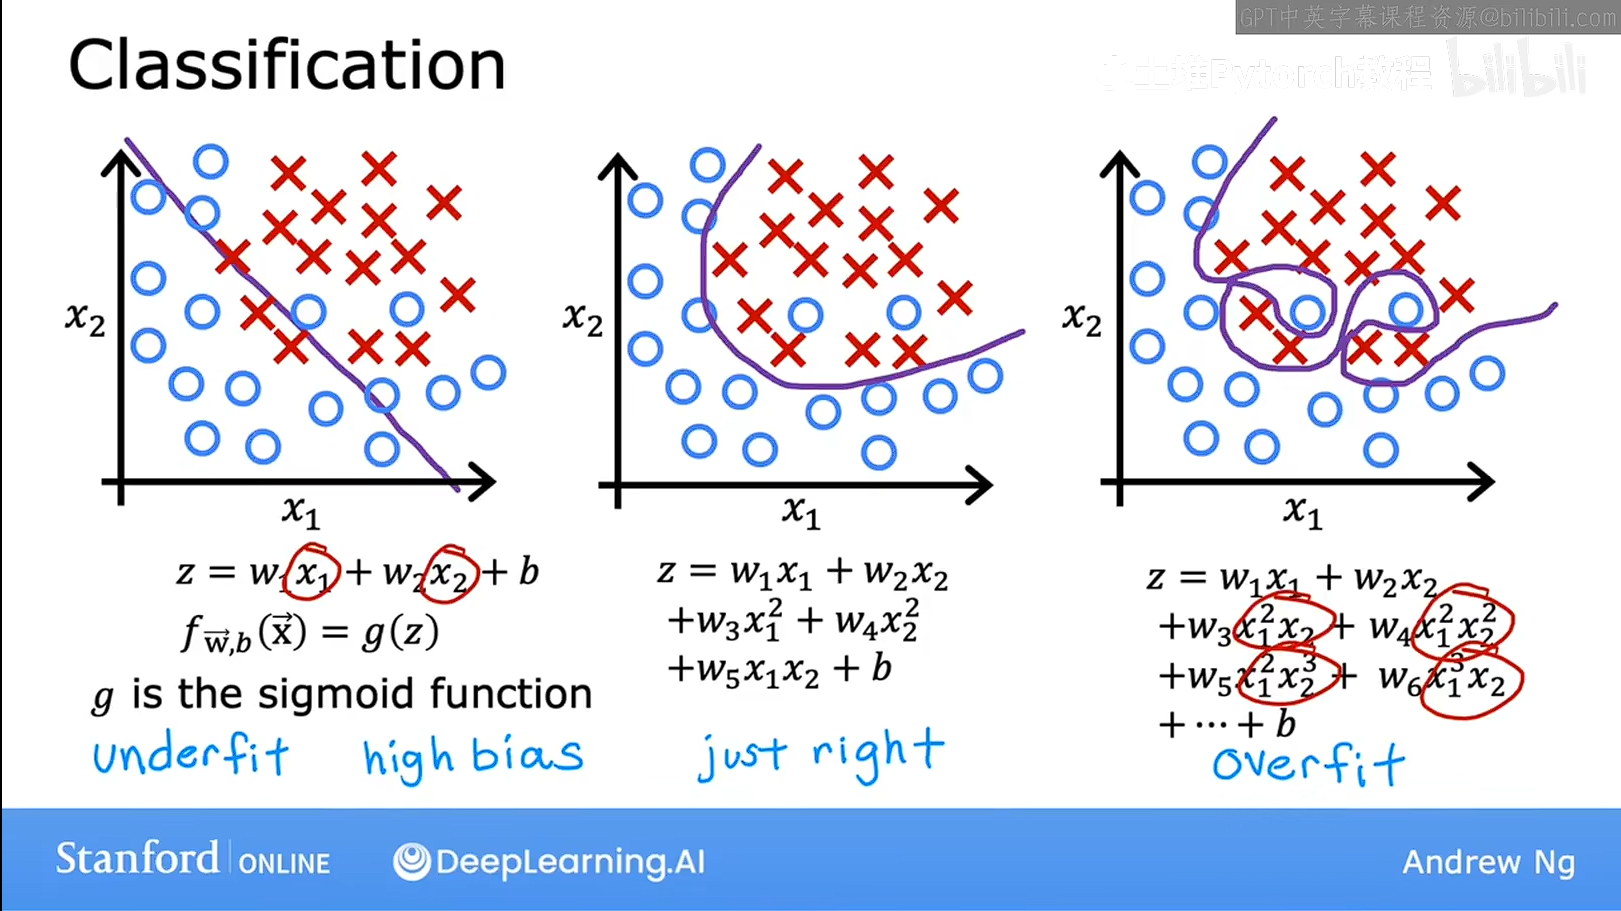
如上图我们可以看到,第一个数据拟合的不太好,属于欠拟合,第二个,数据拟合的刚刚好,第三个数据是过拟合也叫高方不一定有很好的泛化能力

相关推荐
XLYcmy5 分钟前
基于大语言模型的智能漏洞检测与修复系统 作品报告评审分析报告 下
机器学习·llm·prompt·api·token·漏洞修复·漏洞检测
AllData公司负责人14 分钟前
第九篇:AI大模型数据开发底座系列说明书:AllData集成BISHENG开源项目建设大模型应用开发底座,涵盖可视化编排/智能助手/一键API/模型接入!
人工智能·云原生·数据分析·视觉检测·知识图谱·大模型应用·bisheng
数字新视界17 分钟前
数据中心DCIM管理系统助力提升机房管理效率与安全性
大数据·人工智能·物联网·信息与通信·动环监控系统
阿里云大数据AI技术21 分钟前
阿里云 EMR Serverless StarRocks(Stella)× Paimon:让多模态数据湖从“存得下”走向“找得到、用得上”
人工智能
class心平气和36 分钟前
AI 赋能测试流程:从基础概念到测试全流程实战
人工智能
猿人谷38 分钟前
遗传编程的未来:从进化搜索到自主发现求解方法
人工智能·深度学习·神经网络·ai-native
字节跳动开源42 分钟前
OpenViking 3D理解模型上线轴测八视图及PMI解析
人工智能·开源·aigc
阿里云大数据AI技术1 小时前
孩子王基于阿里云Data Agent的智能体实践:300+Agent 覆盖400+业务场景
大数据·人工智能·agent
code2cat1 小时前
【随笔】MCP长任务:查询已经返回,为什么任务还没有完成
javascript·人工智能·后端·mcp
玄魂1 小时前
小红书/抖音图文排版利器——一个杂志风skill
人工智能·agent·视觉设计