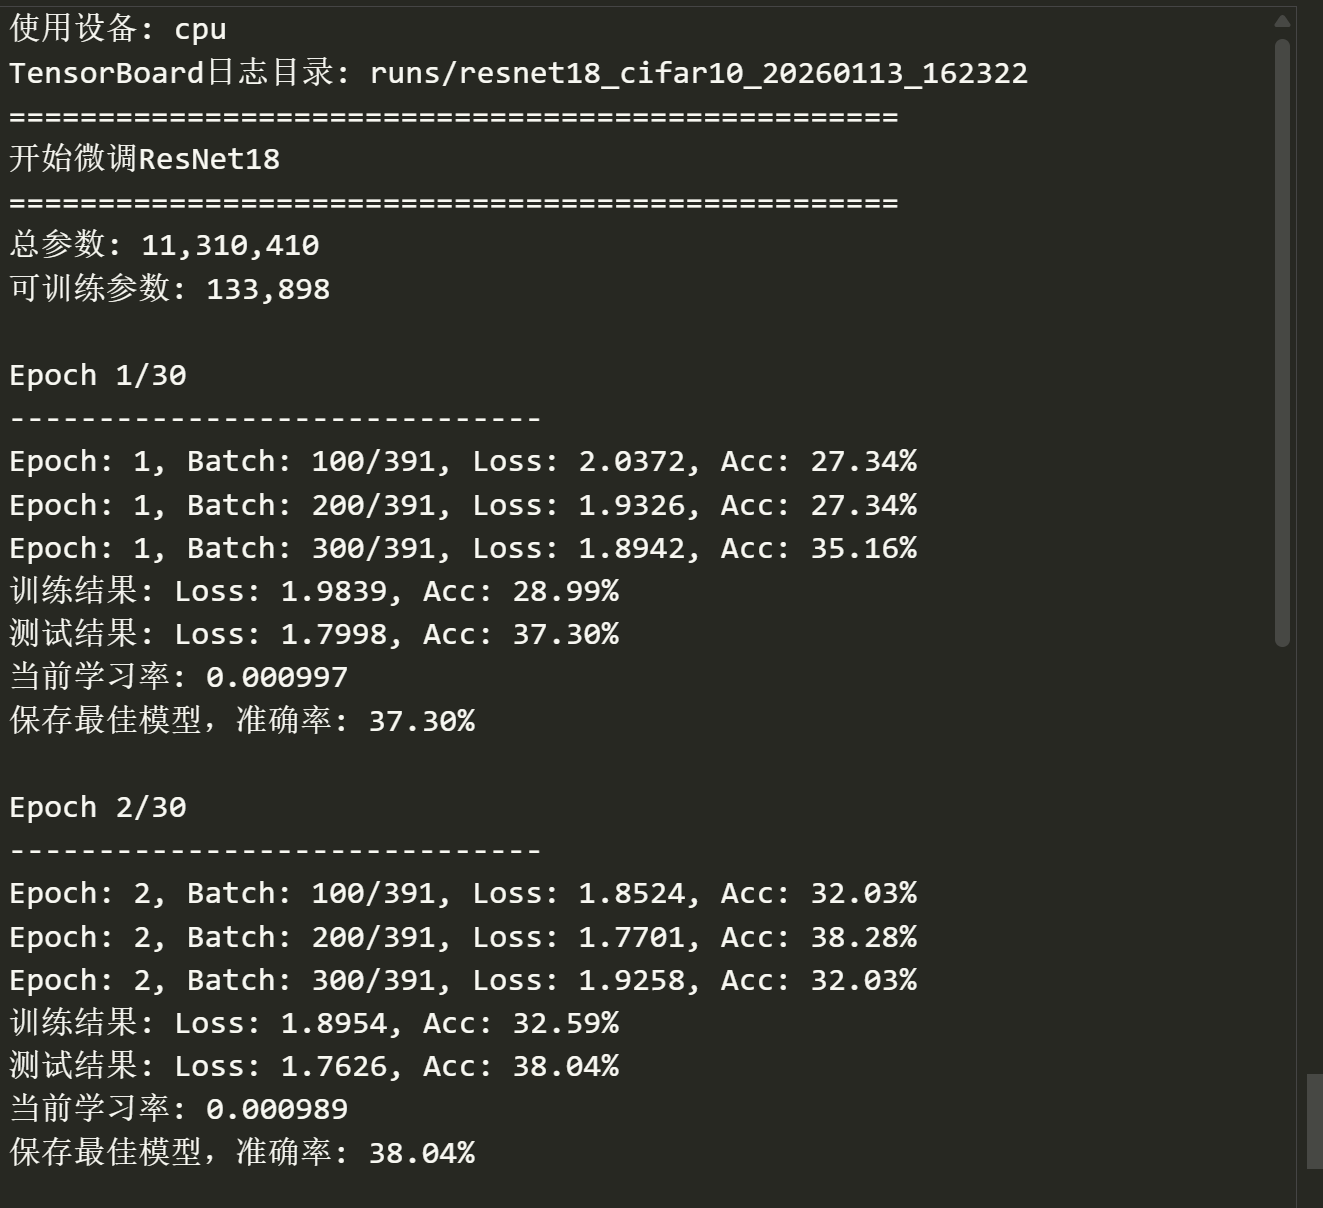
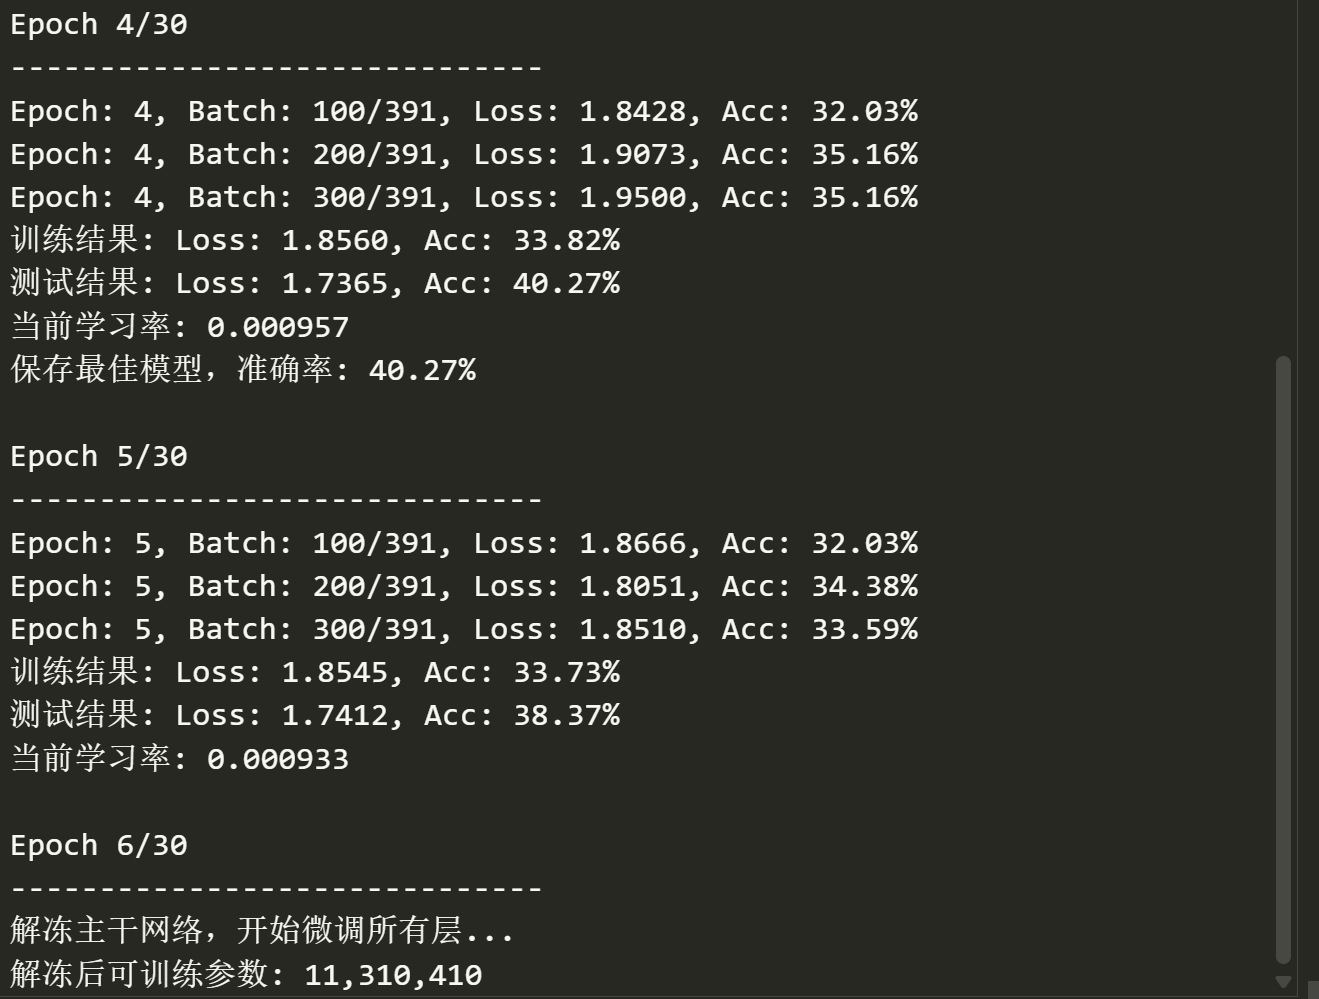
python
import torch
import torch.nn as nn
import torch.optim as optim
from torchvision import datasets, transforms, models
from torch.utils.data import DataLoader
from torch.utils.tensorboard import SummaryWriter
from torchvision.utils import make_grid
import matplotlib.pyplot as plt
import numpy as np
import os
from datetime import datetime

# 设置随机种子保证可重复性
torch.manual_seed(42)
np.random.seed(42)

# 设备配置
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
print(f"使用设备: {device}")

# 数据预处理和增强
transform_train = transforms.Compose([
    transforms.RandomCrop(32, padding=4),
    transforms.RandomHorizontalFlip(),
    transforms.ToTensor(),
    transforms.Normalize((0.4914, 0.4822, 0.4465), (0.2023, 0.1994, 0.2010)),
])

transform_test = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.4914, 0.4822, 0.4465), (0.2023, 0.1994, 0.2010)),
])

# 加载CIFAR-10数据集
train_dataset = datasets.CIFAR10(
    root='./data',
    train=True,
    download=True,
    transform=transform_train
)
test_dataset = datasets.CIFAR10(
    root='./data',
    train=False,
    download=True,
    transform=transform_test
)

train_loader = DataLoader(
    train_dataset,
    batch_size=128,
    shuffle=True,
    num_workers=2
)
test_loader = DataLoader(
    test_dataset,
    batch_size=100,
    shuffle=False,
    num_workers=2
)

# 类别名称
classes = ('plane', 'car', 'bird', 'cat', 'deer',
           'dog', 'frog', 'horse', 'ship', 'truck')

# 创建TensorBoard的SummaryWriter
timestamp = datetime.now().strftime('%Y%m%d_%H%M%S')
log_dir = f'runs/resnet18_cifar10_{timestamp}'
writer = SummaryWriter(log_dir=log_dir)
print(f"TensorBoard日志目录: {log_dir}")

# 创建ResNet18模型(使用预训练权重)
def create_resnet18_finetune(num_classes=10, freeze_backbone=True):
    """
    创建用于微调的ResNet18模型

    Args:
        num_classes: 输出类别数
        freeze_backbone: 是否冻结主干网络(前几个epoch可以冻结,之后解冻)
    """
    # 加载预训练的ResNet18
    model = models.resnet18(weights=models.ResNet18_Weights.IMAGENET1K_V1)

    # 冻结所有卷积层(在微调开始时)
    if freeze_backbone:
        for param in model.parameters():
            param.requires_grad = False

    # 修改最后的全连接层以适应CIFAR-10
    num_features = model.fc.in_features
    model.fc = nn.Sequential(
        nn.Dropout(0.5),
        nn.Linear(num_features, 256),
        nn.ReLU(),
        nn.Dropout(0.3),
        nn.Linear(256, num_classes)
    )

    return model

# 训练函数
def train_epoch(model, train_loader, criterion, optimizer, epoch, device, writer=None):
    """训练一个epoch"""
    model.train()
    running_loss = 0.0
    correct = 0
    total = 0

    for batch_idx, (inputs, targets) in enumerate(train_loader):
        inputs, targets = inputs.to(device), targets.to(device)

        # 前向传播
        optimizer.zero_grad()
        outputs = model(inputs)
        loss = criterion(outputs, targets)

        # 反向传播
        loss.backward()
        optimizer.step()

        # 统计
        running_loss += loss.item()
        _, predicted = outputs.max(1)
        total += targets.size(0)
        correct += predicted.eq(targets).sum().item()

        # 每100个batch打印一次进度
        if (batch_idx + 1) % 100 == 0:
            batch_loss = loss.item()
            batch_acc = 100. * predicted.eq(targets).sum().item() / targets.size(0)
            print(f'Epoch: {epoch+1}, Batch: {batch_idx+1}/{len(train_loader)}, '
                  f'Loss: {batch_loss:.4f}, Acc: {batch_acc:.2f}%')

            # 记录每个batch的学习率
            if writer:
                writer.add_scalar('Learning Rate', optimizer.param_groups[0]['lr'],
                                epoch * len(train_loader) + batch_idx)

    # 计算整个epoch的指标
    epoch_loss = running_loss / len(train_loader)
    epoch_acc = 100. * correct / total

    # 记录到TensorBoard
    if writer:
        writer.add_scalar('Loss/Train', epoch_loss, epoch)
        writer.add_scalar('Accuracy/Train', epoch_acc, epoch)

    return epoch_loss, epoch_acc

# 测试函数
def test_epoch(model, test_loader, criterion, epoch, device, writer=None):
    """测试模型"""
    model.eval()
    test_loss = 0.0
    correct = 0
    total = 0

    with torch.no_grad():
        for inputs, targets in test_loader:
            inputs, targets = inputs.to(device), targets.to(device)
            outputs = model(inputs)
            loss = criterion(outputs, targets)

            test_loss += loss.item()
            _, predicted = outputs.max(1)
            total += targets.size(0)
            correct += predicted.eq(targets).sum().item()

    # 计算整体指标
    test_loss = test_loss / len(test_loader)
    test_acc = 100. * correct / total

    # 记录到TensorBoard
    if writer:
        writer.add_scalar('Loss/Test', test_loss, epoch)
        writer.add_scalar('Accuracy/Test', test_acc, epoch)

    return test_loss, test_acc

# 主训练循环
def train_resnet18_finetune(epochs=30, lr=0.001, unfreeze_epoch=5):
    """
    微调ResNet18

    Args:
        epochs: 总训练轮数
        lr: 学习率
        unfreeze_epoch: 解冻主干网络的epoch
    """
    print("=" * 50)
    print("开始微调ResNet18")
    print("=" * 50)

    # 创建模型
    model = create_resnet18_finetune(num_classes=10, freeze_backbone=True)
    model = model.to(device)

    # 打印模型参数
    total_params = sum(p.numel() for p in model.parameters())
    trainable_params = sum(p.numel() for p in model.parameters() if p.requires_grad)
    print(f"总参数: {total_params:,}")
    print(f"可训练参数: {trainable_params:,}")

    # 损失函数和优化器
    criterion = nn.CrossEntropyLoss()

    # 第一阶段:只训练最后的全连接层
    optimizer = optim.AdamW(model.fc.parameters(), lr=lr, weight_decay=1e-4)
    scheduler = optim.lr_scheduler.CosineAnnealingLR(optimizer, T_max=epochs)

    best_acc = 0.0

    for epoch in range(epochs):
        print(f"\nEpoch {epoch+1}/{epochs}")
        print("-" * 30)

        # 在指定epoch解冻主干网络
        if epoch == unfreeze_epoch:
            print("解冻主干网络,开始微调所有层...")
            for param in model.parameters():
                param.requires_grad = True

            # 重新定义优化器,包含所有参数
            optimizer = optim.AdamW(
                model.parameters(),
                lr=lr/10,  # 解冻后使用更小的学习率
                weight_decay=1e-4
            )
            scheduler = optim.lr_scheduler.CosineAnnealingLR(optimizer, T_max=epochs-unfreeze_epoch)

            # 更新可训练参数计数
            trainable_params = sum(p.numel() for p in model.parameters() if p.requires_grad)
            print(f"解冻后可训练参数: {trainable_params:,}")

        # 训练
        train_loss, train_acc = train_epoch(
            model, train_loader, criterion, optimizer,
            epoch, device, writer
        )

        # 测试
        test_loss, test_acc = test_epoch(
            model, test_loader, criterion, epoch,
            device, writer
        )

        # 学习率调度
        scheduler.step()

        # 打印结果
        print(f"训练结果: Loss: {train_loss:.4f}, Acc: {train_acc:.2f}%")
        print(f"测试结果: Loss: {test_loss:.4f}, Acc: {test_acc:.2f}%")
        print(f"当前学习率: {optimizer.param_groups[0]['lr']:.6f}")

        # 保存最佳模型
        if test_acc > best_acc:
            best_acc = test_acc
            torch.save({
                'epoch': epoch,
                'model_state_dict': model.state_dict(),
                'optimizer_state_dict': optimizer.state_dict(),
                'test_acc': test_acc,
                'train_acc': train_acc,
            }, f'best_resnet18_cifar10.pth')
            print(f"保存最佳模型,准确率: {test_acc:.2f}%")

    print("\n" + "=" * 50)
    print(f"训练完成!最佳测试准确率: {best_acc:.2f}%")
    print("=" * 50)

    return model, best_acc

# 可视化函数
def visualize_results(model, test_loader, writer, num_images=8):
    """在TensorBoard中可视化一些测试图片和预测结果"""
    model.eval()
    dataiter = iter(test_loader)
    images, labels = next(dataiter)

    # 只取前num_images张图片
    images = images[:num_images]
    labels = labels[:num_images]
    images = images.to(device)

    with torch.no_grad():
        outputs = model(images)
        _, predicted = torch.max(outputs, 1)

    # 将图片添加到TensorBoard
    # 反归一化用于显示
    mean = torch.tensor([0.4914, 0.4822, 0.4465]).view(3, 1, 1)
    std = torch.tensor([0.2023, 0.1994, 0.2010]).view(3, 1, 1)
    images_denorm = images.cpu() * std + mean
    images_denorm = torch.clamp(images_denorm, 0, 1)

    # 创建图片网格
    img_grid = make_grid(images_denorm, nrow=4, normalize=False)

    # 添加到TensorBoard
    writer.add_image('Test Images/Predictions', img_grid, 0)

    # 添加预测文本
    print("\n预测示例:")
    for i in range(min(num_images, len(images))):
        pred_label = predicted[i].item()
        true_label = labels[i].item()
        is_correct = pred_label == true_label
        status = "✓" if is_correct else "✗"
        print(f"图片{i+1}: 真实={classes[true_label]:8s}, 预测={classes[pred_label]:8s} {status}")

    return images, labels, predicted

# 运行训练
if __name__ == "__main__":
    # 创建日志目录
    os.makedirs('models', exist_ok=True)

    # 开始训练
    trained_model, best_acc = train_resnet18_finetune(
        epochs=30,  # 可以调整epoch数量
        lr=0.001,   # 初始学习率
        unfreeze_epoch=5  # 在第5个epoch解冻主干网络
    )

    # 可视化一些结果
    print("\n可视化预测结果...")
    images, labels, predictions = visualize_results(trained_model, test_loader, writer, num_images=8)

    # 记录模型图结构
    print("记录模型图结构到TensorBoard...")
    dummy_input = torch.randn(1, 3, 32, 32).to(device)
    writer.add_graph(trained_model, dummy_input)

    # 记录超参数
    print("记录超参数到TensorBoard...")
    writer.add_hparams(
        {
            'lr': 0.001,
            'batch_size': 128,
            'epochs': 30,
            'unfreeze_epoch': 5,
            'weight_decay': 1e-4
        },
        {
            'best_accuracy': best_acc,
            'final_train_acc': 0,  # 这里可以记录实际的训练准确率
            'final_test_acc': 0    # 这里可以记录实际的测试准确率
        }
    )

    # 关闭TensorBoard写入器
    writer.close()

    print(f"\nTensorBoard日志保存在: {log_dir}")
    print("在终端运行以下命令查看结果:")
    print(f"tensorboard --logdir={log_dir}")
    print("\n或者指定端口:")
    print(f"tensorboard --logdir={log_dir} --port=6006")

    # 加载最佳模型并测试
    print("\n加载最佳模型进行最终测试...")
    checkpoint = torch.load('best_resnet18_cifar10.pth')
    trained_model.load_state_dict(checkpoint['model_state_dict'])

    # 最终测试
    test_loss, test_acc = test_epoch(
        trained_model, test_loader,
        nn.CrossEntropyLoss(), 0, device
    )
    print(f"最佳模型测试准确率: {test_acc:.2f}%")