一、NLP 概念
自然语言处理(NLP)是人工智能的重要分支,核心目标是让计算机理解、解释和生成人类自然语言,实现人机无缝交流。它融合计算机科学、语言学、人工智能、心理学等多学科知识,既能处理语言表层结构(如文字切割),也需理解深层含义(如语义、情感、文化背景)。
当前 NLP 借助深度学习实现显著突破,部分任务性能接近人类水平,但仍面临歧义处理、抽象概念理解、隐喻 / 讽刺识别等挑战,需通过更优算法、更大规模数据集持续优化。
二、NLP 发展历程
NLP 发展以 "技术驱动" 为核心,历经三次关键阶段,从 "规则依赖" 逐步走向 "数据智能":
2.1 早期探索阶段(1940 年代 - 1960 年代)
- 核心技术:基于人工编写的规则和字典,如依赖词典查找、简单词序规则处理语言。
- 关键事件:1950 年图灵测试提出(判断机器是否具备类人智能)、乔姆斯基生成语法理论(为语言结构分析提供基础)。
- 局限:机器翻译等任务效果差,无法应对复杂语言场景
2.2 符号主义与统计方法阶段(1970 年代 - 1990 年代)
- 技术分野:符号主义延续 "规则驱动",聚焦形式语言和语法;统计方法兴起,通过统计语料中词汇 / 短语的出现概率建模语言。
- 关键转折:1980 年代计算能力提升 + 机器学习算法引入,统计模型逐渐取代人工规则,解决部分复杂场景问题。
2.3 机器学习与深度学习阶段(2000 年代至今)
- 核心技术:深度学习模型(RNN、LSTM、注意力机制)普及,预训练模型成为主流。
- 关键突破:2013 年 Word2Vec(优化词向量表示)、2018 年 BERT(预训练语言模型新浪潮)、GPT 系列(大参数模型实现高质量文本生成)。
- 成果:多任务性能大幅提升,推动 NLP 进入工业化应用(如智能客服、自动翻译)。
三、NLP 核心任务
NLP 核心任务覆盖 "文本预处理→语义理解→内容生成" 全流程,每项任务均为下游应用的基础:
|------|--------------------------------------------|-----------------------------------------------------------------|
| 任务名称 | 核心目标 | 简单示例 |
| 中文分词 | 将无空格分隔的中文文本,切分为有意义的词汇序列(中文 NLP 首要步骤) | 输入 "今天天气真好"→输出 "今天", "天气", "真", "好" |
| 子词切分 | 将词汇拆分为更小的子词单位,解决罕见词 / 新词处理问题 | 输入 "unhappiness"→BPE 算法输出 "un", "happi", "ness" |
| 词性标注 | 为分词后的每个词汇分配词性标签(如名词、动词),辅助理解词汇功能 | 输入 "She is playing"→输出 She (代词), is (动词), playing (动词现在分词) |
| 文本分类 | 将文本自动分配到预定义类别,实现信息归类 | 输入 "NBA 季后赛下周开赛"→归类为 "体育" |
| 实体识别 | 从文本中识别特定意义实体(人名、地名、日期等)并分类 | 输入 "李雷 2024 年去上海"→输出 ("李雷", 人名), ("2024 年", 日期), ("上海", 地名) |
| 关系抽取 | 识别文本中实体间的语义关系(如创始人、所属地) | 输入 "比尔・盖茨是微软创始人"→输出 ("比尔・盖茨", "创始人", "微软") |
| 文本摘要 | 生成简洁准确的文本概括,分 "抽取式(选原文关键句)" 和 "生成式(改写新内容)" | 输入火星探测器着陆新闻→生成式摘要:"天问一号成功火星着陆,我国深空探测获突破" |
| 机器翻译 | 将源语言文本自动转换为目标语言,保持语义和流畅度 | 输入 "今天天气很好"→输出 "The weather is very nice today" |
| 自动问答 | 理解自然语言问题,从数据源(文本、知识库)中返回准确答案 | 问题 "天问一号着陆时间"→答案 "2021 年 5 月 22 日" |
四、文本表示方法
4.1 核心概念
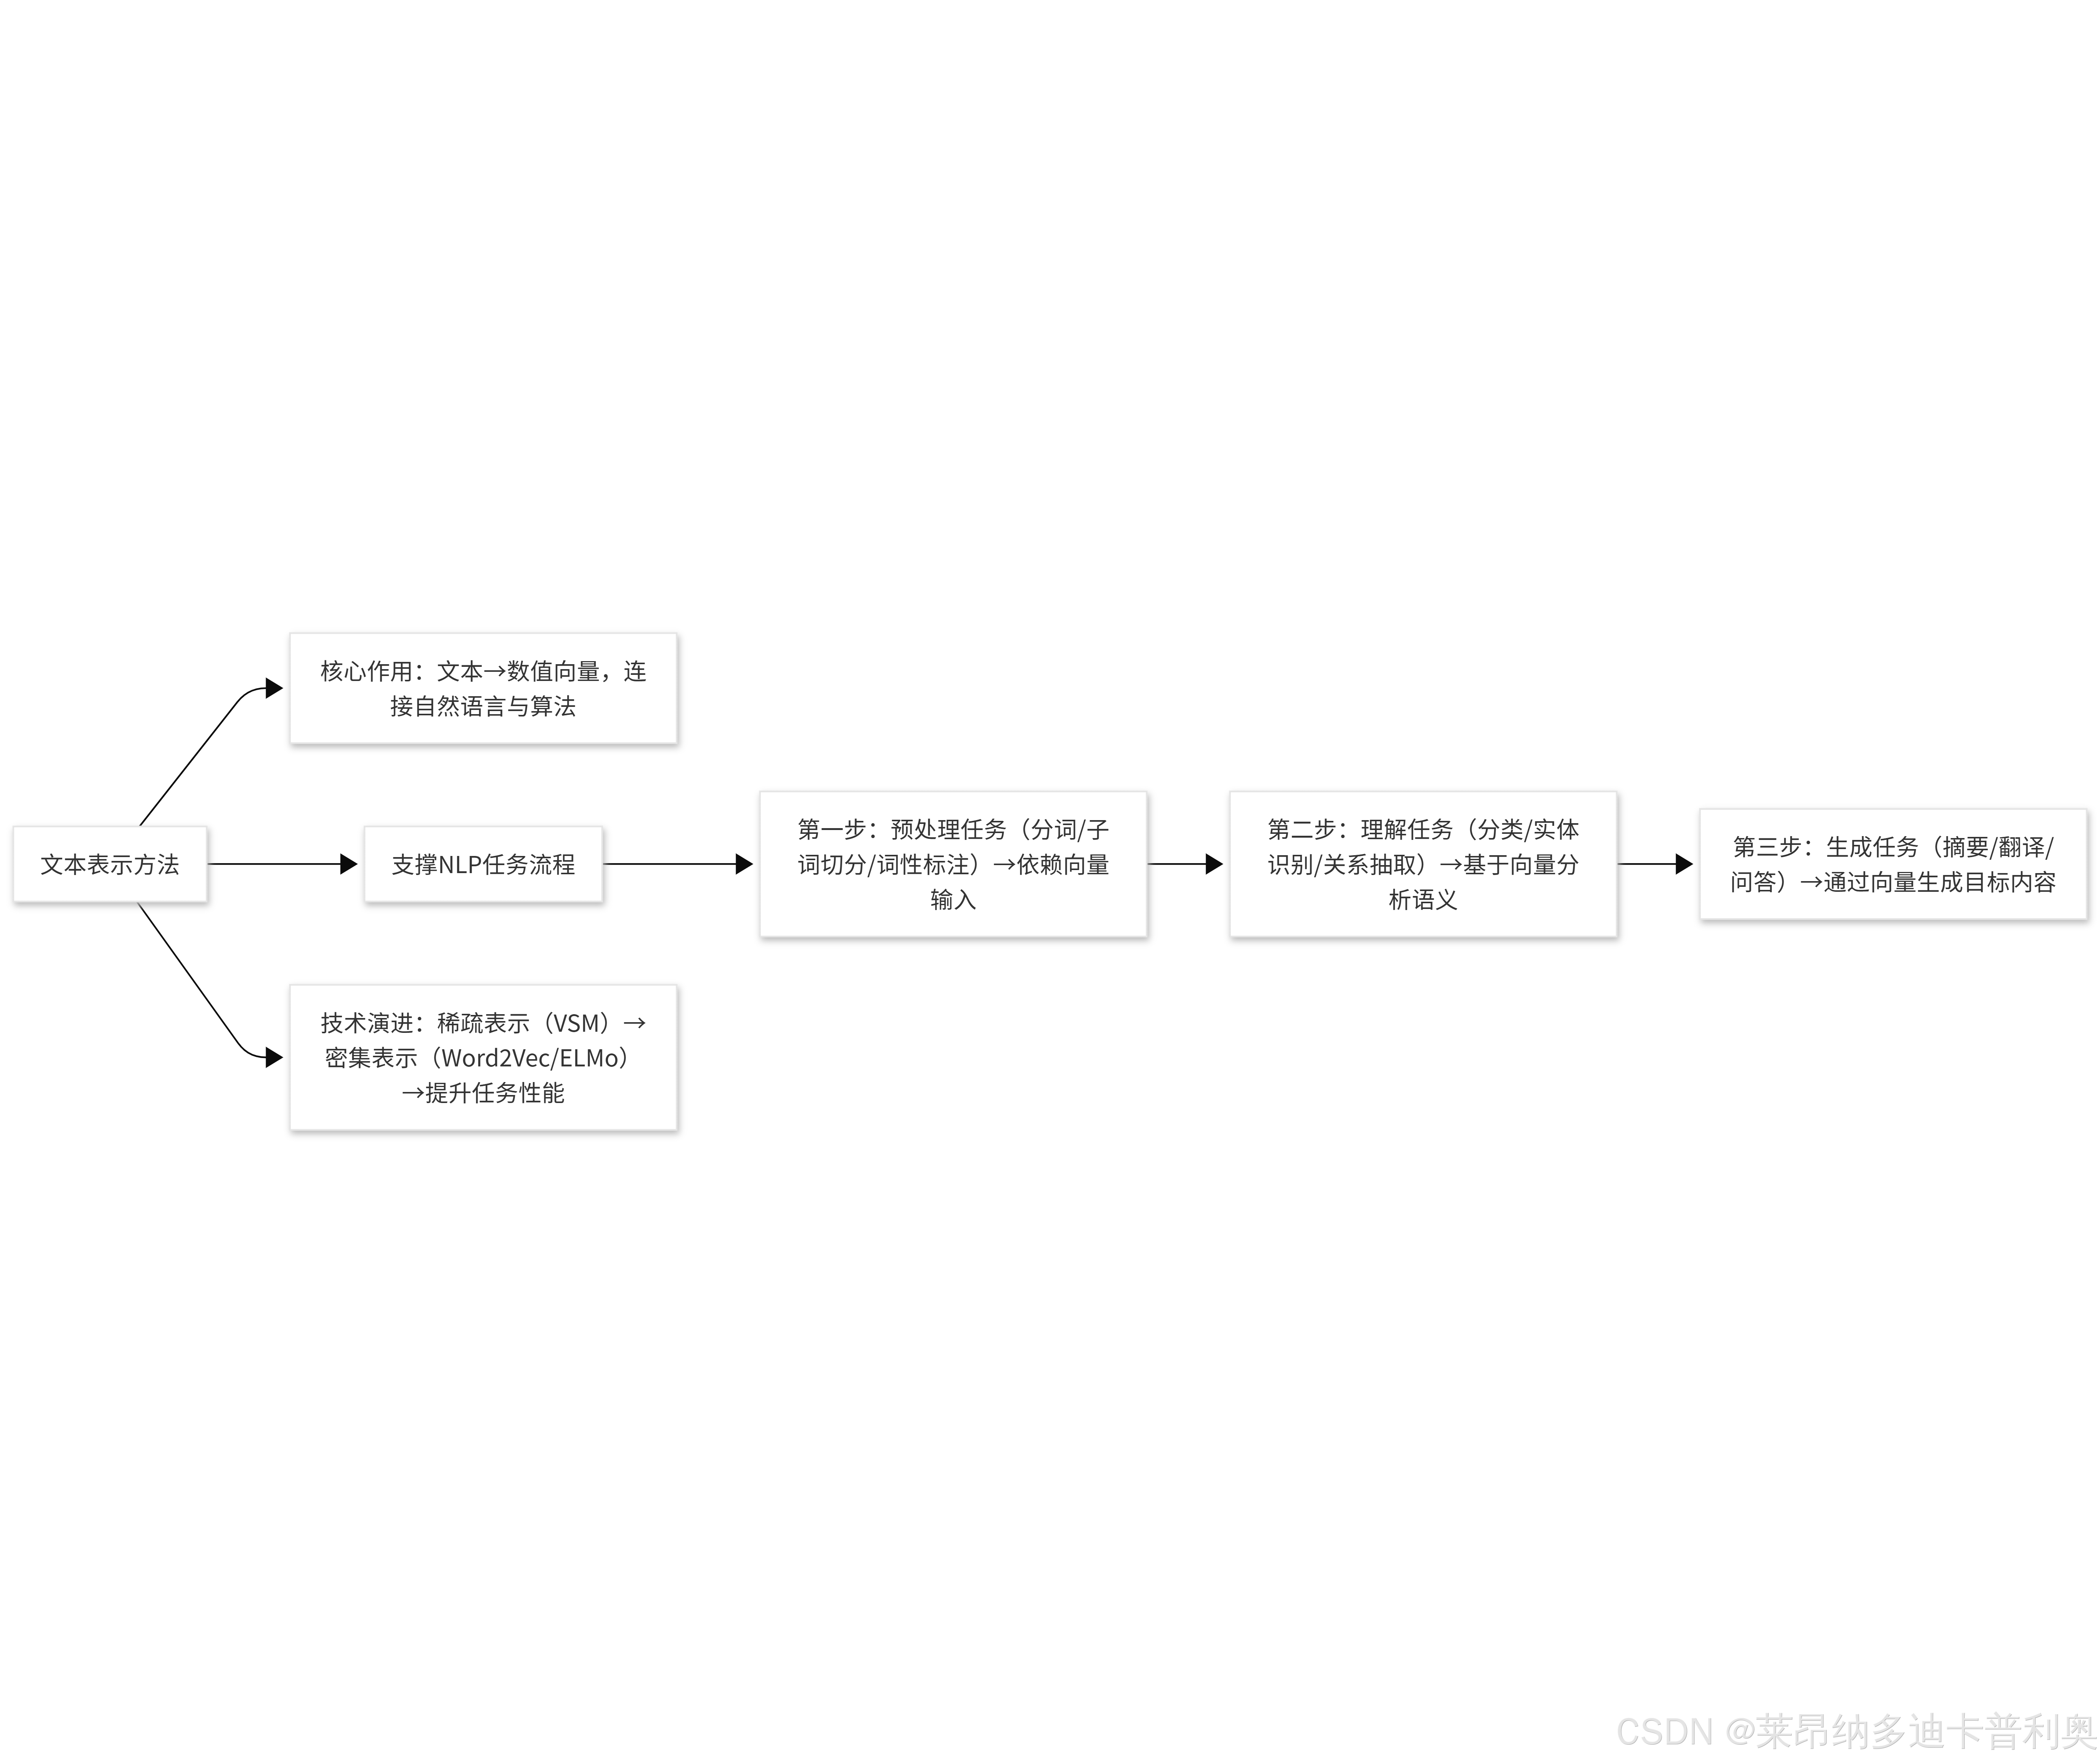
文本表示方法是将人类可读的自然语言文本 ,转换为计算机可处理的数值形式(如向量、矩阵) 的技术,也称为 "词嵌入" 或 "文本向量化"。
4.2 核心作用
计算机无法直接理解文字符号,文本表示是连接自然语言与计算机算法的桥梁------ 只有将文本数字化,后续的分类、翻译、问答等 NLP 任务才能有效开展,其表示效果直接决定 NLP 系统的性能。
4.3 与 NLP 的关系
文本表示是所有 NLP 任务的前置基础:无合理的文本向量,NLP 任务无法落地;更优的文本表示(如从稀疏向量到密集向量),能显著提升 NLP 任务的准确率和效率(例:Word2Vec 相比传统向量空间模型,更能捕捉语义关系)。
4.4 主流方法
|-----------|--------------------------------------------|---------------------|------------------------|
| 方法名称 | 核心思路 | 优点 | 局限 |
| 向量空间模型 | 基于 "词袋思想",将文本转为高维向量,用 TF/TF-IDF 计算词汇权重 | 简单易实现,适用于相似度计算、信息检索 | 稀疏性严重(多数维度为 0)、忽略词序和语义 |
| N-gram 模型 | 基于马尔可夫假设,用连续 N 个词的概率预测当前词,捕捉局部词汇搭配 | 实现简单,在语音识别、拼写纠错中实用 | N 增大时参数爆炸、无法捕捉长距离依赖 |
| Word2Vec | 基于神经网络,通过上下文学习生成低维密集向量,语义相似词向量距离近 | 维度低、计算快,能泛化到未见过的词 | 依赖局部上下文,无法处理多义性 |
| ELMo | 基于双向 LSTM 的预训练模型,生成 "动态词向量"(同一词在不同语境有不同向量) | 解决多义性,捕捉上下文语义 | 模型复杂、训练耗时长、计算资源需求高 |