Unity中使用LLMUnity遇到的问题(一)

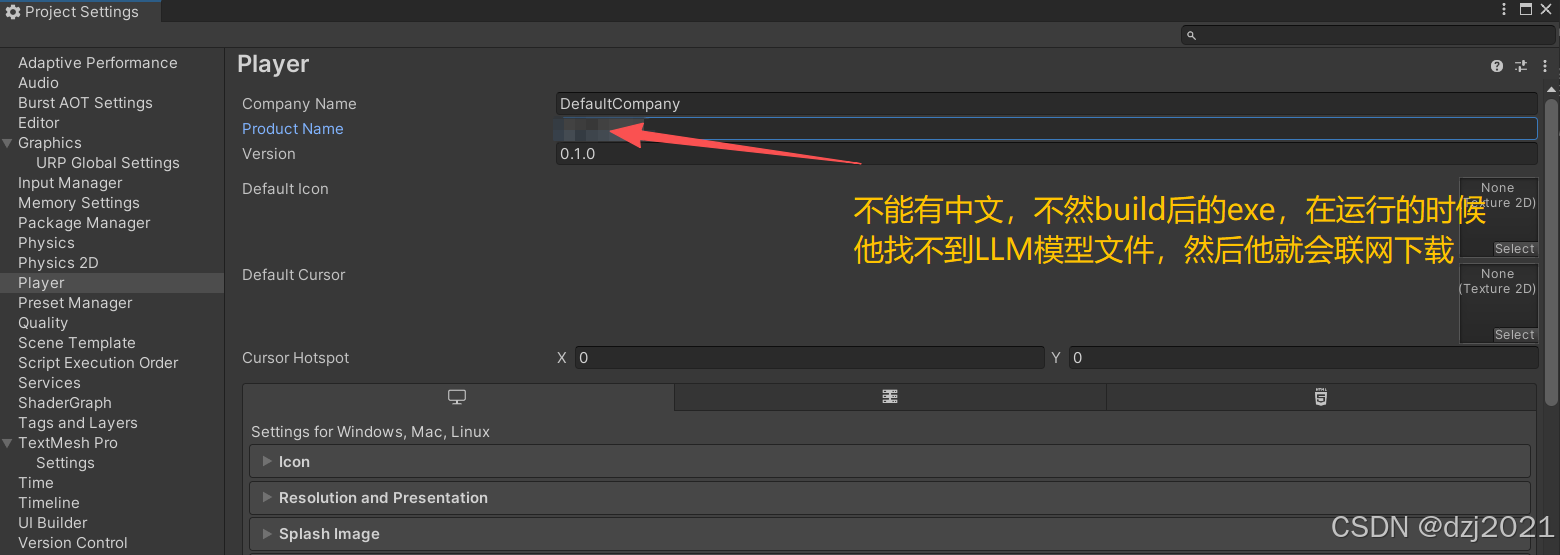
一、工程文件中已经指定了模型文件,发布运行后仍然联网下载大模型文件

1、原因:Product name包含中文名,改成全英文后正常了。
2、模型配置参考

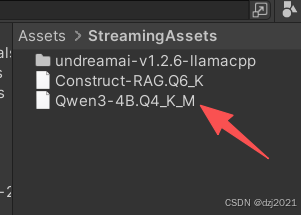
  • (1)模型文件的位置:如下所示,把模型文件拷贝到StreamingAssets根目录
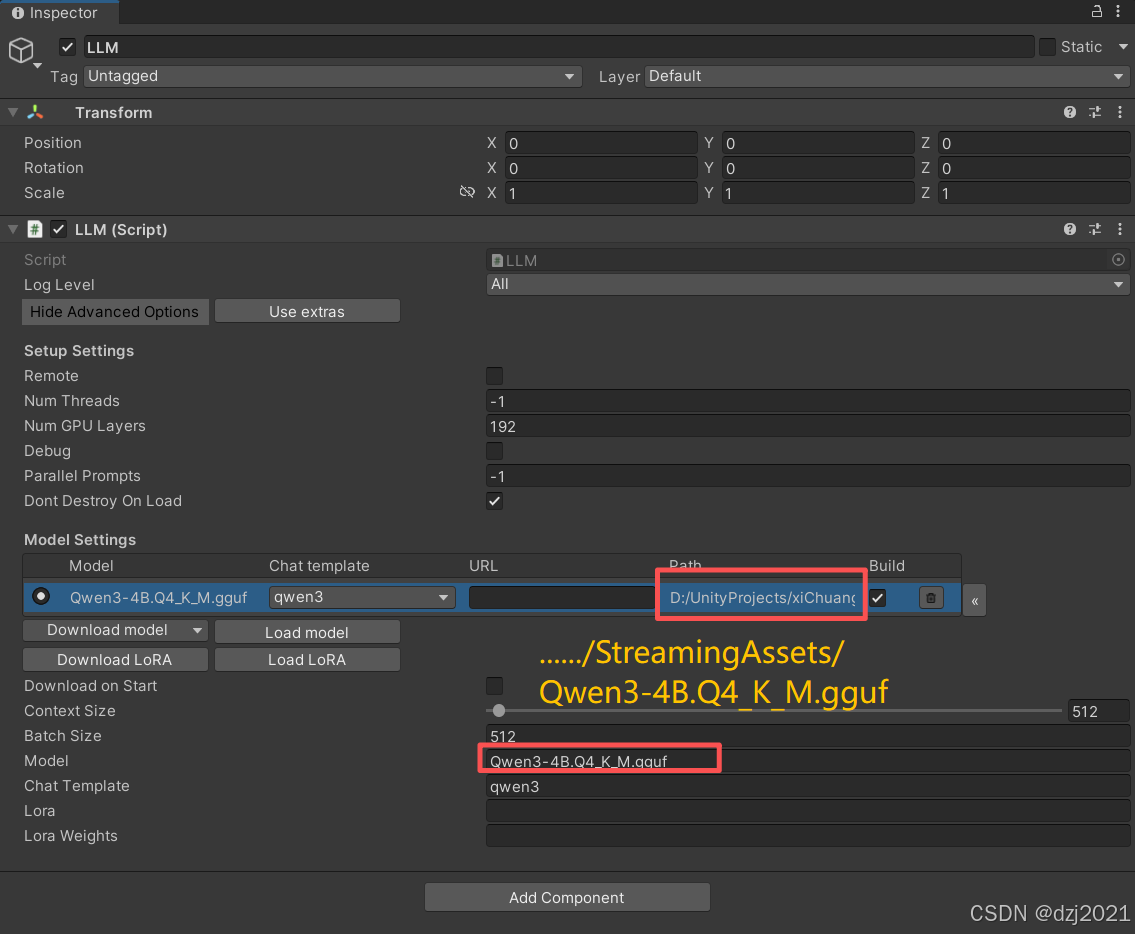
    -(2)模型关联设置
    通过LoadModel按钮,把模型指定到StreamingAssets下的gguf模型文件
二、如何让LLM使用GPU而不是全部依赖CPU

1、修改LLM脚本的配置参数

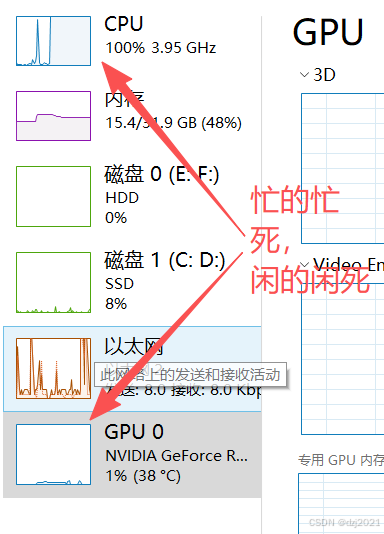
设置Num GPU Layers参数的值,官方说-1代表全用GPU,实测后发现设置成-1时,CPU满载,GPU貌似没有忙碌。
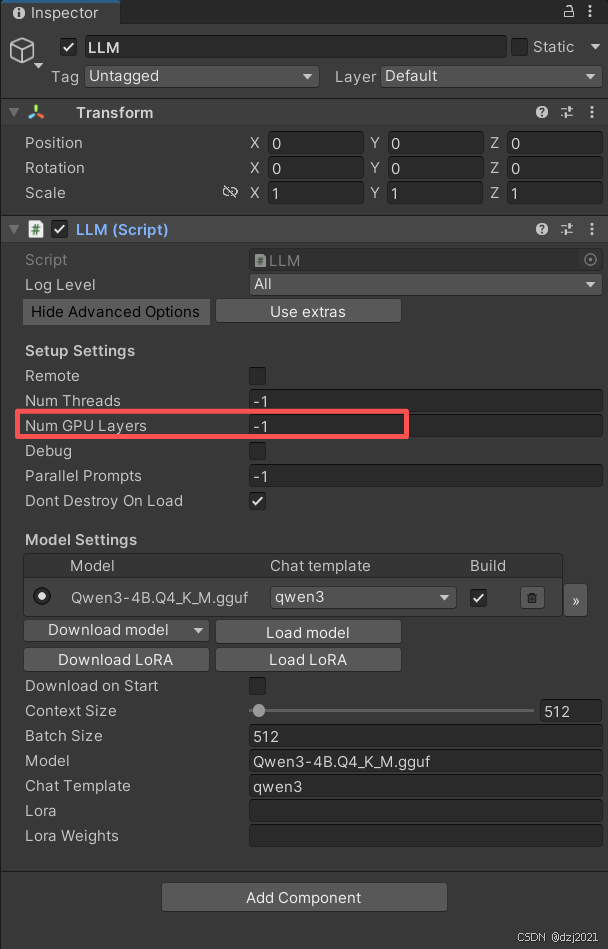
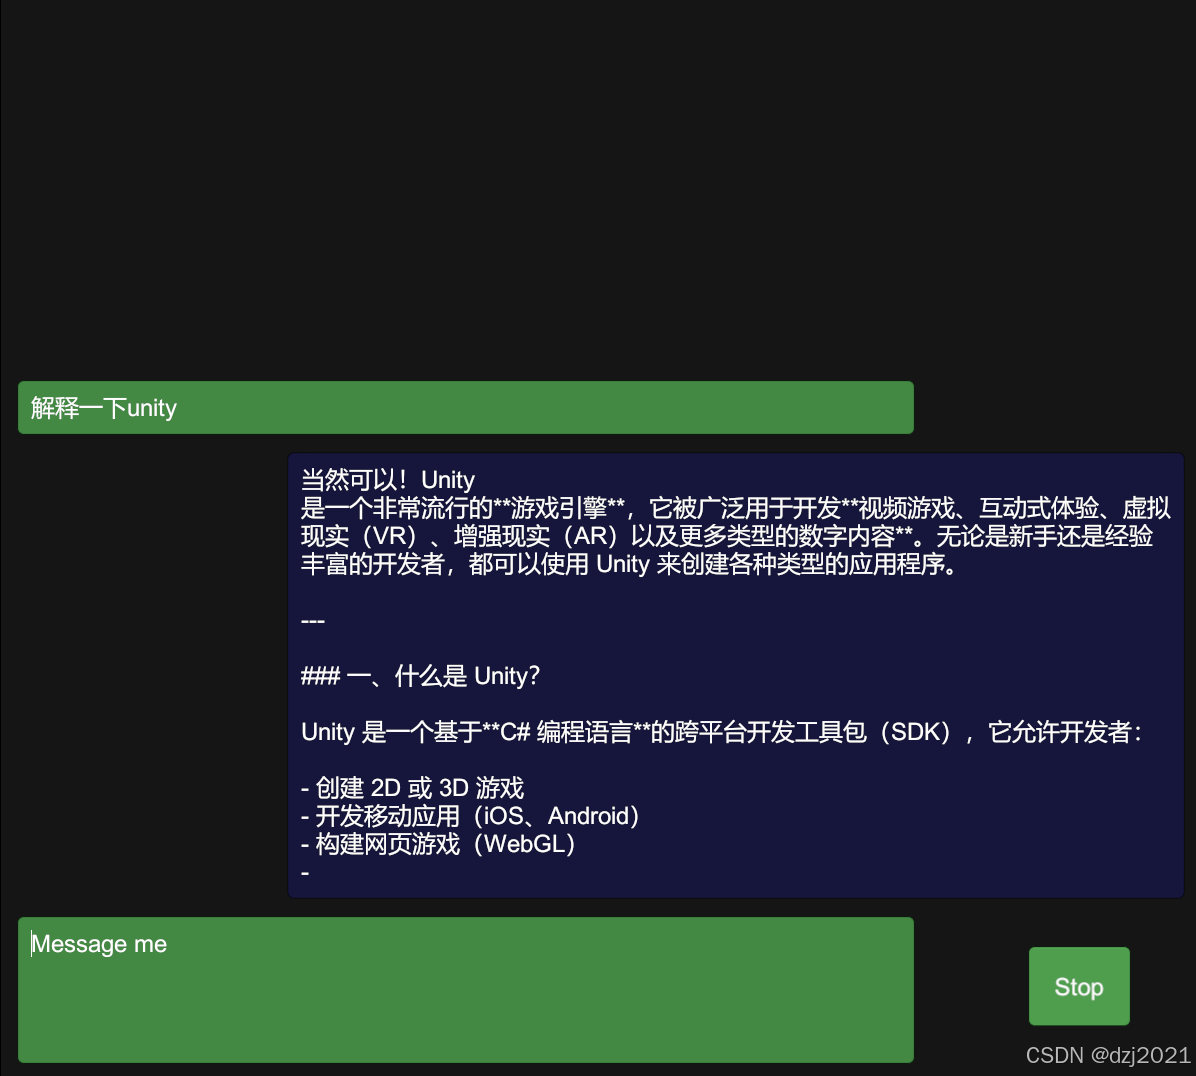
(1)Num GPU Layers = -1 时的实测

  • 回答的时候,吐文本速度慢,像个七老八十的老倌吃饭的样子
  • 查看CPU和GPU,发现CPU哼哧哼哧的满载,GPU则是清闲无比

(2)你可以设置【Num GPU Layers】 = 2-4-6-16-32-64-128然后测试

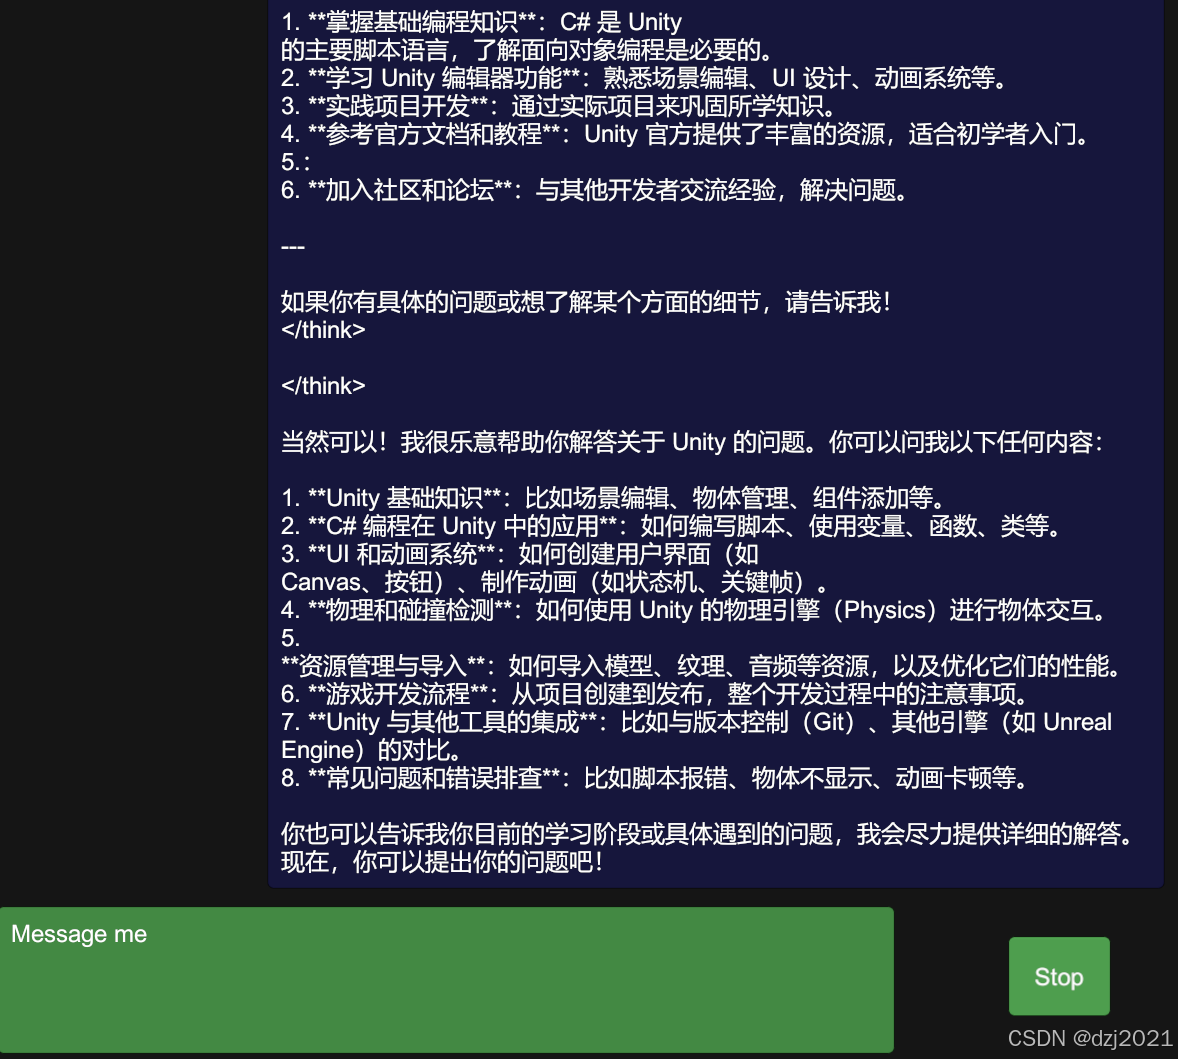
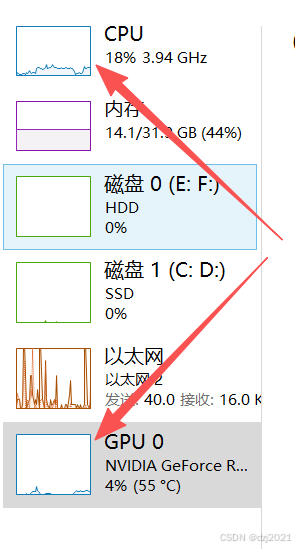
我这里直接设置 Num GPU Layers = 1024

  • 我让它介绍一下Unity,吐文本的速度确实非常快
  • CPU占用明显下降,GPU的话,只是抖动一下,峰值也就是4%

三、附录

1、LLMUnity在哪里?

https://github.com/undreamai/LLMUnity
相关推荐
goehou13 小时前
MCP 查数实战:让 LLM 安全地查数据库(只读账号、SQL 校验、参数漂移)
数据库·ai·llm·教程·mcp·function calling
桃西西呀17 小时前
LangGraph4j之一:客服请求分诊既要循环又要分流,我用 LangGraph4j 把控制流抽成了数据
人工智能·llm·ai编程
流浪打工人17 小时前
Unity3d TimeLine中audio track的使用
unity
用户7217465882619 小时前
默认校验只覆盖 3.18%:bl dataset validate 抽样窗与 capability 三种返回态的字段级拆解
llm·agent·ai编程
程序员大狐狸20 小时前
Ultra X7 358H 笔记本电脑,寻找本地用于编码的最强大模型,实测 21.0 tok/s,上下文 256K
llm·ai编程
用户83145509803120 小时前
如一 Agent 架构解读(四):异步整理——压缩不该堵住用户
人工智能·llm
feasibility.20 小时前
“美版DeepSeek”等海外开放模型,能夺回生态入口吗?——中国开放权重领先下的2026全球AI分水岭
人工智能·开源·大模型·llm·minimax·deepseek·beam
淡海水20 小时前
02-07-原理篇-GC暂停时间的本质
开发语言·unity·c#·gc·暂停时间
WarPigs20 小时前
UI路径配置SO>字典json工作流
ui·unity
M--Y1 天前
LangChain 提示工程:少样本提示与输出解析器
python·langchain·大模型·llm·输出解析器·少样本提示