使用 Chainlit + Ollama 快速搭建本地 AI 聊天应用
大家好!今天分享一个超级简单的本地 AI 聊天界面实现方案:Chainlit + Ollama 。
无需部署复杂的后端,只需本地运行 Ollama,再用几行 Python 代码,就能拥有一个支持模型切换、流式输出的美观聊天界面。
效果如下(实际运行时会实时流式显示回复):
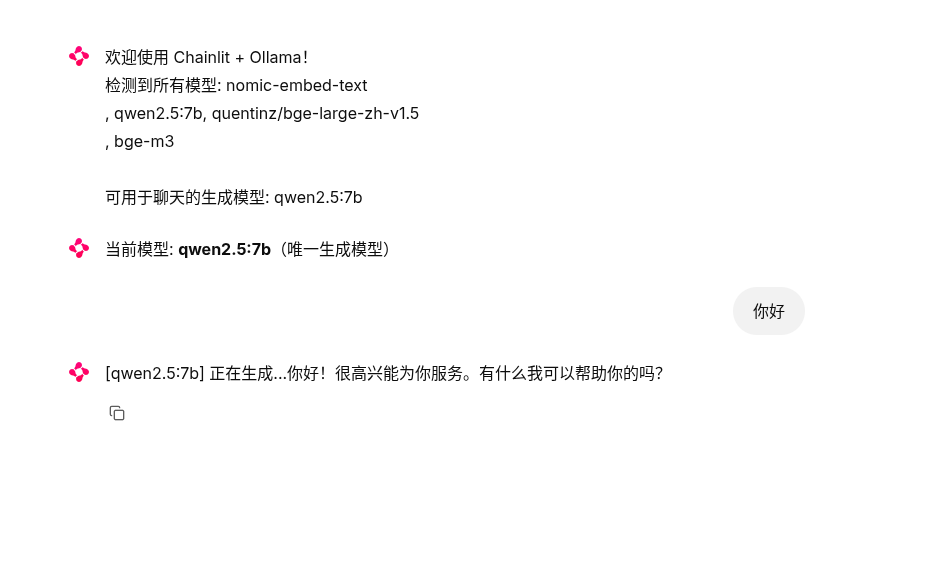
- 支持检测本地所有 Ollama 模型
- 自动过滤出生成型模型用于聊天
- 支持一键切换模型
- 流式输出,体验接近 ChatGPT
下面一步步教大家从零开始搭建。
一、环境准备
1. 安装 Ollama
前往官网下载并安装 Ollama:
安装完成后,打开终端运行:
bash
ollama --version看到版本号即表示安装成功。
2. 拉取模型(必须)
Ollama 默认没有模型,需要手动拉取。我们推荐以下生成型模型(任选其一即可):
bash
# 推荐中文能力强的模型
ollama pull qwen2.5          # 阿里通义千问 2.5,中文极强
ollama pull qwen2.5:7b       # 更小更快版本

# 或者经典的 Llama3
ollama pull llama3
ollama pull llama3:8b

# 其他可选
ollama pull gemma2
ollama pull phi3
拉取完成后运行 ollama list 查看已安装模型。
3. 安装 Python 依赖
创建一个新文件夹(如 ollama-chainlit),进入文件夹后执行:
bash
pip install chainlit httpx这是本项目所需的所有第三方库,非常轻量。
二、完整代码
将以下代码保存为 app.py(文件名随意,但后缀必须是 .py):
python
import chainlit as cl
import httpx
import json

# 同步获取 Ollama 模型列表
def get_ollama_models():
    try:
        with httpx.Client(timeout=10.0) as client:
            response = client.get("http://localhost:11434/api/tags")
            response.raise_for_status()
            data = response.json()
            return [m["name"] for m in data["models"]]
    except Exception as e:
        print(f"获取模型列表失败: {e}")
        return []

OLLAMA_MODELS = get_ollama_models()

# 过滤生成模型(排除常见的 embedding 模型)
GENERATIVE_MODELS = [
    m for m in OLLAMA_MODELS
    if "embed" not in m.lower() and "bge" not in m.lower()
]

if not GENERATIVE_MODELS:
    print("警告:未检测到生成模型,请拉取如 ollama pull qwen2.5 或 ollama pull llama3")
    DEFAULT_MODEL = "llama3"  # fallback
else:
    DEFAULT_MODEL = GENERATIVE_MODELS[0]

# Ollama 流式生成
async def ollama_chat_stream(model: str, messages: list):
    payload = {
        "model": model,
        "messages": messages,
        "stream": True
    }

    async with httpx.AsyncClient(timeout=None) as client:
        try:
            async with client.stream("POST", "http://localhost:11434/api/chat", json=payload) as response:
                async for line in response.aiter_lines():
                    if not line.strip():
                        continue
                    data = json.loads(line)
                    if "message" in data and "content" in data["message"]:
                        yield data["message"]["content"]
                    if data.get("done"):
                        break
        except Exception as e:
            yield f"\n\n[错误: 调用 Ollama 失败 - {str(e)}]"

# Chainlit 应用
@cl.on_chat_start
async def on_chat_start():
    all_models_info = ', '.join(OLLAMA_MODELS) if OLLAMA_MODELS else "无"
    gen_models_info = ', '.join(GENERATIVE_MODELS) if GENERATIVE_MODELS else "无(请拉取生成模型,如 qwen2.5、llama3 等)"

    await cl.Message(
        content=f"欢迎使用 Chainlit + Ollama!\n"
                f"检测到所有模型: {all_models_info}\n"
                f"可用于聊天的生成模型: {gen_models_info}"
    ).send()

    if not GENERATIVE_MODELS:
        await cl.Message(content="提示:当前只有 embedding 模型,无法正常聊天。请运行 `ollama pull qwen2.5` 或其他生成模型后重启。").send()
        return

    cl.user_session.set("current_model", DEFAULT_MODEL)

    if len(GENERATIVE_MODELS) > 1:
        actions = [
            cl.Action(
                name="model_select",
                value=model,
                label=f"切换到 {model}"
            ) for model in GENERATIVE_MODELS
        ]
        await cl.Message(
            content=f"当前模型: **{DEFAULT_MODEL}**\n选择其他模型:",
            actions=actions
        ).send()
    else:
        await cl.Message(content=f"当前模型: **{DEFAULT_MODEL}**(唯一生成模型)").send()

@cl.action_callback("model_select")
async def on_model_select(action: cl.Action):
    new_model = action.value
    cl.user_session.set("current_model", new_model)
    await cl.Message(content=f"模型已切换为: **{new_model}**").send()

@cl.on_message
async def on_message(message: cl.Message):
    if not GENERATIVE_MODELS:
        await cl.Message(content="未检测到生成模型,无法回复。").send()
        return

    model_name = cl.user_session.get("current_model", DEFAULT_MODEL)

    messages = cl.user_session.get("messages", [])
    messages.append({"role": "user", "content": message.content})

    # 创建流式消息
    response_msg = cl.Message(content="")
    await response_msg.send()

    # 显示正在生成提示
    response_msg.content = f"[{model_name}] 正在生成..."
    await response_msg.update()

    # 流式输出
    full_response = ""
    async for token in ollama_chat_stream(model_name, messages):
        full_response += token
        await response_msg.stream_token(token)

    # 保存历史
    messages.append({"role": "assistant", "content": full_response})
    cl.user_session.set("messages", messages)

    # 最终更新
    await response_msg.update()
三、运行项目
确保 Ollama 服务正在运行(安装后一般会自动启动,如果没有可以手动运行 ollama serve)。
在代码所在目录打开终端,执行:
bash
chainlit run app.py -w-w 参数表示自动刷新浏览器,开发时很方便。
运行成功后,浏览器会自动打开 http://localhost:8000,你将看到欢迎界面和模型列表。
点击右侧的模型按钮即可切换,输入问题开始聊天!
四、常见问题
-
模型切换按钮不显示?
只有检测到多个生成模型时才会显示切换按钮。如果只有一个模型,会直接显示"唯一生成模型"。
-
提示"正在生成..."一直不消失?
检查 Ollama 是否正常运行,模型是否拉取成功。可以在终端运行
ollama list确认。 -
想去掉"正在生成..."提示?
可以修改
on_message函数最后部分,把注释掉的代码取消:pythonresponse_msg.content = f"[{model_name}]\n\n{full_response}" await response_msg.update()这样最终只会显示模型名 + 回复内容。
五、总结
整个项目只有不到 100 行代码,却实现了:
- 自动检测本地模型
- 模型切换
- 流式输出
- 聊天历史保持
非常适合本地玩大模型、快速搭建私人助手、学习 Chainlit 框架。
喜欢的话别忘了点赞 + 收藏 + 关注 三连哦~
有问题欢迎在评论区留言,我会尽快回复!