机器学习-带正则化的成本函数-

在上一节介绍了如何防止模型过拟合,现在就详细的讲一讲其中的一个办法,正则化今天就详细的讲一下

从之前的数据集图象(房价预测)
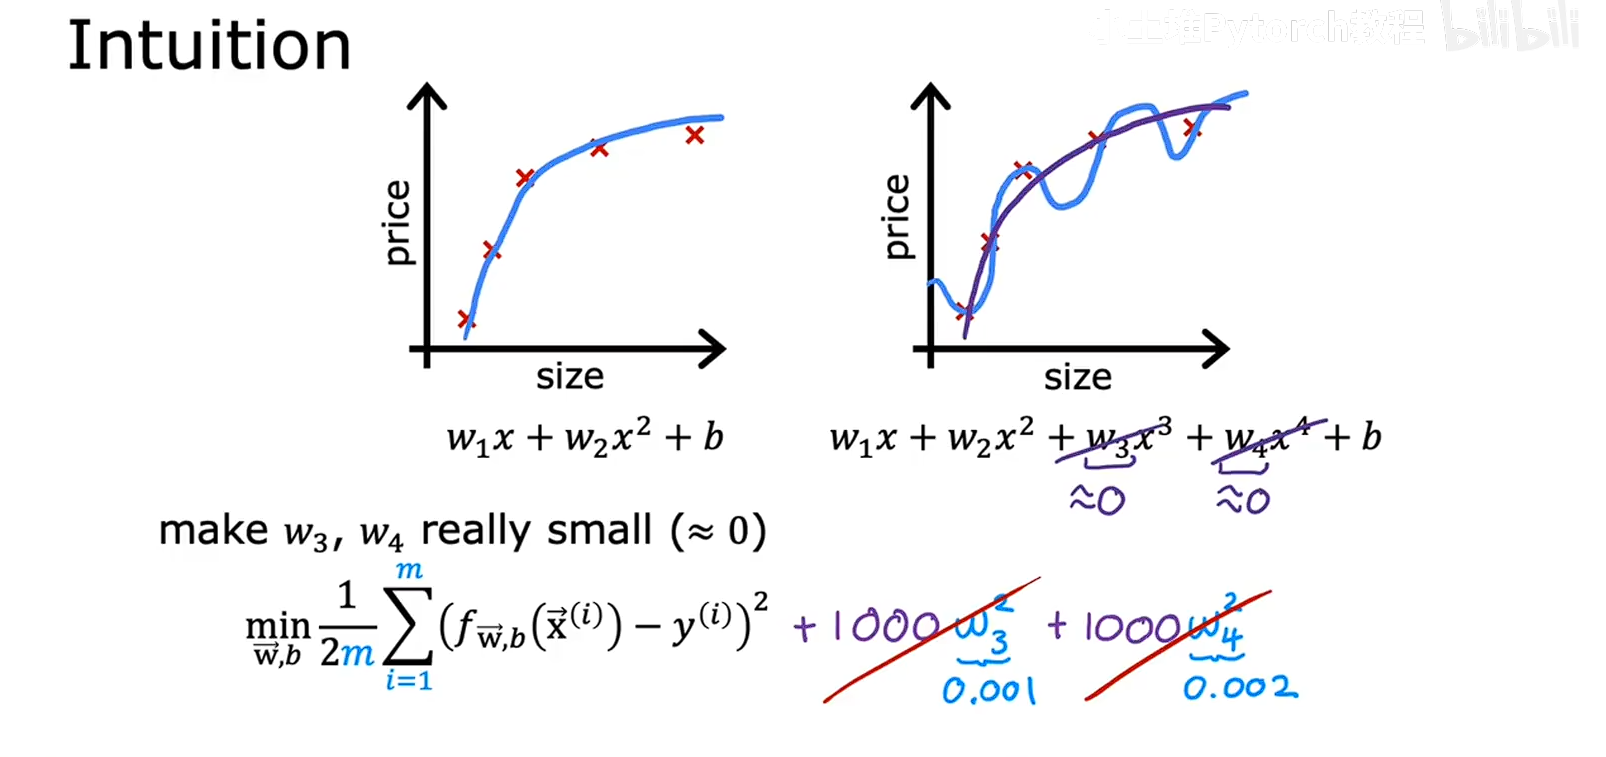
在模型中我们想要防止过拟合,正则化就是对模型的变量的W进行约束,防止过于敏感,防止对模型影响过大,而且w的参数越大,这一项因子的影响就越大,就会导致模型的曲线波动的非常的厉害,变成高次函数,如右边的模型数据集。就像给模型的自由度上了一个刹车,不让他为了贴合训练数据,猛打方向,结果在新数据中表现不好
。

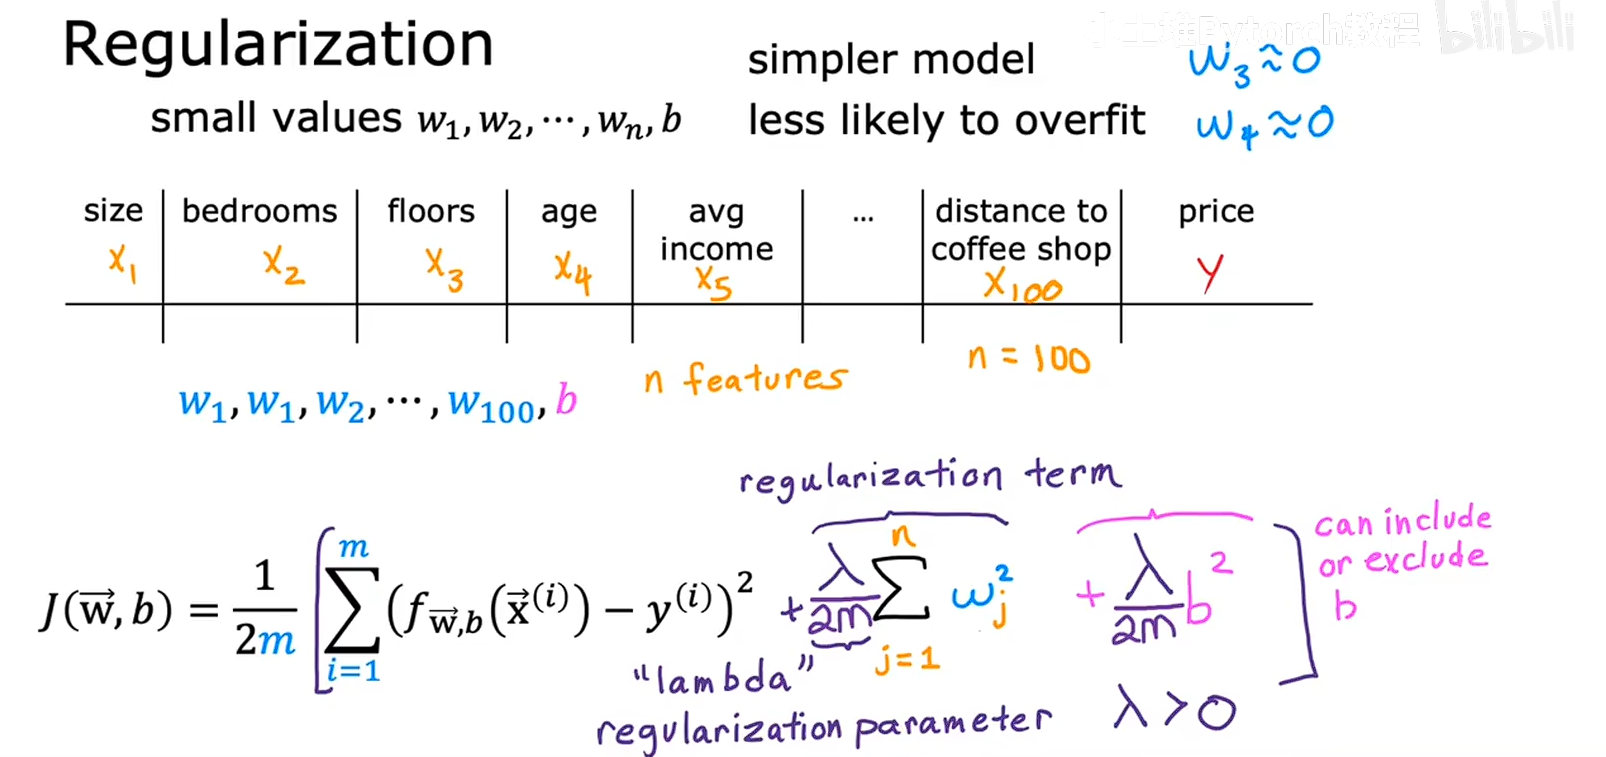
因为我们不知道什么特征是重要的特征,什么特征不重要,所以我们对所有参数进行惩罚,但是不对b进行惩罚,对W向量进行惩罚

为了防止参数过大,我们对模型的成本函数进行变化,添参数大小的的影响,当参数过大的时候成本函数就会变大,因为是整体的考虑,计算累加的求和,然后乘以一个参数 lamdba 入 ,

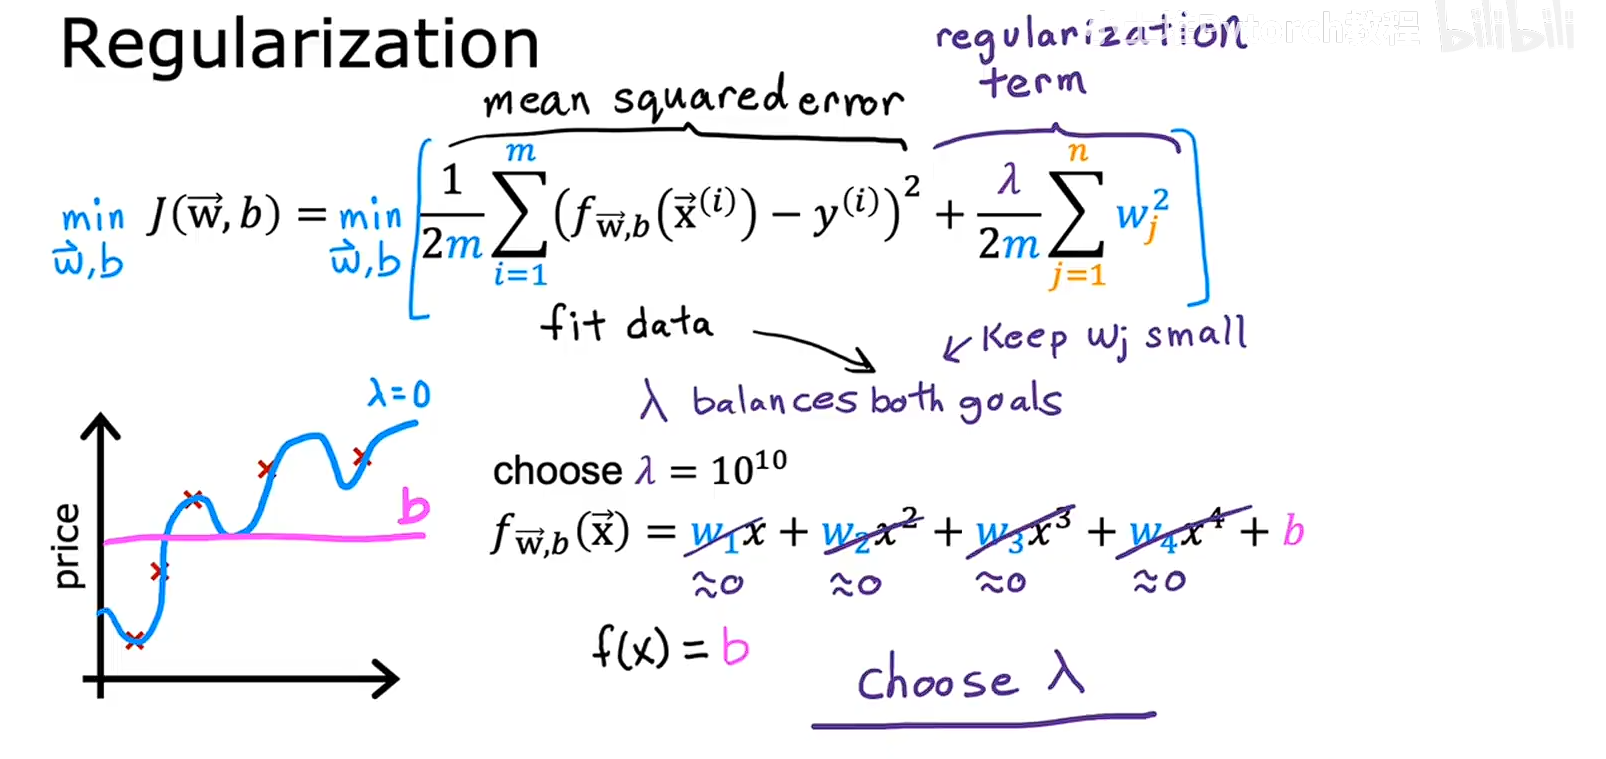
当lamdba等于,或者非常小的时候,实际上就没有进行正则化,或者说惩罚力度非常小,容易过拟合,

当lamdba过大的时候,惩罚力度很大,成本函数为了最小化成本,会将参数压得非常小,相当于忽略了特征,数据就会变成一条直线这条曲线会趋近于b,数据会欠拟合,
相关推荐
用户8356290780518 分钟前
使用 Python 对 Excel 工作表进行排序
后端·python
yumgpkpm9 分钟前
Acceldata ODP(Open Data Platform)3.3.6.4(RHEL9)保姆级完整安装手册
大数据·人工智能·hive·hadoop·kafka·hbase·cloudera
邓工说电22 分钟前
智慧断路器安全吗?数据加密、离线保护与合规认证全解读
大数据·数据库·人工智能·智能断路器·炜晔科技
阿里云大数据AI技术24 分钟前
Lance 数据检索怎么选,当然阿里云 Milvus 向量湖
人工智能
出海客25 分钟前
跨境电商多语言客服知识库怎么建:资料结构、检索边界与人工升级
大数据·人工智能
liliangcsdn30 分钟前
派息率指标的应用探索和分析
大数据·算法
for_ever_love__30 分钟前
MySQL 全文索引实战:FULLTEXT、ngram 中文分词与 MATCH AGAINST 到底该怎么用
java·python·mysql·全文检索·分词·索引·ngram
用户83562907805136 分钟前
使用 Python 合并 PowerPoint 演示文稿
后端·python
xsd2024111842 分钟前
从自主导航到视觉读表:一台工业巡检机器人的全栈技术链路拆解
人工智能
袁哥大话安全1 小时前
巡隐WEBSHELL扫描软件
人工智能·安全·web