MapReduce概述
MapReduce是一个分布式运算程序的框架重要组成部分,是用户开发"基于Hadoop HDFS的数据分析应用"的核心框架。
MapReduce核心功能是将用户编写的业务逻辑代码和自带默认组件整合成一个完整的分布式运算程序,并行运行在Hadoop集群上。
MapReduce 可以理解为 "大数据界的分工协作流水线" ------ 专门解决 "数据太大,一台机器处理不过来" 的问题,核心思路是 "分而治之,再合并结果"。
- Map(映射) = 拆分任务,并行处理,生成局部结果;
- Reduce(归约) = 汇总局部结果,计算最终答案。
优点
(1)MapReduce易于编程
它简单的实现一些接口(比如Mapper、Reducer等),就可以完成一个分布式程序的开发,分布式程序可以运行在大量廉价的PC机器上。也就是说你写一个分布式程序,跟写一个简单的串行程序是一模一样的。因此使得MapReduce编程变得非常流行。及时对分布式不太了解,也可以开发分布式分析程序。
(2)良好的扩展性
当你的计算资源不够用的时候,你可以通过简单的增加机器来扩展它的计算能力。
(3)高容错性
MapReduce设计的初衷就是使程序能够部署在廉价的PC机器上,这就要求它具有很高的容错性。比如其中一台机器挂了,它可以把上面的计算任务转移到另外一个节点上运行,不至于这个任务运行失败,而且这个过程不需要人工参与,而完全是由Hadoop内部完成的。
(4)适合TB+级别海量数据的离线处理
可以实现数以千计的服务器集群并发工作,提供数据处理能力。
缺点
(1)不擅长实时计算
MapReduce无法像MySQL、Spark、Flink一样,在毫秒或者秒级内返回结果。
(2)不擅长流式计算
流式计算的输入数据是动态的,而MapReduce的输入数据集是静态的,不能动态变化。这是因为MapReduce自身的设计特点决定了数据源必须是静态的。
(3)不擅长DAG(有向无环图)计算
多个应用程序存在依赖关系,后一个应用程序的输入为前一个的输出。在这种情况下,MapReduce并不是不能做,而是使用后,每个MapReduce作业的输出结果都会写入到磁盘,会造成大量的磁盘IO,导致性能非常的低下。
MapReduce工作流程
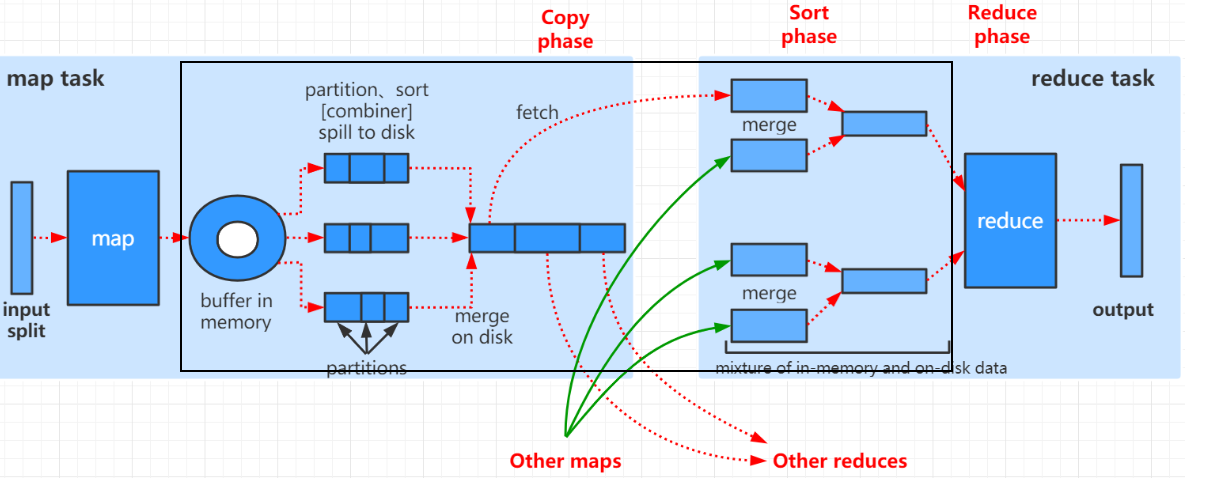
官方给的定义:系统执行排序、将map输出作为输入传给reducer的过程称为Shuffle。通俗来讲,就是从map产生输出开始到reduce消化输入的整个过程称为Shuffle。如下图用黑线框出的部分:
圆形缓冲区介绍:
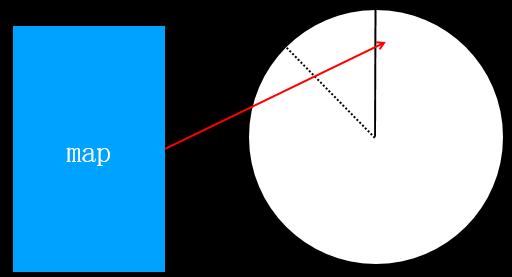
每一个map任务都会有一个圆形缓冲区。默认大小100MB(io.sort.mb属性)阈值0.8也就是80MB(mapreduce.map.sort.spill.percent属性指定) ,
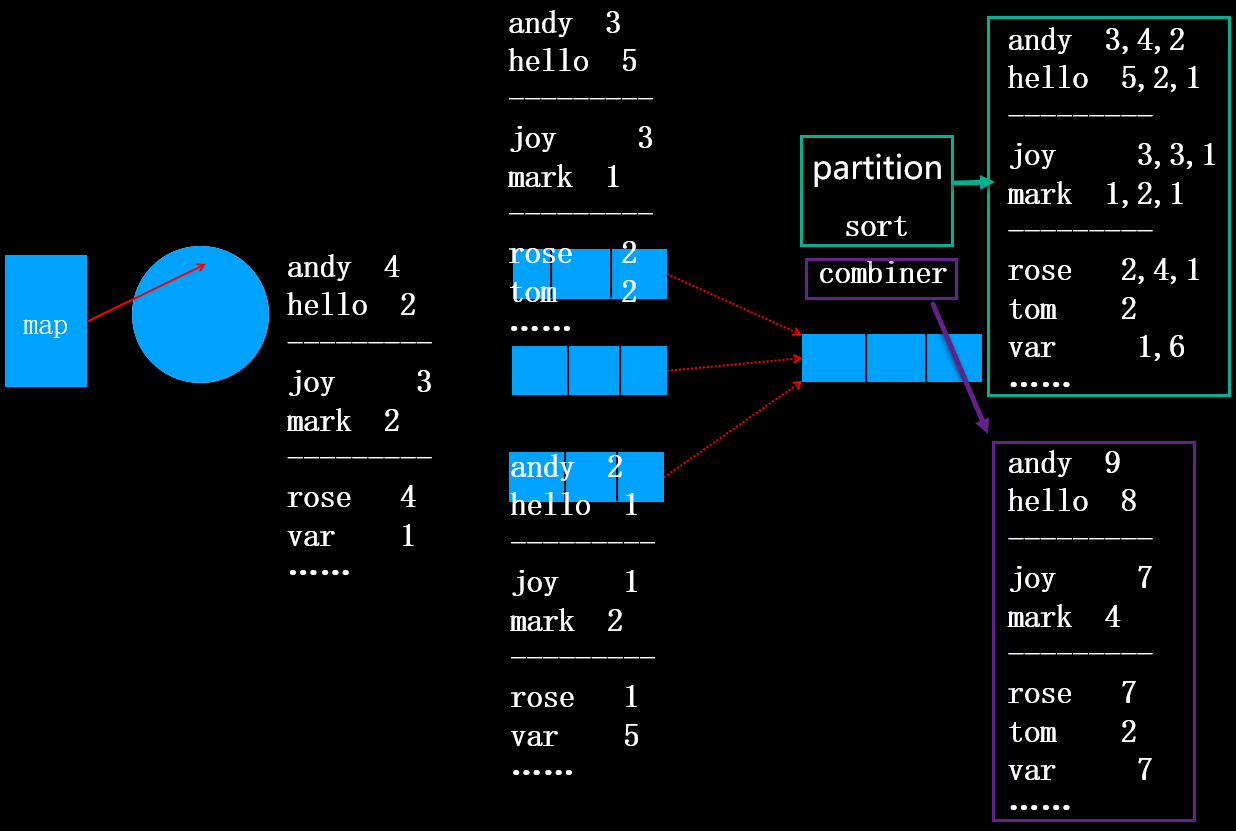
一旦达到阈值一个后台线程开始把内容写到(spill)磁盘的指定目录mapred.local.dir下的新建的一个溢出写文件。写入磁盘前先partition、sort、combiner。一个map task任务可能产生N个磁盘文件。map task运算完之后,产生了N个文件,然后将这些文件merge合成一个文件。 如果N=2,合成的新文件写入磁盘前只经过patition(分区)和sort(排序)过程,不会执行combiner合并(无论是否指定combiner类),如果N>=3,合成的新文件写入磁盘前经过patition(分区)、sort(排序)过和combiner合并(前提是指定了combiner类)。
思考:为什么只有当N>=3时,合成文件才会执行combiner呢?
这是因为如果N<3时,执行combiner虽然减少了文件的大小,但是同时产生了一定的系统开销。由于减少的文件大小不大,权衡利弊后,确定N<2时不在执行combiner操作。当该map task全部执行完之后,对应的reduce task将会拷贝对应分区的数据(该过程称为fetch)。
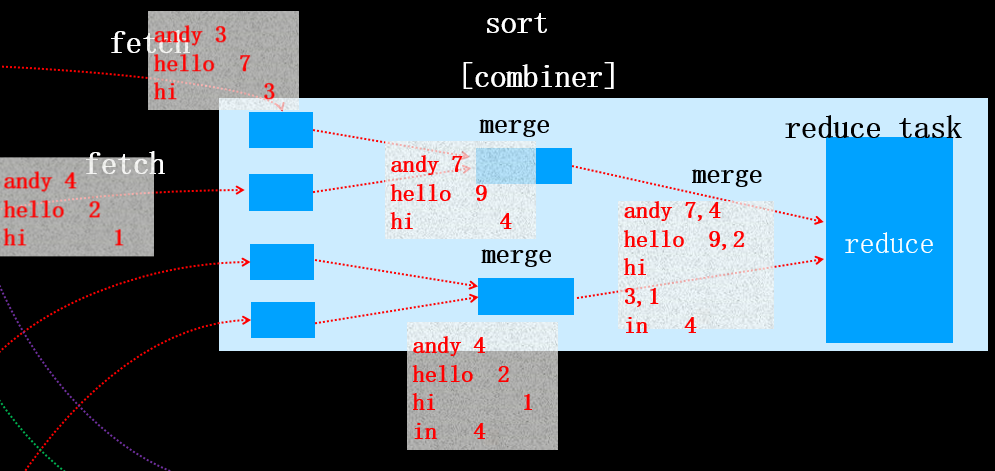
每个map任务的完成时间可能不同,因此只要有一个任务完成,reduce任务就开始复制其输出。该阶段被称为reduce的复制阶段。reduce任务有少量复制线程,因此能够并行取得map输出。默认值是5个线程,但这个默认值可以通过设置mapred.reduce.parallel.copies属性改变。
复制完所有map输出后,reduce任务进入合并阶段,该阶段将合并map输出,并维持其顺序排序(相当于执行了sort),如果指定了combiner,在写入磁盘前还会执行combiner操作。
Wordcount案例理解
接下来通过Wordcount的案例来理解MapReduce的工作流程。
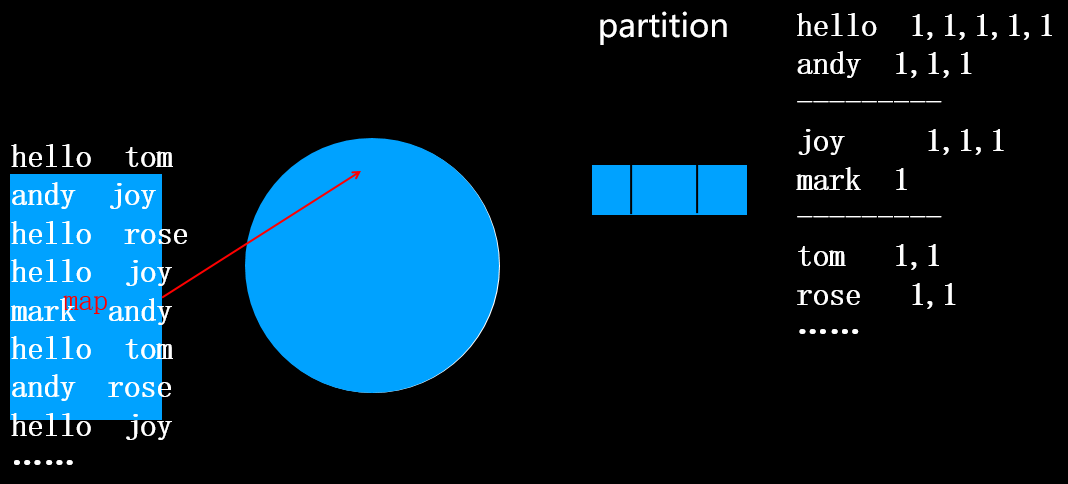
在分区(分区规则:按首字母分四个区,分别为a-i,j-q,r-z,其它)的过程中,会将相同的单词合并到一起,将出现次数用逗号隔开,如上图所示。注意此时还没有排序。
接着执行排序操作,默认排序规则是按照key的字典升序排序,当然你也可以指定排序规则,排序后如下图所示:
接下来执行combiner操作,将每个单词后续的1求和。
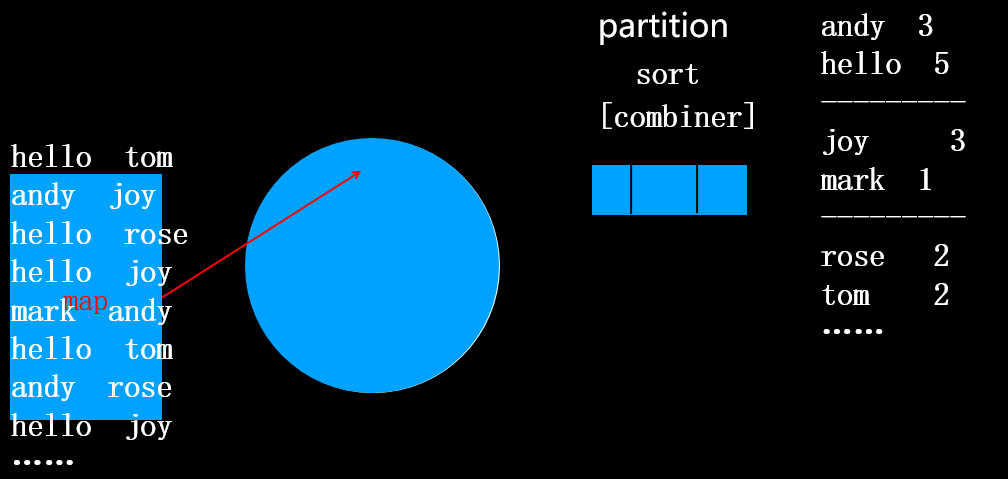
combiner的结果如上图所示
map任务执行完,产生N个spill文件,接着对N个文件进行合并,分以下两种情况:1.N<3,无论是否指定combiner类,合并文件时都不会执行combiner
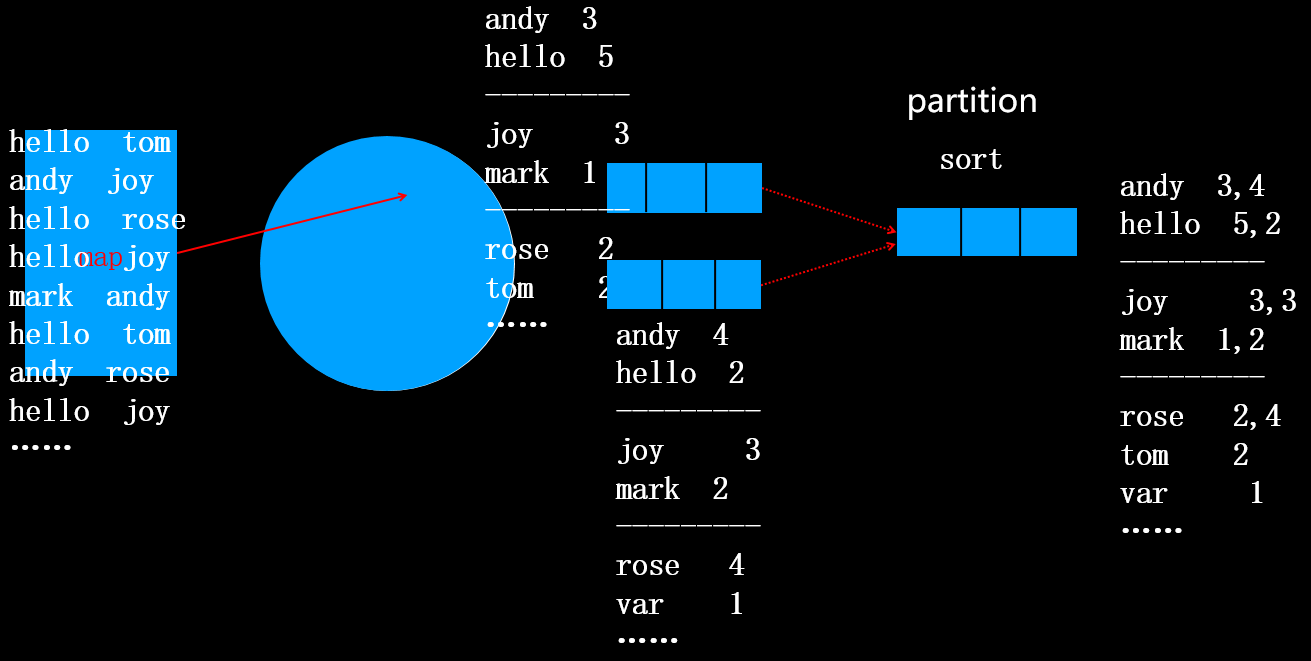
2.N>=3,如果指定了combiner类将执行combiner操作,如下图:
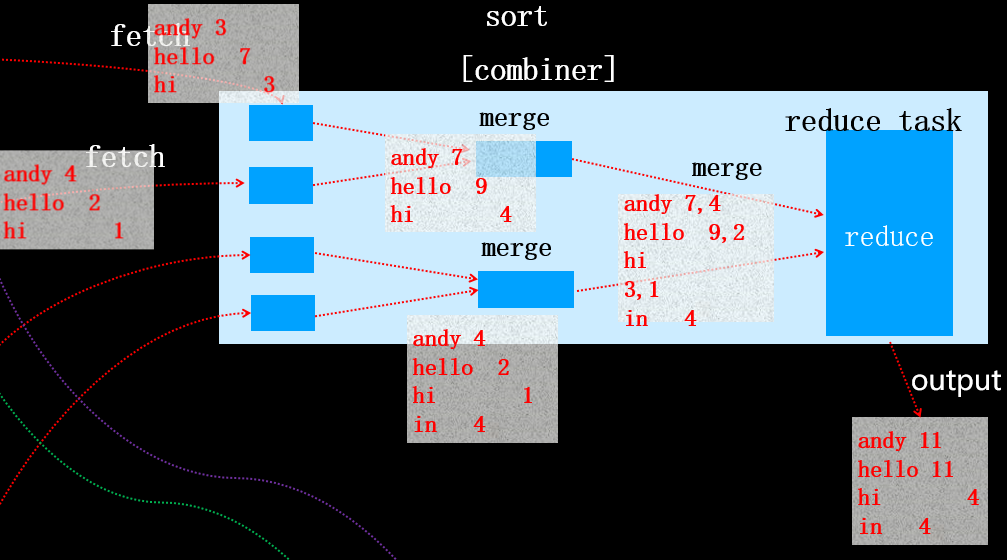
接下来进入fetch(或copy)阶段
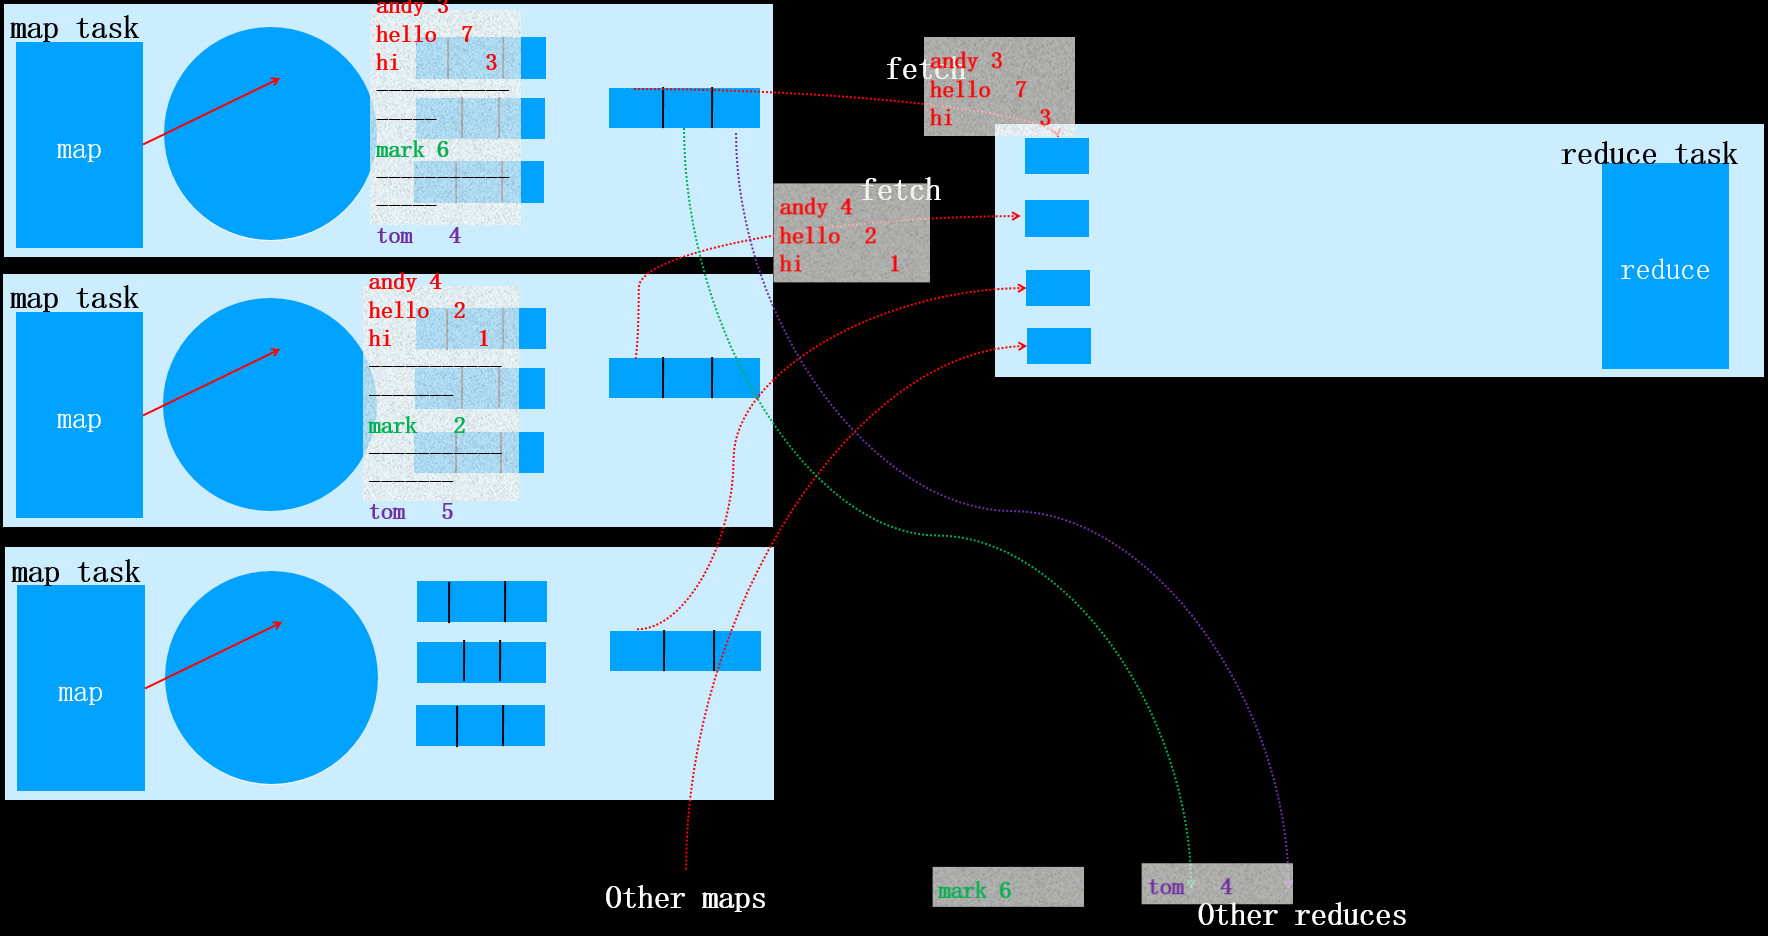
然后在reduce端进行合并
然后执行最后一趟合并,并将结果直接传给reduce
reduce task执行后,输出结果: