预训练语言模型(PLM)概述
本章围绕Transformer架构衍生的三大主流PLM类型(Encoder-Only、Encoder-Decoder、Decoder-Only)展开,系统讲解各类型代表模型的架构设计、预训练任务、优化方向及发展历程,揭示现代大语言模型(LLM)的技术根基。
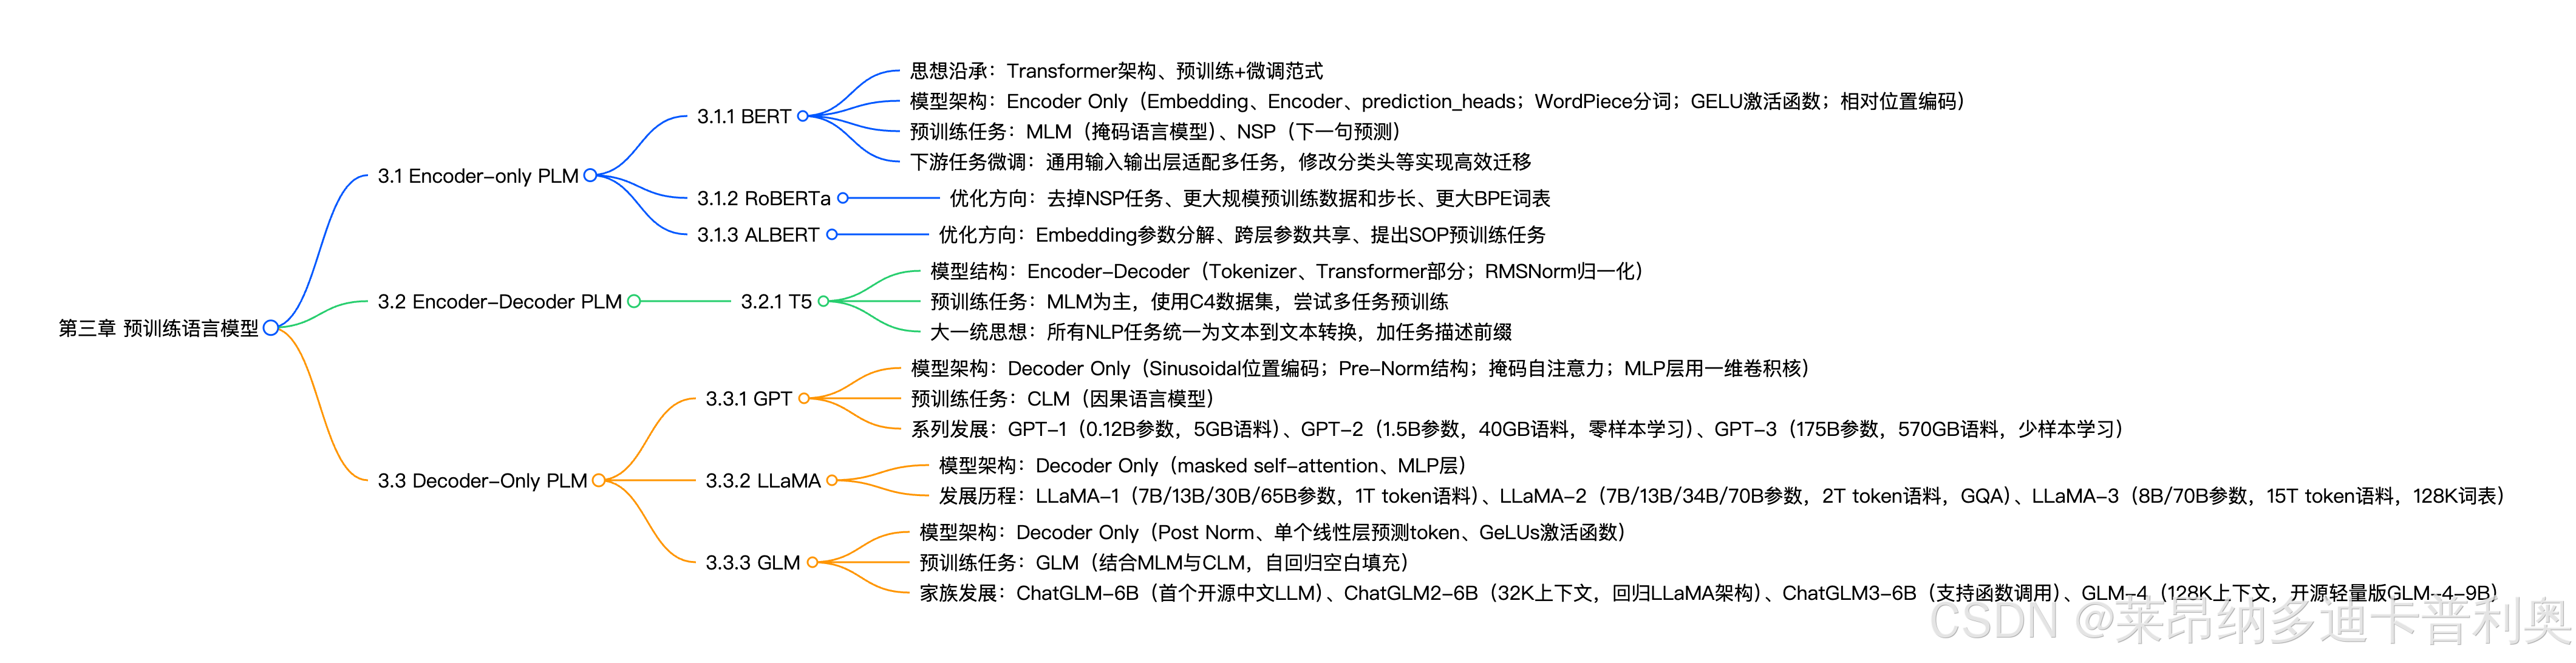
1 Encoder-Only PLM
核心定位:聚焦自然语言理解(NLU)任务,通过堆叠Transformer的Encoder层,结合双向语义学习的预训练任务,实现对文本深层语义的捕捉。代表模型为BERT及其优化版本RoBERTa、ALBERT。
1.1 BERT(Bidirectional Encoder Representations from Transformers)
1.1.1 核心思想沿承
- Transformer架构基础:沿用2017年《Attention is All You Need》提出的Transformer Encoder层,通过堆叠Encoder实现深层语义编码,摒弃传统RNN/LSTM的序列依赖问题。
- 预训练+微调范式:继承ELMo(2018年)的"无监督预训练+下游任务微调"思路,将预训练阶段的通用语言能力迁移到具体任务,大幅降低下游任务标注成本。
1.1.2. 模型架构(Encoder Only)
- 整体结构 :由
Tokenizer→Embedding层→Encoder层→Prediction Heads四部分组成,本质为Seq2Seq模型(无Decoder),通过分类头适配NLU任务。- Tokenizer:采用WordPiece分词(如"playing"→"play", "##ing"),中文以单个汉字为原子单位,平衡词表大小与编码效率。
- Embedding层:将input_ids映射为隐藏态(hidden_states),包含词嵌入+可训练的相对位置编码(通过线性矩阵拟合位置信息,优于Transformer的绝对位置编码,但无法处理超训练长度输入,最大上下文512 token)。
- Encoder层:堆叠12层(Base版)或24层(Large版)Encoder Layer,每层含"多头自注意力+Intermediate层(线性层+GELU激活函数)",Base版参数量110M,Large版340M。
- Prediction Heads:线性层+激活函数,输出维度与任务类别数一致,通过Softmax得到类别概率。
1.1.3. 预训练任务(MLM + NSP)
- MLM(掩码语言模型) :模拟"完形填空",解决传统LM单向语义学习的缺陷。
- 操作:随机遮蔽15% token,其中80%替换为
<MASK>、10%随机替换为其他token、10%保持不变(消除预训练与微调的不一致性,迫使模型关注上下文)。 - 优势:利用无监督语料(如3300M单词),拟合双向语义,提升文本理解能力。
- 操作:随机遮蔽15% token,其中80%替换为
- NSP(下一句预测) :针对句级NLU任务(如问答匹配、自然语言推理),判断两个句子是否为连续上下文。
- 正例:从语料中抽取连续句子;负例:随机打乱句子(避免原连续句),通过
<CLS>token的隐藏态做二分类。
- 正例:从语料中抽取连续句子;负例:随机打乱句子(避免原连续句),通过
1.1.4. 下游任务微调
- 通用适配设计 :输入首部添加
<CLS>token(代表整句语义),预训练后仅需微调分类头即可适配多任务:- 文本分类:修改Prediction Heads输出维度;
- 序列标注:集成多层隐藏态输出标注结果;
- 文本生成:直接用Encoder输出解码。
- 性能与影响:发布时刷新GLUE、MultiNLI等7个任务SOTA,确立预训练模型在NLU的统治地位,即使LLM时代,仍在标注数据丰富的NLU任务中表现优异。
1.2 RoBERTa(Robustly Optimized BERT Pretraining Approach)
1.2.1 核心优化方向
基于BERT架构,聚焦"数据规模、预训练任务、训练参数"三大维度优化,模型结构与BERT-large一致(24层Encoder,340M参数)。
| 优化点 | 具体措施 |
|---|---|
| 移除NSP任务 | 实验证明NSP任务简单且可能负面影响性能,仅保留MLM;同时采用"动态遮蔽"(训练时实时遮蔽,避免静态遮蔽的数据重复)。 |
| 扩大预训练数据与步长 | 新增CC-NEWS、OPENWEBTEXT等语料,总量160GB(10倍于BERT);训练步长500K(66个Epoch),batch size提升至8K(BERT为256),全序列以512 token训练。 |
| 增大BPE词表 | 替换BERT的WordPiece为BPE分词,词表从30K扩大到50K,提升编码能力(代价是Embedding层参数增加)。 |
1.2.2. 性能与意义
刷新多个下游任务SOTA,证明"更大数据、更长训练、更优任务设计"的有效性,为LLM的"规模优先"思路提供基础。
1.3 ALBERT(A Lite BERT)
1.3.1 核心优化方向
聚焦"减小参数量、提升模型效率",通过结构优化在小参数下超越BERT性能。
| 优化点 | 具体措施 |
|---|---|
| Embedding参数分解 | 解绑Embedding输出维度与隐藏层维度:设Embedding输出为128维,通过128×1024线性层升维至隐藏层大小(如1024),参数从V×H降至V×E + E×H(E=128),大幅减少计算开销。 |
| 跨层参数共享 | 仅初始化1个Encoder Layer,24层计算复用该层参数(参数量从340M降至59M),支持构建"更宽"模型(如隐藏层2048维),但训练/推理速度略慢(仍需24次计算)。 |
| 改进预训练任务(SOP) | 替换NSP为SOP(句子顺序预测):正例为连续句子,负例为连续句子逆序(提升任务难度,迫使模型学习句子逻辑顺序),实验证明SOP更优。 |
1.3.2 性能与意义
以59M参数(ALBERT-xlarge)实现超越BERT-large(340M)的性能,为模型压缩提供新思路,但因速度问题未广泛替代BERT。
2 Encoder-Decoder PLM
核心定位:兼顾NLU与NLG(自然语言生成),保留Transformer的Encoder与Decoder双结构,通过"文本到文本"的统一范式处理多任务,代表模型为T5。
2.1 T5(Text-To-Text Transfer Transformer)
2.1.1 模型结构(Encoder-Decoder)
- 整体框架 :
Tokenizer→Embedding层→EncoderLayers→DecoderLayers,Encoder处理输入文本,Decoder生成输出文本,两者通过"Encoder-Decoder Attention"交互。- Tokenizer:与BERT类似,将文本转为input_ids;
- Embedding与归一化 :采用RMSNorm(Root Mean Square Normalization)替代LayerNorm,仅1个可学参数,公式为
RMSNorm(x) = x / √(1/n∑x_i² + ε) · γ,稳定性更强; - Encoder Layer:含"多头自注意力+前馈神经网络(FFN)";
- Decoder Layer:额外增加"Encoder-Decoder Attention"(捕捉输入与输出的依赖),Mask机制与Transformer一致(遮蔽未来token)。
2.1.2 预训练任务
- 核心任务:MLM(类似BERT),使用750GB的C4数据集(Common Crawl清洗后的英文文本),随机遮蔽15% token并预测。
- 多任务预训练:尝试混合翻译、摘要等任务进行预训练,提升模型通用能力。
2.1.3 核心创新:大一统思想
将所有NLP任务统一为"文本到文本"转换,通过"任务描述前缀"明确任务类型,简化模型设计与训练流程:
- 文本分类:输入"classify: 这是一个很好的产品",输出"正面";
- 翻译:输入"translate English to French: How are you?",输出"Comment ça va?";
- 问答:输入"answer: 地球的半径是多少?",输出"约6371公里"。
2.1.4 性能与影响
统一任务范式减少任务特定调试,提升多任务学习效率,为后续Seq2Seq模型(如BART)提供思路,在翻译、摘要等任务中表现优异。
3 Decoder-Only PLM
核心定位:专为自然语言生成(NLG)设计,是现代LLM的主流架构,通过堆叠Transformer的Decoder层,结合"因果语言模型(CLM)"预训练任务,实现长文本生成,代表模型为GPT、LLaMA、GLM系列。
3.1 GPT(Generative Pre-Training Language Model)
3.1.1 模型架构(Decoder Only)
- 整体结构 :
Tokenizer→Embedding层→Positional Embedding→DecoderLayers→线性层,与BERT类似但堆叠Decoder层,天生适配NLG。- 位置编码:沿用Transformer的Sinusoidal绝对位置编码(三角函数计算),而非BERT的可训练编码;
- Decoder Layer:12层(GPT-1),含"掩码自注意力(遮蔽未来token)+ Pre-Norm(先归一化再计算注意力,避免梯度爆炸)+ MLP(用1D卷积替代线性层,效果一致)";
- 输出层:线性层映射到词表维度,通过Softmax生成下一个token。
3.1.2 预训练任务:CLM(因果语言模型)
- 核心逻辑 :基于前文预测下一个token,模拟人类写作习惯,公式为
P(token_i | token_1, ..., token_{i-1}),通过不断迭代生成完整序列(如输入"今天天气"→输出"今天天气很"→再输入"今天天气很"→输出"今天天气很好")。 - 优势:与下游生成任务完全匹配(无预训练-微调不一致),可利用任意无监督文本,数据规模易于扩大。
3.1.3 GPT系列发展历程
| 模型 | 参数量 | 预训练语料 | 核心改进与意义 |
|---|---|---|---|
| GPT-1 | 0.12B | 5GB | 首个Decoder-Only PLM,验证预训练+微调范式,但参数与数据小,性能弱于BERT。 |
| GPT-2 | 1.5B | 40GB | 扩大参数量与数据(WebText数据集);改为Pre-Norm结构;提出"零样本学习(Zero-Shot)",无需微调直接通过任务描述解决问题(能力有限)。 |
| GPT-3 | 175B | 570GB | LLM开创之作,数据从CC、WebText等采样(45T清洗后570GB);引入"少样本学习(Few-Shot/上下文学习)",通过3-5个示例提升任务表现;稀疏注意力降低计算成本,展现"涌现能力",为ChatGPT奠定基础。 |
3.2 LLaMA(Large Language Model Meta AI)
Meta开源的LLM系列,基于GPT架构优化,聚焦"性能、效率、多语言支持",是开源社区主流基座模型。
3.2.1 模型架构(Decoder Only)
与GPT一致,核心差异在细节优化:
- 归一化:采用LlamaRMSNorm(类似T5的RMSNorm);
- 位置编码:引入旋转位置编码(RoPE),提升长序列建模能力;
- 注意力机制:LLaMA-2起引入分组查询注意力(GQA),平衡计算效率与注意力质量。
3.2.2 系列发展历程
| 版本 | 参数量版本 | 预训练语料 | 核心改进 |
|---|---|---|---|
| LLaMA-1 | 7B/13B/30B/65B | 1T token | 2023年2月发布,开源后成为社区热门;65B模型需2048张A100训练21天。 |
| LLaMA-2 | 7B/13B/34B/70B | 2T token | 2023年7月发布,上下文长度从2K→4K;引入GQA;除34B外均开源,支持更多任务。 |
| LLaMA-3 | 8B/70B(400B待训) | 15T token | 2024年4月发布,词表扩大到128K(编码效率提升);支持8K长文本;多语言能力增强,性能接近闭源模型。 |
3.3 GLM(General Language Model)
智谱开发的中文LLM系列,早期尝试融合CLM与MLM,后期回归主流Decoder-Only架构,是中文开源LLM的重要代表。
3.3.1 模型架构(Decoder Only,早期差异化设计)
与GPT的三点差异:
- 归一化:使用Post Norm(先残差计算再归一化,鲁棒性更强,但大模型易梯度问题);
- 输出层:单个线性层预测token(而非MLP),减少参数量;
- 激活函数:用GeLUs替代ReLU,保证非线性连续性。
3.3.2 预训练任务:GLM(自回归空白填充)
早期核心创新,融合CLM与MLM:
- 操作:随机遮蔽连续token片段(而非单个token),模型需用上下文预测片段,且片段内部按CLM顺序生成(如输入"I because you "→输出"-love you; -are wonderful");
- 优势:同时适配NLG(片段内CLM)与NLU(上下文预测),实验中在SuperGLUE等任务超越同体量BERT。
3.3.3 系列发展历程
| 版本 | 发布时间 | 核心改进 |
|---|---|---|
| ChatGLM-6B | 2023.03 | 国内首个开源中文LLM,1T语料预训练,支持2K上下文;基于早期GLM架构。 |
| ChatGLM2-6B | 2023.06 | 回归LLaMA架构,引入MQA;上下文长度→32K;预训练规模扩大,性能大幅提升。 |
| ChatGLM3-6B | 2023.10 | 优化训练数据与策略,语义、数学、代码能力达SOTA;支持函数调用与代码解释器。 |
| GLM-4 | 2024.01 | 支持128K上下文,英文性能接近GPT-4;开源轻量版GLM-4-9B(8K上下文,多语言支持)。 |
核心总结与技术脉络
- 架构演进逻辑:从Encoder-Only(NLU)→Encoder-Decoder(兼顾NLU/NLG)→Decoder-Only(LLM主流,NLG优先),核心驱动力是"任务需求"与"规模效应"。
- 预训练任务创新:从LM(单向)→MLM(双向)→CLM(因果生成)→GLM(融合),逐步解决"语义捕捉"与"任务匹配"问题。
- LLM技术根基:GPT的CLM任务、LLaMA的架构优化、GLM的中文适配,共同构成现代开源LLM的核心技术栈,而"参数量扩大+数据规模提升+上下文长度增加"是性能突破的关键。