ChatTS: Time Series LLM for Understanding and Reasoning
ChatTS: Time Series LLM for Understanding and Reasoning

1、保留值的时间序列归一化

时间序列的数值特征至关重要,因为现实世界的应用通常涉及特定的数值查询(例如,询问最大 CPU 利用率),时间序列数据归一化可能导致丢失原始数据信息。

方案 :首先,我们对每个时间序列数组应用标准的最小 - 最大归一化 (0-1 缩放)。然后,对于每个时间序列 ,我们在文本中作为提示的一部分包含归一化参数 -"值缩放 "(归一化期间的缩放因子)和 "值偏移"(归一化期间应用的偏移)。

代码实现:

① 归一化:计算均值并进行中心化,计算缩放因子

② 构建元数据提示词:它会根据时间序列的统计信息 生成一段特殊的文本描述,[offset=0.1234|scaling=1.0000|length=100|max=5.5|min=-2.1|left=0.1|right=0.5]<ts><ts/>

Processing_qwen3_ts.py文件实现了:

① 实现了保留值的时间序列归一化

② 通过将自然语言和原始时间序列转化为TokenID + 归一化时间序列张量

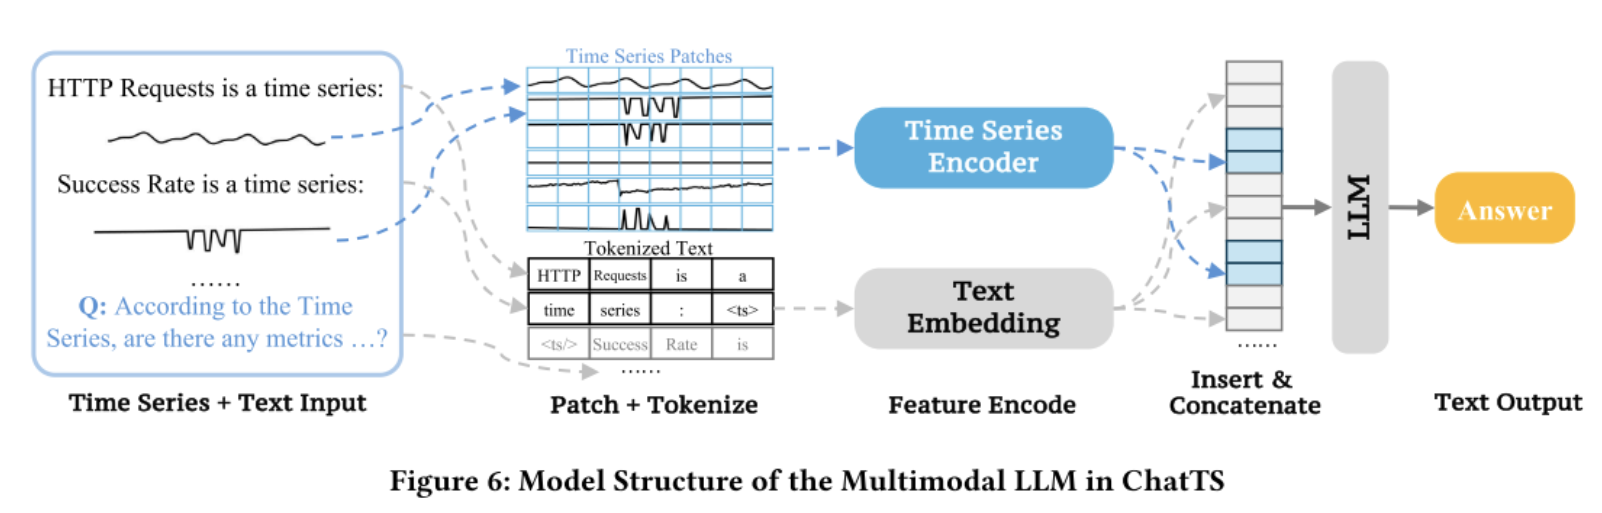
2、整体架构

该模型采用了 "Patch + Projection" 的多模态融合范式(类似 Vision Transformer 或 LLaVA 处理图像的方式):

  1. 基座模型 (Backbone): 使用 Qwen3Model 作为大脑,负责处理上下文和生成文本。
  2. 编码器 (Encoder): 使用一个轻量级的 TimeSeriesEmbedding (MLP结构) 将时间序列切片(Patch)并映射到 LLM 的特征空间(Embedding Space)。
  3. 融合机制 (Fusion): 在输入层(Input Embedding layer)直接将文本的 Embedding 和时间序列的 Embedding 拼接在一起。
相关推荐
Rocky Ding*6 分钟前
GPT-6.1 Sol大模型深度解析
论文阅读·人工智能·深度学习·机器学习·aigc·ai-native·gpt-6.1 sol
m4Rk_20 小时前
【论文阅读】Agent 记忆机制(87):VizoMem——把文本历史转化为可检索的视觉记忆
论文阅读·人工智能·学习·开源·github
m4Rk_2 天前
【论文阅读】Agent 记忆机制(86):Skill-Pro——用 Non-Parametric PPO 将交互经验演化为可复用技能
论文阅读·人工智能·学习·开源·github
Rocky Ding*2 天前
DeepSeek DSec技术深度解析:Agent规模化训练的真正瓶颈,是沙箱基础设施
论文阅读·人工智能·深度学习·机器学习·aigc·agent·ai-native
m4Rk_3 天前
【论文阅读】Agent 记忆机制(83):Inside Out——用可演化 PersonaTree 构建 Agent 的核心长期记忆
论文阅读·人工智能·学习·开源·github
m4Rk_4 天前
【论文阅读】Agent 记忆机制(81):EMR——用情景记忆避免 Agent 在多步推理中反复绕圈
论文阅读·人工智能·学习·开源·github
m4Rk_4 天前
【论文阅读】Agent 记忆机制(82):ReasoningBank——从成功与失败经验中沉淀可复用的推理记忆
论文阅读·人工智能·学习·开源·github
Rocky Ding*4 天前
一文读懂Qwen-Audio-3.1核心基础知识:从语音识别到可控声景与实时Agent
论文阅读·人工智能·深度学习·机器学习·aigc·ai-native·qwen-audio
Rocky Ding*5 天前
Hi-DiT:一文读懂Hybrid Latent-Pixel Diffusion Transformer的本质与技术细节
论文阅读·人工智能·深度学习·机器学习·aigc·ai-native·hi-dit
m4Rk_11 天前
【论文阅读】Agent 记忆机制(77):TSM——让记忆回到事件真正发生的时间
论文阅读·人工智能·学习·开源·github