KV Cache

原理

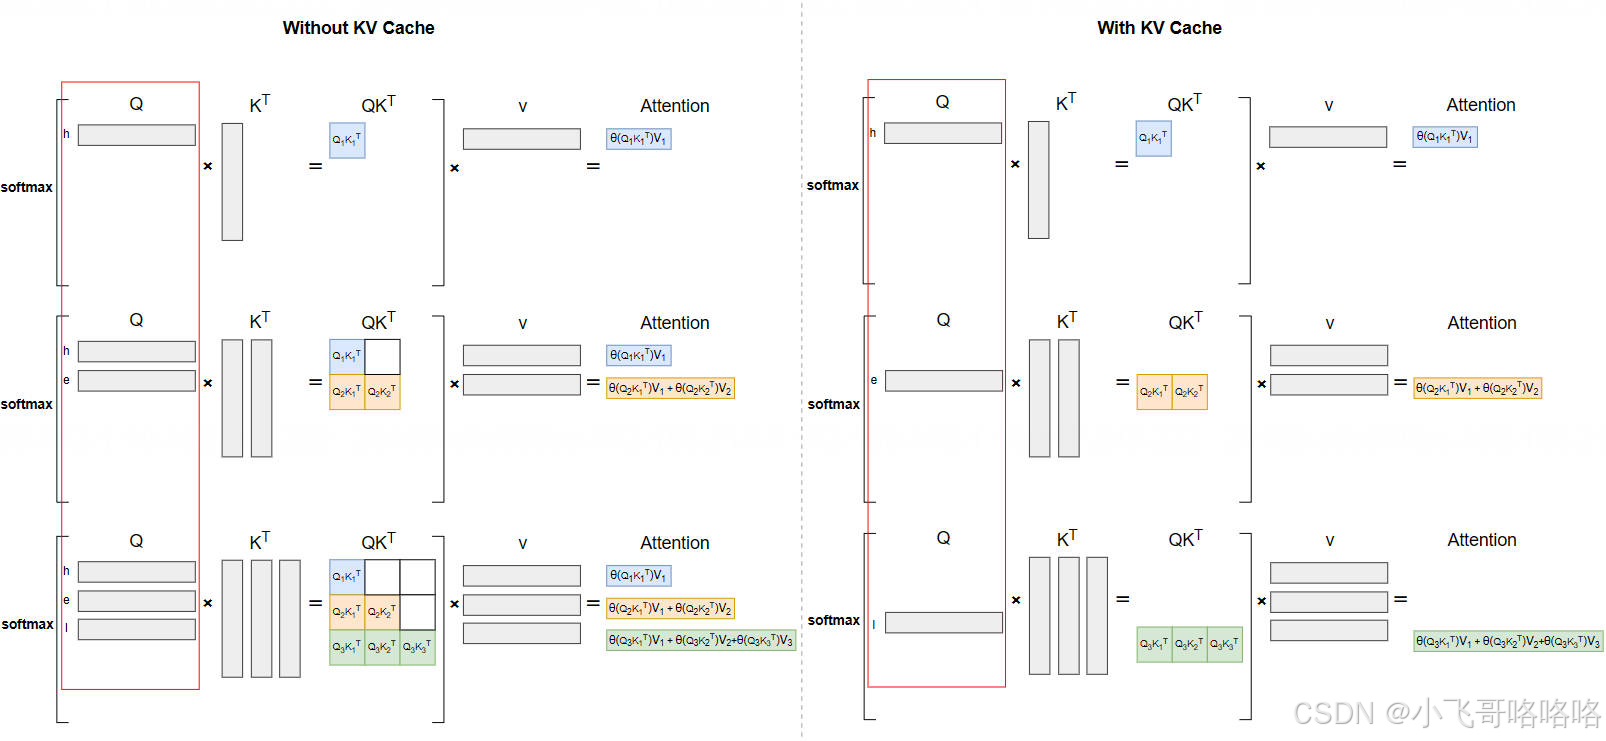
这里贴一张经典的图(ref:https://infrasys-ai.github.io/aiinfra-docs/05Infer02InferSpeedUp/01KVCache.html)

但我个人觉得这个图不能体现KV Cache减少计算的情况,因为看起来Attention的结果在前后也有优化,但实际上左边的Q也可以改成单个的,关键的是不需要重复计算K和V了。

数学推理参考https://datahonor.com/blog/2025/06/03/llm_kv_cache/

prefix Cache

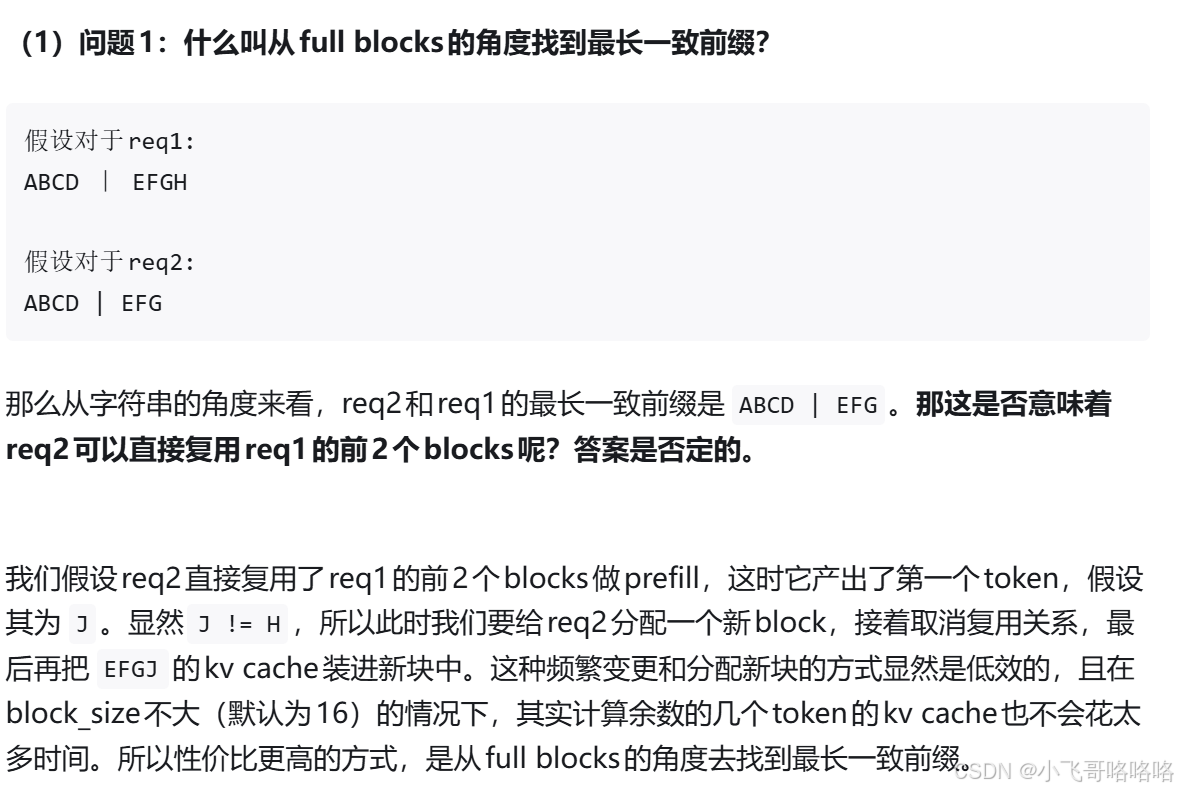
直白讲,就是在KV Cache保存时,如果是相同前缀的完全相同的block,可以复用。
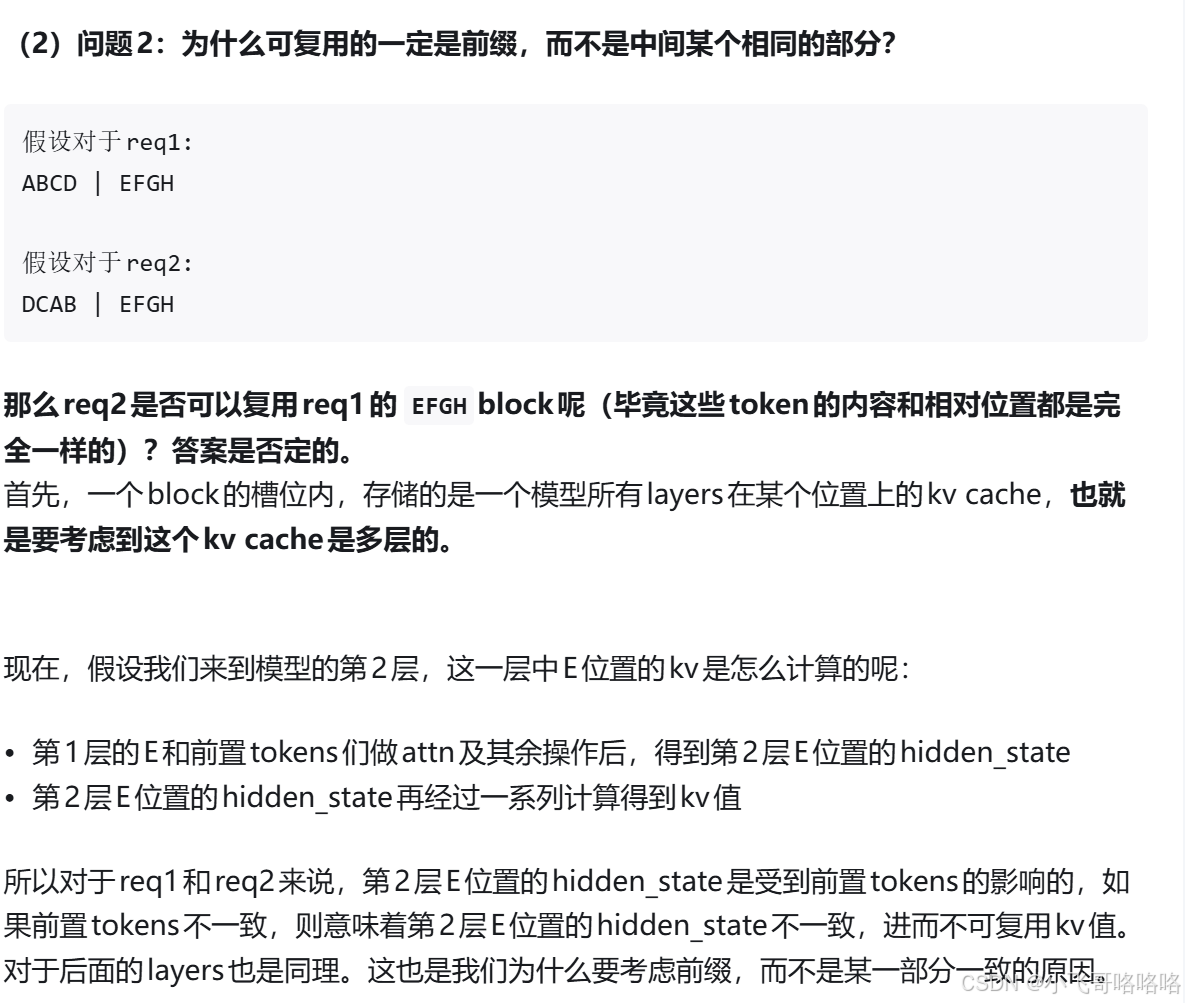
比如下面的问题2(ref:https://zhuanlan.zhihu.com/p/1916181593229334390),这里的前缀如果变了,对应上图中K和V的前面几根柱形发生了变化,会直接影响所有的生成的Attention的结果,因此不能复用。(似乎可以是一个优化点?比如通过调整输入prompt的顺序,或是进行同义prompt的转换)

相关推荐
I Am a robert girl20 天前
STEPQuant:Delta-Rule 循环状态量化中,误差何时何地才真正致命
深度学习·模型部署·量化·kv cache·线性注意力·显存优化·循环状态
小马92622 天前
KV Cache 瘦身 437 倍:DeepSeek V4.1-Flash 的推理效率革命
大模型·moe·kv cache·deepseek·推理优化·ai基础设施
Together_CZ1 个月前
DeepSeek-V4.1-Flash:Pushing the Limits of KV Cache Compression——推动 KV 缓存压缩的极限
缓存·llm·compression·kv cache·deepseek·v4.1-flash·推动 kv 缓存压缩的极限
晨欣2 个月前
LLM Architecture Gallery 是什么:新开源模型出来后,先对照架构再决定要不要部署
qwen·moe·gqa·kv cache·deepseek·mla·llm架构
weixin_440213292 个月前
大模型训练、微调、对齐、推理、量化、优化、数据集等
微调·数据集·sft·预训练·模型量化·gptq·kv cache
weixin_440213292 个月前
大模型推理核心原理:KV Cache、Prefill、Decode、TTFT、vLLM、算子
vllm·大模型推理·decode·kv cache·prefill·llm 部署
thesky1234562 个月前
27届大模型面试准备(三十六):注意力机制演进与 KV Cache 优化——从 MHA 到 MLA 的显存之战
大模型·注意力机制·mha·gqa·mqa·kv cache·mla
白拾2 个月前
【NeurIPS 2023】H2O:重型命中者预言机——大模型高效生成式推理的 KV Cache 驱逐策略|从大模型推理系统优化视角
大模型推理·高效推理·kv cache·稀疏注意力·h2o 论文分享·neurips 2023
thesky1234562 个月前
27届大模型面试准备(十九):模型量化全攻略——INT8/INT4、GPTQ、AWQ、SmoothQuant 与 KV Cache 量化
大模型·模型量化·gptq·awq·kv cache·smoothquant·int4
Token炼金师3 个月前
服务的骨架:网关、负载均衡、容灾、弹性与多机房 —— 推理系统架构五柱
人工智能·系统架构·llm·负载均衡·容灾·kv cache·prefix cache