1.对比学习
- 监督学习需要大量的有标签的数据,强化学习需要与环境的大量交互尝试。
- 自监督学习是一种新机器学习方法,他通过从无标签数据中生成监督信号,来学习有用的表示,特别是在大规模数据集上取得了先出成果
- 三种分类:上下文学习,时序学习和对比学习
2.对比学习的优势
- 传统监督学习方法,面对大量数据,需要消耗大量的人力和时间用于标注数据成本较高
- 传统无监督学习的方法中(聚类、降维、异常检测),面对在处理数据稀疏问题时可能效果不佳
- 传统的无监督学习方法没有充分利用未标注数据中的信息,而对比学习可以更好的利用这些数据
3.对比学习思路
主要解决如何学习表征、如何解决数据稀疏问题、如何利用无标签数据等
对比学习是一种自监督学习方法,侧重于通过对比正反两方面的实力来提取有意义的表征。在学习到的嵌入空间中,相似的实例应靠的更近,而不相似的实例离得更远。
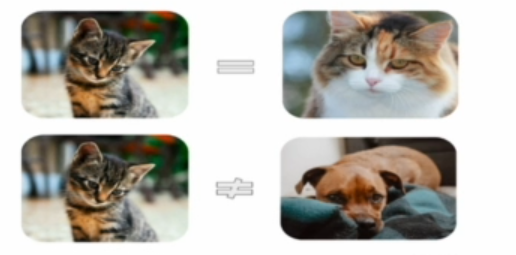
4.数据增强
对比学习通常从数据增强开始,这设计对未标记的数据应用各种转换或扰动以创建不同的实例或增强视图。
数据增强的目标是增加数据的可变性,并将模型暴露给同一实例的不同视角。常见的数据增强技术包括裁剪、翻转、旋转、随机裁剪和颜色变换。通过生成不同的实例,对比学习可确保模型学习捕获相关信息,而不管输入数据的变化如何。
5.特征提取
特征提取器是对比学习模型的核心组件,负责从输入数据中提取高级特征表示。常见特征提取器包括:
ResNet :残差网络是深度学习中非常流行的架构之一,它通过引入残差链接解决了深度网络的梯度消失问题。
Inception:通过多尺度的卷积操作来捕获不同大小的特征,适合于复杂的图像特征。
EfficientNetL:这是一个高效网络结构,通过复合缩放的方法优化了网络的宽度、深度和分辨率,以达到更好的性能
6.相似度计算
在对比学习中,相似度计算式核心步骤之一,用于衡量不同样本之间的相似程度。余弦相似度常用于对比学习中的相似度计算,因为它受向量长度的影响,只关注方向。这使得它在特征表示学习中非常有用。
- 余弦相似度
- 欧式距离
- 曼哈顿距离(L1距离)
- jaccard相似度(离散的数据)
7.对比学习模型
SimCLR:通过大量数据增强和对比学习,直接在特征表示上使用NT-Xent损失函数来最大化正样本对的相似性,最小化负样本的相似性。
MoCo:使用动量更新机制和一个队列来存储负样本,从而在有限的内存下提供大量的负样本对,提高对比学习的效果。
BYOL:通过两个编码器(在线编码器和目标编码器)之间的预测机制,不需要负样本对,直接优化在线编辑器的输出与目标编码器的输出指甲你的相似性。