一、Kafka安装
1.1、先安装Java环境
准备在Linux平台运行,下载Linux下的安装包,下载地址:https://www.oracle.com/java/technologies/downloads/#java8
这边目前的下载的版本为:jdk-8u481-linux-x64.tar
然后找到合适的位置,进行解压:
shell
tar -zxvf jdk-8u481-linux-x64.tar本人在/usr/lib目录下创建 jdk目录,将解压后的文件移动到/usr/lib/jdk目录下:
shell
mkdir /usr/lib/jdk
mv jdk1.8.0_481 /usr/lib/jdk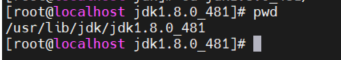
配置环境变量,编辑/etc/profile文件,在文件末尾添加如下内容:
shell
#set java env
export JAVA_HOME=/usr/lib/jdk/jdk1.8.0_481
export JRE_HOME=${JAVA_HOME}/jre
export CLASSPATH=.:${JAVA_HOME}/lib:${JRE_HOME}/lib
export PATH=${JAVA_HOME}/bin:$PATH
使环境变量生效:
shell
source /etc/profile验证是否安装成功:
shell
java -version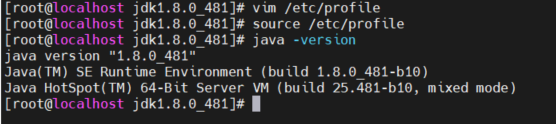
1.2、安装Kafka
如果联网,直接用命令进行下载:
shell
wget https://archive.apache.org/dist/kafka/2.0.0/kafka_2.11-2.0.0.tgz如果没联网,直接下载好,然后上传到服务器,解压:
shell
tar -zxvf kafka_2.13-2.8.0.tgz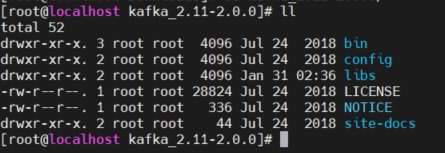
配置和启动zookeeper
kafka自带的zookeeper程序,可以使用bin/zookeeper-server-start.sh和bin/zookeeper-server-stop.sh来启动和停止Zookeeper
在config目录下,存在一些配置文件,其中zookeeper.properties是zookeeper的配置文件,可以根据需要进行修改,默认配置如下:
shell
# the directory where the snapshot is stored.
dataDir=/tmp/zookeeper

# the port at which the clients will connect
clientPort=2181

# disable the per-ip limit on the number of connections since this is a non-production config
maxClientCnxns=0
启动zookeeper:
shell
sh bin/zookeeper-server-start.sh config/zookeeper.properties            # 前台运行
sh bin/zookeeper-server-start.sh -daemon config/zookeeper.properties    # 后台运行
配置和启动kafka
在config目录下,存在一些配置文件,其中server.properties是kafka的配置文件,可以根据需要进行修改,默认配置如下:
shell
#broker的全局唯一编号,不能重复
broker.id=0
#用来监听链接的端口,生产者和消费者会连接到这个端口
listeners=PLAINTEXT://:9092
#处理网络请求的线程数量
num.network.threads=3
#用来处理磁盘IO的线程数量
num.io.threads=8
#发送套接字的缓冲区大小
socket.send.buffer.bytes=102400
#接收套接字的缓冲区大小
socket.receive.buffer.bytes=102400
#请求套接字的缓冲区大小
socket.request.max.bytes=104857600
#kafka运行日志存放的路径
log.dirs=/tmp/kafka-logs
#topic在当前broker上的分区个数
num.partitions=1
#用来恢复和清理data下数据的线程数量
num.recovery.threads.per.data.dir=1
#segment文件保留的最长时间,超时将被删除
log.retention.hours=168
......
############################# Zookeeper #############################

# Zookeeper connection string (see zookeeper docs for details).
# This is a comma separated host:port pairs, each corresponding to a zk
# server. e.g. "127.0.0.1:3000,127.0.0.1:3001,127.0.0.1:3002".
# You can also append an optional chroot string to the urls to specify the
# root directory for all kafka znodes.
zookeeper.connect=localhost:2181                    # 这只是本地配置,如果是其他机器运行zookeper,需要配置对应的ip地址

# Timeout in ms for connecting to zookeeper
zookeeper.connection.timeout.ms=6000
启动kafka:
shell
sh bin/kafka-server-start.sh config/server.properties            # 前台运行
sh bin/kafka-server-start.sh -daemon config/server.properties # 后台运行启动完之后,确认下是否启动成功,尤其是在后台运行的情况,利用lsof命令查看端口
shell
lsof -i:9092二、Kafka使用
2.1、创建topic
创建一个名为test的topic,只有一个分区和一个备份:
shell
sh bin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 1 --topic test
参数说明:
--create:创建topic--zookeeper:指定zookeeper的地址--replication-factor:指定副本的数量--partitions:指定分区数量--topic:指定topic名称
2.2、查看当前服务器中的所有topic:
shell
sh bin/kafka-topics.sh --list --zookeeper localhost:21812.3、查看topic属性
shell
sh bin/kafka-topics.sh --describe --zookeeper localhost:2181 --topic test
2.4、发送消息
启动一个生产者,然后在控制台输入要发送的消息,回车即可发送:
shell
sh bin/kafka-console-producer.sh --broker-list localhost:9092 --topic test
# 输入
hello world
Tom
Cat
Hello kafka
2.5、消费消息
启动一个消费者,消费名为test的topic中的消息:
shell
sh bin/kafka-console-consumer.sh --bootstrap-server localhost:9092 --from-beginning --topic test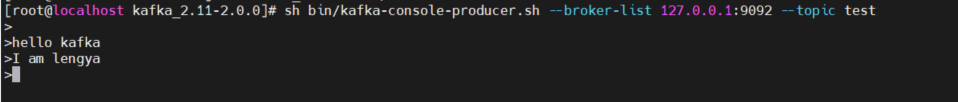

2.6、删除topic
删除名为test的topic:
shell
sh bin/kafka-topics.sh --delete --zookeeper localhost:2181 --topic test注意:如果topic正在被使用,则不能删除,需要先停止使用。
2.7、多看帮助手册
在bin/目录下存在多个脚本,每个脚本都有对应的帮助手册,可以查看帮助手册来了解如何使用:
shell
sh bin/kafka-topics.sh --help