前言:本文将简单介绍一下关于SQL调优的相关概念,执行计划中相关字段的含义以及功能
你是否还在为每逢假期,抢火车票时软件总会出现卡顿现象,点击一个页面迟迟没有响应。你是否还在因为学校教务系统选课时人数爆满,倒是选不上心怡的课程而私下懊恼。出现这种现象的一大原因就是数据库性能瓶颈。
一,为什么需要调优
调优的目的不仅仅是为了快,还是提高系统稳定性 以及节约服务器成本。
二,如何发现慢SQL
MySQL客户端运行
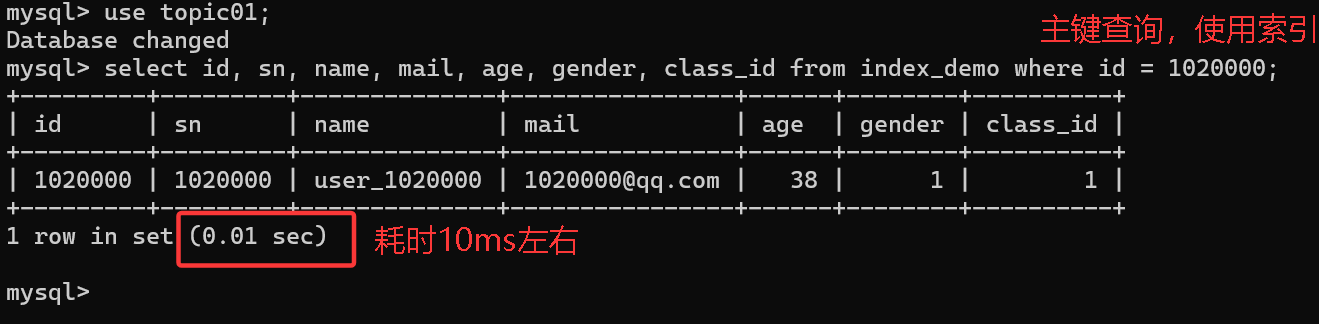
使用主键查询一条SQL语句,运行结果如下:
再使用非索引字段来查询,比如使用sn(学号),观察运行结果:
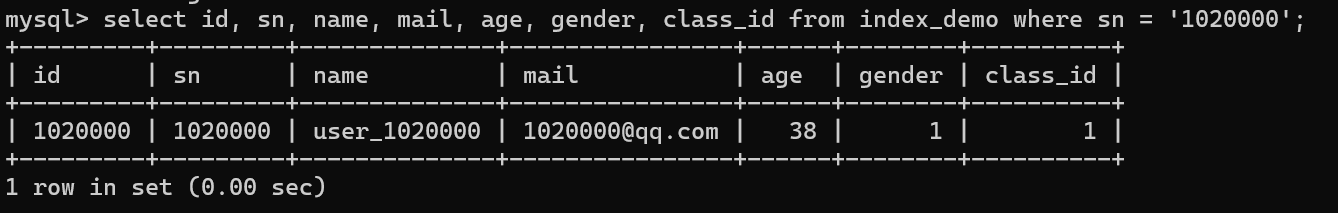
可以发现使用索引比不使用索引耗时更慢,不符合我们的预期。查询结果产生波动时正常的。直接观察查询结果,数据不够准确。
mysqlslap压测工具
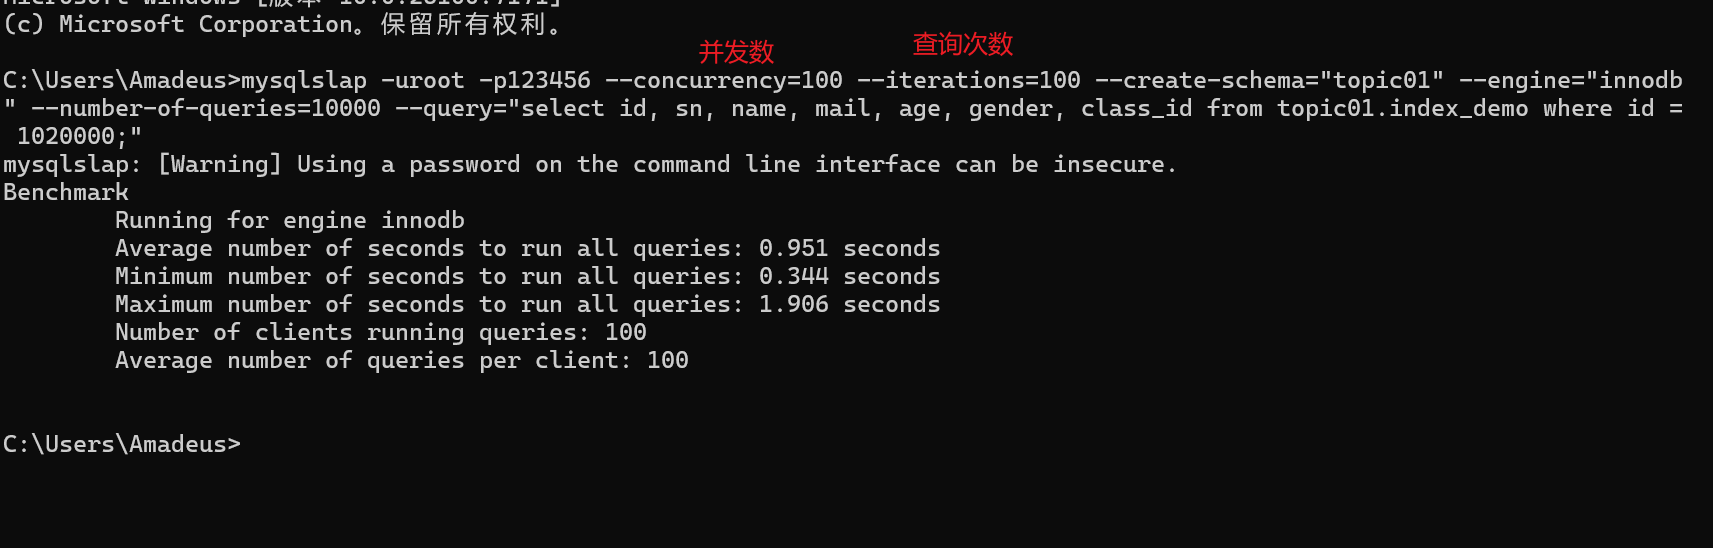
这时候就可以使用MySQL自带 压测工具来观察SQL语句的查询耗时,在使用之前,我们需要先配置好MySQL的环境变量,在命令行执行SQL语句
java
mysqlslap -uroot -p123456 --concurrency=100 --iterations=100 --create-schema="topic01" --engine="innodb" --numberof-queries=10000 --query"select id, sn, name, mail, age, gender, class_id from topic01.index_demowhere id = 1020000;"下图就显示了对于100个客户端,每个连接100轮查询,每轮10000次,共计100w次查询的耗时
使用非索引字段的查询sql,观察耗时
java
mysqlslap -uroot -p123456 --concurrency=50 --iterations=5 --create-schema="topic01" --number-of-queries=5000 --query="select id, sn, name, mail, age, gender, class_id from topic01.index_demo where sn = '1020000';"结果显示,即使是执行了远比100w次小的25000次查询,在不添加索引的情况下,耗时更长
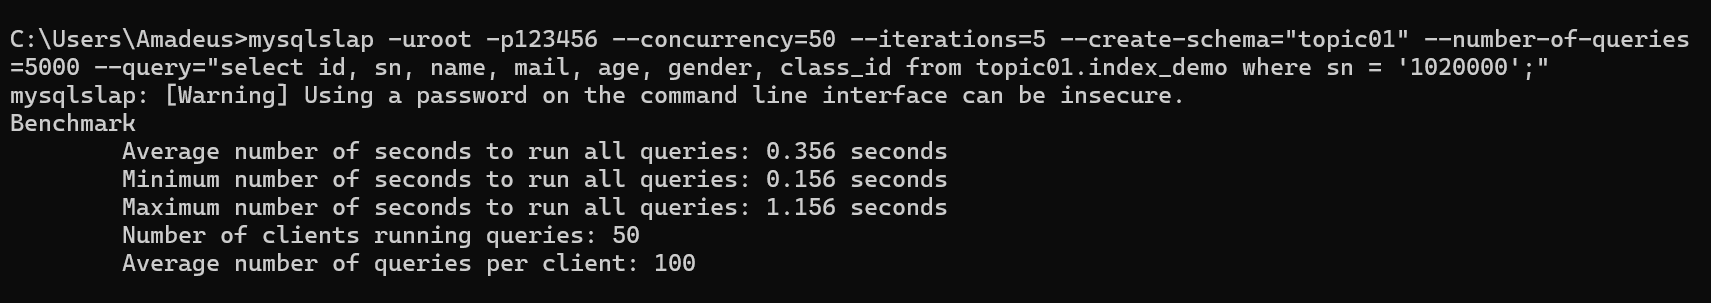
通过压测工具的使用,我们可以发现一个sql的耗时详情,得到问题所在,下面就是来查看解决问题的关键点------执行计划
三,执行计划
什么是执行计划?
执行计划是MySQL 优化器在分析完你的 SQL 语句后,决定"如何去执行"的一份蓝图 。可以理解为一个预测,对sql语句实机运行后的结果的预测。但是实际上并未在服务器上运行
其sql代码也很简单,只需要在sql前添加EXPLAIN即可,下面是一个使用了主键索引的执行计划
结果出现了很多字段,接下来简单介绍一下这些字段分别代表什么含义
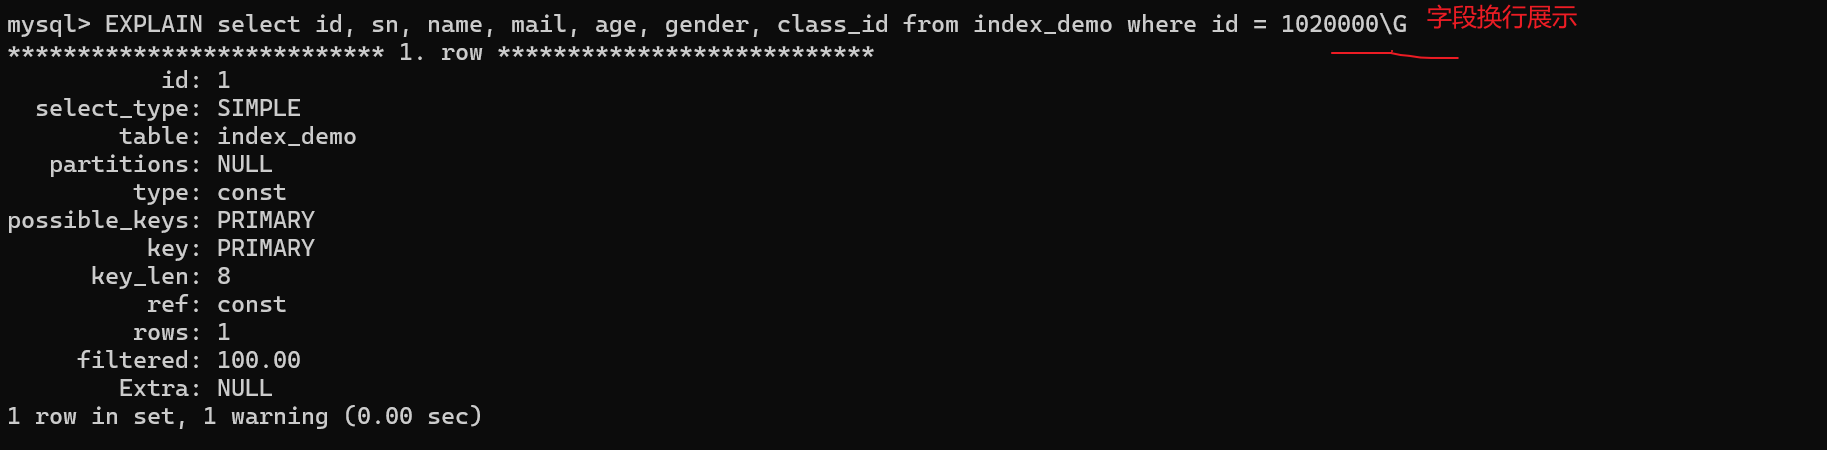
执行计划字段
id
id用于显示查询结果在结果集中所处的序列号
select查询会把数据以一个表格的形式存储在内存当中,这个表格并未真实创建,而是查询结果的展现方式。id则显示了我们所查询的id = 1020000这一行在结果集中从上到下的序列号。
由于上述查询指找到了一条返回结果,所以id为1,当查询语句中包含子查询或者合并查询时,运行结果显示
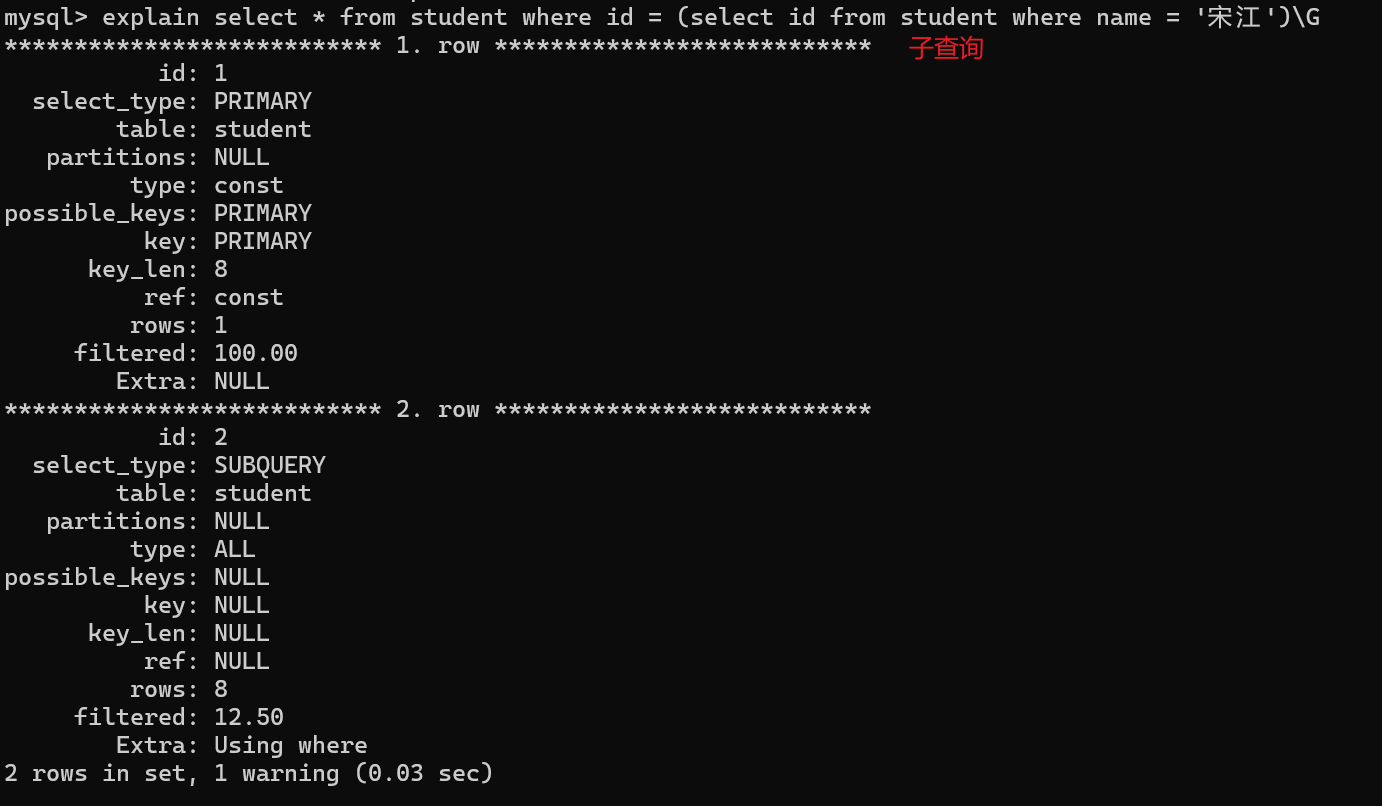
select_type
select_type用于区分查询语句的类型
| select_type 类型 | 描述 (含义) | 性能/注意点 |
|---|---|---|
| SIMPLE | 简单查询 。查询中不包含子查询或者 UNION。 |
🟢 最常见。通常性能较好,结构简单清晰。 |
| PRIMARY | 最外层查询。如果查询包含任何复杂的子部分(如子查询、UNION),最外层的那个 SELECT 被标记为 PRIMARY。 | 🔵 框架。它是整个复杂查询的"容器"或"入口"。 |
| SUBQUERY | 子查询 。在 SELECT 或 WHERE 列表中包含了子查询(且该子查询不依赖外部查询)。 |
🟡 独立。该子查询只执行一次,结果会被缓存,性能尚可。 |
| DEPENDENT SUBQUERY | 相关子查询 。在 SELECT 或 WHERE 列表中包含了子查询,且该子查询依赖了外部查询的结果。 |
🔴 警惕。外部查询每扫一行,子查询就要跑一遍。如果外表很大,性能会极其糟糕。 |
| DERIVED | 衍生表 。在 FROM 列表中包含的子查询。MySQL 会递归执行这些子查询,把结果放到临时表中。 |
🟡 临时表。因为要创建临时表,可能会有内存/磁盘开销。 |
| UNION | 联合查询 。如果第二个 SELECT 出现在 UNION 之后,则被标记为 UNION。 |
🔵 连接部分 。通常属于 PRIMARY 或 SUBQUERY 的一部分。 |
| DEPENDENT UNION | 相关联合查询 。与 UNION 类似,但它出现在 DEPENDENT SUBQUERY 中。 |
🔴 警惕 。同 DEPENDENT SUBQUERY,由于依赖外部结果,通常性能较差。 |
| UNION RESULT | 联合结果 。从 UNION 表获取结果的 SELECT。 |
🟡 开销 。通常涉及临时表去重(除非是 UNION ALL),有额外开销。 |
| MATERIALIZED | 物化子查询。子查询的结果被保存(物化)到一个临时表中,以便外层查询多次复用。 | 🟢 优化 。MySQL 的一种优化手段,比普通的 DEPENDENT SUBQUERY 快得多。 |
| UNCACHEABLE SUBQUERY | 不可缓存子查询。一个子查询的结果不能被缓存,必须为外部查询的每一行重新评估。 | 🔴 极慢 。通常是因为子查询里用了 UUID()、RAND() 等随机函数。 |
table
显示查询结果数据所处表,告诉你这一行数据是关于哪张表的(或者是生成的临时表)。
partitions
partitions表示查询语句在数据库中匹配的分区
简单来说,Partition(分区) 是 MySQL 把一张原本巨大的表,在物理磁盘上拆分成多个"小文件"存储,但在逻辑上(写 SQL 时)依然把它当做一张表来用的技术。
一般情况下,partitions为NULL代表着未对表做分区处理。在设计到大数据量(千万,亿级)时,使用分区表可以优化查询性能。
设想假如一个表中存储用户2015 - 2026几乎十年的数据,如果使用select查询这十年的数据就会过于耗时。这是如果把表中数据按照年份划分,查询2018年的数据就去对应年份的子表中查找,效率就会显著提高。
type
EXPLAIN输出的type列描述了表是如何连接的
在EXPLAIN 的所有结果列中,type 是最核心、最重要的指标。其类型可作为数据库查询性能的指标评判依据
| 访问类型 (type) | 性能等级 | 详细描述 | 触发场景举例 |
|---|---|---|---|
| system | 最优 | 表中只有一行数据。这是 const 类型的特例,通常出现在系统表或只有一条记录的临时表中。 | SELECT * FROM mysql.proxies_priv; |
| const | 优 | 通过主键(PRIMARY KEY)或唯一索引(UNIQUE INDEX)进行等值查询。MySQL 在查询开始时将其转换为一个常量,查询效率极高。 | WHERE id = 1; (id 为主键) |
| eq_ref | 优 | 在多表连接中,对于前一张表的每一行,后一张表通过主键或唯一非空索引只能找到唯一的对应行。 | JOIN table2 ON table1.id = table2.id; |
| ref | 良 | 使用普通索引(非唯一索引)或联合索引的前缀部分进行匹配,可能会查到多行数据。 | WHERE name = '张三'; (name 为普通索引) |
| fulltext | 特殊 | 使用全文索引(FULLTEXT)进行查询。 | WHERE MATCH(content) AGAINST('keyword'); |
| ref_or_null | 良 | 类似于 ref 访问,但增加了对 NULL 值的搜索。 | WHERE name = '张三' OR name IS NULL; |
| index_merge | 中 | 查询条件中使用了多个独立索引,MySQL 分别扫描这些索引并合并结果集。 | WHERE id = 1 OR status = 0; (id 和 status 分别有索引) |
| unique_subquery | 中 | 针对 IN 形式的子查询优化,子查询返回的字段是主键或唯一索引。 |
WHERE id IN (SELECT id FROM table2); |
| index_subquery | 中 | 类似于 unique_subquery,但子查询返回的是普通索引,非唯一。 | WHERE category_id IN (SELECT cat_id FROM category); |
| range | 差 (及格) | 索引范围扫描。利用索引检索给定范围内的行。 | WHERE id > 100; 或 WHERE id IN (1, 2, 3); |
| index | 差 | 全索引扫描。遍历整个索引树,虽然避免了全表扫描,但依然需要读取索引中的所有记录。 | SELECT id FROM table; (id 为索引,无需回表) |
| ALL | 最差 | 全表扫描。MySQL 从硬盘读取整个数据表进行比对,没有任何索引支持。 | WHERE age = 18; (age 字段无索引) |
possible_keys
possible_keys表示MySQL认为该查询可能用到的索引
possible_keys的值和真实使用的索引不一定一致,查询语句实际上使用的索引还是要以key的值为依据。
key
key表示实际上使用的索引
如果为NULL,则没用索引。优化时首要检查对象。依据情况来判断是否添加索引
key_len
key_len表示索引使用的字节长度
一般能够在保证索引生效,对表中数据产生过滤效果的情况下,索引的字节长度越短越好,其原因有三
A. 内存利用率更高 (Buffer Pool)
MySQL 的索引是存在 B+ 树里的,而 B+ 树的每一个节点(Page)大小是固定的(默认 16KB)。
-
索引越短:每个节点能容纳的索引键(Keys)就越多。
-
结果:索引树会变得更"矮胖",减少了树的层数,从而减少了查找时的 I/O 次数。
B. I/O 压力更小
索引文件存储在磁盘上。
- 短索引:索引文件体积小,从磁盘加载到内存的速度更快,占用的磁盘带宽也更少。
C. CPU 比较速度更快
数据库在查找时,需要不断地比较索引值。
- 比较一个 4 字节的整数,显然比比较一个 255 字节的字符串要快得多。
ref
ref表示索引引用的列,显示索引的哪一列被使用了,通常是一个常数
const或某个表的字段。
rows
rows表示预估扫描行数,数值越小,说明索引的过滤效果越好,性能通常越好。
filtered
filtered表示过滤百分比,数值越高说明索引的过滤效果越好,性能通常越好。
Extra
如果说type决定了查询的快慢,那么Extra就揭示了 MySQL 在执行过程中到底动用了哪些"秘密武器"或是踩到了哪些"性能坑"。
下面是对于Extra 类型的分析
| Extra 类型 | 性能评价 | 详细描述 | 优化建议 |
|---|---|---|---|
| Using index | 优 | 覆盖索引(Covering Index)。查询所需的全部字段都在索引树中,无需回表(通过主键查原始行数据)。 | 性能极佳,应尽量追求这种状态。 |
| Using index condition | 良 | 索引条件下推(ICP)。MySQL 会在存储引擎层先过滤索引,减少回表次数和 Server 层的数据处理量。 | MySQL 5.6 后的自动优化,通常表现良好。 |
| Using where | 中 | 服务器层在接收到存储引擎返回的行后,使用了 WHERE 子句进行过滤。 |
常见现象。如果 type 是 ALL,需检查是否漏掉索引。 |
| Using join buffer | 中 | 在多表连接中,连接字段没有索引,MySQL 使用了内存缓冲区来辅助连接(如 Block Nested Loop)。 | 建议在连接字段上添加索引。 |
| Using temporary | 差 | MySQL 需要创建一张临时表 来处理查询(常见于 DISTINCT, GROUP BY, UNION)。 |
性能消耗大,建议通过优化索引结构来消除临时表。 |
| Using filesort | 差 | 文件排序。MySQL 无法利用索引完成排序,必须在内存或磁盘中进行额外的排序操作。 | 性能杀手,应通过建立包含排序字段的索引来优化。 |
| Select tables optimized away | 优 | 优化器确定只需读取索引或系统表即可得出结果(如 SELECT MIN(id)),无需访问表数据。 |
极速响应,无需优化。 |
| Impossible WHERE | 逻辑错误 | WHERE 子句永远为假,查询不会返回任何行。 |
检查 SQL 逻辑是否有误,例如 WHERE id=1 AND id=2。 |
四,回表查询
当使用二级索引 (非主键索引)进行查询时,发现数据页中不能拿到我们想要的全部信息 (只包含了部分信息)时,这时候就需要进行回表查询 ,也就是重新对主键id对应的B+树再多做一次B+树扫描。
当需要回表的次数变多时,就会进行频繁的磁盘IO,影响性能
比如我们使用mail邮箱这个二级索引来进行查询,由于二级索引时为了辅助主键索引而存在的,其B+树的叶子节点中一般不会保存数据的全部信息,这个时候就会出现回表查询
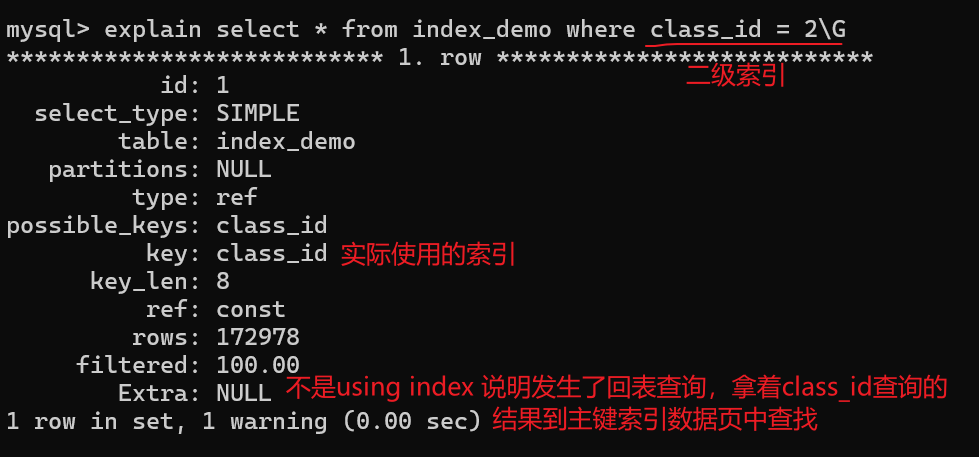
上图可以看到,即使我们使用了索引,但是由于回表查询,导致仍然需要查询17w条数据,所以要尽量避免回表查询哦~~
五,索引覆盖
索引覆盖是避免回表查询的一个有效手段,当我们查询的数据在索引的数据页中能够全部得到时,我们无需进行回表查询操作(数据拿不全的时候才回表)
下面就是一个使用sn(学号)作为辅助索引查询的结果,可以发现产生了索引覆盖
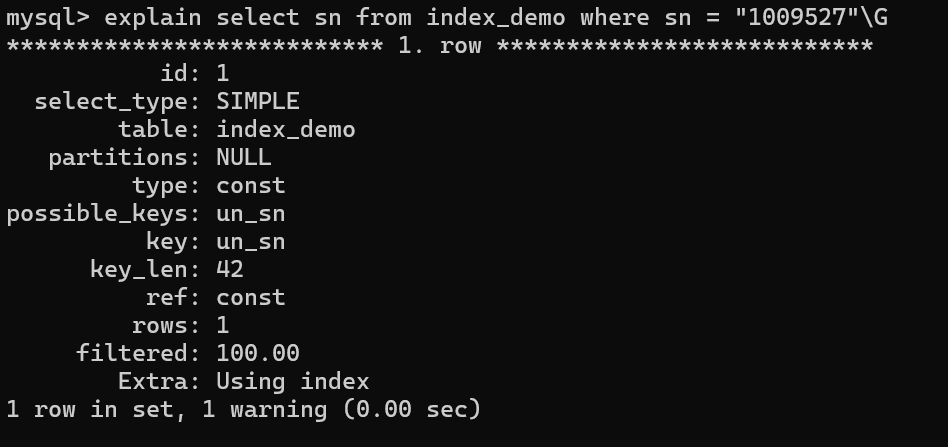
以下是一个总结关于如何避免回表查询
| 优化维度 | 具体操作 | 实现效果 |
|---|---|---|
| 查询字段 | 严禁使用 SELECT * |
仅选择索引包含的字段,是触发索引覆盖的前提。 |
| 索引设计 | 建立联合索引 | 将 WHERE 条件和 SELECT 字段共同加入索引中。 |
| 主键利用 | 利用二级索引自带主键的特性 | 二级索引的叶子节点默认包含主键 ID,查询 ID 时天然覆盖。 |
| 代码规范 | 保证类型匹配 | 避免因隐式类型转换导致索引失效,从而引发全索引扫描。 |