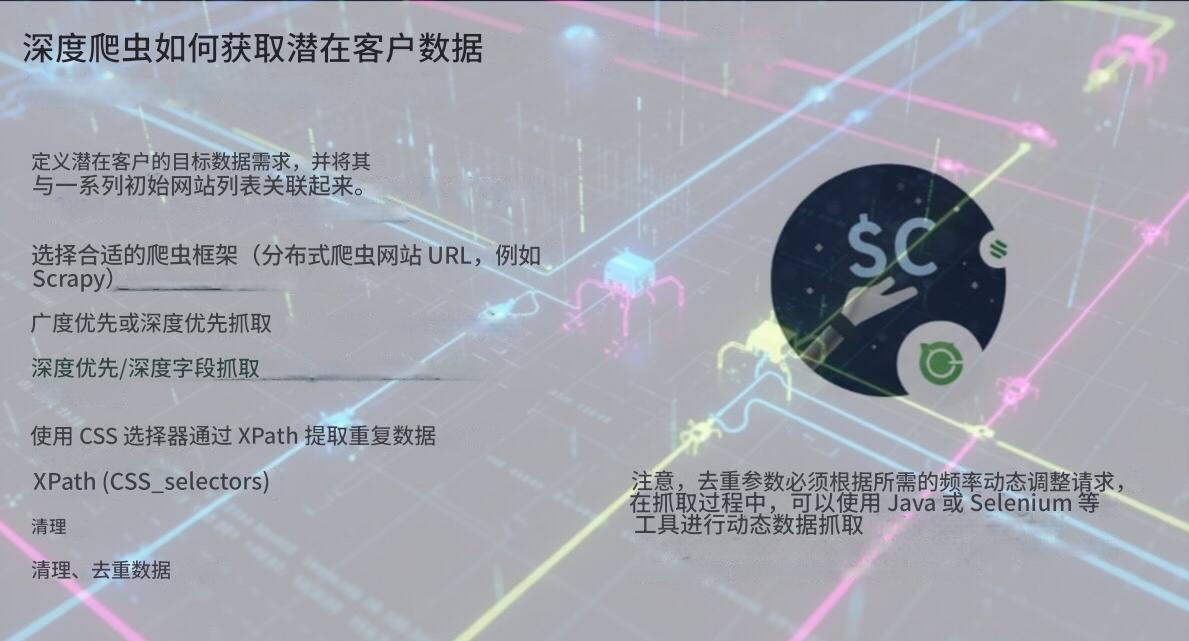
Selenium常用于网页爬取 为了提高爬取效率,可以采取以下优化措施:合理使用无头模式
Selenium常用于网页爬取 合理使用无头模式
如何优化 Selenium 的使用以提高爬取效率、数据清洗的具体步骤和常用工具
Selenium 的优化策略
Selenium 是一款功能强大的自动化测试工具,常用于网页爬取。直接使用 Selenium 可能会导致爬取效率低下,甚至被目标网站封禁。为了提高爬取效率,可以采取以下优化措施:合理使用无头模式(Headless Mode),减少界面渲染时间;设置合理的等待策略,如显式等待(Explicit Waits)或隐式等待(Implicit Waits),避免不必要的超时;可以结合浏览器扩展或代理IP轮换,降低被封禁的风险。通过这些优化,Selenium 的爬取效率将显著提升,同时还能减少对目标网站的干扰。
数据清洗的具体步骤
数据清洗是数据处理的重要环节,直接影响后续分析的准确性。以下是数据清洗的具体步骤: 数据导入 :从文件、数据库或 API 导入原始数据。 格式化数据 :统一日期格式、去除空值、多余空格和特殊字符。 去重 :根据标识字段剔除重复记录。 示例:df.drop_duplicates(subset='column_name', inplace=True) 处理缺失值 :填补缺失值(均值、中位数、特定值)或删除。 示例:df.fillna('Unknown', inplace=True) 类型转换 :确保数据类型一致,如将字符串转换为日期。 文本处理 :对文本进行去标点、大小写转换、分词等。
常用工具
数据清洗过程中,选择合适的工具能大幅提高效率。以下是常用工具:
- Pandas :强大的数据处理和分析库,适合数据清洗。
- OpenRefine :用于探索和清理数据的开源工具。
- NLTK / SpaCy :处理自然语言文本的库,可用于文本清洗。 这些工具不仅能简化清洗流程,还能处理复杂的数据转换和文本分析任务。
 实际应用场景
在实际应用中,优化 Selenium 和数据清洗的流程能显著提升数据采集的效率和质量。例如,在电商数据爬取中,通过无头模式和多线程结合,可以快速获取商品信息;随后使用 Pandas 进行数据清洗,剔除重复记录并填补缺失值,最终得到结构化的数据集。这种组合不仅节省时间,还能确保数据的准确性,为后续分析提供可靠基础。