20 世纪 80 年代末,研究者开始探索基于数据驱动的统计机器翻译(Statistical Machine Translation, SMT)方法。1990 年,IBM Watson 的研究者在《Computational
Linguistics》上发表了题为《A Statistical Approach to Ma- chine Translation》的论文,这标志着统计机器翻译的诞生。
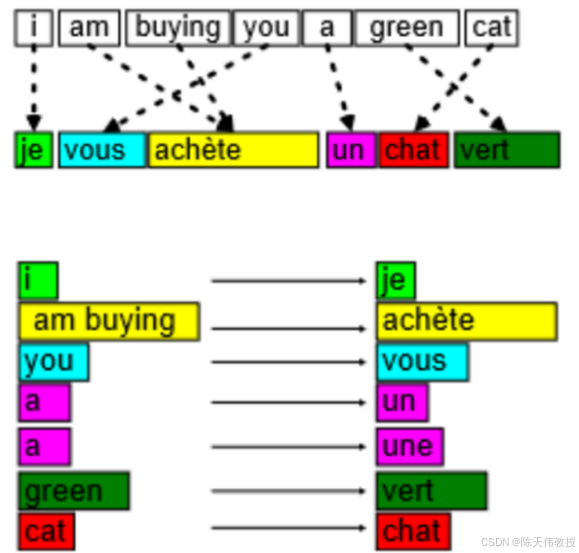
统计机器翻译中的短语对齐与词典构建。
SMT 的核心思想是利用大量平行语料库来学习不同语言之间的对应关系。平行语料库是指两种语言中一一对应的句子对。例如,中文的"我吃饭了"对应英文的"I have eaten",这两句话构成了平行语料库的一个样本。通过统计大量这样的句子对,机器能够学习到源语言和目标语言之间的短语对齐关系,并基于这些关系构建词典。
如图所示,SMT 系统首先将源语言和目标语言中的短语进行对齐,并基于这种对齐关系学习短语之间的对应模式。在实际系统中,短语之间的对应关系往往不是一一对应的,可能出现"一对多"或"多对一"的情况。为了处理这种复杂性,系统会生成多种可能的翻译组合,并通过语言模型选择概率最高的翻译结果。图 展示了 SMT 系统的基本框架。
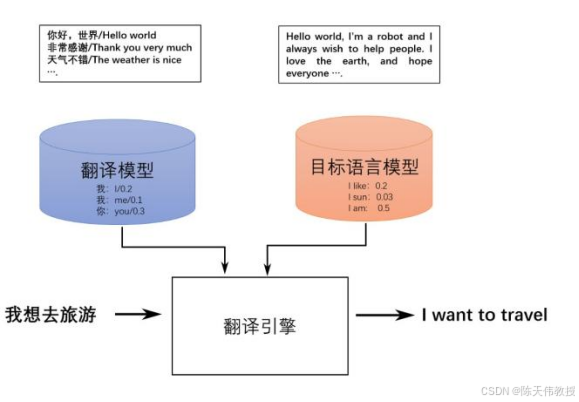
统计机器翻译框架。翻译模型存储了对应短语,用于短语层次的翻译;目标语言模型存储了目标语言的语言学知识,用于选择最通顺的翻译方式
统计机器翻译方法在概念上延续了传统规则方法中的"词典"和"规则",但区别在于:SMT 中的词典和规则不再是人为设计的,而是通过数据驱动的方式学习得到的,并以概率模型的形式表示。这种概率化的方法使得 SMT 在面对复杂语言现象时具有更强的灵活性。
尽管SMT 技术取得了显著进展,但仍然存在一些局限性。首先,它对平行语料库的依赖较强,数据的质量和覆盖范围直接影响翻译效果。其次,在处理长句或复杂句式时,SMT 常常会出现语义不连贯或翻译生硬的问题。即便如此,在神经机器翻译兴起之前,SMT一直是机器翻译领域的主流技术。