如何优化机器学习模型的训练速度?------从基础知识到具体实现
在机器学习的实际应用中,训练速度是一个关键的性能指标。提高训练速度不仅能大幅节省开发时间,还能提高实验的迭代效率。本文将从基础知识入手,逐步介绍优化训练速度的思路、框架,并最终深入到具体的工具准备、环境部署和代码实现。
一、机器学习模型训练的基本概念
1.1 机器学习模型训练流程
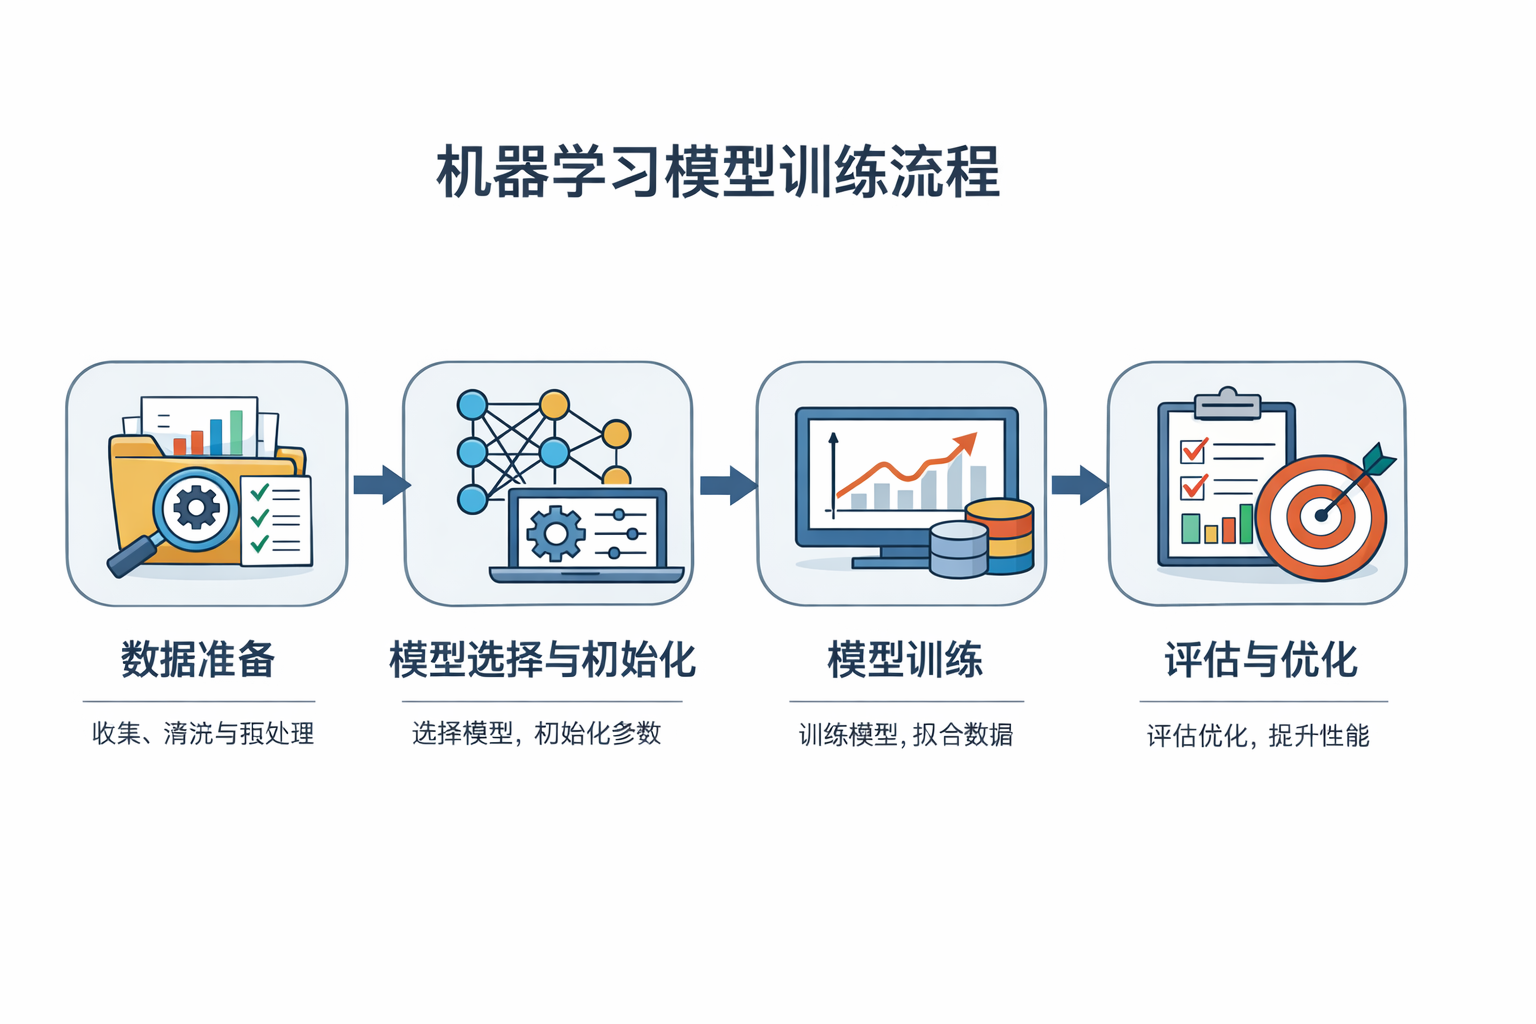
机器学习模型训练过程的基本步骤包括:
- 数据准备:收集、清洗和预处理数据。
- 模型选择与初始化:选择合适的模型,初始化模型参数。
- 模型训练:使用训练数据来拟合模型。
- 评估与优化:评估模型的表现并进行优化,直到模型达到满意的效果。
训练过程的每一阶段都可能成为瓶颈,尤其是数据量庞大时,训练速度往往变得非常缓慢。
1.2 影响训练速度的因素
- 数据质量与大小:数据越多,训练时间越长。
- 特征工程:特征选择与处理不当会增加计算负担。
- 模型复杂度:复杂模型(如深度神经网络)训练速度较慢。
- 硬件配置:CPU、GPU性能以及内存大小对训练速度有显著影响。
二、优化思路与整体框架
2.1 优化策略概述
优化训练速度的思路可以从以下几个方面进行:
- 数据处理优化:通过数据清洗、压缩和批处理等方式减少数据的计算量。
- 算法选择与模型调优:选择高效的算法、合理调整超参数,避免不必要的计算。
- 硬件加速:利用GPU、TPU等硬件进行计算加速。
- 分布式训练:利用多个计算节点进行并行计算,加速训练过程。
2.2 整体框架
本篇文章的框架如下:
- 数据预处理:我们将介绍如何优化数据准备阶段,减少数据加载和预处理的时间。
- 模型优化:如何选择合适的算法,并调节模型参数以减少训练时间。
- 硬件加速:如何利用GPU、TPU等硬件加速训练。
- 分布式计算:如何通过分布式训练加速大规模数据集的训练过程。
- 总结与展望:总结本篇文章的优化策略,并展望未来的优化技术。
三、实现细节:工具准备与环境部署
3.1 工具准备
在开始实现之前,确保你的开发环境中安装了以下工具和库:
- Python:推荐使用Python 3.6及以上版本。
- 机器学习框架:如TensorFlow、PyTorch,或者Scikit-learn。
- 数据处理工具:如Pandas、NumPy,支持高效的数据处理。
- 硬件加速支持:如CUDA支持的GPU,或Google Colab/TPU。
bash
pip install tensorflow scikit-learn pandas numpy3.2 环境部署
-
GPU支持:如果使用NVIDIA GPU进行加速,确保安装了CUDA和cuDNN。
- 安装CUDA:
https://developer.nvidia.com/cuda-downloads - 安装cuDNN:
https://developer.nvidia.com/cudnn
- 安装CUDA:
-
使用GPU加速(以TensorFlow为例):
python
import tensorflow as tf

# 检查是否有可用的GPU
print("Num GPUs Available: ", len(tf.config.experimental.list_physical_devices('GPU')))- 配置分布式训练环境:如使用多台机器或多个GPU进行并行计算,TensorFlow和PyTorch均提供了分布式训练的支持。
3.3 环境测试
在开始训练之前,确保你的环境设置正确,可以通过一个简单的计算任务来测试硬件加速是否有效。
python
import tensorflow as tf

# 运行一个简单的模型,检查GPU是否被正确使用
model = tf.keras.Sequential([tf.keras.layers.Dense(10, activation='relu', input_shape=(784,))])
model.compile(optimizer='adam', loss='sparse_categorical_crossentropy', metrics=['accuracy'])

# 模拟训练
model.fit(x_train, y_train, epochs=1)
四、数据预处理优化:减少数据加载与处理的瓶颈
4.1 数据清洗与规范化
数据预处理是影响训练速度的重要环节。优化数据清洗和规范化操作,可以减少训练过程中的计算开销。常见的优化手段包括:
- 数据去重与缺失值填充:清除不必要的数据或填充缺失值。
- 特征规范化:通过标准化或归一化将数据的范围控制在一定范围内。
4.2 数据批处理与流式读取
当数据量过大时,通过批处理加载数据而非一次性加载整个数据集,可以有效避免内存瓶颈。
python
# 使用Pandas进行批处理
batch_size = 1000
for i in range(0, len(df), batch_size):
    batch = df.iloc[i:i+batch_size]
    # 对每一批数据进行处理
4.3 数据存储与加载优化
使用高效的数据格式(如HDF5、Parquet)可以加快数据的加载速度。
五、模型优化:选择高效算法与调参
5.1 模型选择
在机器学习中,选择一个高效的算法是优化训练速度的关键。对于分类任务,使用决策树或随机森林可能比使用深度神经网络(DNN)要更高效。
5.2 超参数调优
通过网格搜索或随机搜索调整超参数,可以在不增加过多计算开销的情况下,显著提高训练效率。
python
from sklearn.model_selection import GridSearchCV

# 超参数网格搜索
param_grid = {'max_depth': [10, 20, 30], 'n_estimators': [50, 100]}
grid_search = GridSearchCV(estimator=RandomForestClassifier(), param_grid=param_grid)
grid_search.fit(X_train, y_train)
六、硬件加速:GPU与TPU
6.1 GPU加速
利用GPU进行训练加速,可以大幅提高深度学习模型的训练速度。TensorFlow、PyTorch等框架已经内置了GPU加速支持,只需要配置好相应环境,即可无缝使用。
python
# TensorFlow自动使用可用的GPU
device = tf.config.experimental.list_physical_devices('GPU')
if len(device) > 0:
    print("GPU is available!")
6.2 TPU加速
对于大型模型,可以考虑使用Google Cloud的TPU。TPU的计算能力远超GPU,对于深度学习任务尤其适用。
七、总结与展望
优化机器学习模型的训练速度,不仅需要从数据、算法和硬件三方面进行综合优化,还要合理利用现代计算资源。随着硬件技术的不断进步,未来的训练速度将更加迅速,而如何结合不同的硬件和算法进行高效的训练,将是机器学习研究人员和开发者需要不断探索的问题。