大模型架构演进:从Transformer到MoE

大模型架构演进:从Transformer到MoE

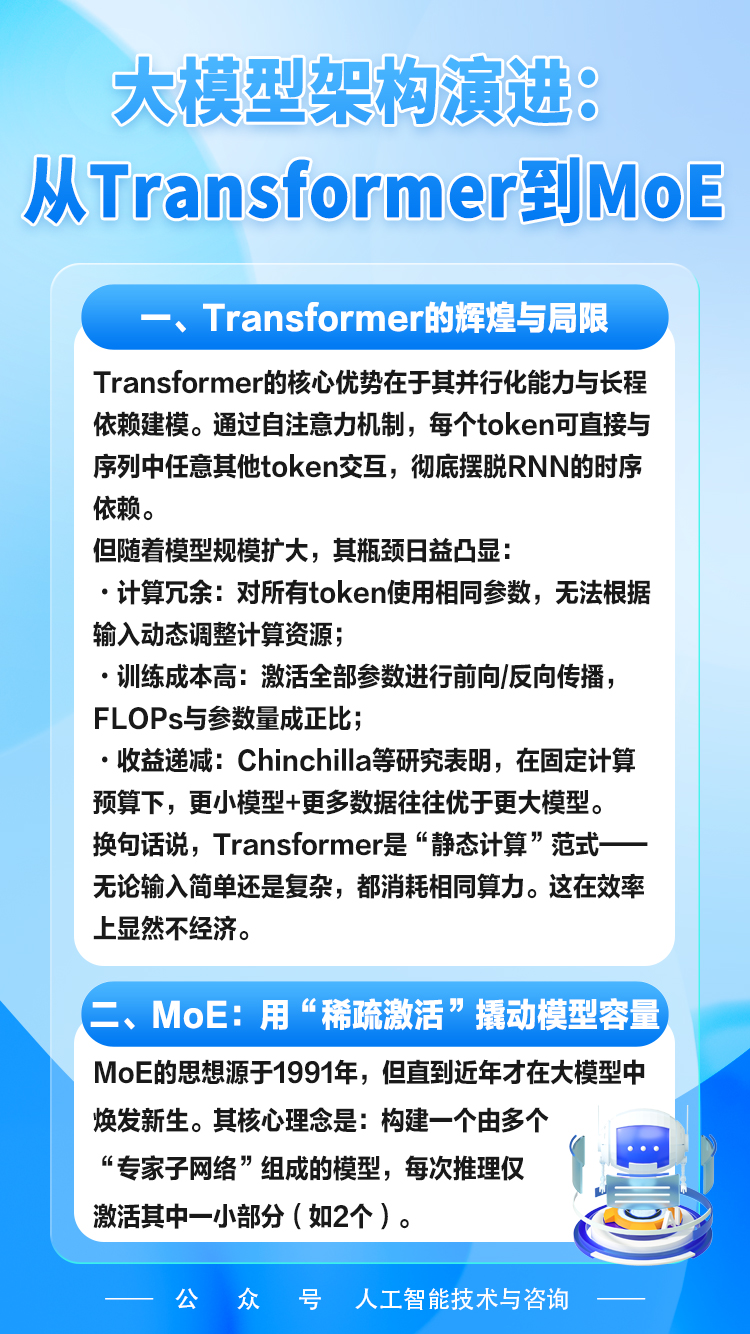
一、 Transformer的辉煌与局限

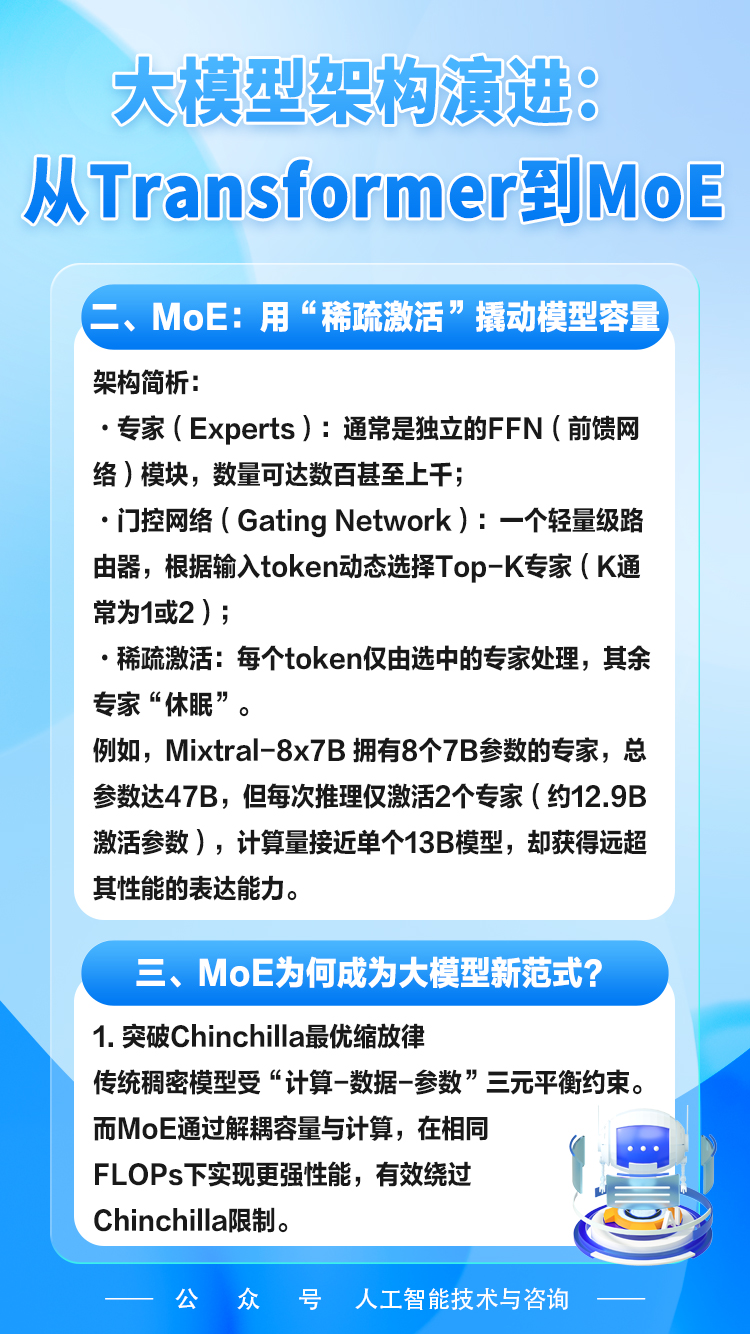
二、 MoE:用"稀疏激活"撬动模型容量

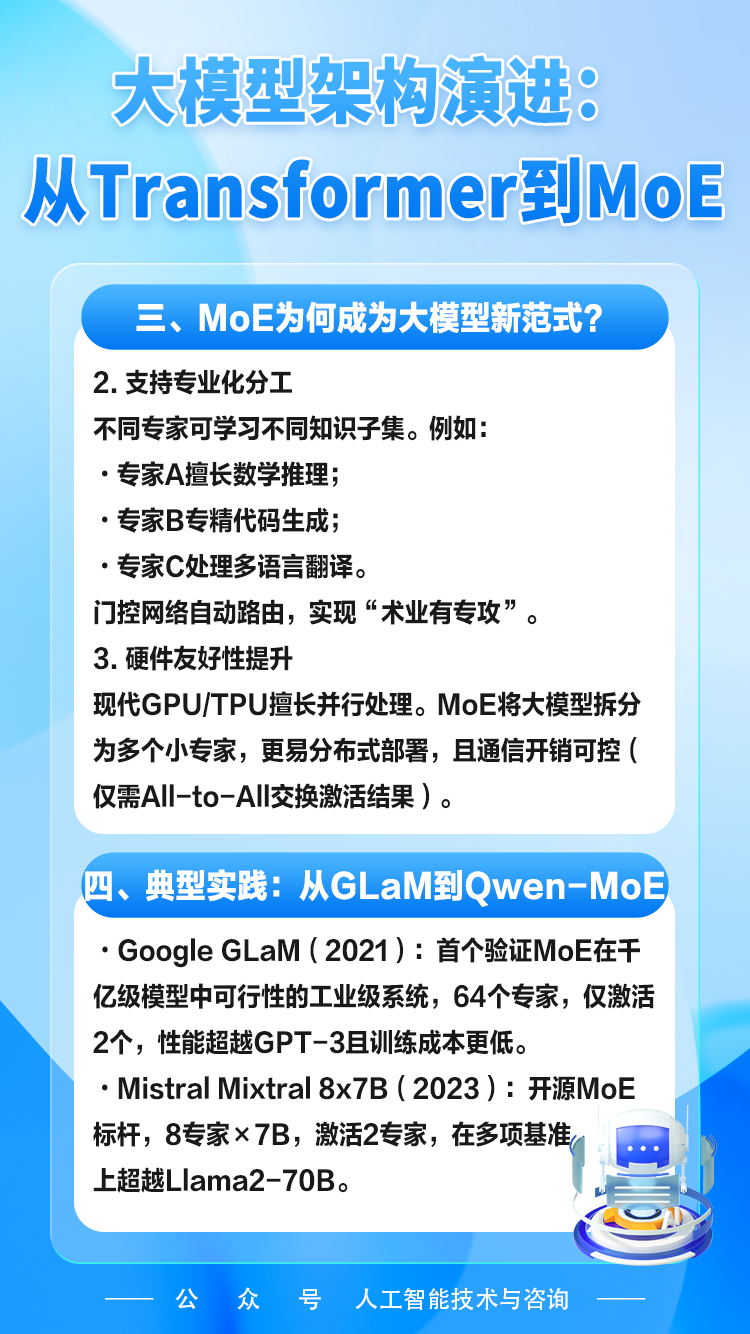
三、 MoE为何成为大模型新范式?

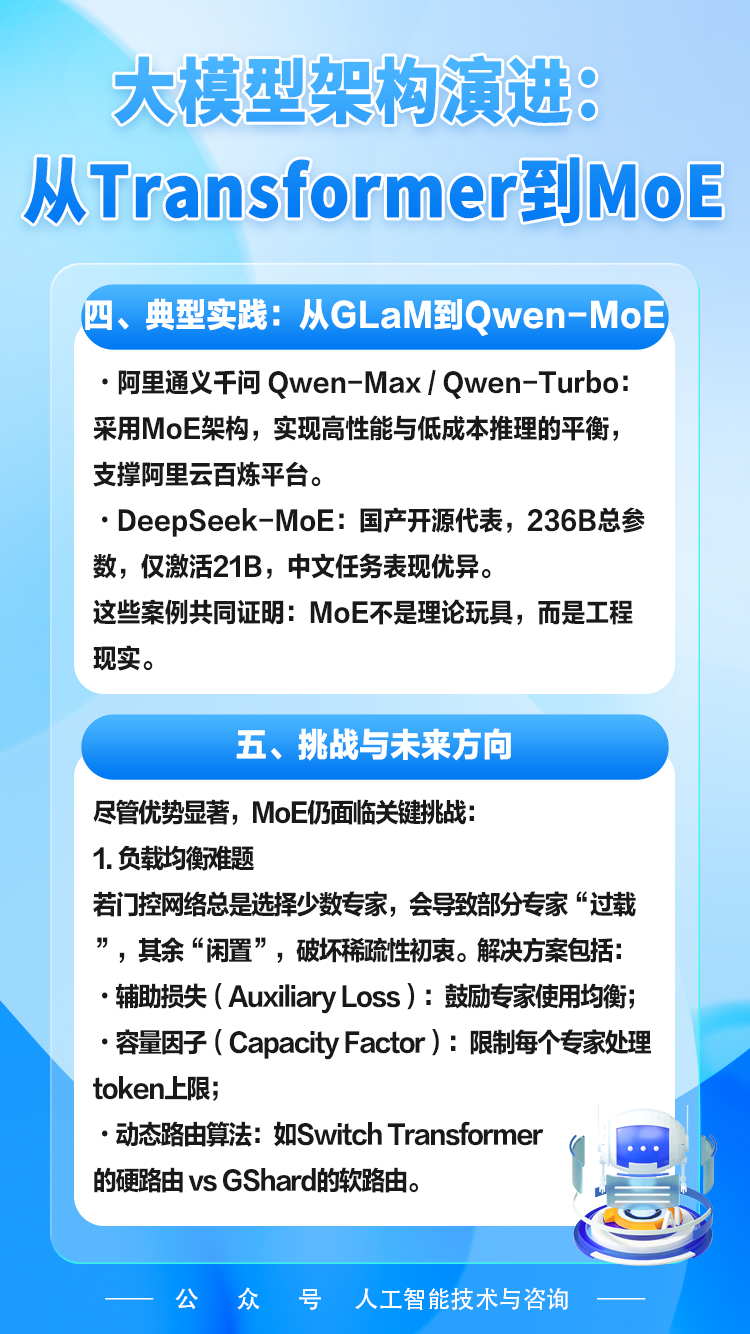
四、 典型实践:从GLaM到Qwen-MoE

五、 挑战与未来方向
​

相关推荐
攒了一袋星辰2 小时前
AI 求职长期记忆原理解析:从碎片经历到贝叶斯能力星图
知识图谱·agent·rag·ai工程·校招面试
意念回复2 小时前
从 RNN 到 GQA:自注意力与多头注意力机制全解析
人工智能·rnn·深度学习
哈尔滨张谦蛋1 天前
兰州大学 · 甘肃省可穿戴装备重点实验室 · 2027年博士招生
人工智能·深度学习
chh5631 天前
从 BERT 到大模型:让模型从“会接龙”到“会回答
人工智能·深度学习·bert
龙腾AI白云2 天前
具身智能的空间导航与未知环境探索
大数据·数据库·人工智能·机器学习·知识图谱
汤姆宝库2 天前
RoPE旋转位置编码的实现与长上下文外推
python·深度学习·机器学习
tellmewhoisi2 天前
深度学习0:数学知识:(L1正则化和L2正则化)
人工智能·深度学习
AI小怪兽2 天前
你的视觉基础模型会说“植物语“吗?面向目标检测的视觉基础模型植物语法
人工智能·深度学习·机器学习
罗西的思考3 天前
【轻量化复现大模型 / KIMI K3】MTP / EAGLE‑3 模块交互式演示
人工智能·深度学习·算法