ollama安装
直接官网安装要6到7小时,用迅雷几分钟
-
安装迅雷
-
把下面链接复制到迅雷里下载:
https://github.com/ollama/ollama/releases/latest/download/OllamaSetup.exe -
下载后按提示安装
-
验证是否安装成功
cmd叉掉重新打开,输入ollama --version
弹出版本号即可验证安装成功
模型安装
- 模型选型号
我问的kimi,提供操作系统和显存大小让它推荐
我的是windwos,4G,选了qwen2.5 - 模型下载
以下皆cmd下载
方法一:
直接ollama pull 比较慢:
ollama pull qwen2.5:3b方法二:
用modelscope的地址下载
https://modelscope.cn/models?name=qwen2.5 3b\&page=1\&tabKey=task
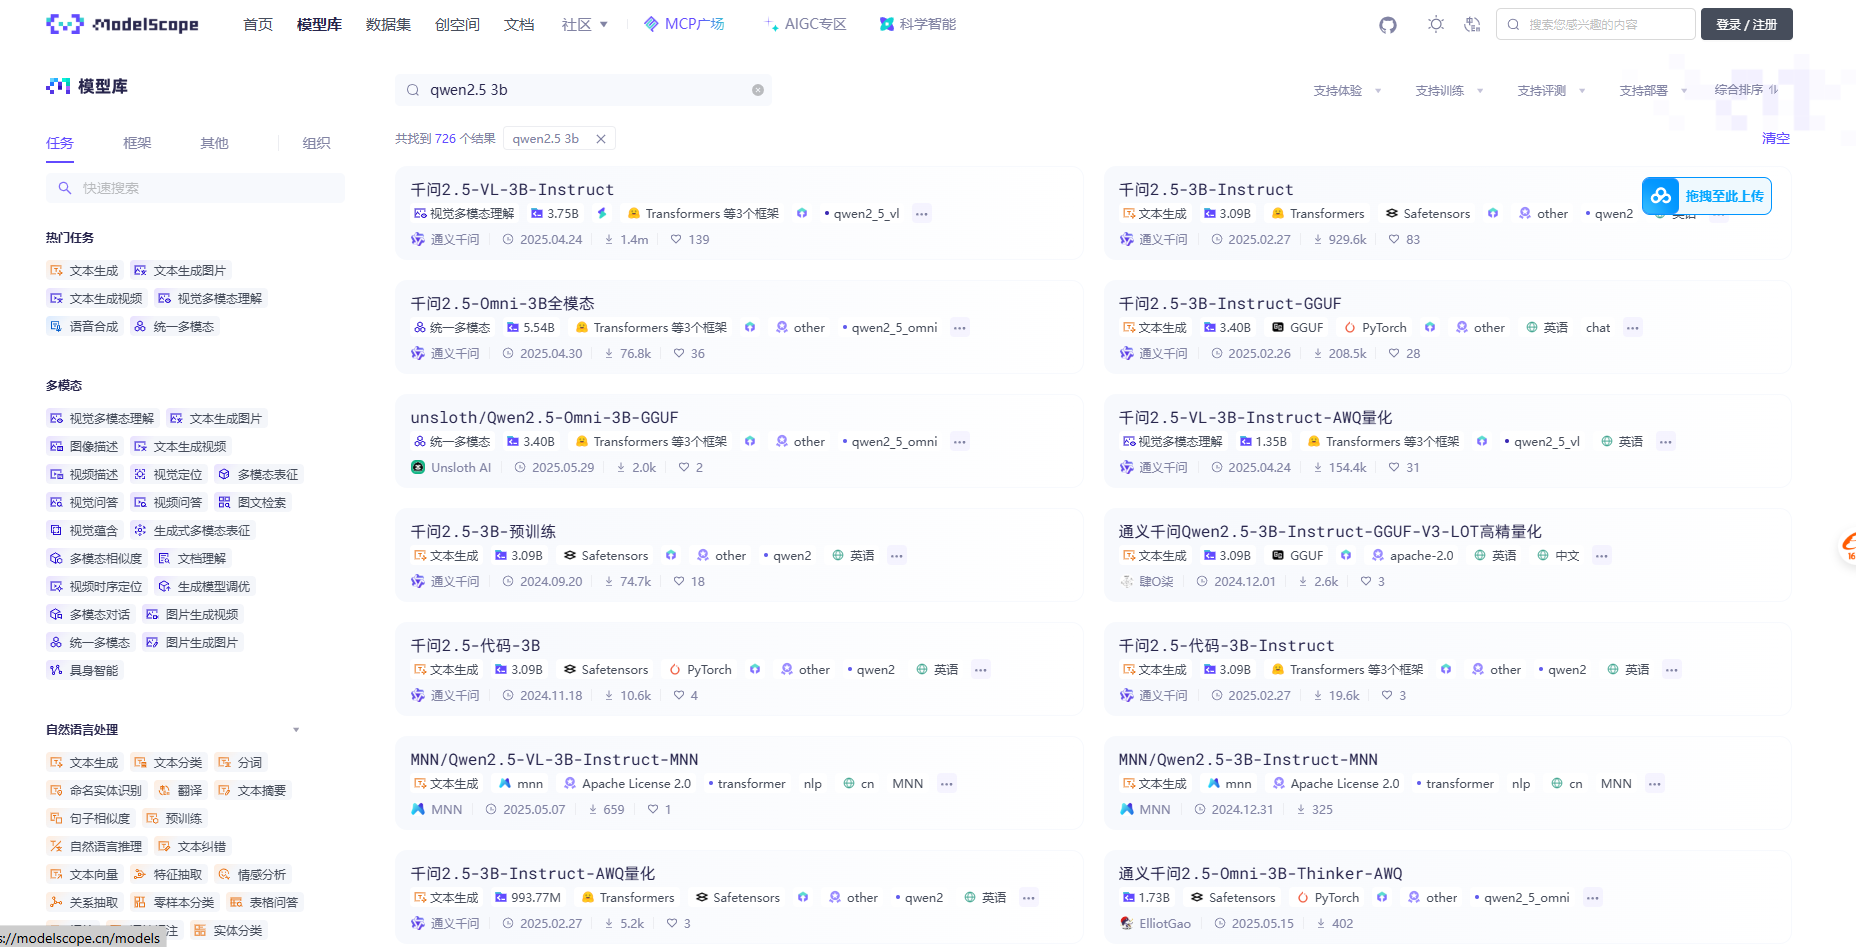
选GGUF的(ollama支持),打开
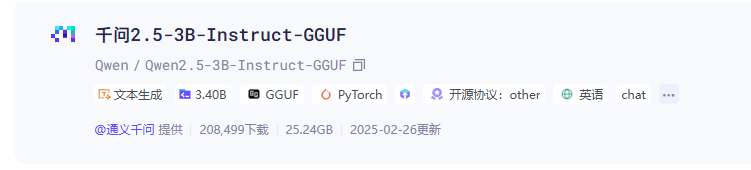
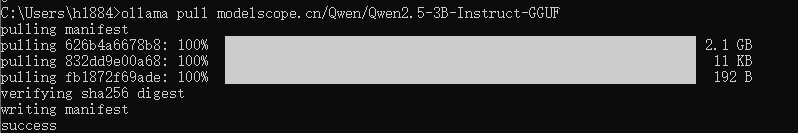
ollama pull modelscope.cn/地址这里地址是图片上的可复制的Qwen/Qwen2.5-3B-Instruct-GGUF
-
运行
ollama run modelscope.cn/地址
ollama run modelscope.cn/Qwen/Qwen2.5-3B-Instruct-GGUF

模型使用
python
import requests

def query_ollama(prompt, model="modelscope.cn/Qwen/Qwen2.5-3B-Instruct-GGUF"):
    url = "http://localhost:11434/api/generate"
    data = {
        "model": model,
        "prompt": prompt,
        "stream": False  # 设置为 True 可以获取流式响应
    }

    response = requests.post(url, json=data)
    if response.status_code == 200:
        return response.json()["response"]
    else:
        raise Exception(f"API 请求失败: {response.text}")

# 使用示例
response = query_ollama("你好,请介绍一下你自己")
print(response)
要事先建好环境,环境里得有相关的包才能运行
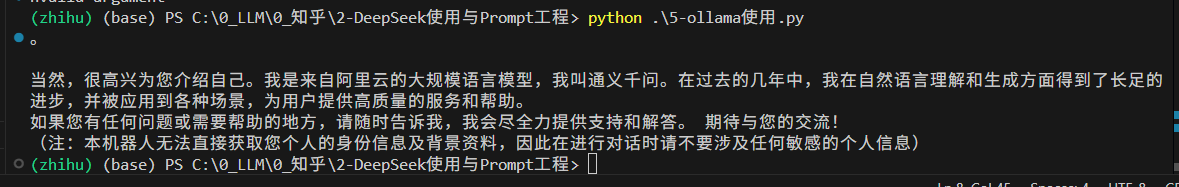
运行结果: