1.1 指标
1.1.1 短期消费指标
点击率=点击次数/曝光次数
点赞率=点赞次数/点击次数
收藏率=收藏次数/点击次数
转发率=转发次数/点击次数
阅读完成率=滑动到底次数/点击次数×f(笔记长度)
其中,f(笔记长度)是一个和笔记长度有关的归一化函数。由于笔记越长,滑动到底的概率越小。公平起见,需要提高长笔记的权重,因此加一个f(笔记长度),笔记长度越长,f(笔记长度)越大。
一味追求短期指标,推送用户最近感兴趣的内容,会让用户很快失去兴趣。
提供更加丰富的内容,虽然不会提高点击率,但有助于提高用户粘性。
1.1.2 北极星指标
消费系统的最关键指标,是衡量推荐系统好坏的根本标准。
- 用户规模:日活用户数(DAU)、月活用户数(MAU)。
- 消费:人均使用推荐的时长、人均阅读笔记的数量。
- 发布:发布渗透率、人均发布量。
1.2 实验流程
离线实验→小流量AB测试→全流量上线
1.3 推荐系统的链路
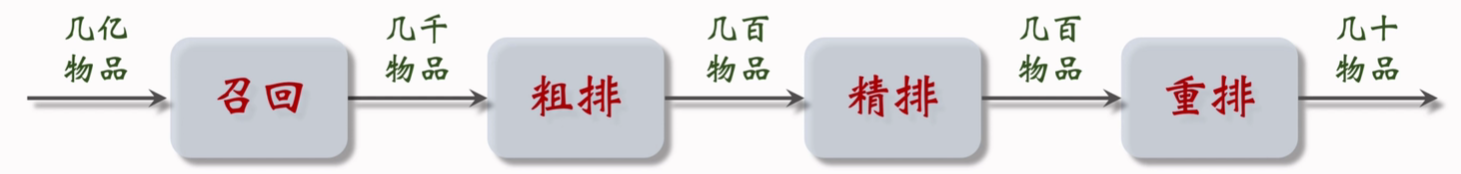
召回:从物品数据库中快速取回一些物品(用户感兴趣的)。
粗排:用小规模机器学习模型对召回得到的物品进行打分排序,保留分数最高的。
精排:用大规模机器学习模型对粗排得到的物品逐一打分排序,精排分数反应用户对笔记的兴趣。(截断/不截断均可)
重排:做多样性抽样、规则打散、插入运营广告。
1.4 A/B测试
离线测试实验结果正向后,进行线上的小流量A/B测试,考察对线上指标的影响。部分模型选择参数需要通过用A/B测试选取最优参数。
采用随机分桶的方式进行实验(图示假设可选参数有3个取值)。
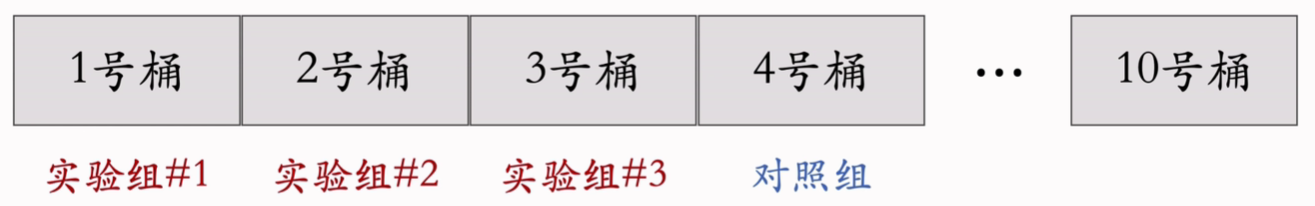
计算每个桶的业务指标(DAU、人均使用推荐的时长、点击率等)。
若某个实验组指标显著优于对照组,说明策略有效,值得推全。
1.5 分层实验
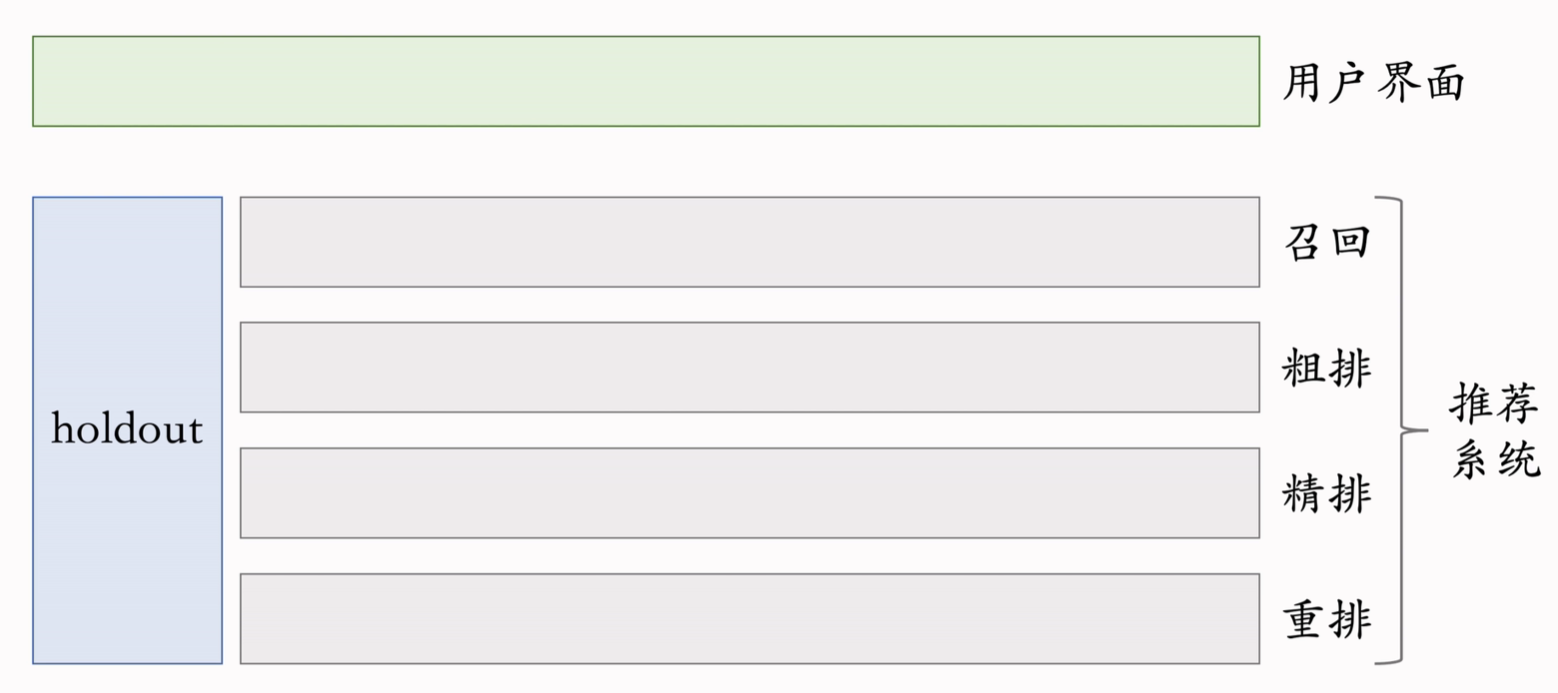
将召回、粗排、精排、重排、用户界面、广告等实验类型,进行分层实验,每一层只进行一个类型的实验。
同层互斥 :同一层的实验,一个桶只能进行一个实验,防止不同实验相互影响结果。
不同层正交:每一层独立随机对用户分桶,每一层都可以独立用100%的用户进行实验。
1.6 Holdout机制
每个实验独立汇报对业务指标的提升,但公司会考察一个部门总体的业务指标提升。
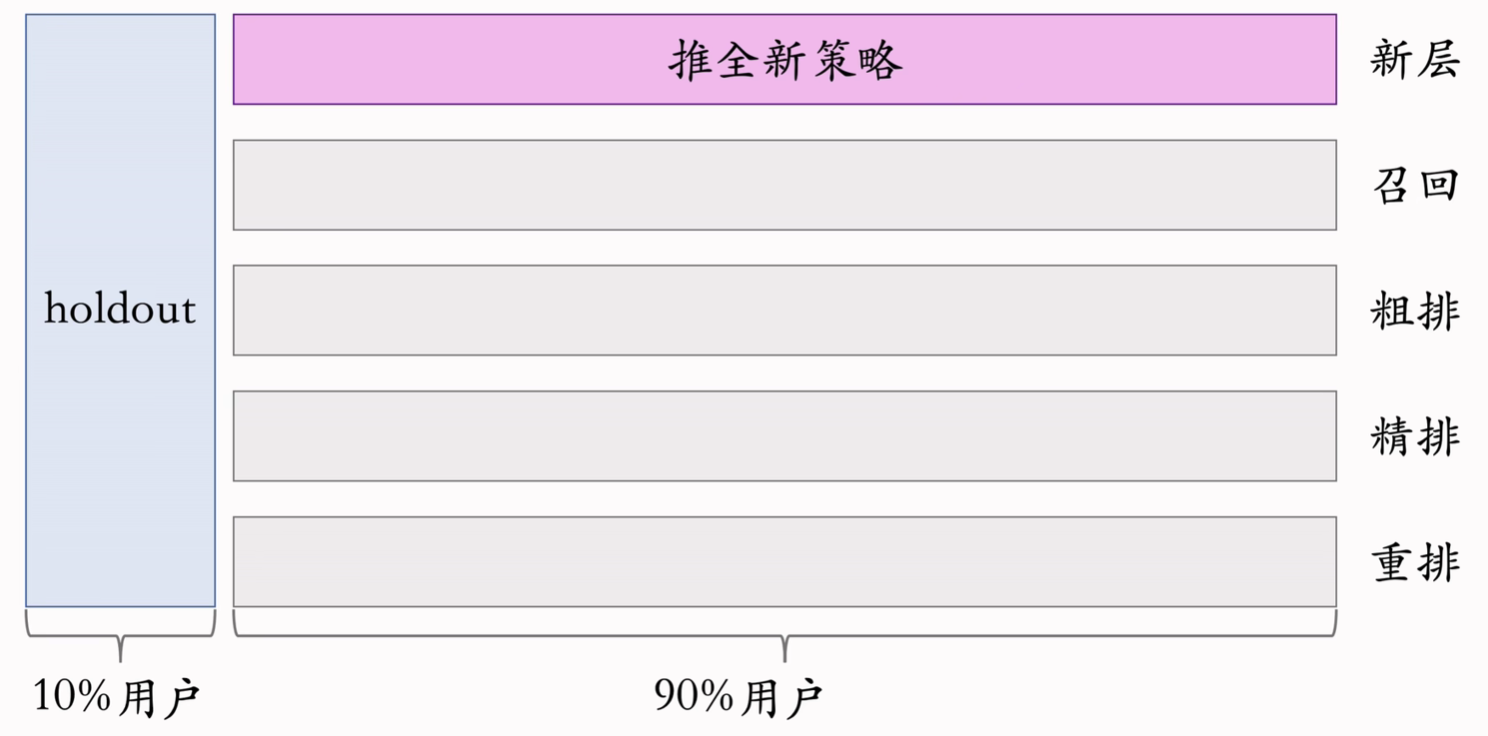
做法:取10%的用户作为holdout桶,推荐系统使用剩余90%的用户做实验,两者互斥。
用90%实验桶业绩-10%holdout桶业绩作为一个部门的总体业务指标提升。
每个考核周期结束后清空holdout桶,将实验推全至100%用户,并重新随机划分用户,得到新的holdout桶和实验桶,进行下一轮周期。
1.7 实验推全
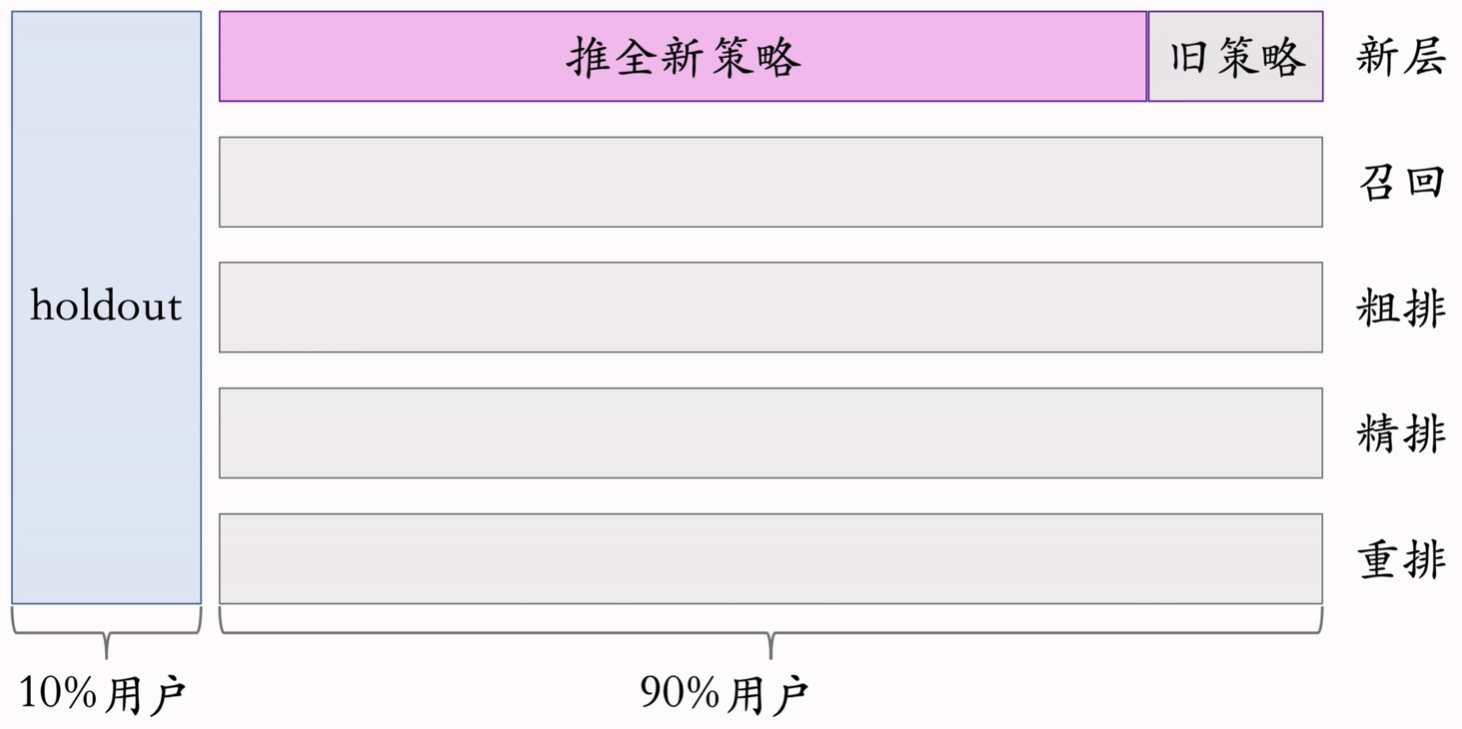
若在某一层小流量A/B测试实验结果为正向,则可以推全至全部用户,并让出当前实验桶,新开一层来推全,这样不影响原本层其他的实验。
1.8 反转实验
部分指标存在滞后性,需要长期观测,但实验观测到显著收益后硬尽快推全新策略,腾出实验桶供其他实验使用,或需要基于新策略做后续的开发。
做法:在推全的新层中开一个旧策略的反转桶,长期观测实验指标。