文章目录
引言
在大规模分布式系统,特别是金融级应用中,集中化的日志监控是保障系统可观测性与稳定性的关键。ELK栈是解决这一问题的经典方案。
核心架构设计
本次部署采用 Filebeat + Redis + 双Logstash管道 + Elasticsearch 的架构,旨在实现日志收集的解耦、缓冲与高可用。
架构流程图:
[应用服务器A] --(Filebeat)--> [Logstash管道1] --> [Redis队列] --> [Logstash管道2] --> [Elasticsearch]
[应用服务器B] --(Filebeat)--> (同一套) (同一套)组件角色解析:
- Filebeat:部署在每台应用服务器上,作为轻量级日志采集器,负责读取指定路径的日志文件。
- Logstash管道1:作为"生产者",接收来自多个Filebeat的日志数据,进行初步处理后,写入Redis作为缓冲队列。
- Redis :作为高性能内存队列,用于缓存日志数据。这有效地解耦了日志生产端和消费端,防止Elasticsearch或网络抖动直接影响前端应用。
- Logstash管道2:作为"消费者",从Redis队列中取出日志,进行最终处理后,写入Elasticsearch。
- Elasticsearch:负责日志数据的存储、索引和检索。
环境与软件准备
本次实战基于以下版本(请根据实际情况调整):
- 操作系统:Linux (x86_64)
- Redis: 6.2.6
- Elastic Stack: 7.15.1 (包含 Elasticsearch, Logstash, Filebeat)
下载地址:
https://download.redis.io/releases/redis-6.2.6.tar.gz
https://artifacts.elastic.co/downloads/beats/filebeat/filebeat-7.15.1-linux-x86_64.tar.gz
https://artifacts.elastic.co/downloads/logstash/logstash-7.15.1-linux-x86_64.tar.gz
https://artifacts.elastic.co/downloads/elasticsearch/elasticsearch-7.15.1-linux-x86_64.tar.gz
分步安装与配置
第一步:部署Redis缓冲队列
-
安装 :上传安装包,解压后进入目录执行
make && make install。 -
配置 :复制默认配置文件
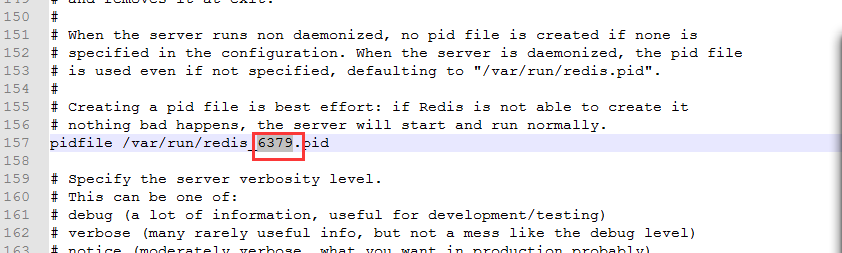
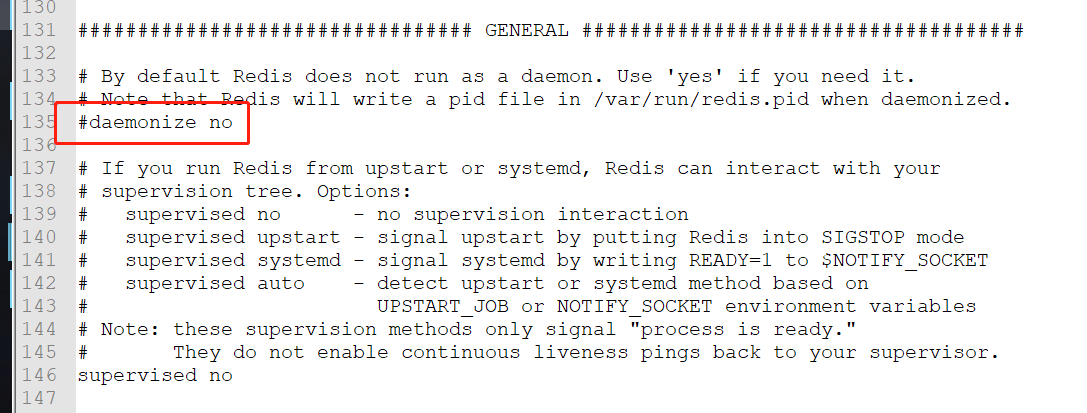
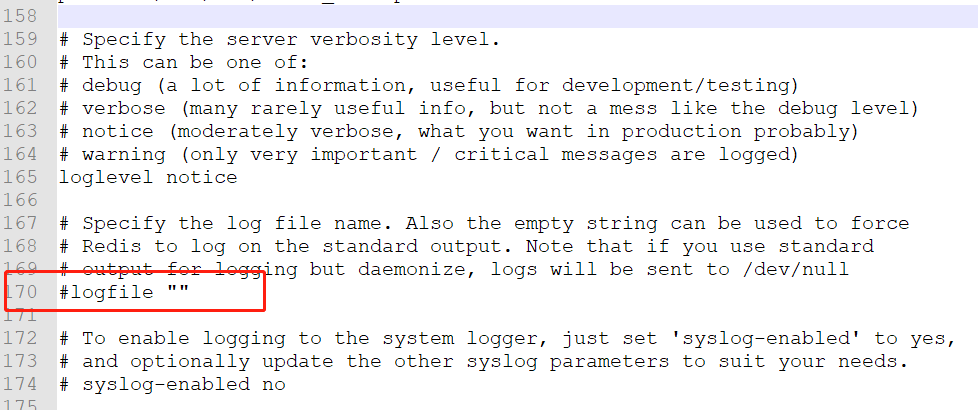
redis.conf为6379.conf,并修改以下几处关键配置:properties# 绑定IP,根据实际情况设置(生产环境建议绑定内网IP) bind 192.168.x.x # 保护模式,如果设密码可关闭 protected-mode yes # 设置访问密码,这是必须的! requirepass your_strong_password_here # 以守护进程运行 daemonize yes # 指定日志文件和进程ID文件 logfile "/var/log/redis/redis-6379.log" pidfile /var/run/redis_6379.pid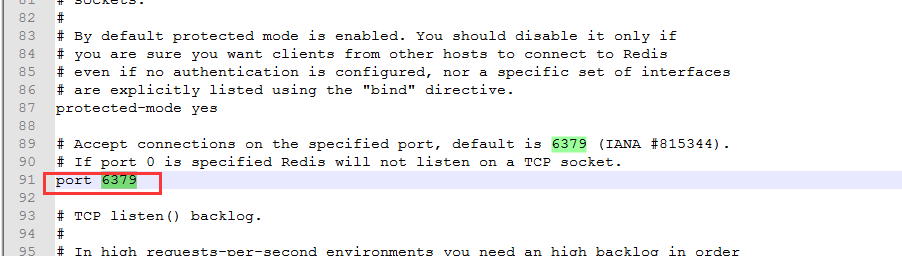
-
启动 :
./redis-server 6379.conf
第二步:部署Elasticsearch存储与检索引擎
因为安全问题elasticsearch 不让用root用户直接运行,所以使用非root用户。具体操作如下:
bash
添加es用户
useradd es -m
设置es用户密码
passwd es
另外,es用户拥有的可创建文件描述的权限太低,至少需要65536,处理办法: #切换到root用户修改
vim /etc/security/limits.conf # 在最后面追加下面内容
es hard nofile 65536
es soft nofile 65536 #*** 是启动es的用户
max_map_count文件包含限制一个进程可以拥有的VMA(虚拟内存区域)的数量
处理办法: #切换到root用户修改
vim /etc/sysctl.conf # 在最后面追加下面内容
vm.max_map_count=655360
执行 sysctl -p
1、登录服务器,将elasticsearch-7.15.1-linux-x86_64.tar.gz上传至服务器,使用root用户执行
chown -R es:es elasticsearch-7.15.1-linux-x86_64.tar.gz
然后解压(tar -xzvf elasticsearch-7.15.1-linux-x86_64.tar.gz)产生文件夹elasticsearch-7.15.1
2、进入目录elasticsearch-7.15.1/config,修改elasticsearch.yml 文件。修改的主要内容:
#节点名称
node.name: es
#设置当前的ip地址,如果配置集群通过指定相同网段的其他节点会加入该集群中
network.host: 192.168.xx.xx
#设置对外服务的http端口
http.port: 9200
#集群节点名
cluster.initial_master_nodes: ["es"]
#以下内容添加在文件最后
http.cors.enabled: true
http.cors.allow-origin: "*"
http.cors.allow-headers: Authorization
xpack.security.enabled: true
xpack.security.transport.ssl.enabled: true
3、首次启动,不要关闭程序,直到设置密码之后再重启
./bin/elasticsearch
4、设置密码(均设置成相同的即可)
./bin/elasticsearch-setup-passwords interactive
第三步:部署双Logstash管道
我们将Logstash部署两份,扮演不同角色。
-
解压并复制 :
bashtar -xzvf logstash-7.15.1-linux-x86_64.tar.gz cp -r logstash-7.15.1 logstash-producer cp -r logstash-7.15.1 logstash-consumer -
配置生产者管道 (
logstash-producer/config/producer.conf) :rubyinput { beats { port => 5044 } } filter { # 可在此处添加公共的过滤逻辑,如grok解析 } output { redis { host => "localhost" port => 6379 password => "your_strong_password_here" db => 0 data_type => "list" key => "logstash" } } -
配置消费者管道 (
logstash-consumer/config/consumer.conf) :rubyinput { redis { host => "localhost" port => 6379 password => "your_strong_password_here" db => 0 data_type => "list" key => "logstash" } } filter { # 可在此处进行最终的数据处理和富化 } output { elasticsearch { hosts => ["http://ES服务器IP:9200"] index => "%{[@metadata][type]}-%{+YYYY.MM.dd}" user => "elastic" password => "你设置的elastic用户密码" } } -
启动 :分别进入两个目录,执行
bin/logstash -f config/对应配置文件.conf。
第四步:部署Filebeat日志采集器
在需要收集日志的应用服务器上部署Filebeat。
-
核心配置 (
filebeat.yml):yamlfilebeat.inputs: - type: log enabled: true paths: - /app/logs/Server1/*.log fields: type: "server1-log" # 自定义字段,用于标识日志来源,对应Logstash中的[type] - type: log enabled: true paths: - /app/logs/Server2/*.log fields: type: "server2-log" output.logstash: hosts: ["Logstash生产者服务器IP:5044"] -
启动 :
./filebeat -e -c filebeat.yml
核心配置要点与安全提醒
- 密码安全:Redis密码、Elasticsearch各用户密码必须设置为强密码,切勿使用示例中的简单密码。
- 网络隔离:Elasticsearch和Redis的监听地址应绑定内网IP,并通过防火墙策略限制访问源。
- 索引生命周期管理:在Elasticsearch中配置ILM策略,自动清理旧日志,避免磁盘写满。
- 监控:监控Redis内存使用率、Elasticsearch集群健康状态和节点磁盘空间。
总结
- 可靠性:Redis队列有效应对了消费端(Elasticsearch)临时不可用或处理速度慢的问题。
- 解耦:生产(采集)和消费(存储)分离,便于各自扩展和维护。
- 灵活性:可在两个Logstash阶段分别进行不同的数据加工处理。