ElasticSearch快速入门实战(1)-索引、别名、建模最佳实践

2.3 安装head插件和中文分词器

以analysis-icu为例,但是主流还是IK分词器,支持自定义词典和远程热更新.

icu提供了高级的文本分析和处理功能(正则替换).适合多语言场景,支持Unicode标准化.

IK分词器有两种模式:

ik_max_word:最细粒度拆分,穷尽所有可能的词语组合,用于索引阶段以保证高召回率;

ik_smart:最粗粒度拆分,只输出最有可能的词语,用于查询阶段以提高准确率.

还有Pinyin分词器,可以跟IK组合使用.

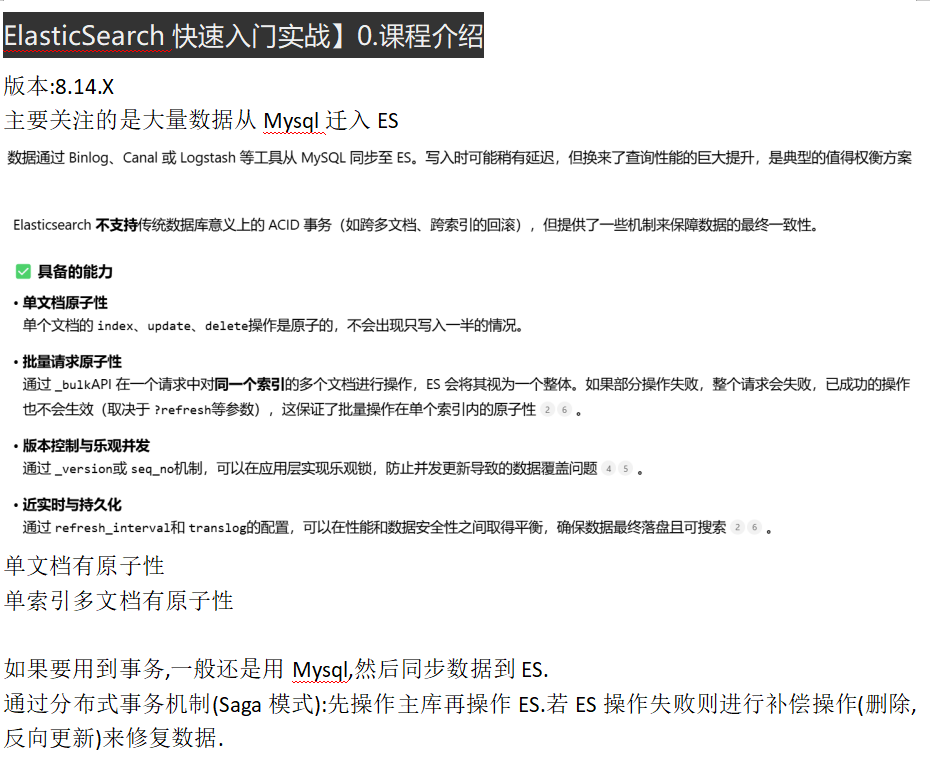
3.1 了解ElasticSearch核心概念

倒排索引:是把所有的分好的词列出来,然后把包含这个词的文章ID都放在一个对应的集合里.构建一个词和ID集合对应的关系.

ES8中,index相当于Mysql中的表(没有type的概念了)

mapping: 相当于Mysql表中的字段信息

document:相当于Mysql中的一条记录
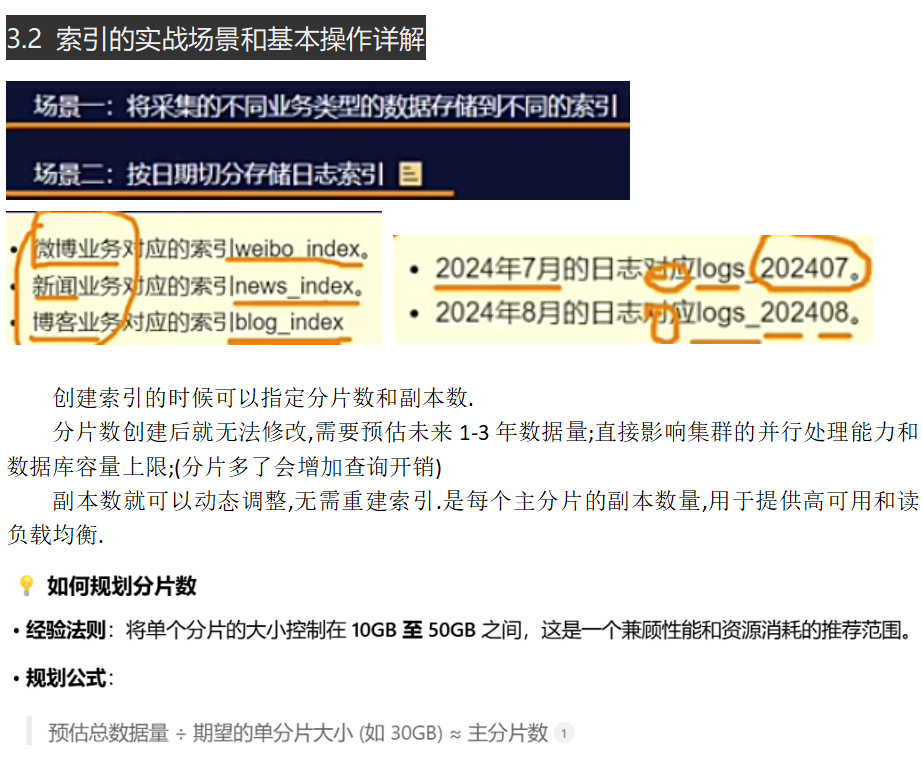
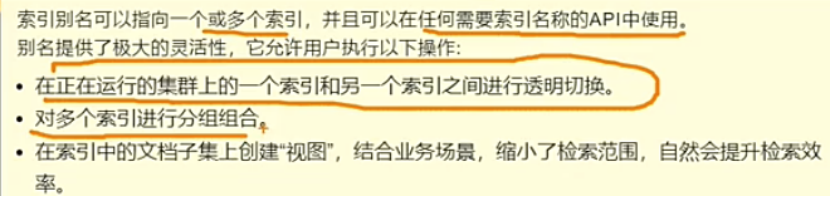
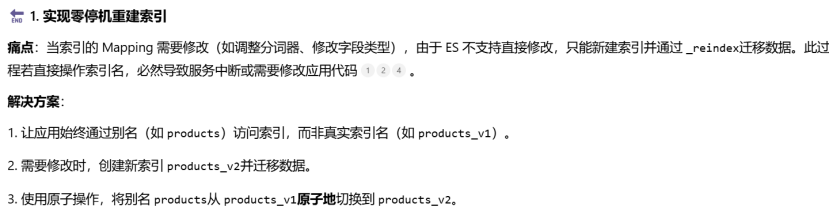
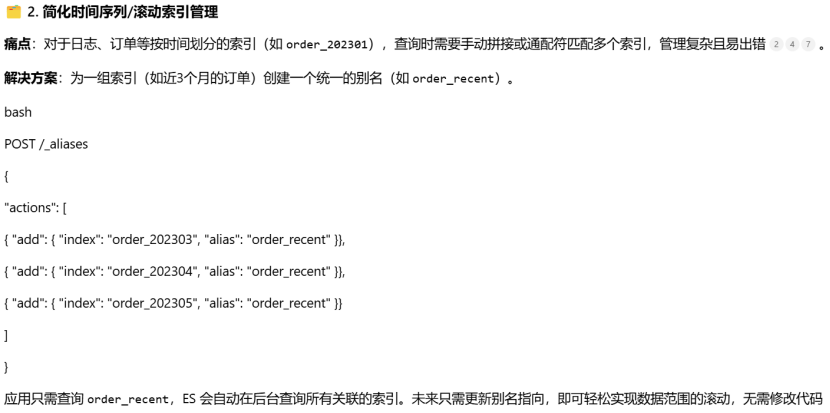
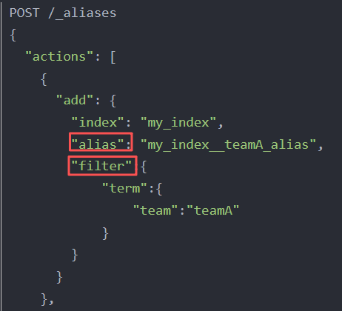
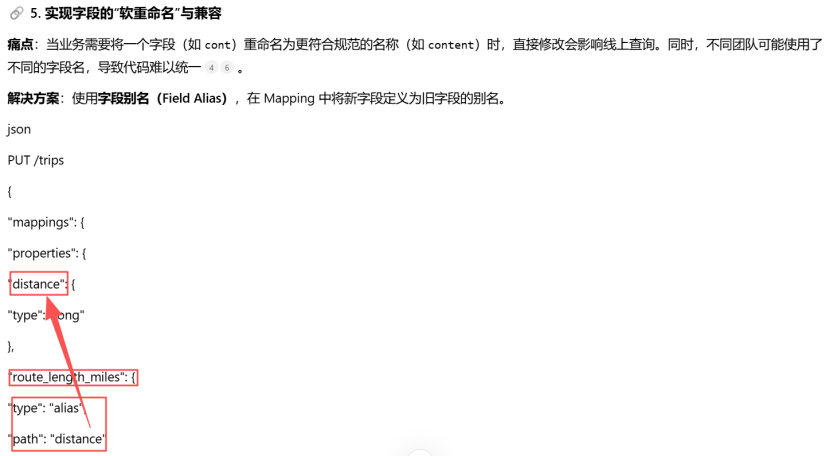
3.3 索引别名详解

为什么要使用索引别名?
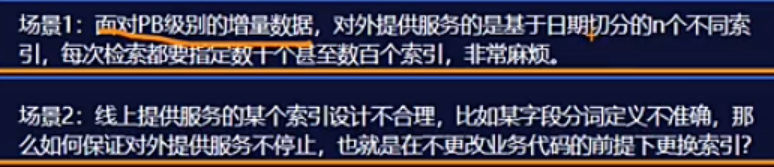
那新建索引名的时候就要习惯性的加上版本号了.然后使用别名.
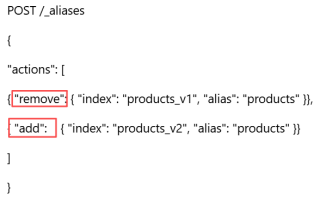
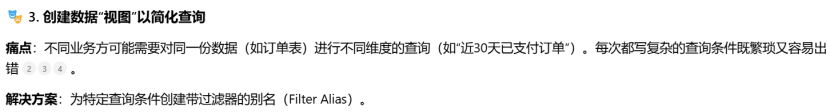
就是定义别名的时候带上一个filter.相当于一个视图

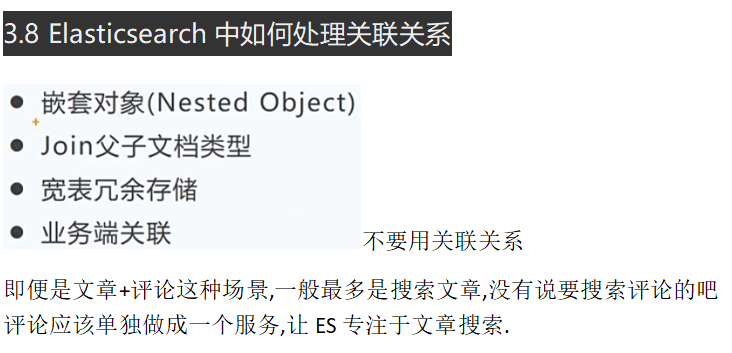
3.9 ElasticSearch文件建模最佳实践

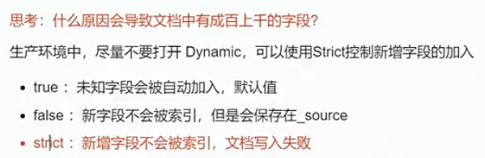
①避免过多字段;避免开启动态新增字段.
②避免正则,通配符,前缀查询.避免模糊查询.如果要模糊查询,可以把大字段拆分为多个小字 段,动静分离把模糊条件具体化.

③避免NULL引起的聚合不准确问题.新增的时候给字段加上默认值

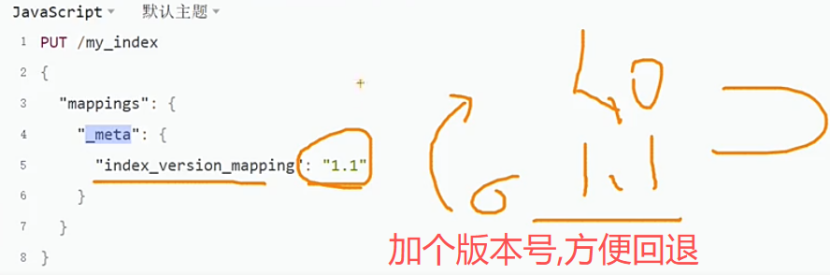
④为索引的Mapping加入Meta信息
相关推荐
Elastic 中国社区官方博客2 小时前
将你自己的密钥用于现有 Elastic Cloud 部署
大数据·数据库·elasticsearch·全文检索
红海云3 小时前
Jev:给智能系统做判断的模型
大数据·数据库·人工智能
Elasticsearch3 小时前
使用 Lucene 搜索你的 Bean — 搜索
elasticsearch
计算机毕业编程指导师3 小时前
计算机毕设选题推荐:基于Hadoop与Spark的Steam游戏数据分析系统源码 毕业设计 选题推荐 毕设选题 数据分析 机器学习 深度学习
大数据·hadoop·python·计算机·spark·毕业设计·steam游戏
计算机毕业编程指导师3 小时前
【计算机毕设选题推荐】基于Hadoop+Spark的白鹿抖音评论大数据分析与可视化系统源码 毕业设计 选题推荐 毕设选题 数据分析 机器学习 深度学习
大数据·hadoop·python·计算机·spark·毕业设计·抖音评论
Y3815326624 小时前
搜索 API 延迟优化:并发数、超时与超时的真实代价
python·搜索引擎
geovindu4 小时前
sql: JSON and XML Data Handling in SQL using sql server 2025
大数据·数据库·sqlserver·数据库开发·数据库架构
samLi06205 小时前
【数据集】A股上市公司beta贝塔系数数据(2010-2024年)
大数据
xianghongtao01166 小时前
麦肯锡2026技术趋势03_科学发现与工程AI_研究解读
大数据·人工智能