注:本文中出现的"内存"指的是GPU的"显存"
VLLM是一款用于部署大模型的开源推理引擎。它的意义在于减少大语言模型部署时造成的显卡显存浪费。本文将简单介绍VLLM的原理。
一、LLM推理过程
在介绍VLLM的原理之前,首先需要介绍LLM(大语言模型)的推理过程。
大语言模型推理分为两个阶段:Prefill 和Decode。Prefill指的是用户输入信息到生成首个token的过程,Decode指的是从生成首个token到整个推理结束的过程。
例如:用户输入语句:Artificial intelligence is,大模型将输出第一个token:the;此过程即为prefill,生成的第一个token一般称之为首token。一般用Prefill过程的耗时称为TTFT(Time to First Token,首token时延)
由self-attention机制和transformer架构可知,在大模型生成第一个token后,继续进行推理时,第一个token将和用户的输入语句一起作为新的输入,来继续产生后续的token,直到整个推理过程结束,而这部分过程即为Decode。Decode阶段,token是一个一个的生成的,每生成一个token消耗的时间叫做TPOT(Time Per Output Token,生成速度)。整个推理过程的耗时就是由TTFT和TPOT共同决定的。
由transformer架构可知,在进行推理的时候,对于每一个输入向量,都会产生三个新的向量,即q、k、v,且每生成一个新的向量,都需要综合考量之前的输入向量。
例如输入:Artificial intelligence is,Prefill阶段生成了"the",Decode阶段生成了"future";生成的"future"与Artificial intelligence is以及"the"都有关,更准确的说是与其k、v向量相关,这就要求推理过程中需要一直使用之前向量的k、v值。
在prefill阶段,由于用户的输入是一次性完成的,所以首token可以一次性计算得出;而在Decoder阶段,token是一个一个的产生的,那么每一次生成token的时候就要重新计算一次之前的序列的k、v值,所以LLM将序列在计算过程中的k、v值都缓存在了GPU内存上。所以kv cache导致GPU显存管理成为了影响大模型推理服务性能的主要因素。
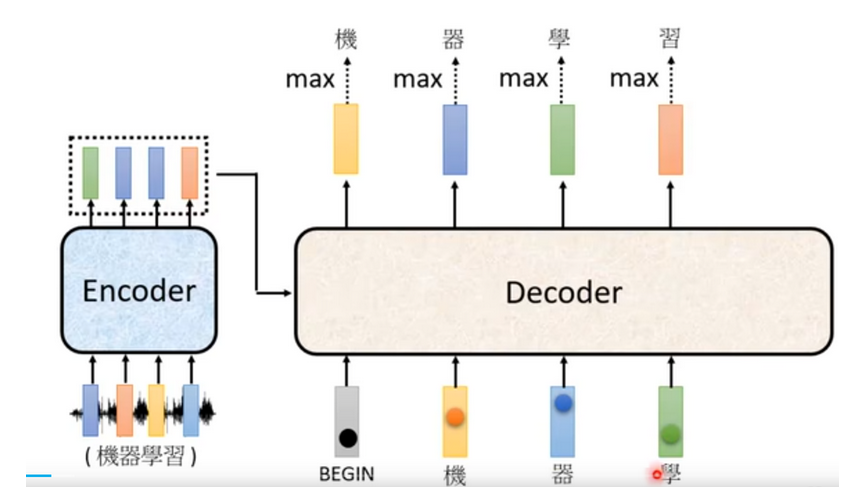
图1.1 transformer中的Decoer阶段
为了进一步理解kv cache造成的GPU消耗,现在我们来简单介绍大模型推理过程中的GPU显存分配情况。
假设用户输入Prompt:Aritificial intelligece is,首先GPU会为"Aritificial" "intelligece"" is"三个词各自分配一块显存,用于存储其kv ;由于GPU上显存分配是连续的,接着会在其后面分配一部分连续的显存,用于存储decode阶段生成的token的kv ,称之为Reserved;再后面,会继续分配一块显存,这部分内存是Decode没有用完的显存,称之为internal fragmentation;再后面,还会有一块显存,称之为External fragmentation,是用于区分这次的Promopt和下一次的Promopt的显存。
这一整块连续的显存都称之为第一段Prompt的kv cache,但实际上只有大约百分之二十到四十的显存是真正用于存储kv值的,剩下的显存并没有被真正的利用起来,因此造成了巨大的显存浪费
二、VLLM对推理过程中显存利用效率的优化
VLLM存在的意义,就是解决kv cache中的显存浪费。VLLM借鉴CPU中虚拟内存的概念,通过PagedAttention来对kv cache进行了物理上非连续 、逻辑上连续的显存分配。GPU将显存分割为了不同的bolck,这些blocck在物理上是连续分配的,如block1、block2、block3在物理上都是相邻的。之前的LLM,对于kv cache的分配也是基于物理上的连续分配;而VLLM则将kv cache分配到了不连续的显存上,而仅仅在逻辑上是连续的。
如"Aritificial intelligece is the",传统的LLM处理会把这四个词的kv值按照顺序存在block1、block2中;而VLLM可以把Aritificial intelligece的k、v存在block3中,is the的k、v存在block1中,这样在物理上不连续,也就不需要产生过多的kv cache,但他们在逻辑上仍然是连续的。
VLLM通过建立Block table,建立逻辑显存和物理显存的映射关系,即把连续的语句的kv映射到非连续的物理的kv存储上。
PagedAttention使得对显存的浪费不到整个kv cache的4%,显存的利用率提升了3-5倍。
三、VLLM的优势
基于上述机制,使得VLLM在模型推理时拥有一些优势;
1.并行采样
首先,在prefill阶段,用户输入的kv blocks,可以被不同的输出共享,则对于同一个输入,在产生不同的输出时,prefill阶段所用的显存块可以复用,而不用再次开辟。
2.束搜索
束搜索可以根据最新时刻的beam search decoding结果,释放掉不需要的逻辑块和对应的物理内存空间。这里不多赘述。