JAVA基础八股文
问:java中序列化是怎么实现的呢?
1.实现Serializable接口,就会实现数据序列化的效果。
2.调用json做序列化。(就比如:Jackson,fastjson等等)
3.实现Enternalizable接口,就可以实现反序列化的效果。
问:java的流有哪些呢?
从方向方面,主要就是输入流和输出流。
从单位方面,主要就是分为字节流和字符流。字节流主要就是InputStream,OutputStream。字符流主要就是Reader,Writer。
问:抽象类 和接口有什么区别呢?
从方法编写方面,抽象类中可以抽象方法和普通方法,而接口中只能编写抽象方法。
从继承和实现方面,抽象方法只能继承一个类并且可以实现多个接口,而接口可以继承多个接口。
在变量的定义方面,接口只能定义静态变量,抽象类可以定义普通变量和静态变量。
问:final关键值有了解过吗?
在修饰方法的时候,说明该方法无法被重写。
在修饰类的时候,说明该类无法被继承。
在修饰属性的时候,说明该变量从创建到销毁过程中不会改变。
在修饰形参的时候,说明该形参的引用在方法执行前后都会不发生改变。
问:异常类有哪些?
异常主要就是Exception,Error。
二者都是继承object的兄弟类,通俗易懂的来说,Error就是物理伤害。exception就是魔法伤害。Error异常包括:内存溢出、栈溢出、虚拟机异常。属于系统级别的异常无法恢复。Exception异常包括:空指针异常、未找到bean异常,属于代码逻辑层面的错误。
问:Filter和Interceptor有说明区别?哪个先执行呢?
- 作用域方面,Filter主要作用于ServletRequest及SerletResponse。interceptor主要作用于回去Controller层。
- 在用法方面,Filter通常作用于跨域判断及权限控制的业务流程,Interceptor通常只用于执行对执行Controller方法的前的前置操作和后处理。
- 在级别方面,Filter是应用级别,interceptor是MVC级别。
执行顺序:在一个请求进来后, doFilter -> interceptor前置处理方法->controller方法 -> interceptor后置方法 -> doFilter。
问:java中共享变量有哪些?
1.静态变量。
2.使用Voliate修饰java中得变量就会变成共享变量。
该修饰关键字修饰的属性保证内存的可见性,该变量的实时值可以被多个线程共享。
问:编写sigleton函数?(单例模式)
饿汉式:
-
public class sigleton { -
//饿汉式,每次都会创建好,即使没有调用 -
private final static Test test = new Test(); -
public Test getInstance() { -
return test; -
} -
}
运行项目并下载源码java运行
懒汉式:
-
public class sigleton { -
//懒汉式,只有在被第一次调用时才会被创建 -
private static Test test; -
public Test getInstance() { -
return test == null ? new Test() : test; -
} -
}
运行项目并下载源码java运行
篇幅限制下面就只能给大家展示小册部分内容了。整理了一份核心面试笔记包括了:Java面试、Spring、JVM、MyBatis、Redis、MySQL、并发编程、微服务、Linux、Springboot、SpringCloud、MQ、Kafc
需要全套面试笔记及答案************【点击此处即可/免费获取】
https://docs.qq.com/doc/DQXdYWE9LZ2ZHZ1ho****************
Redis八股文
问:Redis数据结构的底层实现由了解过吗?
1、String类型的底层使用动态字符串实现的。(该动态字符串也有一定的扩容机制,使用场景:方案数据的缓存)
2、List类型在旧版本中使用的是双向链表和压缩列表,这两个结构最大的问题就是 双向链表需要大量的内存开销,用于存储前后指针,压缩列表在数量大是插入和删除操作的效率会很低,在目前新版本的redis中list使用的是quickList做为结构,该结构就是双向链表的一个变种,在结构基础上将每个节点的结构设置为一个压缩数组,一个节点中会是一个连续的内存,该内存中会存储多个数据,即提高数据插入和删除的效率问题,又能避免数据存储的碎片化。(虽然在做数据删除的时候还是涉及数据移动的问题,但是因为数据比较小,效率上还是比较高的)
-
Quicklist -
+---------+ +---------+ +---------+ -
| 头节点 |<-->| 中间节点 |<-->| 尾节点 | -
+---------+ +---------+ +---------+ -
| | | -
v v v -
+-----+ +-----+ +-----+ -
|Ziplist| |Ziplist| |Ziplist| -
| [a,b,c] | [d,e,f,g] | [h,i] | -
+-----+ +-----+ +-----+ -
(每个Ziplist是一个连续内存块,存储多个列表元素)
运行项目并下载源码
3、set类型的底层使用哈希表+整数集合来实现的。(应用场景: 在线用户人数统计场景解析)
整数集合:当时数据都是整数的时候或者,数据量在512以内的时候就会使用整数集合进行存储。
HashTable:在不符合整数集合条件的时候就会升级为hashTable进行存储,因为set唯一性,key存储set的数据,value设置为null。
4、hash类型的底层使用压缩集合+哈希表实现的。
压缩列表:当键值的字符串长度小64的时候或者键值对数量小于512的时候会使用此结构。
-
Ziplist -
+------+------+------+------+------+------+------+ -
| zlbytes | zltail | zllen | "name" | "Alice" | "age" | "30" | zlend | -
+------+------+------+------+------+------+------+------+ -
键值对是**交替存储**的:[field1, value1, field2, value2, ...]
运行项目并下载源码
hashTable:在上述条件不成立的时候就会使用hashTbale进行存储。就是典型的键值对结构。(使用场景:网校在线人数统计 在线用户人数统计场景解析)
5、zset类型的底层使用压缩集合+跳表 实现的。
压缩集合:当键和值的字符串个数小于64的时候及键值对数量小于128的时候会使用此此结构进行存储。
-
Ziplist 存储 Zset -
+---------+---------+---------+---------+---------+---------+---------+---------+ -
| zlbytes | zltail | zllen | score1 | member1 | score2 | member2 | zlend | -
+---------+---------+---------+---------+---------+---------+---------+---------+ -
| | | | | | | -
| | | | 2字节 | 5字节 | 2字节 | 5字节 | -
| | | | 存储90 | 存储"Alice"|存储87 |存储"Bob" | -
| | | | | | | -
v v v v v v v -
内存偏移: 0x00 0x04 0x08 0x0c 0x0e 0x13 0x15 0x1a -
↓ ↓ ↓ ↓ ↓ ↓ ↓ -
[4字节] [4字节] [2字节] [2字节] [5字节] [2字节] [5字节] [1字节] -
(总字节数)(尾偏移)(元素数量)(score)(成员) (score)(成员) (结束)
运行项目并下载源码
跳表:当不满足上述条件的时候会采用跳表+hashTable(字典)的结构,使用跳表快定位对应得分的数据,时间复杂度为o(logn),因为条表中的数据和字典中的数据都是指向同一个对象,所以在数据的存储方面不需要双倍的开销。跳表+dict的总时间复杂度为 o(logn) + o(1) = o(logn)。(运用场景:课程热度(基于大key存储:网校id , member存储:课程id,score:用于存储课程热度))

问:zset的底层结构有了解过吗?
zset的底层结构主要就是跳表+压缩列表。
压缩列表:本质就是一个数组,结构使用条件:当键值对的字符串的长度都小于64的时候或键值对的个数小于128的时候,会采用此结构,有点就是内存用量小。
跳表:在数据量比较大的是会使用该结构,通常是跳表+dict进行配合使用的,调表用于快熟定位得分区间,dict用于快速定位键值对。因为二者都是直接指向同一个对象,所以在内存开销方面无需两倍的开销,在查询方面,跳表的时间复杂度为o(logn),dict的时间复杂度为o(1),总时间复杂对为o(logn),在数据进行删除和新增的时候可以直接在跳表中进行操作,时间复杂对为o(logn),是由于压缩列表的 o(n)。
问:我看你在做项目的时候都使用到redis,你在最近的项目中哪些场景下使用redis呢?
缓存和分布式锁都有使用到。
问:说说在缓存方面使用
在班级方案信息查询模块使用中使用二级缓存,一级缓存使用的是Caffeine,二级缓存就是使用redis。
业务场景:目前我们系统中,使用到方案的配置会使用到缓存的机制,学员在进入一个已经报名班级的时候,会去查询对应方案的配置,方案配置一般的是教务配置好的,基本上是很少改动的,为此在这个查询上我们会使用到二级缓存,这个二级缓存是对原有的一级缓存进行迭代的方案。旧方案存在的问题,比较依赖网络带宽,如果redis宕机了,就会导致数据接库压力一下就增大了(之前运维现网就出现这种情况),迭代方案就是在服务内部在加一层缓存,使用caffeine它是基于一个jvm,那就会导致相同服务存在缓存不一致的情况,我们做技术选型的时候,主要是考虑到使用redis的发布于订阅模式和kafka的分布订阅模式,最终我们是选择使用redis的发布与订阅模式,在该场景下我们对消息的丢失及消息顺序是不敏感的,且再维护一个topic的成本比redis的模式高的多,相同服务订阅同一个管道即可以实现缓存一致性。
问:对缓存击穿,缓存雪崩,缓存穿透有了解过吗?说说者三个缓存问题的解决方案吧。
1.缓存击穿:某个热点key设置了过期时间,在高并发查询的情况下,该热点key过期了,导致大量的请求去访问数据库,最终压垮数据库。
解决方案:
(1)不给热点key设置过期时间(在redis中设置的过期时间都是逻辑过期时间,通过逻辑字段来判断key是否过期)。
(2)使用分布式 锁,保证每次只有一个请求去访问数据库,在每次访问数据库前再做一次查询缓存的操作,然后获取锁并去数据库查询,将查到的数据重新缓存起来,下一次请求就会在缓存中查询到数据,就不会查询数据库,防止压垮数据库。
2.缓存雪崩:第一种情况:大量的key设置了相同的过期时间,在同一大量的key失效,导致大量的请求去访问数据库,导致压垮数据库。第二种情况:redis宕机。
解决方案:
(1) 错开key的过期时间(TTL):在每个key的统一过期时间上在随机加上1~5分钟的过期时间。
(2)设置服务降级,服务熔断,服务限流,到达阈值的时候直接返回自定义的错误信息。(作为系统的兜底策略)
(3)为redis搭建集群,就包括哨兵模式,集群模式。
(4)做二级缓存。(可以重点介绍,就引导面试官到运单信息查询模块,给他介绍二级缓存的实现还有缓存同步的问题,主要讲caffeine缓存同步的问题)
3.缓存穿透:查询的key在缓存和数据库中都不存在,每次都会进入数据库查询,当大量的这种key访问数据库,就会导致缓存穿透。(这种情况多半上是恶意攻击)
解决方案:
(1)在缓存中储存空值:当在数据库中没有查到数据时,将key关联null的键值对存储到缓存中,后续就会走缓存,这种解决方案缺点很明显,就是存储大量无用的存储,浪费空间。
(2)使用布隆过滤器:在查询缓存的时候先去布隆过滤器中查询是否存在缓存,再去查询缓存。
问:具体讲讲你对这个布隆过滤器理解?
布隆过滤器类似bitmap(位图),会对对数据进行n的哈希操作,并将这n此哈希结果在在对应的位置上设置为1。通过哈希函数计算储存位置,因为使用hash算法的原因就会导致判断上存在一定的预判率,因为当数据量过大上,导致大量的位置被设置为1,就会导致一个不存在的数据被判断为存在。
布隆过滤器的优点就是:储存二进制的数据,查询速度快。缺点:判断数据是否存在有误判率,并且不能做删除操作,对应点位设置为0会导致其他的数据的凭空结果受到影响。
为了降低布隆过滤器的误判率,就会通过增加哈希次数来降低误判率,但是多哈希就意味着使用更多的空间使用,需要使用更多的bitmap的大小。
我们主要是根据redisson设置布隆过滤器,可以设置其误判率。在高并发的场景下,一般误判率控制在5%之内就可以了。
问:你在开发时用使用到分布式锁吗?你能简单的讲述一下分布式锁的实现吗?(引导面试官到你的项目中,去解释)
分布式锁
实现方式:
1.在redisson中的获取锁方法底层主要是通过Lua(能够调用redis命令,保证命令执行的原子性)实现的,如果获取锁方法没有设置过期时间,则分布式锁会有watch dog来保证延长锁的有效时间。
2.可以通过setnx来实现分布式锁(因为redis是单线程的)。 通过 set If not exists并设置过期时间实现分布式锁,但是存在的问题就是无法确定要给锁设置多长的有效时间,所以在项目中比较少使用。
问:分析redisson有哪些特点,说说这些特点的实现结构吧?
1.**支持锁的重入。**主要是使用到redis的hash结构,大key存储的是当前的业务id,小key存储的是线程id,value值存储的就是当前锁重入的次数。(一般一个业务id会存储三个结构:锁模式、重入次数、过期时间)最简单的例子就是在按某一个业务id上锁的时候,又需要在改锁的基础上再次上锁,就会通过业务id就线程id定位hash做 + 1的操作,释放锁的时候就会做- 1,当发现是最外层锁的时候就会把hash结构中的数据删除掉。
-
锁Key: "my_lock" (Hash结构) -
├── 字段1: "mode" = "redisson_lock" -
├── 字段2: "UUID_线程ID:1" = 计数器值 -
└── 字段3: 过期时间等元数据
运行项目并下载源码
2.**支持上锁时间重置机制,也就是watch dog。**本质就是通过Lua脚本来实现的,默认情况下会给锁的上ttl设置为30s,并且每过10s就会进行一次检测,如果还未释放就会给重置过期时间为30s。
3.**支持使用公平锁。**公平锁主要是基于redis的三个结构来实现的,会有一个hash结构和两个zset结构,hash用来控制锁的重入次数,一个zset用来存储等待线程,key存储业务id,member存储线程的id,scope存储存储是时间戳,分数小的优先获取锁。另一个zset存储线程等待锁的最长时间,key存储业务id,member存储线程id,scope存储开始等待时间 + 3000ms的时间戳。这个zset作为清楚等待超时的操作的辅助表。(线程获取锁前会先删除两个zset中超时的线程数据)
问:redisson实现的分布式锁,可以解决主从一致性的问题吗?
不能解决主从一致的问题,单master节点获取锁后就没释放锁就宕机了(主库写入,从库读取),此时slave节点变成了master节点,因为新的master没有上锁,所以新的master会进行上锁,破坏了锁的互斥性。
解决方案
1.使用红锁,也就是给 n / 2 + 1 个的节点添加分布式锁,但是这样效率就变的很低,增加了网络带宽。(最终一致性的形式,性能比较好)
2.使用zookeeper,默认就有实现公平锁,每次线程获取锁的时候会判断当前的节点锁时最小的节点,如果是最小的节点才会做获取锁的操作,保证获取锁的公平性。监听前一个节点是否发出删除事件(因为节点都是临时节点,在使用完后会被删除并发出删除事件,这个过程时同步的基于watch机制,监听器就会使用notifiyAll唤醒所有的线程,做获取锁操作),在删除后当前节点获取锁并在使用完成后释放锁,以此类推,保证主从一致性。(强一致性的形式,性能比较低,qps比红锁低很多)(不需要担心节点单机导致后续其他节点获取锁失败的情况,zookeeper会有心跳机制,当发上锁的节点宕机时并没有心跳后就会自动发出节点删除事件)
线程操作:
-
// 获取所有子节点 -
List<String> children = zk.getChildren("/locks", false); -
// 排序子节点 -
Collections.sort(children); -
// 检查自己是否是最小的节点,每次只有会有一个节点的线程获取锁成功,其他的线程又会进行等待 -
String smallestNode = children.get(0); -
if (myNode.equals("/locks/" + smallestNode)) { -
// 获取锁成功 -
return true; -
} else { -
// 需要等待 -
return false; -
}
运行项目并下载源码java运行
监听器操作:
-
// 找到前一个节点 -
int myIndex = children.indexOf(myNode.substring(myNode.lastIndexOf('/') + 1)); -
String prevNode = children.get(myIndex - 1); -
// 监听前一个节点的删除事件 -
Stat stat = zk.exists("/locks/" + prevNode, new Watcher() { -
@Override -
public void process(WatchedEvent event) { -
if (event.getType() == Event.EventType.NodeDeleted) { -
// 前一个节点释放锁,唤醒所有等待线程 -
synchronized (this) { -
notifyAll(); -
} -
} -
} -
}); -
// 等待前一个节点释放 -
synchronized (this) { -
wait(); -
}
运行项目并下载源码java运行
问:在集群的项目中为什么不能用关键字synchronized呢?
在两个微服务中,如果使用synchronized是无法达到同步上锁效果,因为两个微服务是两个单独的JVM。
篇幅限制下面就只能给大家展示小册部分内容了。整理了一份核心面试笔记包括了:Java面试、Spring、JVM、MyBatis、Redis、MySQL、并发编程、微服务、Linux、Springboot、SpringCloud、MQ、Kafc
需要全套面试笔记及答案****************************【点击此处即可/免费获取】
问:了解过双写一致性吗?
双写一致性:当数据库中的数据发生修改的时候,我们需要修改缓存中的数据,保证数据库和缓存中的信息相同。
 在读操作的时候,会先到缓存中查询数据,如果没有命中的话就到数据库中查询。
在写操作的时候,会采用延迟双删。
问:在延迟双删中为什么要延迟删除缓存?
数据库采用的是主从模式,遵循读写分离,需要一些时间来将主数据库中的数据同步到从数据库,但是还是可能出现脏读的情况。
问:在延迟双删中为什么要删除两次缓存呢?
如果只有一次删除缓存操作的话就会有两种情况。
1.情况1:先删除缓存,再修改数据库。线程1删除缓存。在线程1要修改数据库前。线程2去做查询操作,发现没有缓存,就去数据库中查询数据并做缓存,之后线程1修改了数据库中的信息,最终出现缓存数据和数据库数据不相同的情况。(当前线程在删除缓存并且在写数据库前其他线程查询了就的数据)

2.情况2:先修改数据,再删除缓存。当前缓存中方没有数据,线程1做查询操作,准备将旧数据缓存前,线程2做了修改数据和删除缓存的操作(此时是没有缓存的),最终缓存中就存储了旧的数据,出现脏读的情况。(当前线程要将旧的数据进行缓存的过程中进行了写数据库和删除缓存的操作)

为了防脏读的缓存被使用,所以在数据同步的需要两次删除缓存的操作。
问:延迟双删是没法保证强一致性的,有什么强一致性的方法吗?
方法一:使用分布式锁,每次只有一个线程进行操作,效率比较低下。

方法二:因为缓存中的数据大多是读多写少,所以我们可以使用在读取数据的时候使用共享锁, 多个线程同时可以读取缓存但是其他线程不可以写,在修改数据的时候使用排他锁,会阻塞其他线程的读写操作。

排他锁和共享锁可以使用redisson实现,通过redissonClient获取对应的读写锁。
1.读锁也就是共享锁。

2.写锁也就是排他锁。

必须保证读写锁的名字相同。
问:那有了解过最终一致性的方法吗?
在我们支付模块中,每次支付都需要获取支付模板也就是支付宝支付和微信支付模板,这些数据我们基本上不会修改,会将其缓存起来,在修改mysql中模板的数据的时候,通过rabbitmq发送消息,异步修改缓存的数据,达到最终一致的效果。
为什么mq可以实现最终一致的效果呢?
mq中的消息都是按照顺序进行消费的,消息的消费是和事务绑定的,如果事务进行了回滚操作则被消费的消息也会被重新放回队列的原先位置中,并且接收到消息的服务会异步进行处理。

当然我们不仅仅可以使用rabbitmq实现最终一致的效果,我们还可以使用canal实现最终一致的效果。canal主要是通过mysql的主从同步实现的。通过监听bin Log日志的方式来修改缓存中的信息,达到最终一致的效果。(binLog日志主要是储存DDL(数据定义语句)和DML(数据操纵语句))

问:redis做为缓存,数据的持久化是怎么做的呢?
在持久化上用 RDB和AOF两种方式。
问:说说你对RDB和AOF的理解吧。
1.RDB:通过对数据做快照的方式做持久化,将快照存放到磁盘上,后续需要恢复数据的时候就使用该快照进行恢复。
RDB的执行原理:首先在主进程中会有一个页表,该页表指向内存中对应的物理地址用于主线程做读写操作。当执行RDB的时候会触发fork,此时会复制一个子进程出来,子进程中页表和主进程中的是一样的。子进程会生成一个RDB快照存储到磁盘中。在该过程中主进程是支持写入的,在写入时需要保证原内存空间的数据不变,复制一个内存空间并让页表指向它,在该副本上进行写入的操作。(后续子进程完成RDB后并且发现原内存引用计数器为0是就会将就数据进行回收)

2.AOF:在redis做操写的指令的时候,会将这些指令都存储到对应的AOF文件中,在后续数据需要恢复的时候就执行AOF文件中的所有指令。
AOF执行的原理:就是每次去记录操作写的指令到AOF文件中。
问:RDB和AOF有什么区别吗?
1.备份机制方面:RDB是对整个内存做快照,而AOF是记录redis每一条执行的语句。(AOF只会记录写指令,读指令都不会记录)
2.数据完整性方面:RDB的在两次备份间可能会出现数据丢失的情况(redis宕机)完整性低, 而AOF的完整性比较高,其取决去刷盘的策略。
3.文件大小方面:RDB的文件比较小(采用二进制进行存储),而AOF会记录每一条写指令,所以AOF的文件比较大。
4.数据恢复速度方面:RDB的数据恢复比较快,因为AOF文件比较大,需要一条条的执行写指令,恢复速度慢。
5.执行消耗方面:RDB系统占用高,需要大量的CPU和内存的消耗,而AOF主要是大量文件的IO操作,在生产环境中一般会像使用AOF,如果没有才会使用RDB。
问:RDB和AOF谁的恢复速度更快,我们在平时要怎么选择呢?
RDB的快照文件本质是二进制文件,其体积比较小,而AOF文件需要保存redis中的写操作指令,在体积上比较大,所以在恢复速度上RDB快有点,但是所带来就是高消耗和数据丢失的风险,在生产环境中我们一般会先使用AOF进行恢复,保证数据的完整性,避免数据不完整带来的不确定因数,在没有AOF的时候才会使用RDB。
问:redis的key过期后,会立刻做删除操作吗?
redis有两种数据过期策略,分别是惰性删除和定期删除。
惰性删除:我们会为每个key设置一个过期时间,在每次获取数据的时候会先去判断该key是否过期,如果过期直接删除key,如果没有过期则直接返回,也就是说在没有使用数据时不会主动删除。(优点:对CPU友好,只在查询时才做过期判断。缺点:可能会导致内存泄漏的问题,在某些键值对永远不会被访问的时候)
定期删除:定期去判断一定数量的key是否过期,如果过期则直接进行删除操作,定期删除又分为SLOW模式和FAST模式。(优点:内存消耗小。缺点:定期查询key需要消耗大量时间。)
SLOW模式:默认的频率为10hz(一秒内进行十次),每次不大于25ms,我们可以通过配置文件中的hz修改频率。
FAST模式:执行频率是不固定的,两次删除的间隔不小于2ms,每次耗时小于1ms,事件驱动的模式,当内存压力过大时候就会被动触发。(过期键值对过多时,内存过大时)
redis默认采用的数据过期删除策略:惰性删除+定期删除配合使用,在常规查询的时候采用惰性删除,使用定期删除作为辅助,减少内存泄漏的情况。
问:假如缓存过多,内存有限,内存满了怎么办呢?(redis缓存的空间用完了会怎么样?)
在redis中提供了8种不同的数据删除策略,在默认情况下采用的是noeviction模式,数据满后直接报错不做删除操作。(Least Recently Used:最久前使用的 | Least Frequently Used :最不频繁使用的)
其他七种模式只有的区别就在于 不同的数据范围和不同的删除处理。
1.noevication:直接报错不做删除。
2.allkey-LRU:在全部数据中,删除距离当前最早使用的数据。
3.volatitle-LRU:在所有设置有效时间的数据中,删除距离当前最早使用的数据。
4.allkey-LFU:在全部数据中,删除当前使用频率在少的数据。
5.volatitle-LFU:在设置有效时间的数据中,删除当前使用频率最少的数据。
6.allkey-random:在全部数据中,随机删除数据。
7.voletitle-random:在设置有效时间的数据中,删除数据删除数据。
8.voletitle-TTL:在有设置过期时间的数据中,删除最先要过期的数据。
问:数据库中有100w条数据,redis只能存储20w数据,如何保证redis中的数据是热点数据呢?
使用 allkey-LFU策略,保证经常使用的数据不被淘汰。
问:能介绍一下redis的主从复制和主从复制的流程吗?
单个redis节点的并发能力是有限的,所以为了提高并发能力,我们需要搭建redis集群,就比如:主从复制。
主从复制的流程
主从复制主要分为:全量同步和增量同步。
全量同步:在salve请求数据同步的时候会携带Replication Id(复制id)和offset,如果master判断出Replicationid和自己的不一样,就认为slave是第一次进行同步,所以会进行全量同步。 master会执行bgsave生成RDB文件给slave,slave进行同步,在此过程中master可能会进行新的指令,master会将这些指令存储到日志文件,在加载RDB完后再将Replication Backlog(日志文件)传给slave进行最终的同步,master同步Replication Id和offset给slave。

增量同步: 在master判断出slave中的applid和自己一样就认为不是第一次同步,直接进行增量同步,从日志文件中获取到offset的位置,将offset之后的数据发送给slave,进行数据的同步。
问:那主节点宕机了又该怎么办呢?
为了提高redis集群的高可用,我们可以使用哨兵模式,解决主节点宕机的问题。
问:那说说你对哨兵模式的理解吧
哨兵模式:通过sentinel的心跳机制去监测master的状态,当然为了保证高可用,我们也需要对sentinel搭建集群。sentinel每隔1秒就会向集群的节点发送ping指令,当master失效后会就选择出新的master。
在sentinel中有两种概念:主观下线和客观下线。
主观下线:当有一个sentinel发现redis节点没有返回响应就认为其为主观下线。(连续ping 30s)
客观下线:当有一半以上的sentinel节点发现redis节点没有返回响应就认为其为客观下线。
当master发生客观下线就会筛选slave作为新的master。
筛洗新master的优先级为下:
1.排除与旧master节点断开时间过长的从节点。
2.判断slave的权重(replica-priority),如果权重越小优先级就越高。
3.如果权重相同的话,就比较slave的offst值(主从数据同步的偏移量),如果offset越大优先级就越高。
4.判断slave运行id的大小,如果运行id越小则优先级越高。
篇幅限制下面就只能给大家展示小册部分内容了。整理了一份核心面试笔记包括了:Java面试、Spring、JVM、MyBatis、Redis、MySQL、并发编程、微服务、Linux、Springboot、SpringCloud、MQ、Kafc
需要全套面试笔记及答案****************************【点击此处即可/免费获取】
问:哨兵模式可能会出现脑裂的情况,有了解过吗?
由于网络不稳定的因素,多个sentinel都没有ping到master,此时master是没有宕机的,而哨兵模式就会选择出新的master,就出现两个master的情况,而客户还是对旧的master进行数据的操作,在网络稳定后,旧的master就会变成新master的slave,最终导致数据操作的丢失。从而形成脑裂的现象。
解决脑裂的方案:
1.在redis的配置文件中设置最少的slave个数(对应的配置项:min-replicas-to-write,至少配置一个从节点数)。当出现脑裂的情况时,旧的master会监测到没有slave,就不会做数据的操作直接返回错误信息,防止数据操作的丢失。
2.在resdis的配置文件中设置最大数据同步的延迟时间。(对应的配置项:min-replicas-max-lag)。当出现脑裂的情况时。旧的master在做数据的同步时一直找不到slave,当时间超过最大的延迟时间就会直接返回错误信息,防止数据操作的的丢失。
问:你们使用redis是单点还是集群?
我们的redis使用主从模式(一主一从)+ 哨兵模式。当然在容量不够的时候,会为不同的服务配置独立的redis主从节点。
问:redis分片集群有什么作用?
1,存在多个master,这些master存储不同的数据,多个master可以解决并发写的问题。
2.每一个master都可以有多个slave,解决并发读的问题。
3.在分片集群中,不再通过sentinel监测master的健康状态,而是通过master之间ping状态,判断各个master的健康状态,最终达到哨兵模式的效果。
问:redis分集群中的数据是如何存储和读取的呢?
redis分片集群采用的是哈希槽的结构实现的,哈希槽总共有16384个。master节点等量的获取哈希槽范围用于存储数据。
在存储数据的时候,通过有效部分取哈希槽总数的模计算出哈希值(这里的有效部分指key前大括号中的有效值(就比如: set {}key value),如果没有大括号key就是有效部分),路由到master后做写操作。
在读数据的时候,通过计算出的哈希值确定存储数据的master位置,从该master中读取数据。如果到达读写分离的效果,可以通过redis的集群配置优先读取从节点,达到读写分离且负载均衡的效果。
-
spring.redis.lettuce.cluster.read-from: REPLICA_PREFERRED -
MASTER -
所有读写都只找主节点 -
使用场景:数据必须绝对最新,宁可慢也要准确,追求数据一致性 -
REPLICA -
读操作只找从节点(只会找从节点),写操作找主节点 -
使用场景:读非常多,可以接受稍微旧一点的数据 -
REPLICA_PREFERRED -
优先找从节点读取,从节点不在才找主节点 -
使用场景:最常用的平衡方案 -
MASTER_PREFERRED -
优先找主节点读,忙不过来才找从节点 -
使用场景:希望数据新,但也要保证高可用 -
NEAREST -
谁离我近、响应快就找谁 -
网络环境复杂,追求最快速度
运行项目并下载源码
问:redis是单线程的,为什么会那么快呢?
1.完全基于内存的,每次操作都是在内存中完成的,减少了磁盘io操作带来的瓶颈,是C语言编写的。
2.采用单线程,避免线程间不必要的上下文切换可竞争条件,多线程还需要考虑线程问题。
3.采用IO多路复用模型。
问:说说对阻塞IO和非阻塞IO的理解吧。
我们先需要知道内存的使用情况为:用户空间和内核空间。
用户空间:只能执行受限制的指令,不能直接调用系统资源,需要通过内核提供的接口来调用系统资源。
内核空间:可以执行特权指令,可以直接调用系统资源。

阻塞IO:在用户线程要获取内核中获取数据,而此时内核中没有数据,用户线程就会等待从而导致用户线程阻塞,当内核中有数据后,数据需要重内核缓冲区复制到用户缓冲区,在这个过程中用户线程也需要等待从而导致线程堵塞。在这两个阶段中用户线程都是堵塞的,这就是堵塞IO。

非堵塞IO: 用户线程要从内核中获取数据,但内核中没有数据,此时内核直接返回错误信息给用户线程,反之线程堵塞,用户线程会循环的调用内核的方法直到内核中有数据,当内核中有数据后,用户线程就会等待内核缓冲区中的数据复制到用户缓冲区中,此时用户线程是阻塞的。在第一阶段是不阻塞的,而第二阶段是堵塞的,这就是非堵塞IO。比阻塞IO优化没多少,而且忙等机制可能会导致CPU的空转,CUP使用率暴增。

问:解释一下什么是多路IO复用模型?
单线程同时监听多个Socket(操作客户端)的状态,某个Socket可读可写时得到通知,防止出现忙等的情况,提高CPU的利用率,可能同时存在多个可用Socket,通过循环做读取数据的操作,多路IO复用主要通过epoll模式实现的,将已就绪的socket存到用户空间中,就不需要遍历判断socket是否就绪,从而提高性能。

问:有了解过redis的网络模型吗?
通过多路IO复用 + 事件处理器实现的。事件处理器主要是:连接应答处理器,命令回复处理器,命令请求处理器。在redis6.0之后,使用多线程来处理命令的回复和命令的请求从而实现高效的网络请求,在命令执行的时候依旧是单线程(线程安全的)。

MySQL八股文
问:Mysql的存储引擎有理解过吗?
我比较了解就是 Innodb,myisam,Memory。
Innodb:现在的mysql默认存储引擎就是innodb,主要就是因为它是唯一一个支持事务的存储引擎,支持表级锁和行级锁,其索引的底层结构使用的是B+树(使用聚簇索引),在数据,索引,表结构都存储到.idb中。(基本上目前我们的业务都是使用该结构,在很多业务上都依赖事务的特性)
Myisam:其不支持事务,仅支持表级锁,其索引的底层结构为B+树(非聚簇索引),表结构存储到.sdi中,索引存储到.myi,数据存储到.myd中。(纯读取业务才可能会选择,并且不会当前业务不会存在并发问题)
Memory:基础内存进行存储的,数据在服务重启的时候就会消失,主要就是用sdi存储表结构。索引类型是使用哈希结构,所以在做等值查询的时候速度非常快。(适合做临时缓存,当相比于redis,redis的缓存处理速度更快,并且不会不会带来格外的数据库压力)
问:为啥myisam的查询速度会比innodb的速度快呢?
在速度上不一定myisam会更快,innodb采用的是聚簇索引,单联合索引没有覆盖查询条件的时候就会出现回表的操作,而myisam则采用的时候非聚簇索引,在节点上指针直接对应数据,不存在回表的操作,在此时的查询速度上就会更快。
问:如何定位慢查询?
在我们的项目中,在上线时使用华为云和arthas来定位慢的查询,如果发现是某个SQL执行速度慢,我们就可以使用trace对应接口来确定慢SQL语句。(提供watch来观察出入)
我们使用MySQL提供的慢日志来确定慢查询的位置。mysql是默认没有开启慢日志的,需要通过配置文件开启并设置快查询的最大时间,超过这个时间就认为其为慢查询,我们就可以在慢日志中找到慢查询的sql,在我们的项目中设置最大的时间为2秒。
-
#开启慢日志 -
slow_query_log=1 -
#设置快查询的最大时间 -
long_query_time=2
运行项目并下载源码
问:一个SQL语句执行很慢,应该如何分析呢?
我们可以借助Mysql提供的关键值 explain来展示出某个SQL语句的状态。
篇幅限制下面就只能给大家展示小册部分内容了。整理了一份核心面试笔记包括了:Java面试、Spring、JVM、MyBatis、Redis、MySQL、并发编程、微服务、Linux、Springboot、SpringCloud、MQ、Kafc
需要全套面试笔记及答案****************************【点击此处即可/免费获取】
问:有了解过索引吗?
1.索引是帮助Mysql高效查询数据的数据结构。
2.索引提高检索效率,大大降低IO成本。
3.通过索引列对数据排序,大大降低了排序的成本。
问:B+树和B树的区别?
1.从数据的存储方面:b+树只有在也叶子节点才会存储数据,在非叶子节点上只会存储索引数据,而b树在每一个节点上都会存储数据和索引数据。因为b+树的非叶子节点存储的是索引数据,所以树的结构会趋向"矮胖"的结构,在查询数据上会快一些。
2.在叶子节点的结构方面:b+树的叶子节点采用的是一个有序列表,通常是一个双向链表,而b树的叶子节点不存在这个结构。在范围查询上b+树会更快些。在做全盘扫描的时候因为b+树只要遍历有序列表,所以在全盘扫描查询速度上更快。
问:什么是聚簇索引和非聚簇索引?
聚簇索引:也就是在B+树的叶子节点中存放整行的数据,在表中只能存在一个聚簇索引,通常为主键,在查询时不需要做回表操作。
非聚簇索引(在innodb中的二级索引,采用的时非聚簇索引):也就是在B+树的叶子节点上存放对应的主键一类的数据,在使用到聚簇索引需要通过主键进行回表操作,我们为字段添加索引通常就是二级索引。
问:知道什么是回表操作吗?
在innodb中,如果sql中的查询条件中不只有主键的时候,通过二级索引查到的主键再去聚簇索引中查询数据行的过程就是回表。而直接查询聚簇索引则不会出现回表的情况。
问:有了过覆盖索引吗?
查询数据通过索引进行查询,返回列都可以在索引的数据中找到(包含在其中),就是覆盖查询。
使用id主键进行查询就是覆盖索引查询,因为聚簇索引的数据中包含id主键,性能高。
在做查询的时候如果返回列吧全部存在于索引中就会回表查询 ,所以尽量避免使用select *。
问:Mysql超大分页查询怎么进行优化?
之前在现网环境时就存在数据量过大导致分页查询慢的问题,Mysql做limit分页查询的时候,需要做排序,这个过程非常耗时。旧的方案就是简单的对id排序然后做分页出现。
优化方案:
覆盖索引 + 子查询 + 游标:先提供子查询查询出排序过的主键id的集合(子查询)子查询中的条件就是平台id + 网校id用来控制某一个网校的数据(平台id + 网校id会有一个联合索引所以无需担心回表的操作),通过PreparedStatement(游标类)设置最后查询id及页面遍历查询出对应的分页数据(游标)减少每次扫描表的条数,在传统的分页中提供offset及limit来控制查询范围,每次查询时都会扫描offset前的数据,游标这不会扫描,提供id条件查询数据。(覆盖索引)
-
public List<User> fetchUsersByCoveringIndex(int pageSize, long lastId) { -
List<Long> ids = new ArrayList<>(); -
// 1. 先查询ID(覆盖索引查询,子查询) -
String idSql = "SELECT id FROM users " + -
"WHERE id > ? " + -
"ORDER BY id ASC " + -
"LIMIT ?"; -
try (Connection conn = dataSource.getConnection(); -
PreparedStatement ps = conn.prepareStatement(idSql)) { -
//通过游标遍历查询出分页数据(lastId用来控制id开始位置) -
ps.setLong(1, lastId); -
ps.setInt(2, pageSize); -
try (ResultSet rs = ps.executeQuery()) { -
while (rs.next()) { -
ids.add(rs.getLong("id")); -
} -
} -
} catch (SQLException e) { -
System.err.println("查询ID失败: " + e.getMessage()); -
throw new RuntimeException("数据库查询失败", e); -
} -
if (ids.isEmpty()) { -
return new ArrayList<>(); -
} -
// 2. 批量查询完整数据(覆盖索引) -
return batchFetchUsers(ids); -
}
运行项目并下载源码java运行
问:索引的创建原则有哪些?
1.数据量大于十万且查询的频率表较高的表我们才会考虑创建索引。
2.如果一个表需要添加索引,我们应该选择作为查询字段,排序字段,分组字段的字段作为索引,且字段的区分度要高。
3.在添加索引的时候都使用复合索引来创建,尽量使用覆盖查询, 降低回表的概率。
4.如果需要对长字符串添加索引我们可以使用前缀索引。
5.控制索引的数量,并不是越多越快,在增删改的时候我们也需要消耗时间来维护索引。
问:什么情况下索引会失效?
复合索引

1.在使用复合索引的时候不遵循最左前缀法则。在做条件查询的时候跳跃某一列字段导致索引部分失效。

2.在条件查询中的范围查询的右边的列不能使用索引,使用也会失效。(如果三个都有效的话 key_len应该为六百多,说明此时address字段失效)

3.在查询条件中如果对索引字段进行聚合函数的计算这会导致索引失效。

4.在条件查询的时候如果没有加单引号也会导致索引失效,在数据做自动类型转换的时候会导致索引失效。(就比如:0和'0',会进行类型转换,导致索引失效)
- 在模糊查询的时候,如果字符串中是以%开头的就会导致索引失效。(就比如: "%abc",%开头旧表明了有全盘扫描)
在我遇到的随影失效问题就是没有遵循最左前缀原则,只要实在测试的时候通过explain查询SQL语句的执行状态来判断的。
问:谈谈你对SQL的优化经验?
在做SQL优化的时候主要从:建表时,使用索引时,sql语句编写,主从复制,读写分离的方面进行考虑,当数据量过大的时候考虑使用分库分表。
问:创建表的时候你是怎么优化的?
我们主要遵循阿里的开发手册,就比如在使用整数类型的时候就考虑使用:tinyInt,Int,bigInt,如果是逻辑字段就使用tinyInt,在使用字符串是考虑使用:char,varchar,text。
问:那在使用索引的时候如何进行优化?
讲出索引失效的五种情况,再使用SQL的时候避免使用select *,使用覆盖索引减少回表的操作。
问:你平时SQL语句是怎么优化的?
1.select 指明字段,不要使用select * from防止回表的操作。
2.在使用聚合查询且无去重需求的时候尽量使用union all而不是union,union会多一次去重,在效率上比较低。
3.使用inner join 而不使用 left join/right join,如果要使用的,一定要以小表为驱动。
问:事务的特性是什么?可以详细说一下?
这里你可以取钱的例子来引导模式官。
原子性:在事务中的语句要么都成功要么都失败。
一致性:在事务中数据的总量不会变。
持久性: 提交和回滚的数据都会持久化到数据库。
隔离性:事务中间是是相互隔离的,是不会相互影响的。
问:并发事务带来了哪些问题?
并发事务可能会出现三种问题。
1.脏读:事务1读取到事务2未提交的数据。
2.不可重复读:事务2先后读取事务1中的某行个数据,两次的结果不一样。(多次读取的是同一行的数据时出现的问题)
3.幻读:一个事务在按条件查询数据时没有查到数据吗,但是插入操作时,又发现该数据已经存在。因为其他事务在这个过程中插入数据(条件查询时出现的问题)
怎么解决解决这些问题?
通过设置过隔离级别来解决。隔离级别包括:
1.读取未提交,无法解决并发事务带来的问题。
2.读取已提交,可以解决脏读。
3.可重复读,可以解决脏读,不可重复读。
4.串行化,事务只能一个一个执行,可以解决脏读,不可重复读,幻读,隔离级别最高,效率最低。
MySQL默认的隔离级别是什么?
Mysql默认使用的隔离级别是:可重复读。
问:undo log和rado log有什么区别?
redo log:用于记录数据页的物理变化,当服务宕机的时候进行数据同步操作。保证了事务的持久性。
undo log:记录逻辑日志,就比如:当做插入操作时会在日志中记录逆向的操作也即是删除,在事务回滚的时候会执行逻辑日志中的指令。保证了事务的原子性。
问:隔离级别是怎么实现的?
排他锁+MVCC实现的。
问:说说你对MVCC的理解吧?
多版本并发控制。维护一个数据的多个版本,使得读写操作没有冲突。
mvcc主要有三个重点:
1.隐藏字段:trx_id(事务id):记录当前事务的id,其为自增的。 roll-pointer:指向上一个版本的事务记录地址。
2.undo log:回滚日志,存储老版本的数据,版本链:多个同时修改某条记录,产生多版本的数据,通过rool-pointer指针形成链表。
3.readview:解决一个事务查询选择版本的问题。
根据readView的访问规则和当前事务id找到对应的版本信息。
范围规则:
1、事务id(trx_id)是否是当前事务id,如果是的话则读取到事务中的数据。
2、事务id(trx_id)是否小于当前最小的活跃事务id,是则说明已经提交了,可以读取。
3、事务id(trx_id)是否在活跃事务id集合中,如果存在说明事务还未提交,这个时候就不能进行读取。
4、事务id(trx_id)是否小于low_limit_id(下一个分配的事务id),小于的话说明已经提交,这个时候就是可读取的。
不同的隔离级别快照读是不一样的,最终的访问结果也是不一样的。(问时答:当前读:读取的是最新的数据并且会加锁。快照读:读取的是记录数据的可见版本,不会加锁。)
读已提交:在每次快照读的时候都会生成readview。
可重复读:在有在第一次快照读的时候才会生成readview,后续的快照读都是使用该readview的复制,保证数据的一致性。
问:隔离级别中可重复读有什么缺点呢?
1.无法解决幻读的问题,当我们事务去读取一定范围的数据,且在该过程中其他的事务修改了该范围的数据,此时两次读取就会出现查询结果不一致的情况,最终导致幻读。
2.无法读取到最新的数据,因为可重复读在每次读取的时候都使用同一个readView,且readView并非当前最新的数据,最终导致无法读取到新的数据。因为可重复度的进行数据读取的时候readView都是复制来的。
问:MySQL的主从同步有了解过吗?
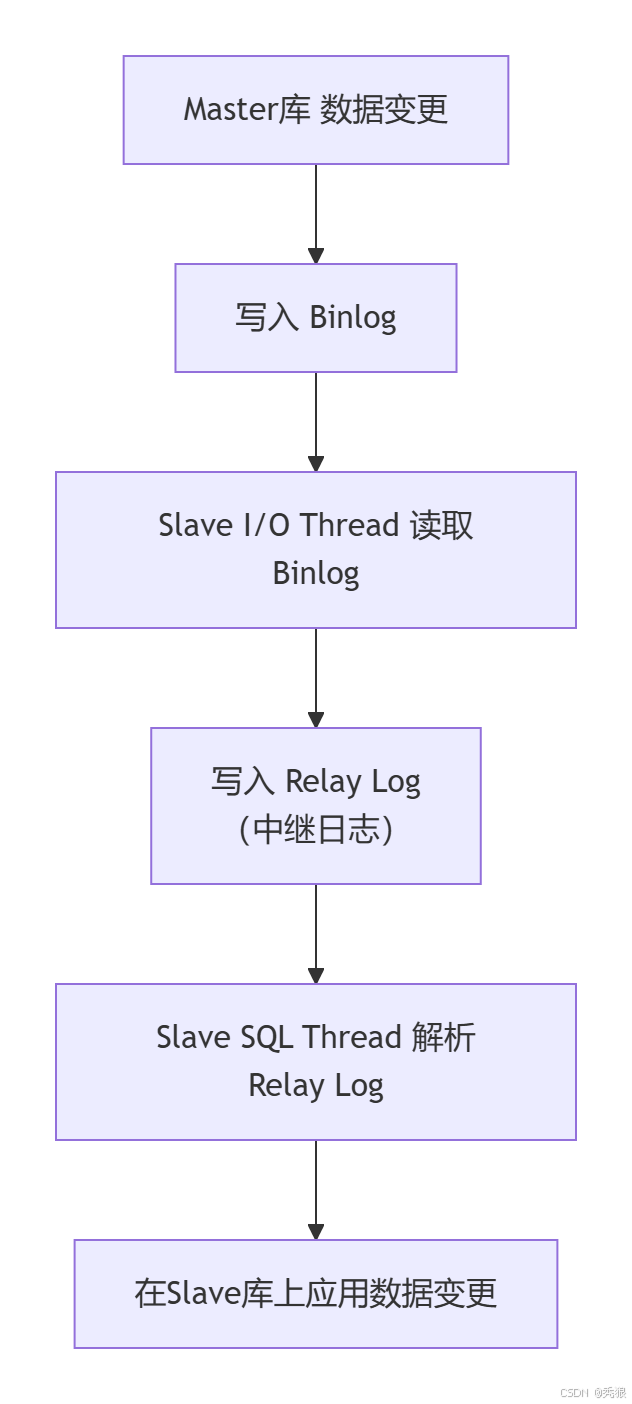
Mysql主从同步的核心就是bin log(二进制日志),这个日志中主要记录 DDL(表的操作),DML(表中数据的操作)。

1.master中事务提交数据后,会将修改的数据保存到bin log中。
2.slave有个iothread线程会监控的bin log的变化,并将变化写入relay log中。
3.slave有个SQLthread线程会监控relay log,将改变的数据写入slave中。
问:你在项目中有使用过分库分表吗?
在在线教育项目中的订单服务的数据非常庞大,请求数多且业务累计大。差不多单表的数据有100w条,这时我们就使用分库分表。
分库分表有四种策略:
1.水平分库:通过将一个库中的数据拆分到多个库中,解决海量数据存储和高并发的问题。主要通过sharing-sphere和mycat实现。
2.水平分表:解决单表存储和性能的问题。
3.垂直分库:根据业务来拆分库中的表,在高并发的情况下提高磁盘IO和网络连接数。每个微服务都有自己的表。
4.垂直分表:冷热数据分离,多表不会相互影响。就比如:表中字段为id,name,des,将id,name和des分离,id和name都是热数据而des为冷数据,访问频率较低。
框架八股文
问:Spring中的设计模式有哪些?
我目前使用到的模式包括:工厂模式、单例模式、代理模式、责任链模式、模板模式。
1.工厂模式:BeanFactory就是最典型的工厂模式,我们在使用autoWired注解本质就是调用BeanFactory获取注解方法,我们无需过度关注类是怎么创建的,直接使用即可。
2.单例模式:IOC的Bean注入采用的就是单例模式,默认情况下在初始化的时候会把对应的Bean提前初始化出来,这就是饿汉式。然后对对应的类属性设置了@Lazy注解,那么,这个类实例只有在被使用的时候才会被创建出来,这就是懒汉式。
3.代理模式:aop就是基于代理模式来实现的,如果被代理的类有实现接口的时候,会采用proxy类进行代理,本质就是生成一个新的实现当前被代理类的使用实现接口的类进行返回。如果当前类没有实现接口的时候,就会使用cglib来进行代理,生成一个被代理对象的子类进行返回。
4.责任链模式:最经典的就是stream流式编程。
5.策略模式:这个模式还是比较采用的,我们访问第三方接口的时候会有一个接口机,就比如:推送学分到管理系统的时候,我们会有一个模板类,这个接口中会有数据准备方法、数据校验方法、数据推送方法、推送后续处理方法,实现这个模板类就可以自定义推送规则。
问:spring框架的单例bean是线程安全的吗?
在spring框架中有个注解叫@Scope可以设置bean的状态,默认就是singleton也就是单例。
bean进行注入的时都是无状态的,其不会被修改的。所以没有线程安全的问题。但是如果bean中有成员变量时就可能会有线程安全的问题,因为该成员变量可能会被多个线程修改,为了解决这个问题我们可以加锁或将bean设置为多例。(@Scope设置为prototype)
问:什么是AOP?
面向切面编程,将那些于业务无关的复用性比较高的代码快抽取出来,较低代码的耦合度。
问:在你的项目中有使用过AOP吗?
在我的云盘项目中就使用到AOP,在记录日志的时候,我创建有个自定义注解,aop的切面就是这个注解,使用环绕通知在方法中,我们通过传入的参数(joinPoint)获取对应的类和方法,从而获取前端传来的参数和其他主要信息,实现记录日志的效果。
问:Spring中的事务是怎么实现的?
本质就是通过AOP实现的,通过环绕通知对应方法进行前后拦截,在方法执行前开启事务,在执行后提交事务,会对此过程进行try/catch,如果报错直接回滚。(就是@transactional)
问:spring中事务失效场景有哪些?
1.在出现异常后,方法中try/catch了该异常并且没有主动抛出异常,这时候就会导致事务失效。解决方法:在方法try/catch异常后手动的抛出异常。(就会导致事务不知道出现异常了)
2.抛出检查异常时会导致事务失效,spring中的事务只会对runtime异常进行回滚。就比如:Not found Exception就是检查异常。解决方法:在@transactional中设置属性 rollbackFor = Exception.class。使得事务会对所有的异常进行回滚。
3.非public方法会导致事务失效。解决方法:将方法的作用域该为public。
4.在非事务方法中调用了事务的方法,此时就会导致事务失效。(就比如某给没有加事务注解的方法调用了加了事务注解的方法)
5.回滚异常类型不匹配。(我们可能会设置需要进行回滚的异常,就是rollback的值,如果抛出的异常类型不匹配就会导致事务失效)
6.事务的传播行为错误。(就比如在事务方法中调用了其他的事务方法,初始化如果其他的时候方法设置开启新事务的话,在其事务成功后,就不会参与外部事务的回滚操作)

问:事务的传播性有哪些?
主要就是三个:Propagation_Required,Propagation_Required_new,Propagation_nested。
- Propagation_Required:如果B为A的子方法,并且都为该传播类型,那么它们都会在同一个事务中。如果主方法中没有开启事务的话就会开启新事务。
- Propagation_Required_new:如果B为A子方法,B会创建一个独立的事务,B不会受A事务的影响。
- Propagation_nested:如果B为A子方法,B会创建一个事务内嵌到A的事务中,如果A中没有事务的话,就单独开启一个事务。