技术栈
爬虫,如何查找一个网页的header请求头?
洛兮银儿
2026-03-18 8:51
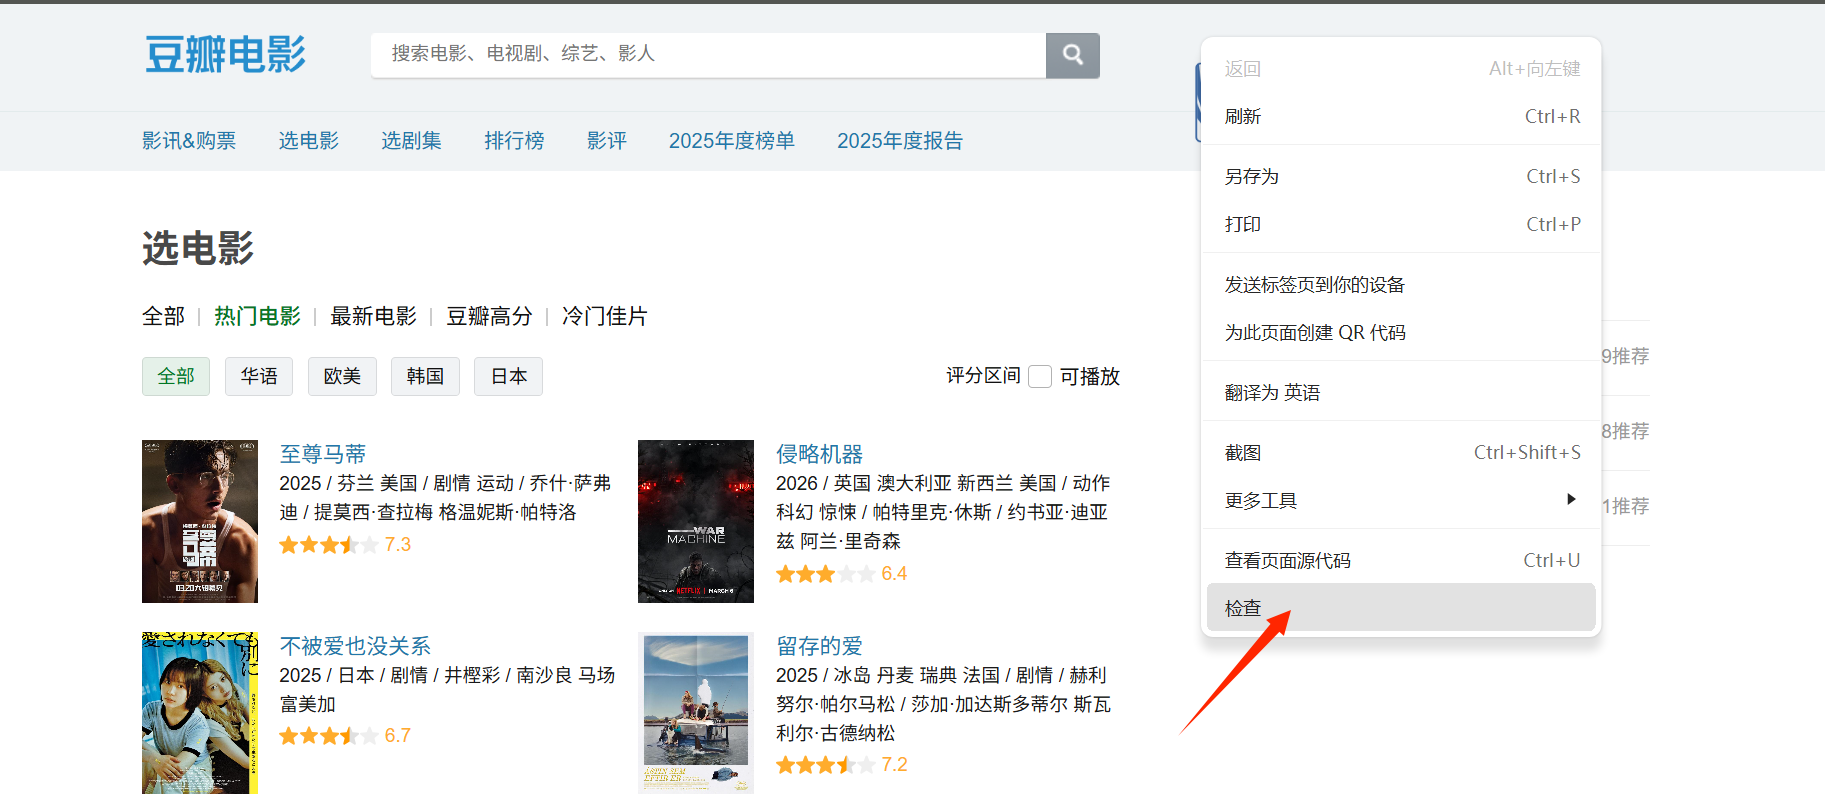
以下以某网页为例子
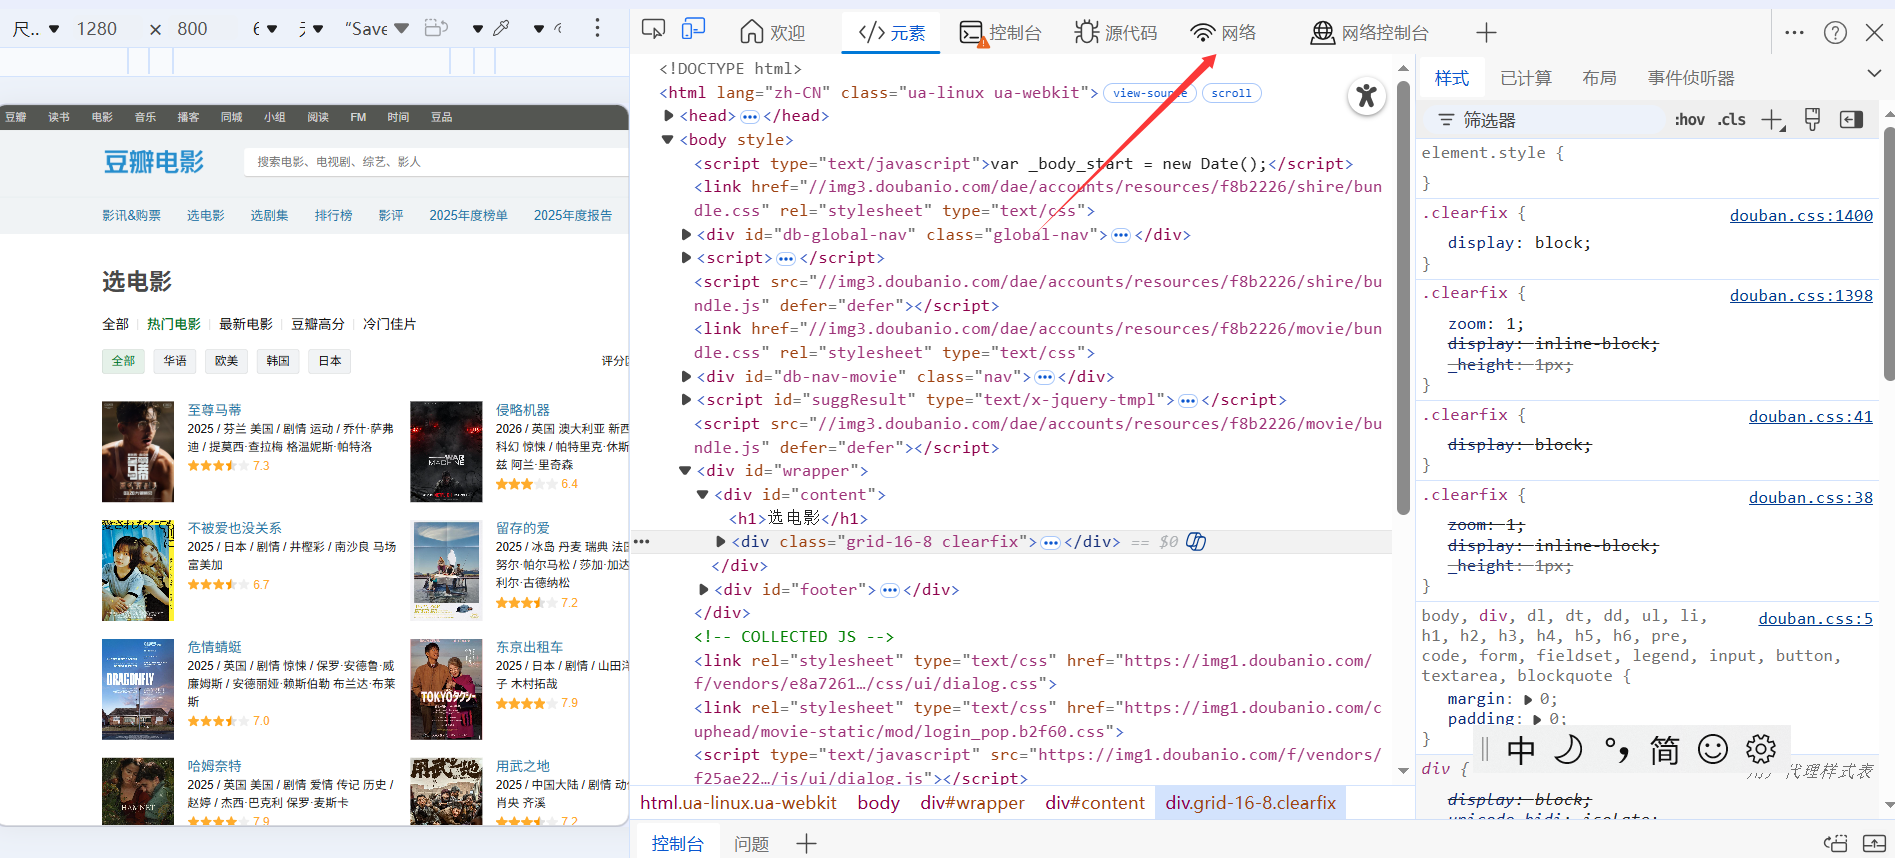
在网页右键,点击检查
进入检查页面,找到网络,也叫network。
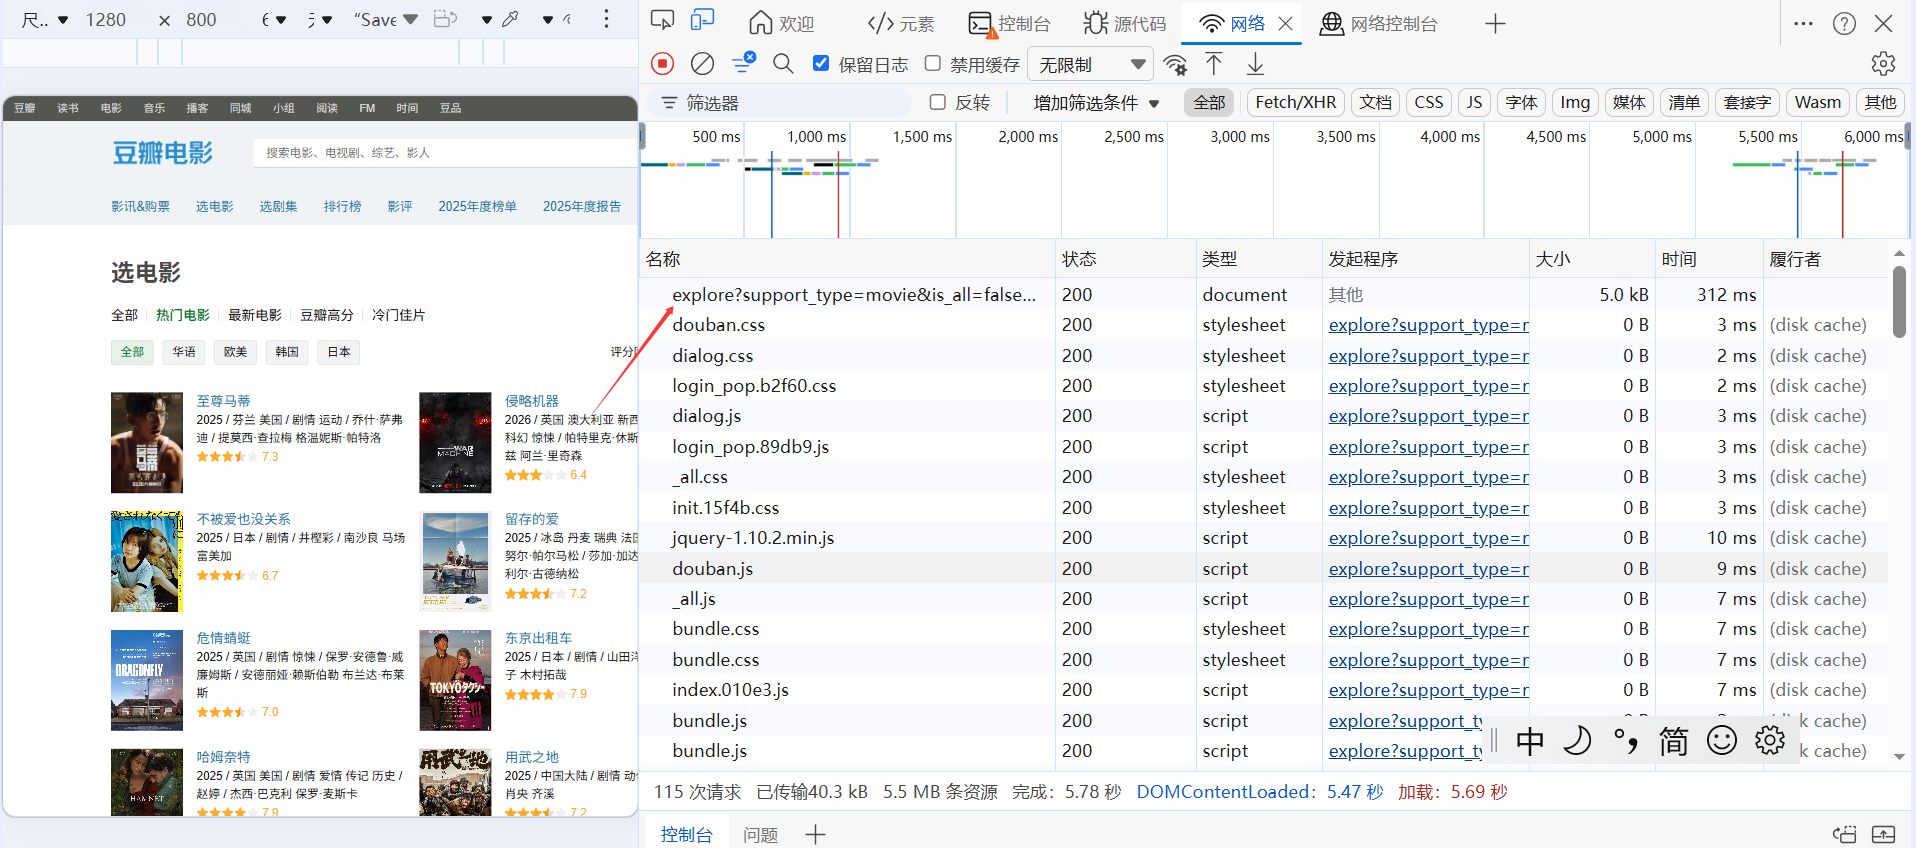
点击网络以后,键盘敲打ctrl+R,进入一个页面
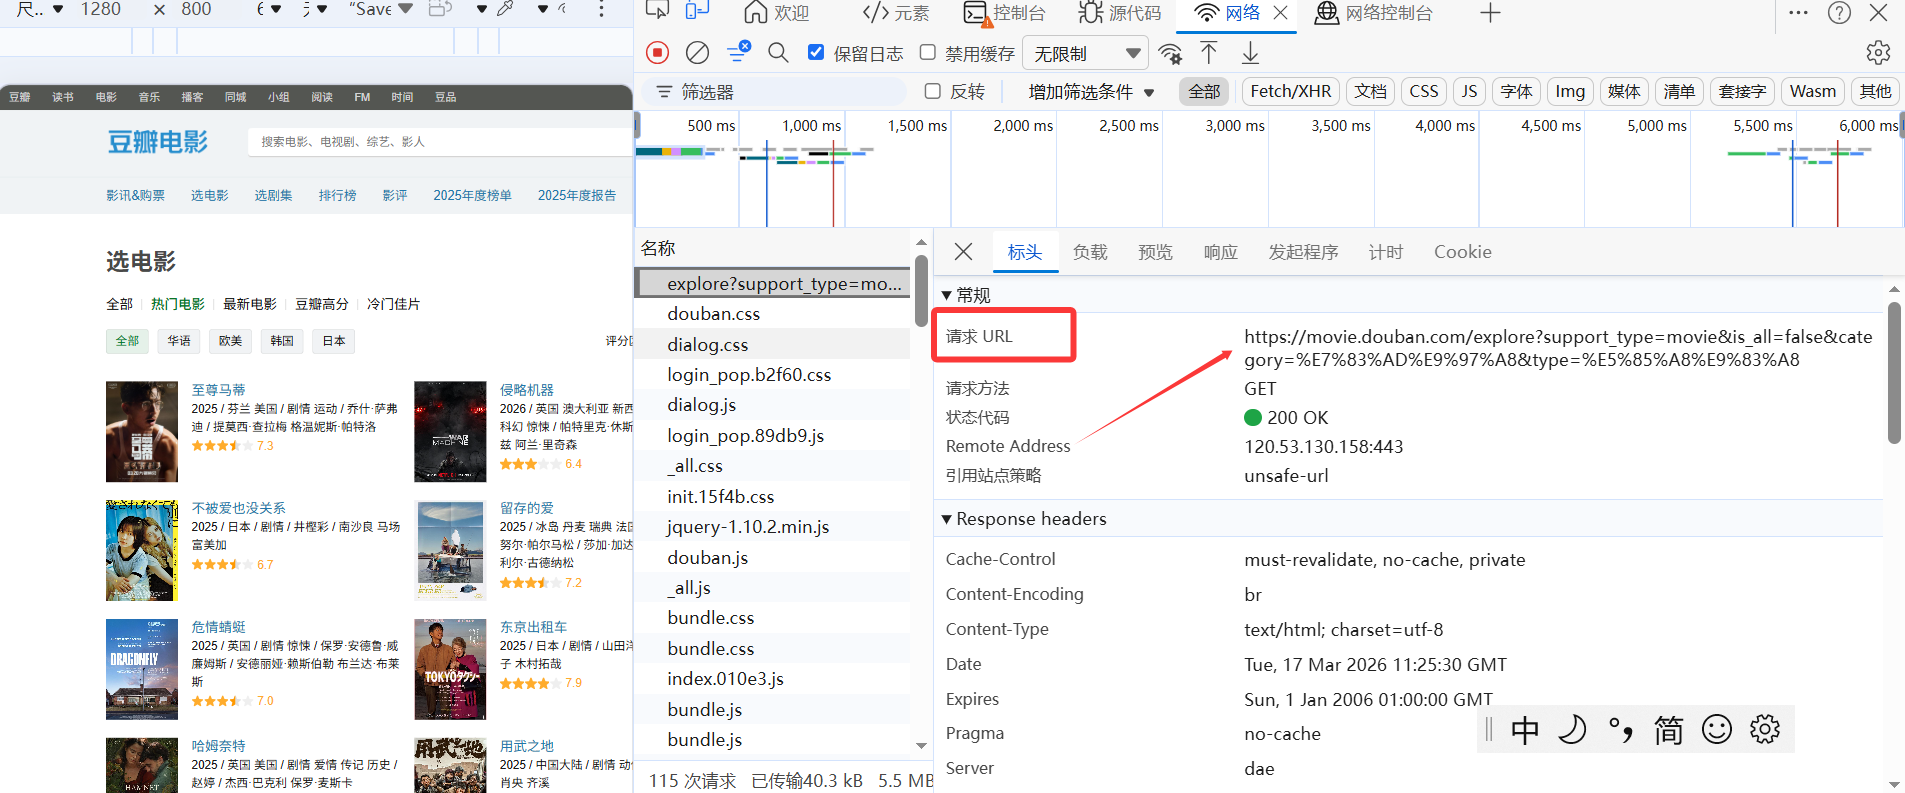
进入后会显示很多名称,一直往上滑,找到第一个名称,点击它,就会显示请求头URL了。
python
上一篇:
像摩尔线程和 沐曦科技怎么解决 nccl 通信问题
下一篇:
WaitableEvent 跨线程等待的死锁陷阱
相关推荐
爱你真是太好了
10 分钟前
Skill 索引瘦身与渐进加载
python
贾公子
13 分钟前
检测链路的容量规划——用 Little's Law 算清 QPS、并发与积压
后端
·
python
天天被压力
30 分钟前
【A股分钟级高频数据完全手册 #06】北交所分钟级数据接口:京市股票Pro版最新分时
java
·
人工智能
·
python
天天被压力
36 分钟前
【A股分钟级高频数据完全手册 #05】指数历史分钟数据接口:Pro版沪深指数分时回放
java
·
人工智能
·
python
ATMQuant
1 小时前
量化策略开发08:Lasso因子选择 - 因子动物园的断舍离
python
·
量化交易
·
lasso
·
vnpy
·
多因子选股
ATMQuant
3 小时前
量化指标解码21:逻辑回归支撑阻力 - 让逻辑回归给关键价位打分
python
·
机器学习
·
逻辑回归
·
量化交易
·
技术指标
q037180
3 小时前
深色 IDE 截图 OCR 老是漏字,我加了一层预处理,顺手把识别结果做成了可搜索历史
python
蜗牛875
4 小时前
个人机票监控开源项目:6 个平台、10 条通道的自托管方案
python
秋名山小白
5 小时前
Playwright UI 自动化测试实战教程
python
·
ui
AI源码
6 小时前
基于 Python 的汽车市场数据分析与可视化平台
python
·
数据分析
·
汽车
热门推荐
01
如何新建文件夹? 电脑新建文件夹的4种方法
02
国内可直接用、免费额度/永久免费的大模型API清单(含 SiliconFlow、火山、阿里、智谱、百度、Kimi、DeepSeek、DMXAPI 等)
03
历年考研数学一、数学二、数学三真题试卷及答案PDF
04
几个好用的ip纯净度检测网站
05
GitHub 镜像站点
06
苹果iPA游戏软件资源下载网站
07
蜘蛛磁力 搜索引擎大全,如何使用蜘蛛磁力查找磁力链接
08
昇腾910B系列芯片完全指南:四款型号对比、服务器选型与大模型部署实战
09
微信历史版本含下载地址( Windows PC | 安卓 | MAC )及设置微信不更新
10
Dify:一站式AI应用开发平台全解析与Windows部署指南