前言
既然是学习langchain,那么最好的学习路径就是按照官方文档上开始学,后续文章也会按照这里学习下去。
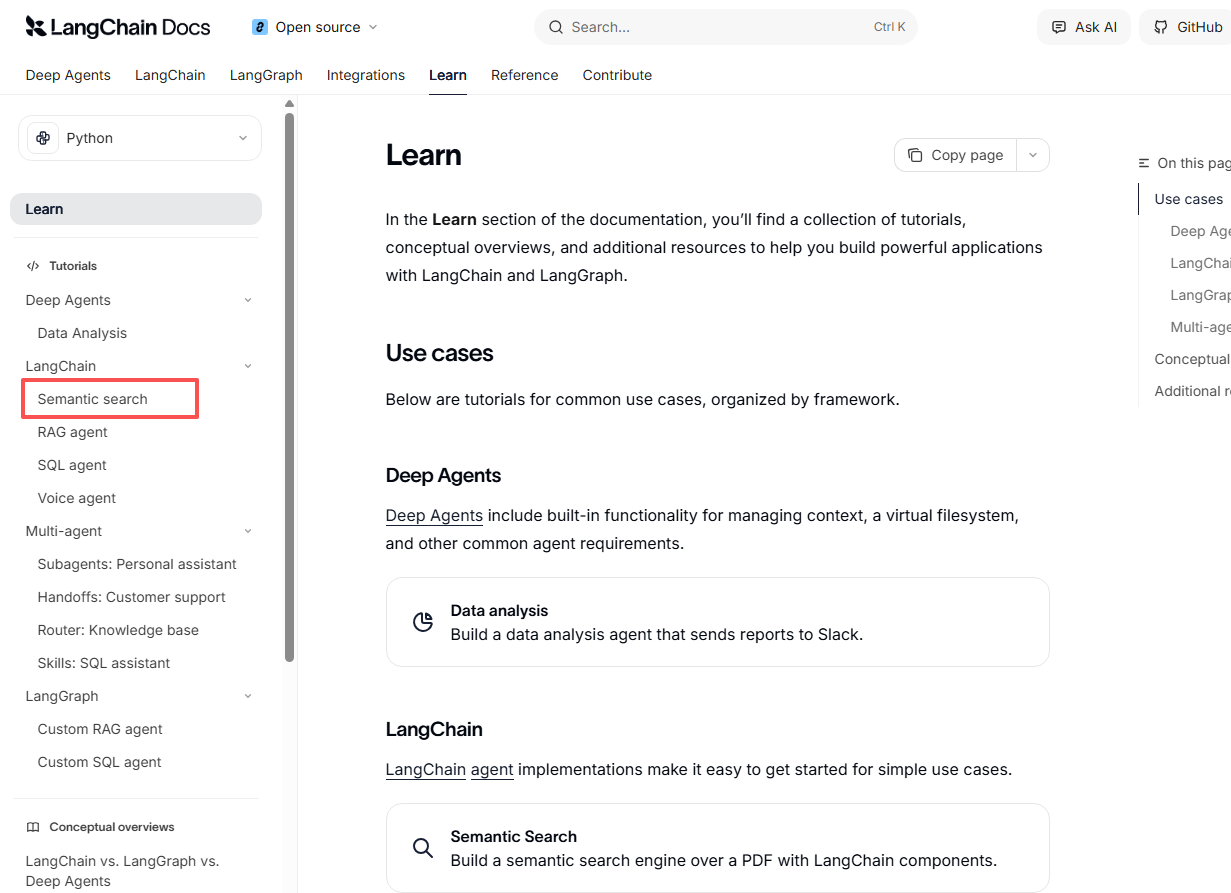
本文从Semantic search 语义搜索开始学习。
编码
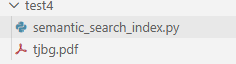
本文主要阐释了经典的 RAG(检索增强生成)架构中的"数据入库"部分,找个比较简单的PDF来测试,我这里找了我自己的一份体检报告PDF来用。放到了项目中,目录结构如下图
先安装pdf处理的插件pypdf,它提供了pdf文件的解析功能。
pip install pypdf
代码:
1.读取pdf
from langchain_community.document_loaders import PyPDFLoader
file_path = 'test4/tjbg.pdf'
loader = PyPDFLoader(file_path)
docs =loader.load()
2.分割文本
from langchain_text_splitters import RecursiveCharacterTextSplitter
text_splitter = RecursiveCharacterTextSplitter(
chunk_size = 300, #每块token/chunk size越小,块越多
chunk_overlap = 50, #重叠部分
separators = "\\n\\n", "\\n", "。", # 强制按行切分
add_start_index = True
)
all_splits = text_splitter.split_documents(docs)
3.向量化
from langchain_ollama import OllamaEmbeddings
embeddings = OllamaEmbeddings(
model="qwen3-embedding:4b",
base_url="http://172.23.2.18:11434")
4.向量库存储
from langchain_chroma import Chroma
vector_store=Chroma(
collection_name="test",
embedding_function=embeddings,
persist_directory="./chroma_langchain_db"
)
ids = vector_store.add_documents(documents=all_splits)
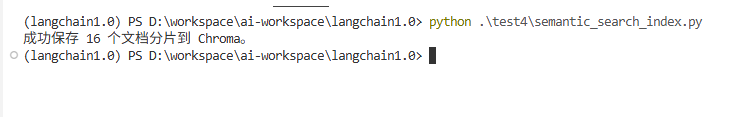
print(f"成功保存 {len(ids)} 个文档分片到 Chroma。")
运行结果:
解释
说说这段代码干了什么:
1.加载阶段
loader = PyPDFLoader(file_path)
docs =loader.load()
PyPDFLoader 像是一个扫描仪。它打开 PDF,读取每一页的内容、字体和元数据,并将其转化为 LangChain 能够理解的 Document 对象。
原始 PDF 是二进制格式,计算机很难直接"阅读"其中的语义。这一步将其提取为纯文本。
- 切分阶段
text_splitter = RecursiveCharacterTextSplitter(
chunk_size = 300,
chunk_overlap = 50,
separators = "\\n\\n", "\\n", "。"
)
把长篇大论的文档切成 300 字左右的小段(Chunks)
chunk_overlap (50):每一段都会包含上一段末尾的 50 个字。这非常重要,它可以防止上下文在切分点被强行切断(比如一句话断成两半,AI 就看不懂了)。
separators:因为我的文档是体检报告,所以优先按段落切,其次按行切,最后按句号切,保证语义完整。
- 向量化阶段
embeding = OllamaEmbeddings(model="qwen3-embedding:4b")
这里是最重要的一步。Embedding 模型会将每一段文字转化成一串数字列表(向量)。
它把文字投影到一个高维空间中。意思相近的句子(例如"心率偏快"和"脉搏跳动迅速"),在这个空间里的距离会非常接近。
因为电脑不认识汉字,但擅长算数。有了坐标,我们就能通过数学计算找到"最相关"的内容。
- 存储阶段
vector_store = Chroma(
collection_name="test",
embedding_function=embeding,
persist_directory="./chroma_langchain_db"
)
ids = vector_store.add_documents(documents=all_splits)
Chroma 是一个专门存储向量的数据库。不仅存下了你切好的文字,还存下了对应的"坐标"(向量)。
为了实现快速检索。当你问"这份报告的心率正常吗?"时,程序会把你的问题也变成坐标,然后在数据库里瞬间找出离这个坐标最近的几个文本块。