蚂蚁暑期 319 笔试
全相等
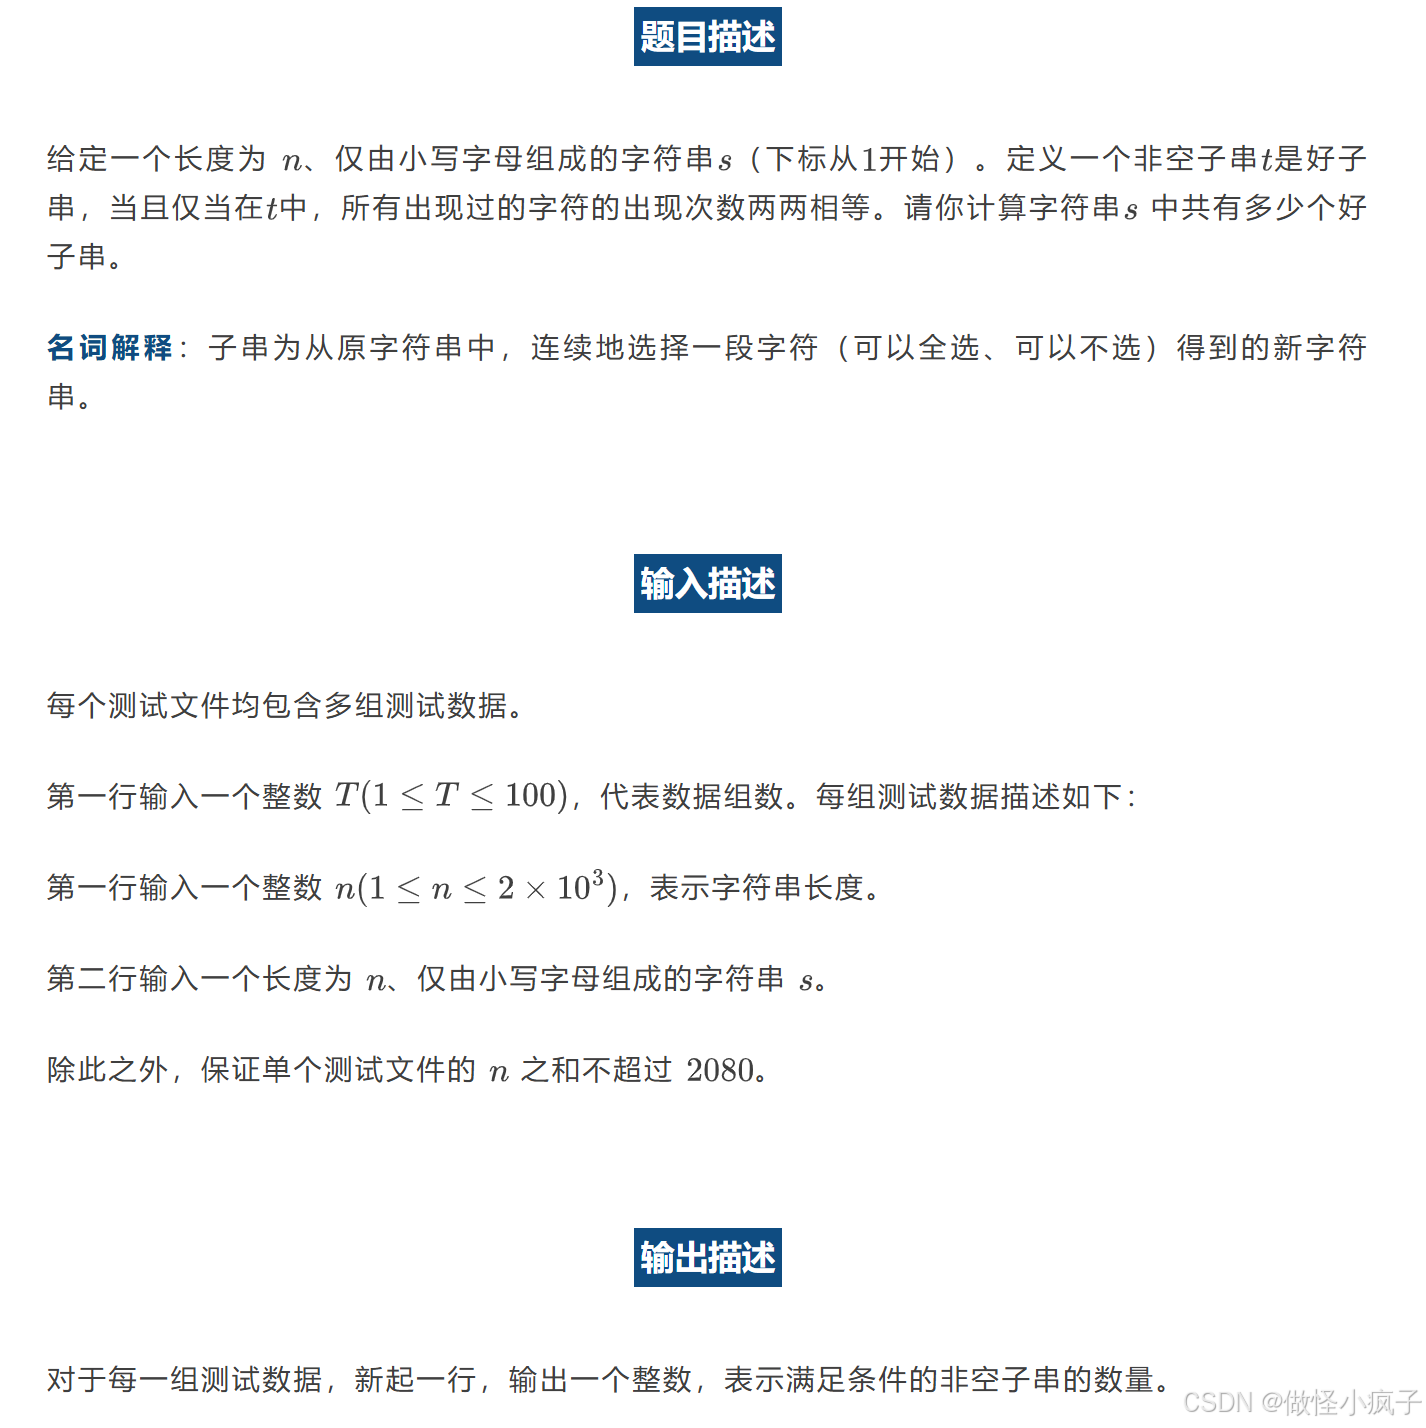
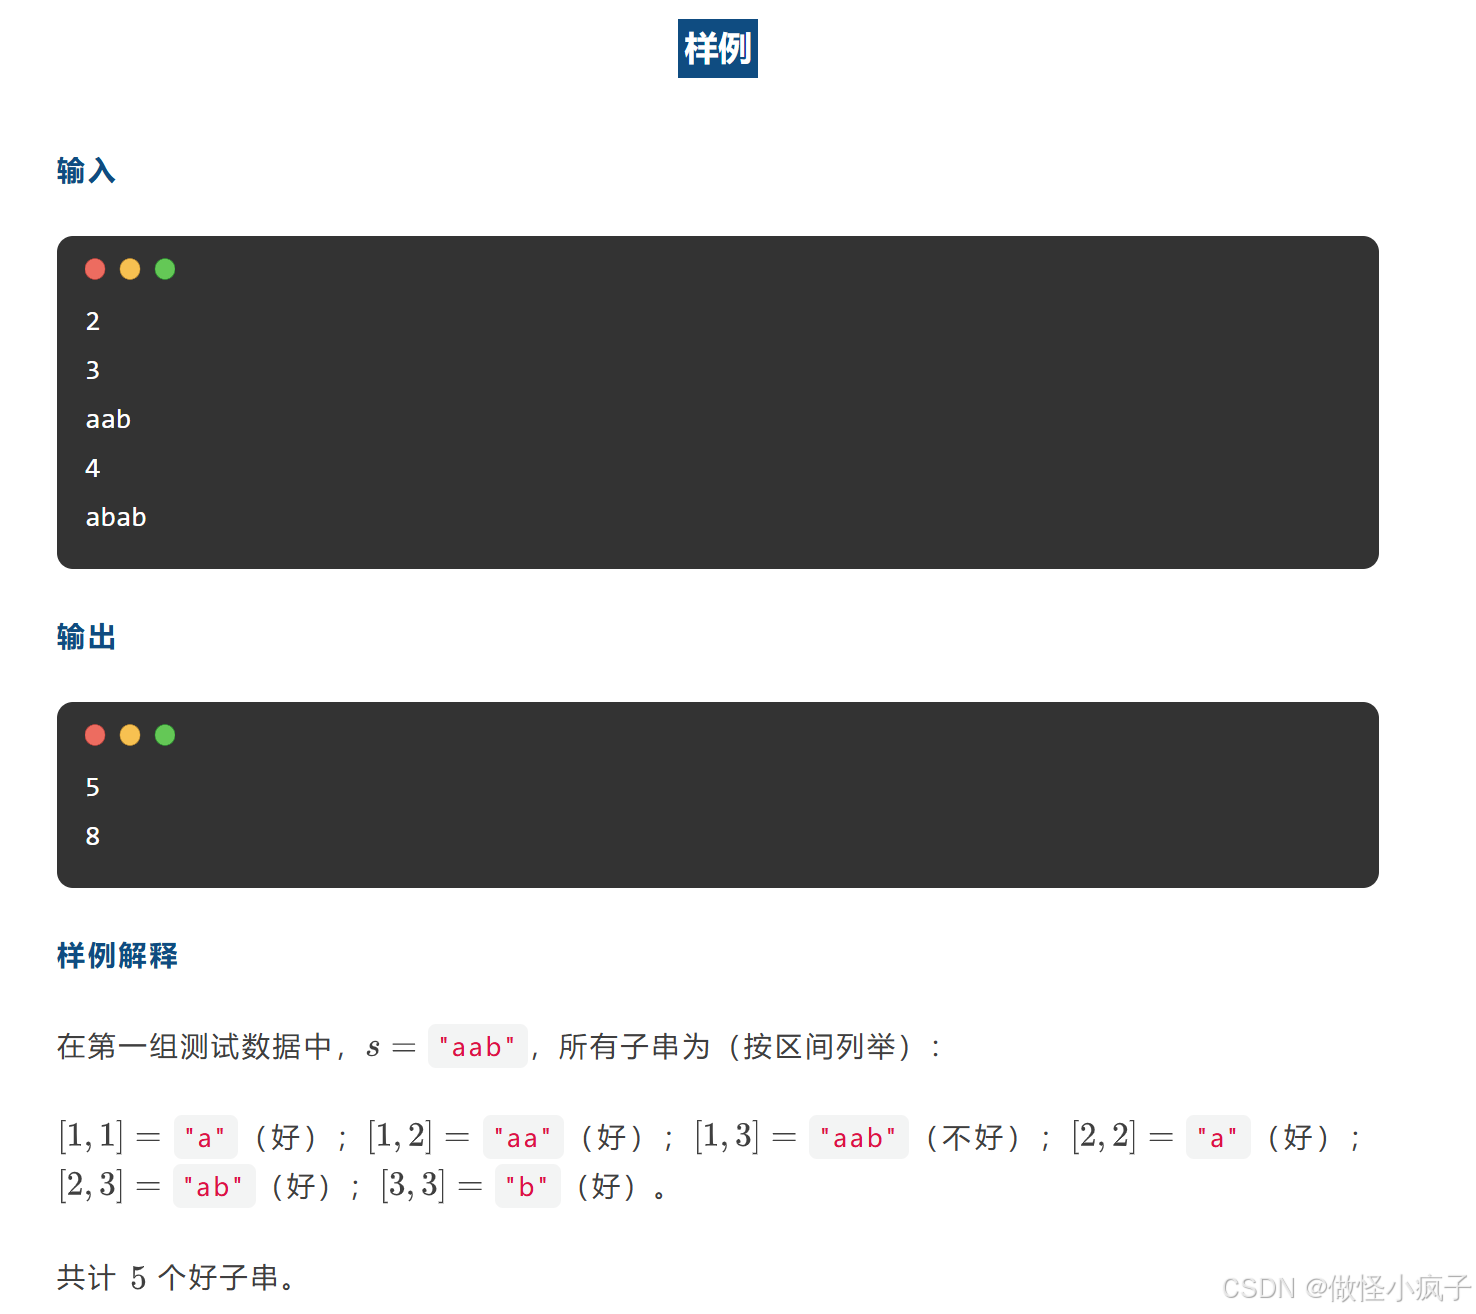
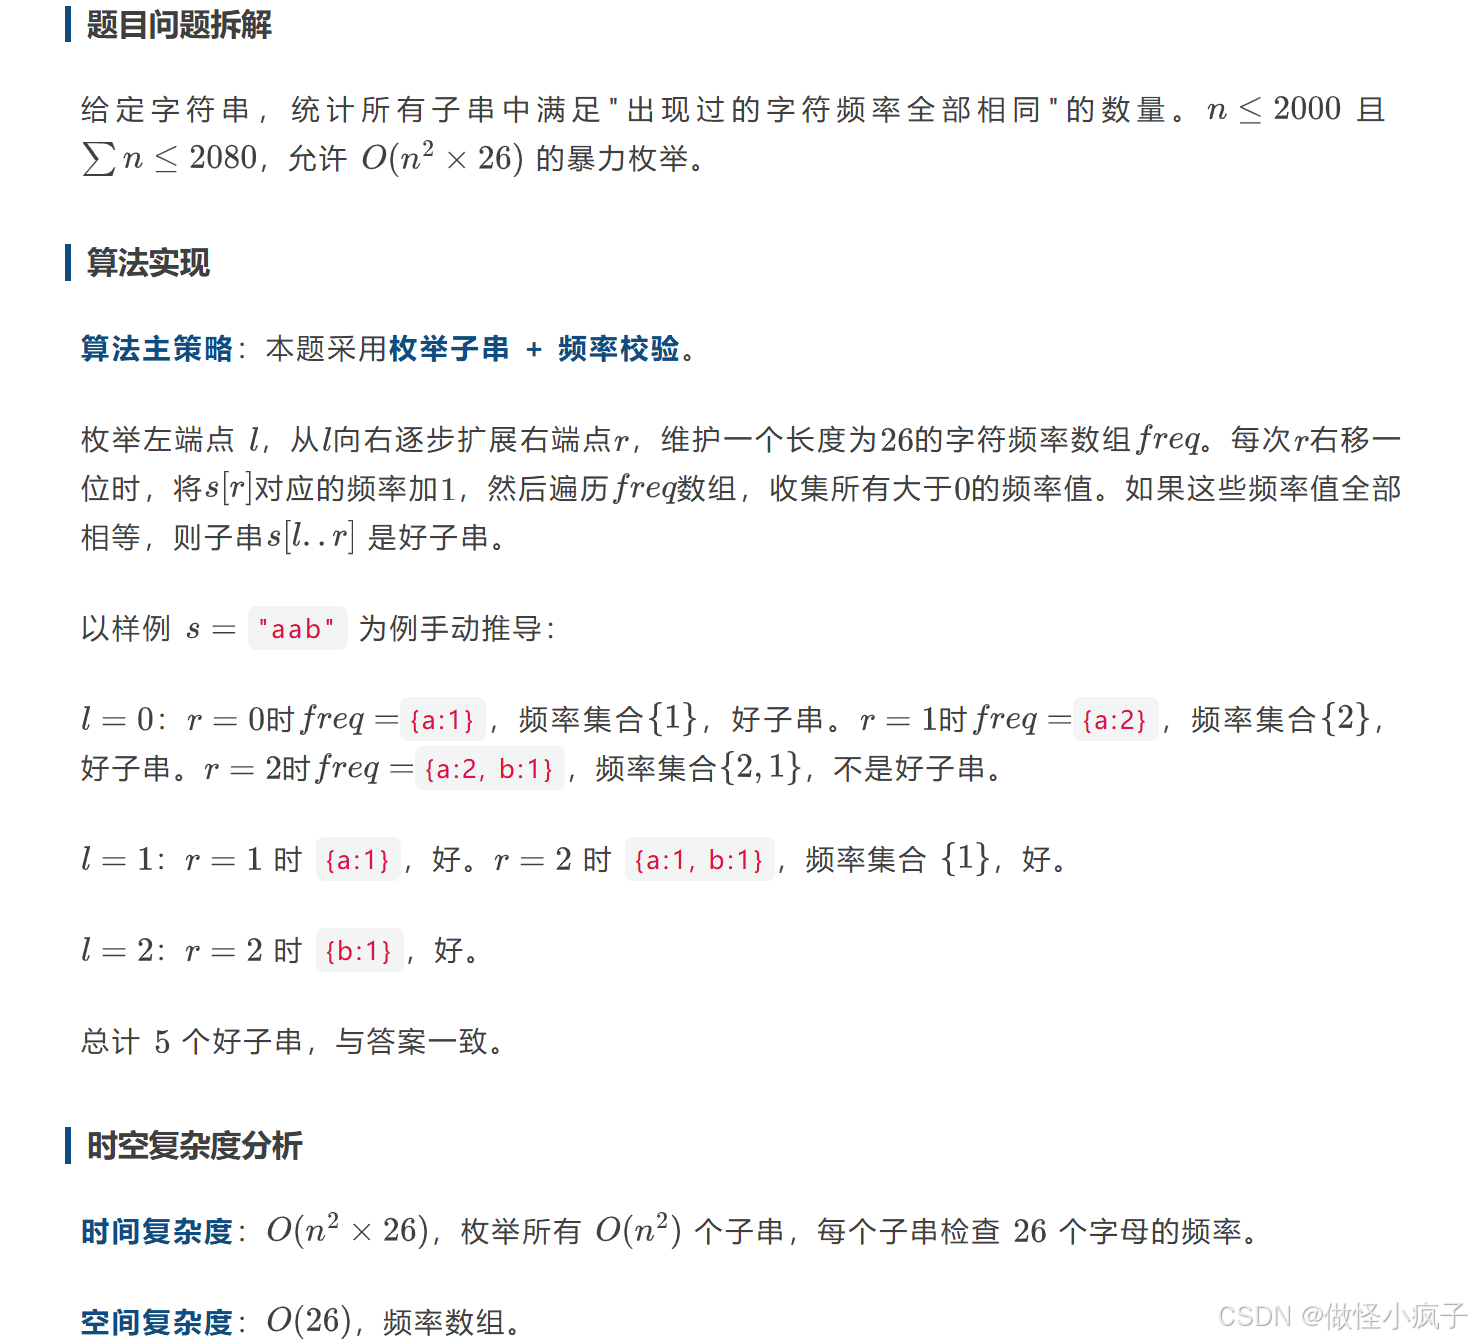
解题:
python
def solve():
    n = int(input())
    s = input()
    ans = 0
    for left in range(n):
        freq = [0] * 26
        for right in range(left, n):
            freq[ord(s[right]) - ord('a')] += 1
            vals = set(i for i in freq if i > 0)
            if len(vals) == 1:
                ans += 1
    print(ans)

T = int(input())
for _ in range(T):
    solve()
文本数值混合特征工程
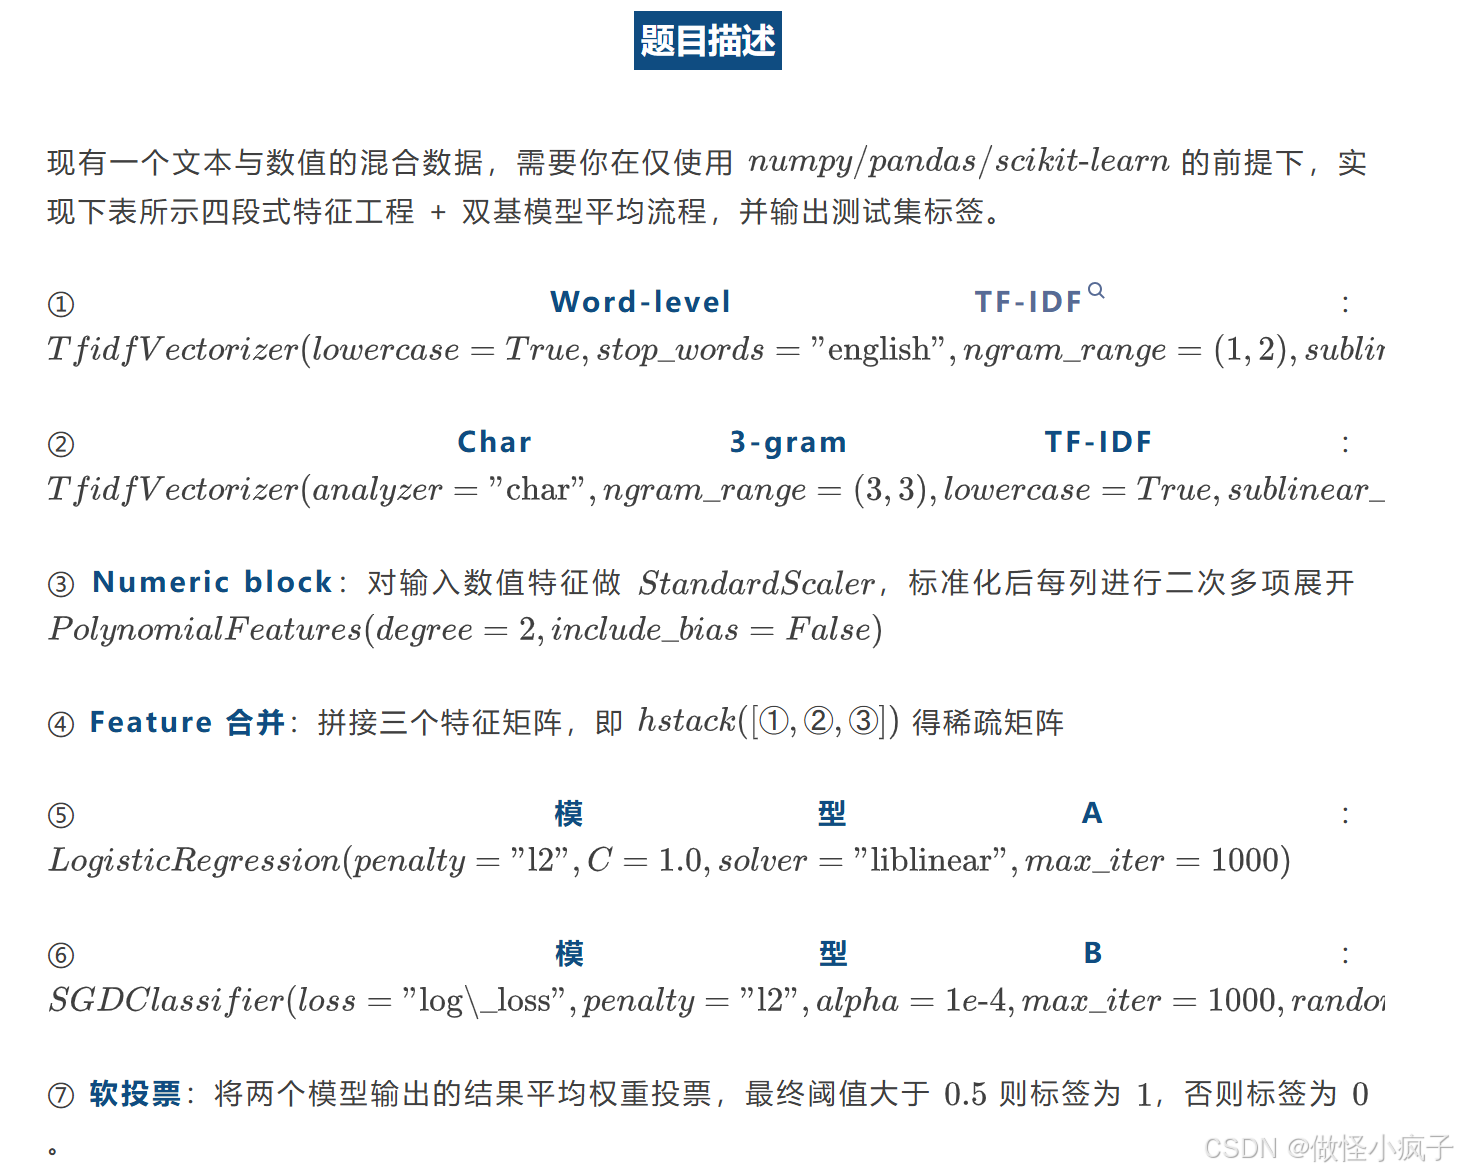
求解:
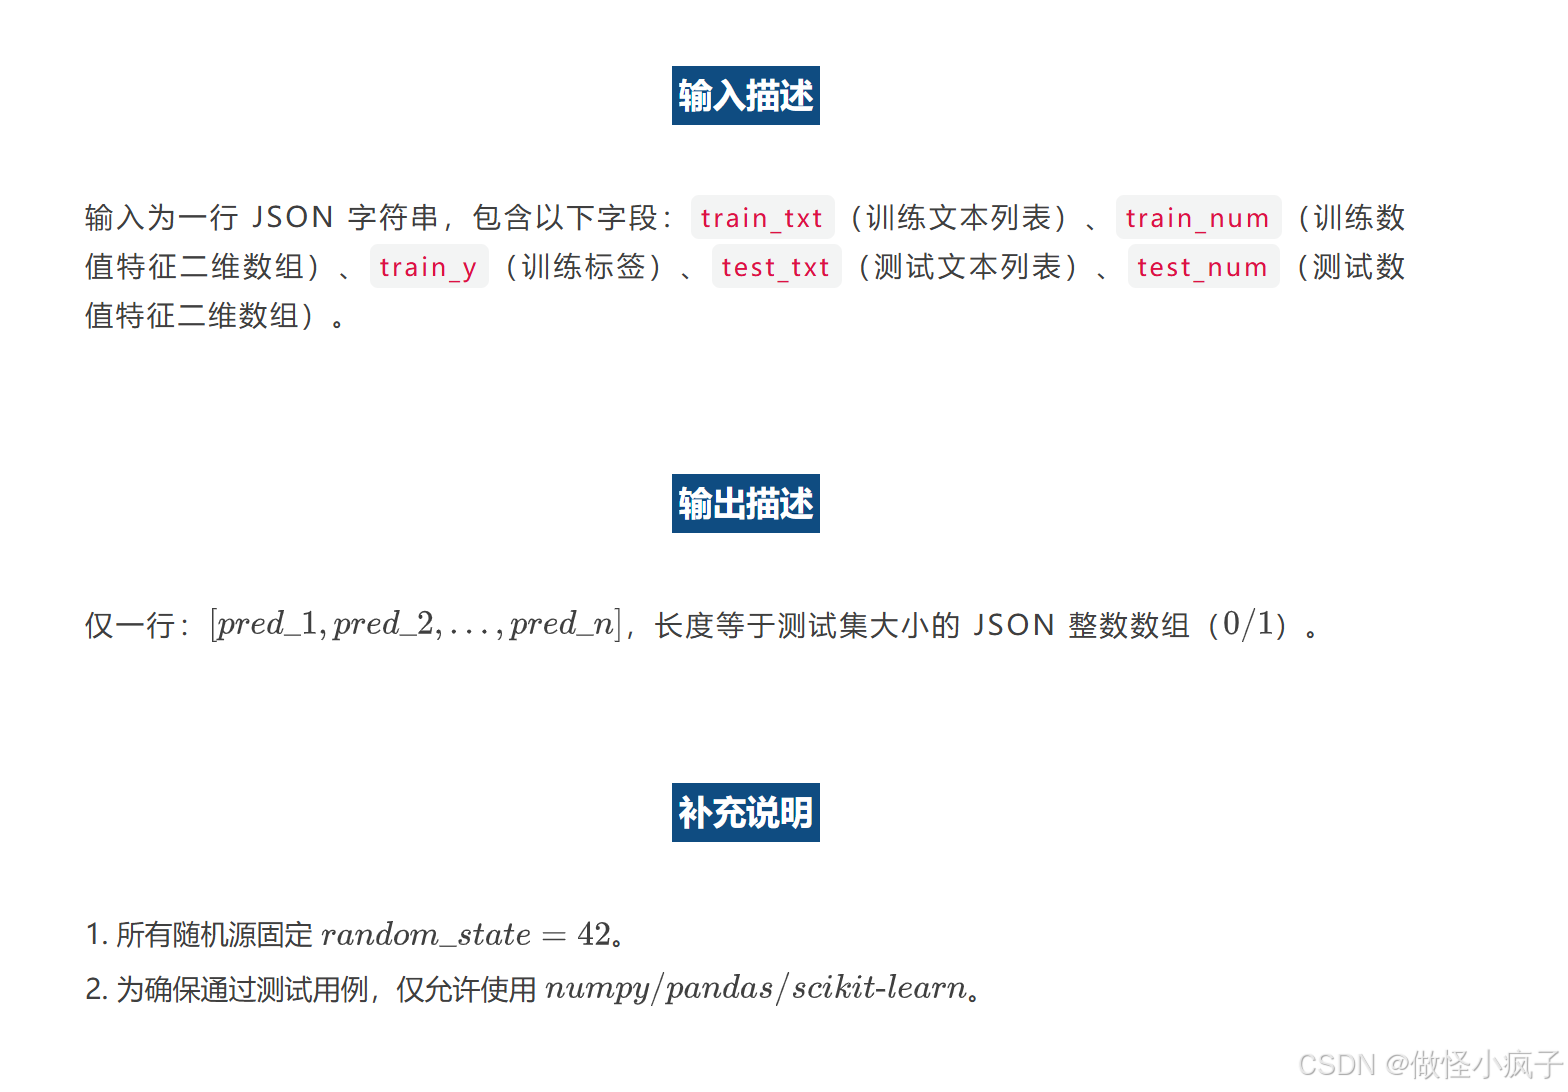
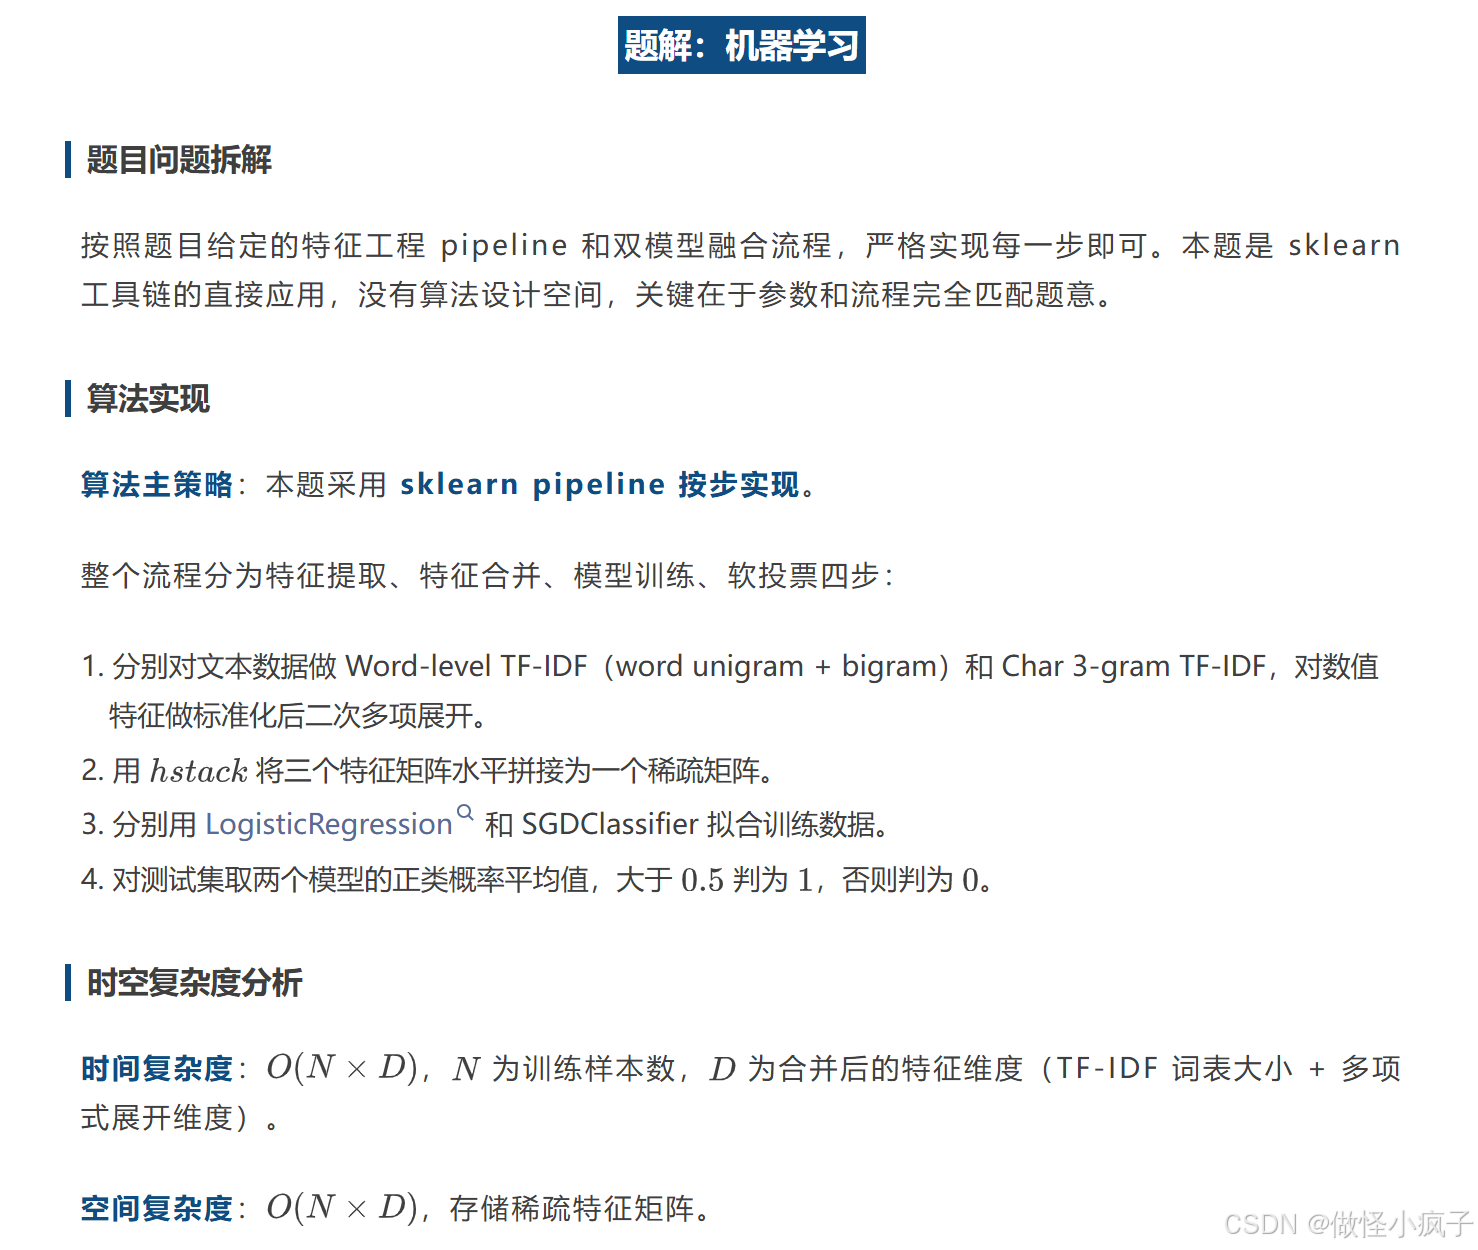
机器学习的题目 本质都是 数据加载 -> 特征处理 -> 模型训练 -> 预测输出 这四个固定模块
python
import json
import numpy as np
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import SGDClassifier, LogisticRegression
from sklearn.preprocessing import StandardScaler, PolynomialFeatures
from scipy.sparse import hstack

# 1. 加载数据
data = json.loads(input())
train_txt = data['train_txt']
train_num = np.array(data['train_num'])
train_y = np.array(data['train_y'])
test_txt = data['test_txt']
test_num = np.array(data['test_num'])

# Word-level TF-IDF
word_vec = TfidfVectorizer(lowercase=True, stop_words="english",
                           ngram_range=(1, 2), sublinear_tf=True)

tr_word = word_vec.fit_transform(train_txt)
te_word = word_vec.transform(test_txt)

# Char 3-gram TF-IDF
char_vec = TfidfVectorizer(analyzer="char", ngram_range=(3, 3),
                           lowercase=True, sublinear_tf=True)
tr_char = char_vec.fit_transform(train_txt)
te_char = char_vec.transform(test_txt)

# Numeric: StandardScaler + PolynomialFeatures
scaler = StandardScaler()
poly = PolynomialFeatures(degree=2, include_bias=False)
tr_num = poly.fit_transform(scaler.fit_transform(train_num))
te_num = poly.transform(scaler.fit_transform(test_num))


# 合并
X_tr = hstack([tr_word, tr_char, tr_num])
X_te = hstack([te_word, te_char, te_num])

# LogisticRegression
lr = LogisticRegression(penalty='l2', solver='liblinear',
                        max_iter=1000, random_state=42)
lr.fit(X_tr, train_y)

# SGDClassifier
sgd = SGDClassifier(loss='log_loss', penalty='l2', alpha=1e-4,
                    max_iter=1000, random_state=42)

sgd.fit(X_tr, train_y)

# 软投票
prob = (lr.predict_proba(X_te)[:1] + sgd.predict_proba(X_te)[:1]) / 2
preds = (prob > 0.5).astype(int).tolist()
print(json.dumps(preds))
三元异或
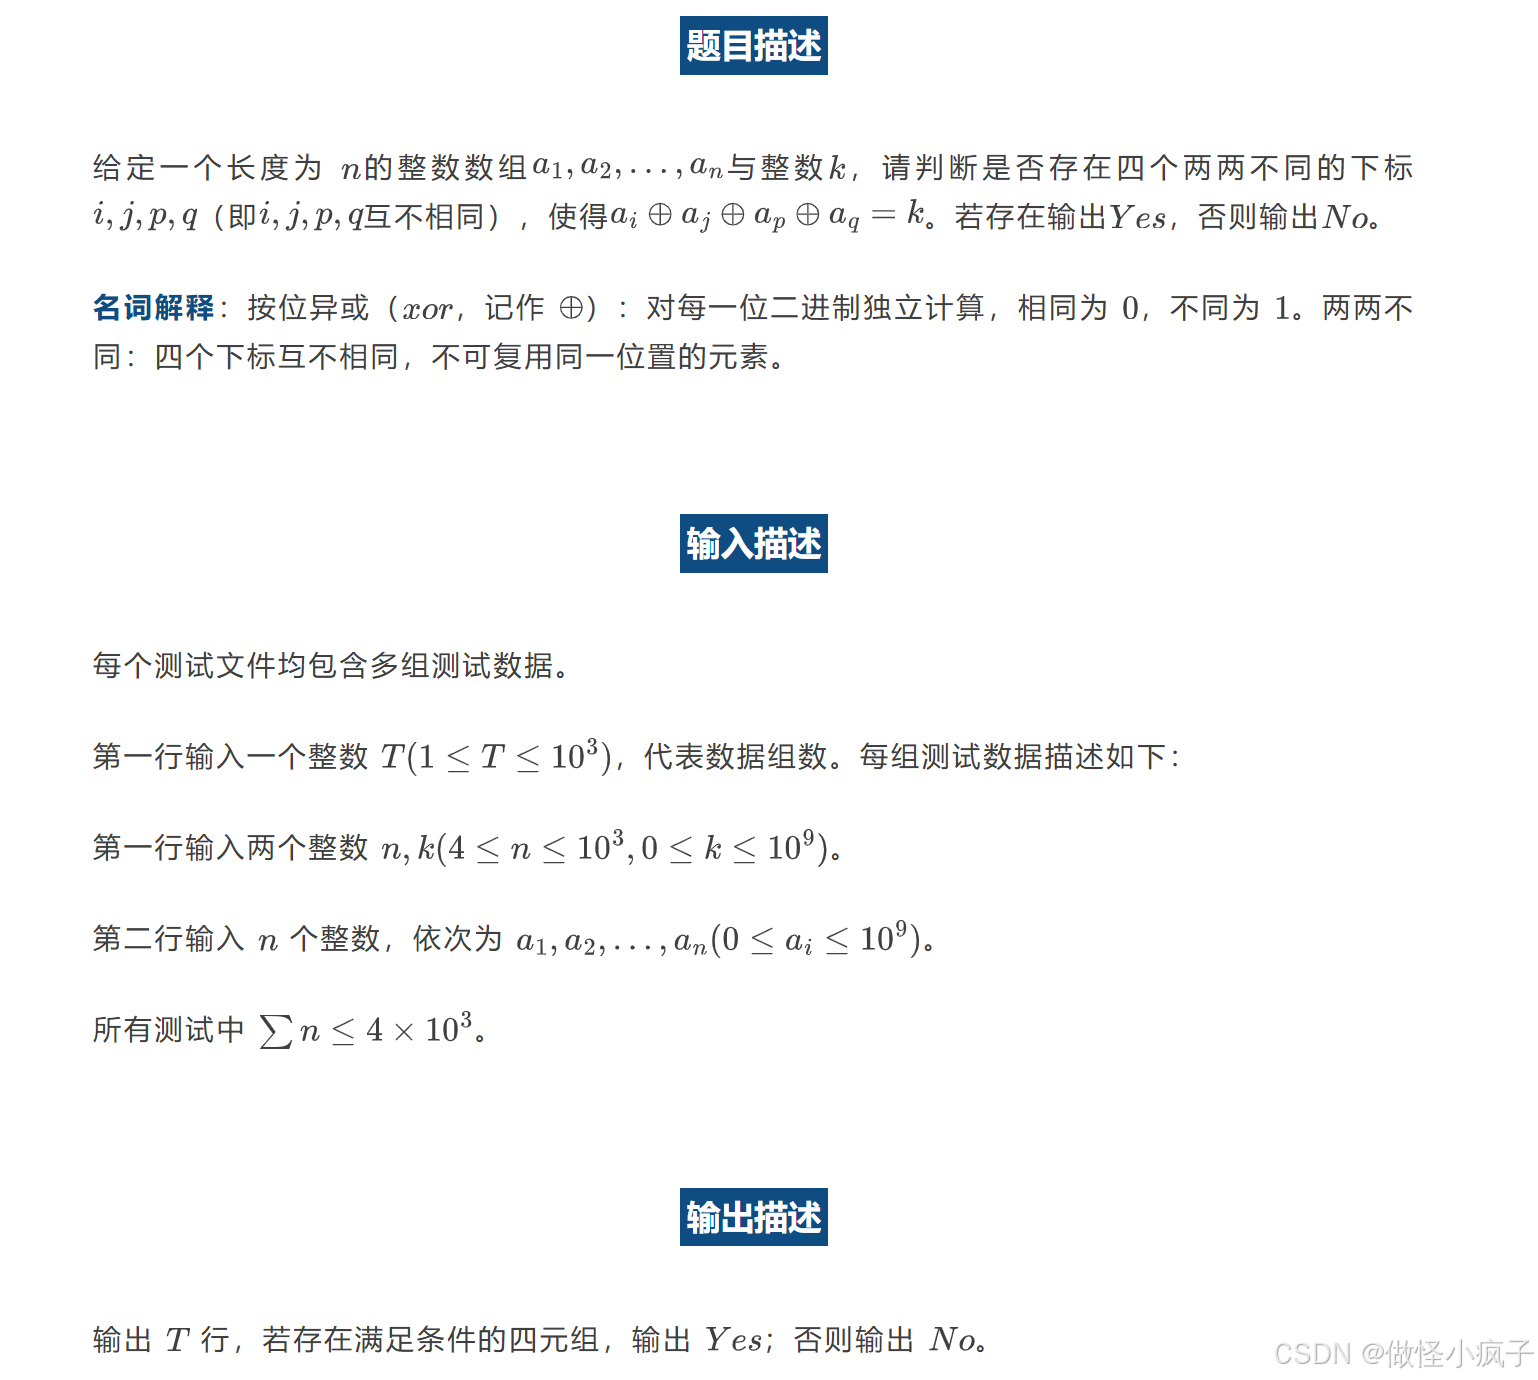
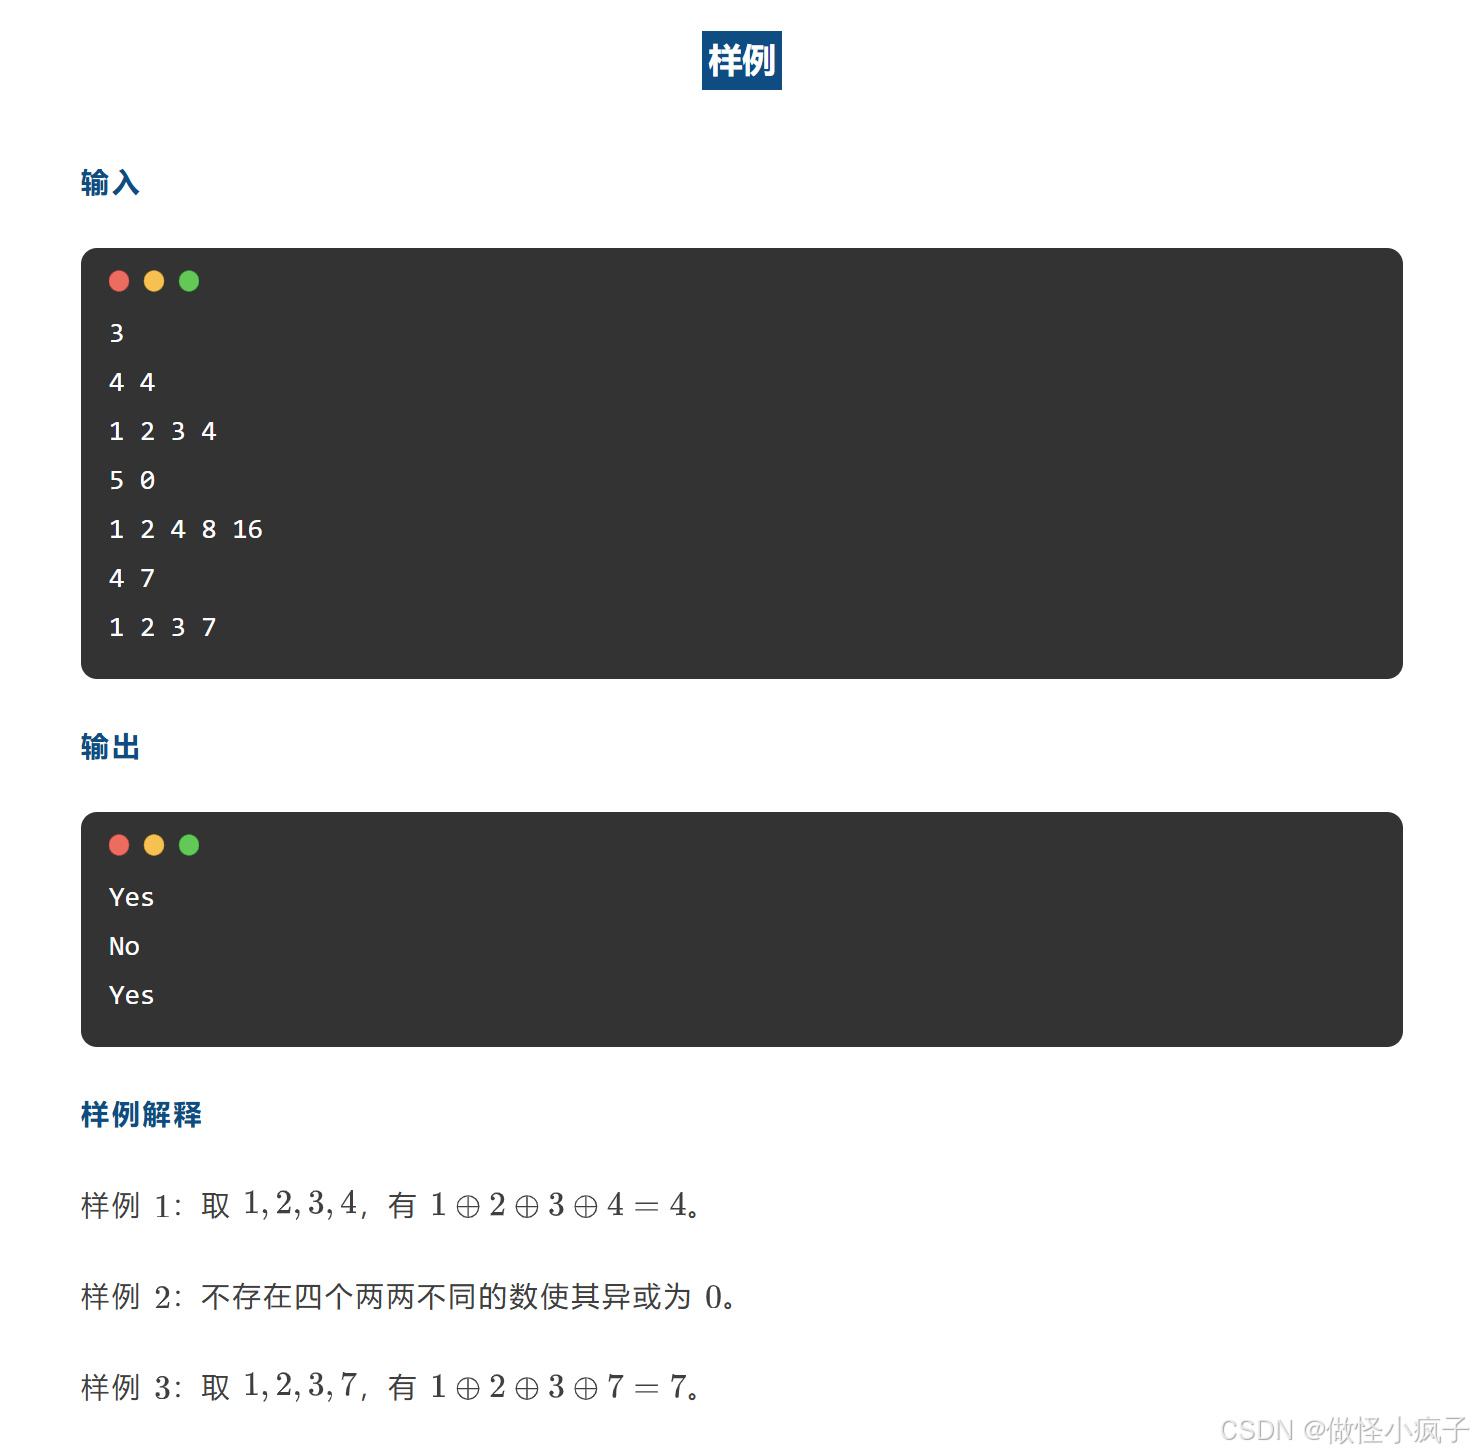
考的是 异或的基本性质:a⊕b=c⟹a=b⊕c,b=a⊕c
python
def solve():
    n, k = map(int, input().split())
    nums = list(map(int, input().split()))
    # a_i ^ a_j ^ a_p ^ a_q = k => a_i ^ a_j = k ^ (a_p ^ a_q)
    mp = {} # key为 a_i ^ a_j的值, value是数组,存放 下标元组(i, j)
    for i in range(n):
        for j in range(i + 1, n):
            v = nums[i] ^ nums[j]
            if v not in mp:
                mp[v] = []
            mp[v].append((i, j))
    for i in range(n):
        for j in range(i + 1, n):
            target = nums[i] ^ nums[j] ^ k
            if target not in mp:
                continue
            for a, b in mp[target]:
                if i != a and i != b and j != a and j != b:
                    print("Yes")
                    return
    print("No")

T = int(input())
for _ in range(T):
    solve()