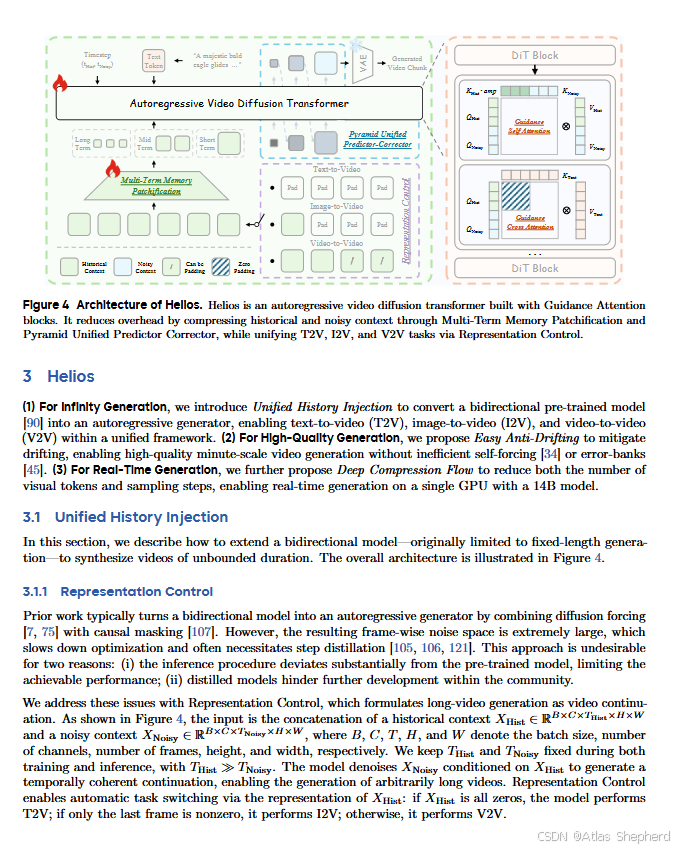
Helios是由北京大学团队开发的14B参数实时长视频生成模型,具有突破性的性能表现。该模型可在单卡H100 GPU上实现19.5 FPS的生成速度,仅需约6GB显存即可运行,并能生成分钟级高质量视频。Helios的创新之处在于无需传统防漂移策略和标准加速技术即可实现实时推理,通过三阶段训练流程(Base-Mid-Distilled)逐步优化模型效率。提供多种部署方式,支持低显存模式和多GPU并行推理,并兼容Diffusers框架。其核心技术包括统一历史注入、简易防漂移和金字塔预测校正等创新方法,使模型在保持高质量输出的同时大幅提升生成效率。
一、Helios概述
Helios 是由北京大学 YuanGroup 团队开发的实时长视频生成模型,是一个突破性的14B参数视频生成模型。它的核心亮点是:
"14B 实时长视频生成模型可以比 1.3B 模型更便宜、更快,同时保持更强的生成能力"
核心性能指标
| 指标 | 数值 |
|---|---|
| 生成速度 | 单卡 H100 GPU 上 19.5 FPS |
| 显存占用 | 使用 Group Offloading 后仅需 ~6GB VRAM |
| 视频长度 | 可生成分钟级高质量视频 |
| 参数量 | 14B |
Helios突破点
- 无需传统防漂移策略(如 self-forcing、error-banks、keyframe sampling 等)即可生成长视频
- 无需标准加速技术(如 KV-cache、causal masking、sparse attention 等)即可实现实时推理
- 优化训练和推理吞吐量,80GB 显存可容纳 4 个 14B 模型
二、部署安装
部署Helios的环境准备
bash
# 0. 克隆仓库
git clone --depth=1 https://github.com/PKU-YuanGroup/Helios.git
cd Helios

# 1. 创建 conda 环境
conda create -n helios python=3.11.2
conda activate helios

# 2. 安装 PyTorch(根据CUDA版本选择)
# CUDA 12.6
pip install torch==2.10.0 torchvision==0.25.0 torchaudio==2.10.0 --index-url https://download.pytorch.org/whl/cu126

# 3. 安装依赖
bash install.sh
Helios模型
| 模型版本 | 特点 | 适用场景 |
|---|---|---|
| Helios-Base | 最佳质量,v-prediction,标准CFG | 追求高质量输出 |
| Helios-Mid | 中间检查点,CFG-Zero* | 过渡版本 |
| Helios-Distilled | 最佳效率,x0-prediction,仅需3步采样 | 追求速度 |
使用 huggingface-cli 下载:
bash
pip install "huggingface_hub[cli]"
huggingface-cli download BestWishYSH/Helios-Base --local-dir BestWishYSH/Helios-Base
使用 modelscope 下载(国内用户推荐):
bash
pip install modelscope
modelscope download BestWishYSH/Helios-Base --local_dir BestWishYSH/Helios-Base
三、使用方法
基础推理
Helios 采用自回归方式 ,每块生成 33 帧。num_frames 应设为 33 的倍数。
bash
cd scripts/inference

# 运行不同模型的推理脚本
bash helios-base_t2v.sh      # 文生视频
bash helios-base_i2v.sh      # 图生视频
bash helios-base_v2v.sh      # 视频生视频
低显存模式(~6GB VRAM)
bash
CUDA_VISIBLE_DEVICES=0 python infer_helios.py \
    --base_model_path "BestWishYsh/Helios-Distilled" \
    --prompt "A vibrant tropical fish swimming..." \
    --num_frames 240 \
    --enable_low_vram_mode \
    --group_offloading_type "leaf_level"
多GPU并行推理
bash
CUDA_VISIBLE_DEVICES=0,1,2,3 torchrun --nproc_per_node 4 infer_helios.py \
    --enable_parallelism \
    --cp_backend "ulysses" \
    --base_model_path "BestWishYsh/Helios-Base" \
--num_frames 99支持的后端:ring、ulysses、unified、ulysses_anything
使用 Diffusers管道
python
import torch
from diffusers import AutoModel, HeliosPyramidPipeline
from diffusers.utils import export_to_video

vae = AutoModel.from_pretrained("BestWishYsh/Helios-Distilled", subfolder="vae", torch_dtype=torch.float32)

pipeline = HeliosPyramidPipeline.from_pretrained(
    "BestWishYsh/Helios-Distilled",
    vae=vae,
    torch_dtype=torch.bfloat16
)
pipeline.to("cuda")

output = pipeline(
    prompt="A vibrant tropical fish swimming...",
    negative_prompt="Bright tones, overexposed, static...",
    num_frames=240,
    pyramid_num_inference_steps_list=[2, 2, 2],
    guidance_scale=1.0,
    is_amplify_first_chunk=True,
).frames[0]

export_to_video(output, "output.mp4", fps=24)
帧数与视频时长对照
| num_frames | 调整后帧数 | 24 FPS | 16 FPS |
|---|---|---|---|
| 1449 | 1452 (33×44) | ~60秒 | ~90秒 |
| 720 | 726 (33×22) | ~30秒 | ~45秒 |
| 240 | 264 (33×8) | ~11秒 | ~16秒 |
| 129 | 132 (33×4) | ~5.5秒 | ~8秒 |
| 81 | 99 (33×3) | ~4秒 | ~6秒 |
四、实现逻辑
Helios逻辑背景
传统长视频生成面临两大难题:
- 漂移问题:生成长视频时,画面容易逐渐失真、不一致
- 速度问题:高质量视频生成通常很慢,无法实时
现有方案通常用复杂的技术(如 KV-cache、特殊注意力机制)来加速,但 Helios 证明了不需要这些也能实现实时生成。
核心技术原理(三阶段训练流程)
第一阶段:Base(基础适配)
- 目标:将双向预训练模型转换为自回归生成器
- 关键技术 :
Unified History Injection(统一历史注入):让模型记住之前生成的内容Easy Anti-Drifting(简易防漂移):轻量级的稳定性保证Multi-Term Memory Patchification(多术语记忆分块):高效管理长序列记忆
第二阶段:Mid(令牌压缩)
- 目标:减少计算量
- 关键技术 :
Pyramid Unified Predictor Corrector(金字塔统一预测校正器)- 激进地减少噪声令牌数量,降低整体计算负担
第三阶段:Distilled(蒸馏加速)
- 目标:极致加速
- 关键技术 :
Adversarial Hierarchical Distillation(对抗层次蒸馏)- 将采样步数从 50 步减少到 3 步
- 消除对分类器自由引导(CFG)的依赖
Helios的优势
可以把 Helios 想象成一个视频画家:
-
传统方法:画家每画一帧都要回头看前面所有帧,还要用各种辅助工具(缓存、特殊技巧)来保持画面一致,很慢
-
Helios 方法:
- 画家有一个智能记忆本(统一历史注入),只记录关键信息
- 画家学会了快速草图→精修的工作流(金字塔预测校正)
- 经过特训后,画家可以3笔完成一幅画(蒸馏到3步采样)
- 不需要额外辅助工具,靠自身能力就能保持画面一致
Helios的创新点
| 创新点 | 说明 |
|---|---|
| 无需防漂移策略 | 不依赖 self-forcing、keyframe sampling 等传统方法 |
| 无需加速技术 | 不依赖 KV-cache、稀疏注意力等,原生实时 |
| 三阶段渐进训练 | Base→Mid→Distilled,逐步优化效率 |
| 多平台支持 | 支持 GPU、Ascend NPU、Diffusers、vLLM、SGLang |
| 低显存运行 | Group Offloading 技术使 6GB 显存即可运行 |