目录
[一 理解硬件](#一 理解硬件)
[1 磁盘,服务器,机柜,机房](#1 磁盘,服务器,机柜,机房)
[2 磁盘物理结构](#2 磁盘物理结构)
[3 磁盘的存储结构](#3 磁盘的存储结构)
[CHS 寻址法](#CHS 寻址法)
[4 磁盘的逻辑结构](#4 磁盘的逻辑结构)
[(2) 真实过程](#(2) 真实过程)
[5 CHS&&LBA地址](#5 CHS&&LBA地址)
[CHS 转 LBA:](#CHS 转 LBA:)
[LBA 转 CHS:](#LBA 转 CHS:)
[二 引入文件系统](#二 引入文件系统)
[1 引入"块"的概念](#1 引入“块”的概念)
[2 引入"分区"概念](#2 引入”分区“概念)
[3 引入"inode"概念](#3 引入“inode”概念)
[三 EXT*文件系统](#三 EXT*文件系统)
[1 宏观认识](#1 宏观认识)
[2 Block Group](#2 Block Group)
[3 块组内部构成](#3 块组内部构成)
[(1)超级块(Super Block)](#(1)超级块(Super Block))
[(3)位块图(Block Bitmap)](#(3)位块图(Block Bitmap))
[(4)inode位图(inode Bitmap)](#(4)inode位图(inode Bitmap))
[(5)节点表(inode Table)](#(5)节点表(inode Table))
[(6)Data Block](#(6)Data Block)
[4 几个问题](#4 几个问题)
一 理解硬件
1 磁盘,服务器,机柜,机房
机械磁盘是计算机中唯⼀的⼀个机械设备
• 磁盘---外设
• 慢
• 容量⼤,价格便宜
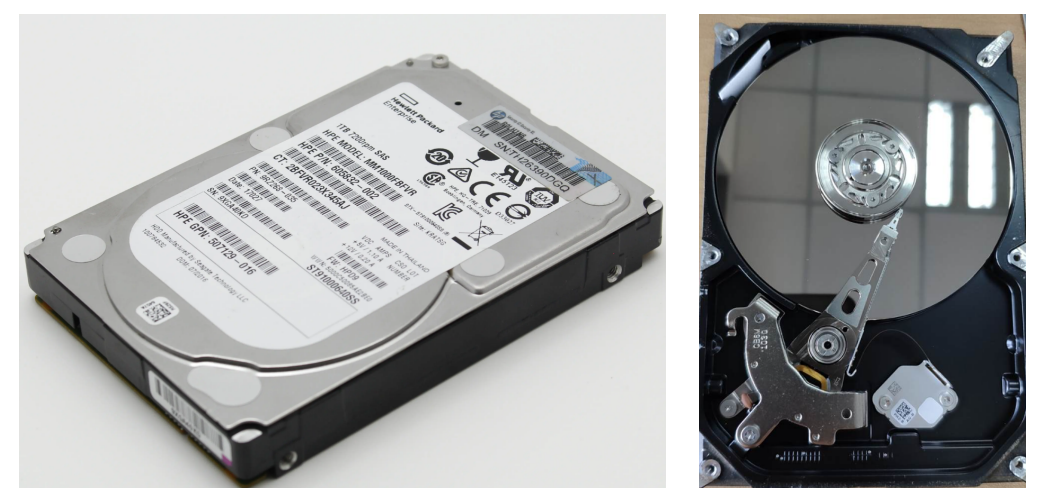
2 磁盘物理结构
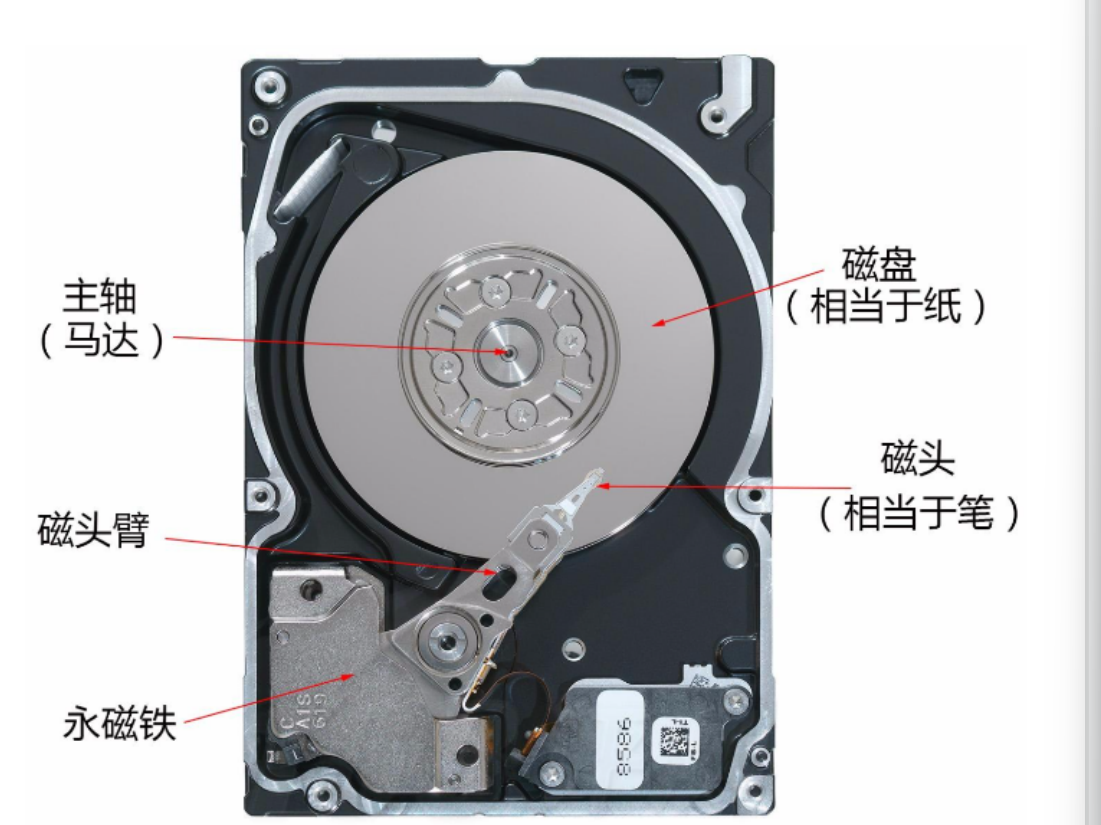
SSD是固态硬盘
对于硬盘而言,离CPU越远,造价越低。中小企业是没有能力自建机房的,只能靠云服务商
微观层面的磁盘:
微观上的磁盘,用磁性南北极的方式区分0,1
不同的点击特性下,0,1的本质是不一样的,所以表示0,1的方式不一样
用光电信号的有无,疏密程度不一样,区分0,1
当数据从一个外设拷贝到另一个外设,拷贝1时,把磁盘的南北极,转化为内存认识的0,1.但是在底层把差异化屏蔽了,所以上层只认为把1搬到了另一个设备
磁盘的使用寿命是3-5年
国家规定,磁盘一旦从互联网公司报废之后,就必须对全面的数据进行擦除,销毁
3 磁盘的存储结构
磁盘的盘片不是只有一片,而是有很多片
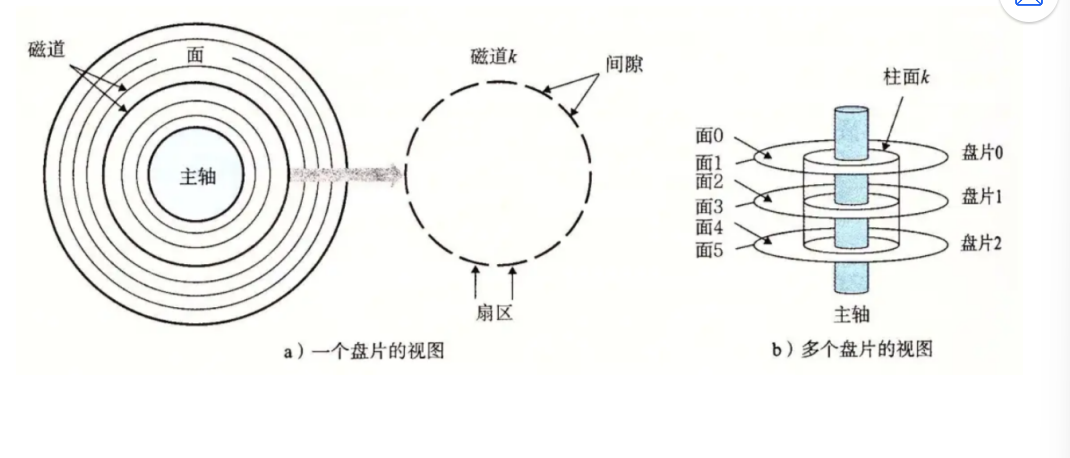
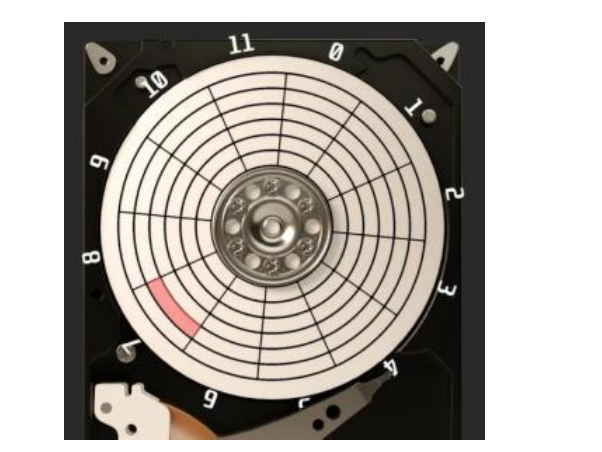
扇区:是磁盘存储数据的基本单位,512字节,块设备
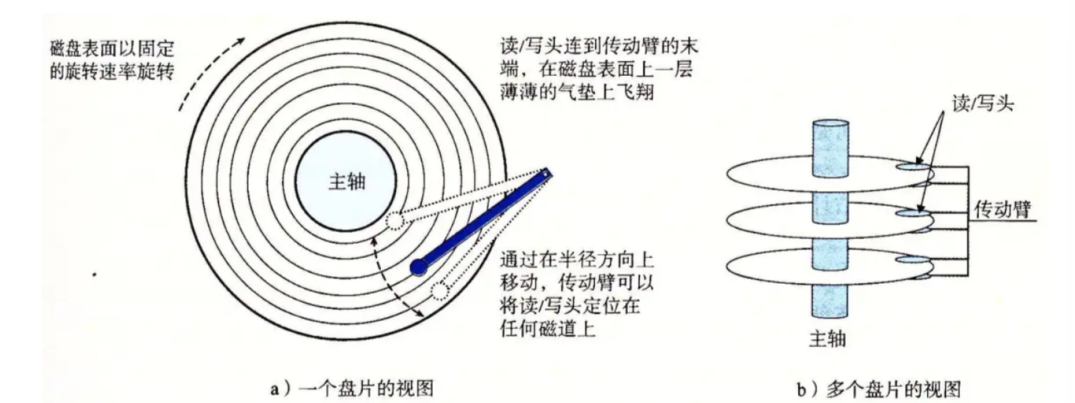
一个磁盘的每一个面上,都有一个磁头
磁头可以访问一个盘片上的任意位置
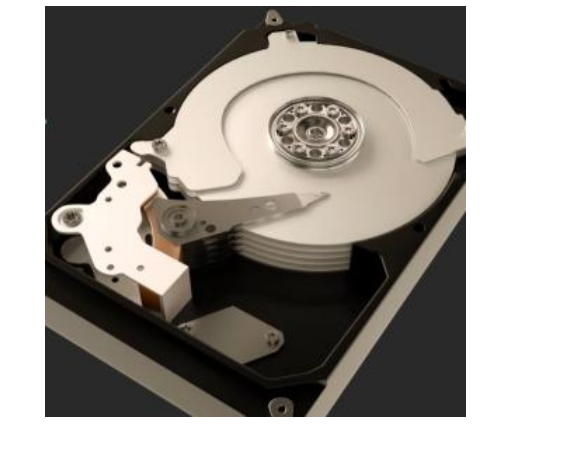
所以,三篇六面的盘片,一定有六个磁头,如下图所示
所有的磁头都会被连接到一个传接臂上,所以这六个磁头共进退
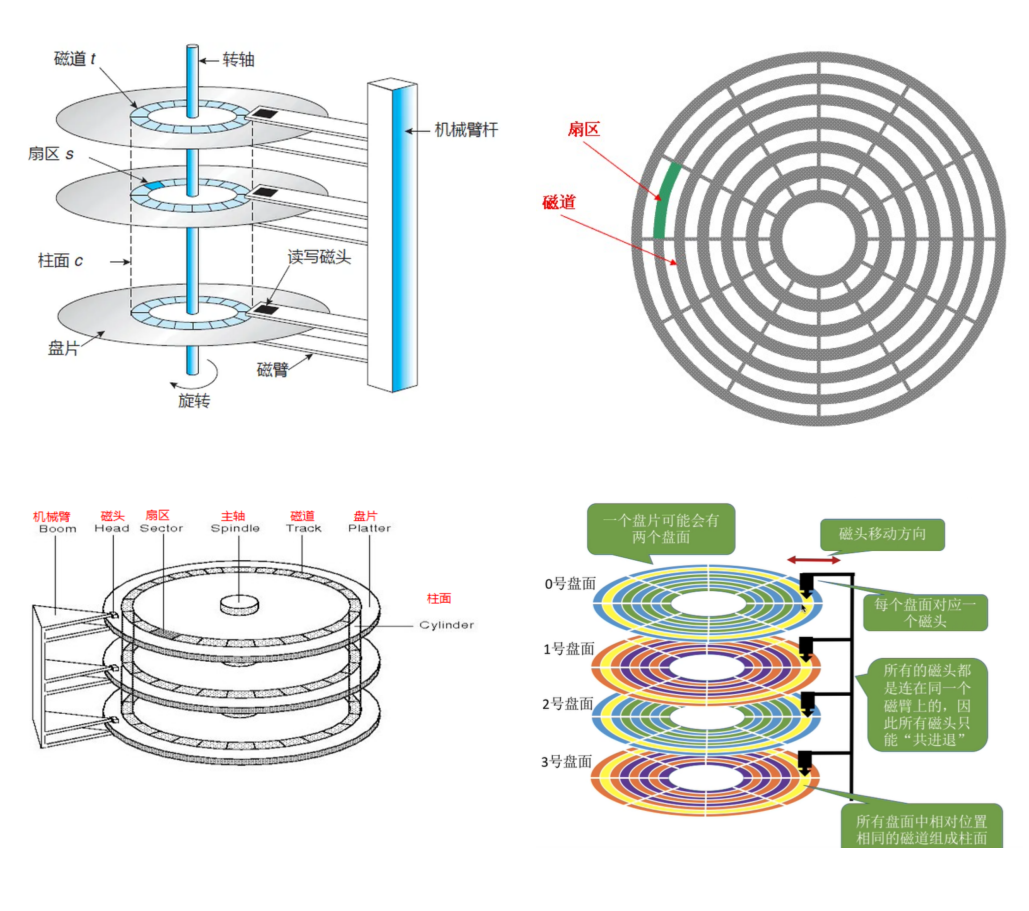
一个面上有无数个同心圆,每个同心圆叫做磁道,磁头移动是一个寻找刺刀的过程
每一个磁道也是连续的:是由一个一个小节构成的,而两个相邻的小节之间是有间隙的,每个小节叫做扇区
扇区是磁盘存储数据的基本单位。每个扇区有512个字节
所以读取磁盘时,一次最少有512个字节
- 磁头:一次操作只使用一个磁头,不确定在哪个磁道、哪个扇区。
- 磁头移动:磁头移动过程就是寻道。
- 编号规则 :
- 磁头、磁道编号从0开始;
- 扇区编号从1开始;
- 一个磁盘的第一个扇区编号为001;
- 三个参数(磁头、磁道、扇区)确定一个扇区。
柱面(Cylinder)
磁头转到同一位置,相同半径的磁道在逻辑上连在一起,称为柱面。
CHS 寻址法
- CHS :代表Cylinder(柱面)、Head(磁头)、Sector(扇区),是早期磁盘的寻址方式。
- 命令:fdisk(sudo提权):在系统中描述系统的物理盘,把物理盘的信息返回回来
- 磁盘容量=磁头数×磁道(柱面)数×每道扇区数×每扇区字节数
- 细节:传动臂上的磁头是共进退的
- 存在问题 :
- 系统需要提前获取磁盘的磁头、磁道、扇区数量,否则无法访问;
- 如果磁盘结构改变,直接使用 CHS 不是最优解。
扇区特性
- 从内圈看,内部扇区比外部扇区的物理尺寸小;
- 我们以为内部扇区数据更紧密,外部更稀疏,但是其实每个扇区的容量均为512 字节。
4 磁盘的逻辑结构
(1)理解过程
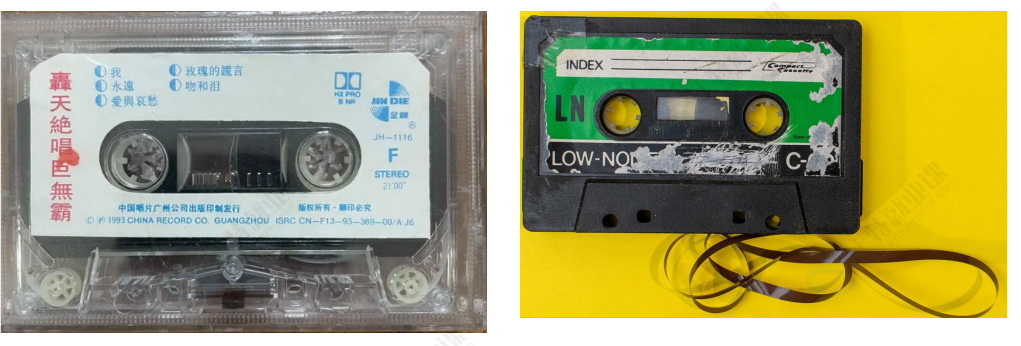
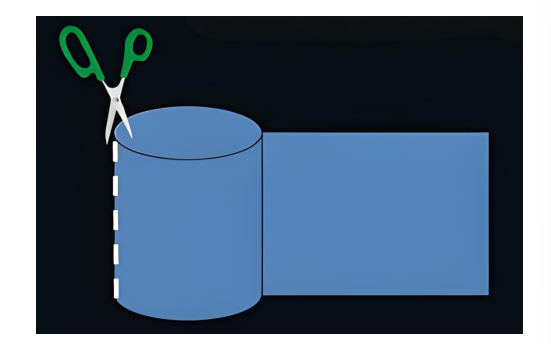
磁带上面可以存储数据,我们可以把磁带"拉直",形成线性结构
那么磁盘本质上虽然是硬质的,但是逻辑上我们可以把磁盘想象成为卷在⼀起的磁带,那么磁盘的逻
辑存储结构我们也可以类似于:
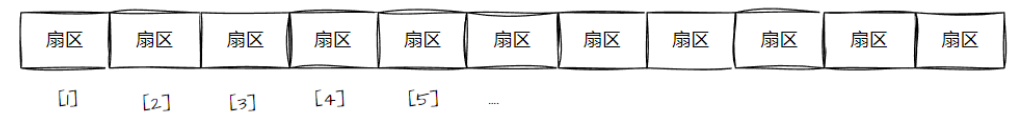
这样每⼀个扇区,就有了⼀个线性地址(其实就是数组下标),这种地址叫做 LBA
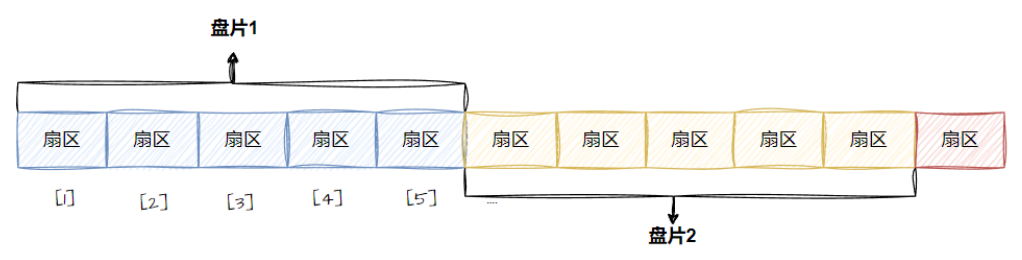
(2) 真实过程
磁盘的盘片是实心的
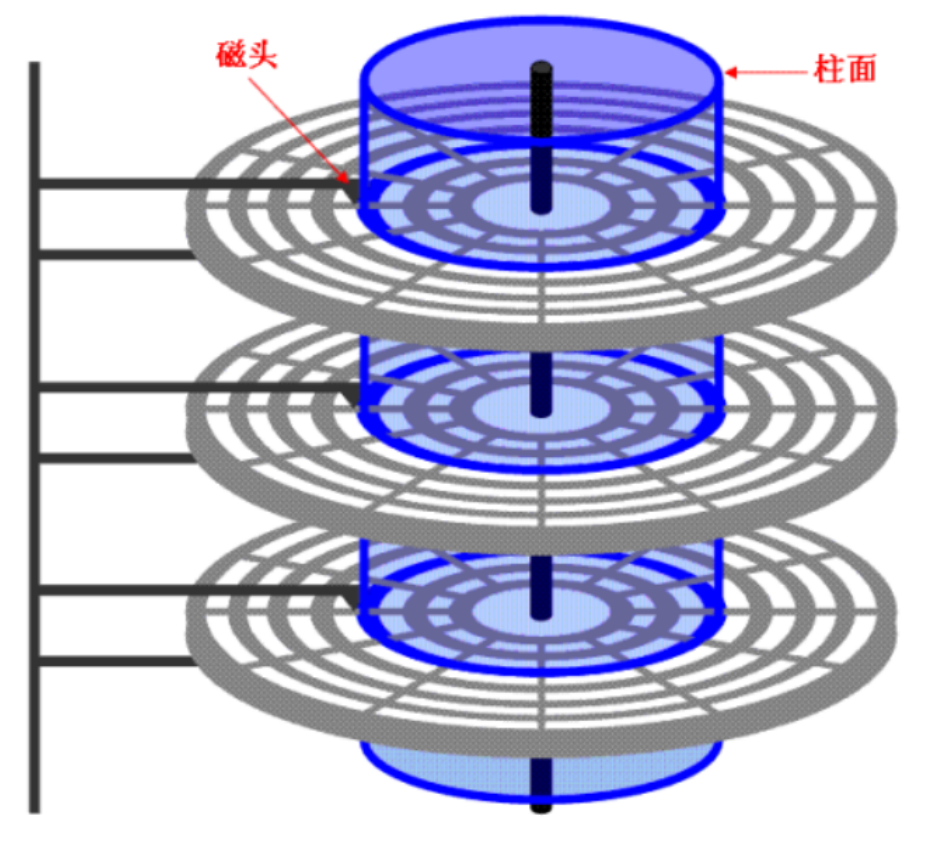
所有的磁头都是共进退的 在访问磁盘时,一定是先定位访问的目标扇区,在哪个柱面,后面在确定在哪个磁头上
所以CHS定址法, C在最前面 因为要先寻找柱面
磁道的真实情况是:
磁道:
某⼀盘面的某⼀个磁道展开:
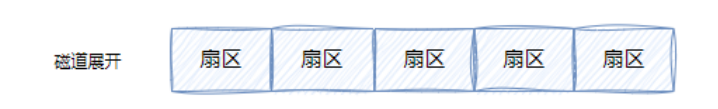
即:⼀维数组
柱面:
整个磁盘所有盘面的同⼀个磁道,即柱面展开:
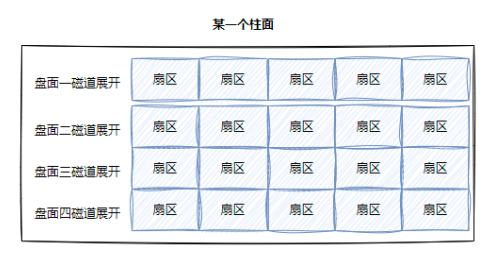
柱面上的每个磁道,扇区个数是⼀样的
这不就是⼆维数组吗
整盘:
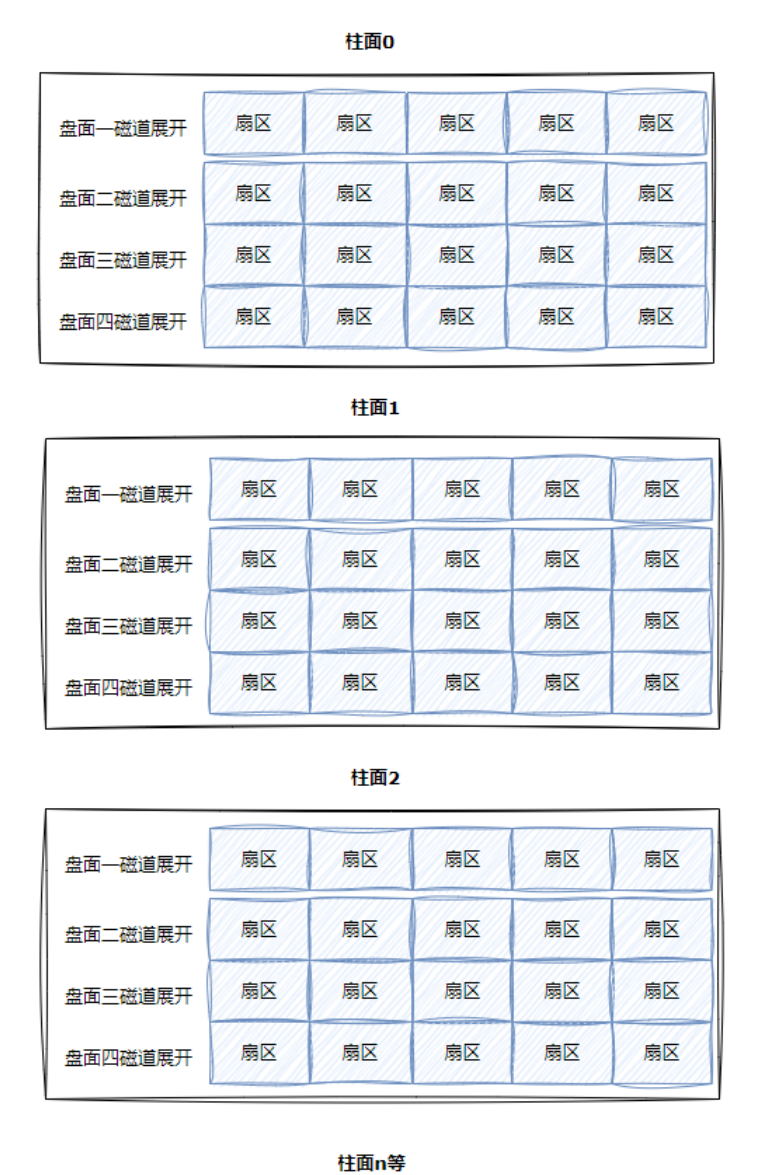
整个磁盘不就是多张二维的扇区数组表(三维数组)
所以,寻址一个扇区:先找到哪一个柱面 (Cylinder),再确定柱面内哪一个磁道(其实就是磁头位置,Head),再确定扇区(Sector),所以就有了 CHS 。
我们之前学过 C/C++ 的数组,在我们看来,其实全部都是一维数组:
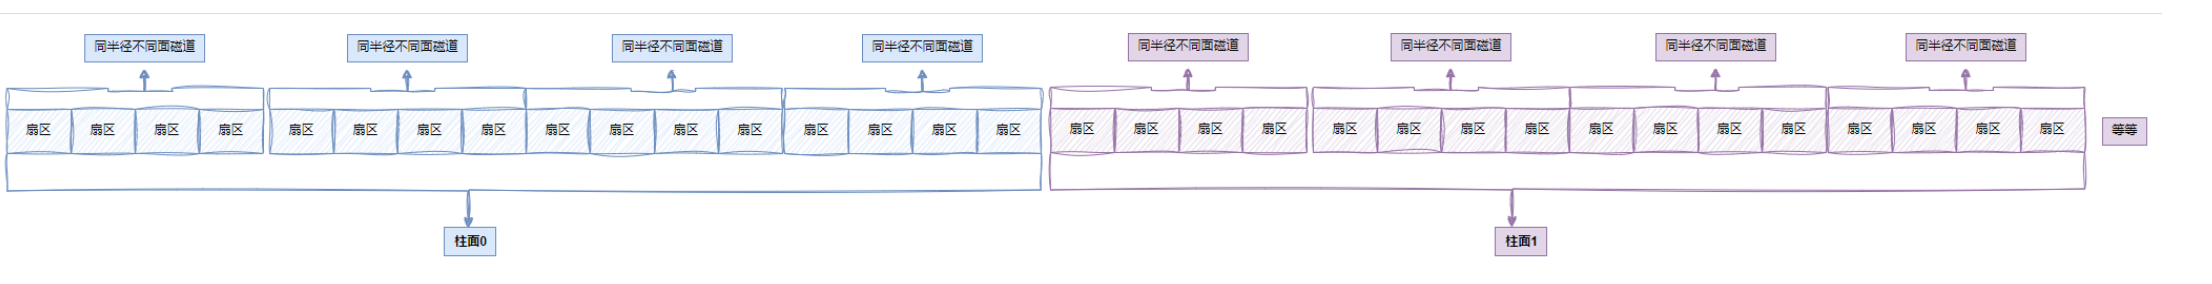
所以,每⼀个扇区都有⼀个下标,我们叫做 LBA(Logical Block Address) 地址,其实就是线性
地址。
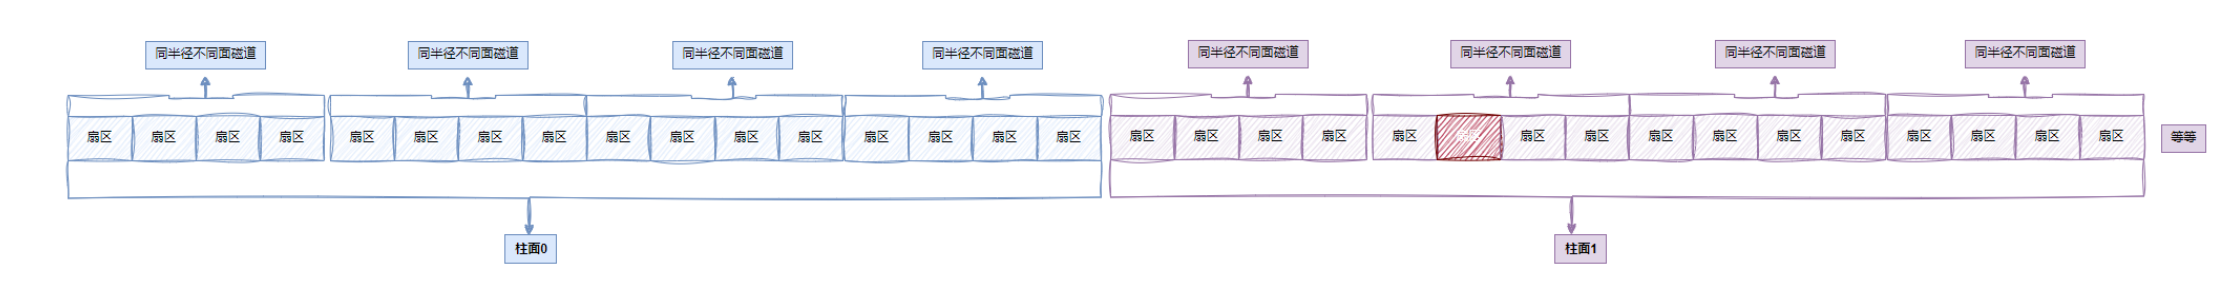
所以我们怎么定位磁盘中任意一个扇区?
三维数组中:sector array\[\]\[\]\[\]
我们先找到第一个下标:确定在哪个柱面,之后就转化为二维数组问题;之后找到在哪个面上,对应磁头;最后确认在这个磁道上,对应哪个扇区
所以CHS就是数组下标!
怎么理解二维数组?三维数组?
二维数组在物理结构上也是线性的 其实二维数组就是两个一维数组
那么相应的,三维数组也是三个二维数组--->也是线性的,所以我们就能把二维数组和三维数组都转化成一维数组
结论:在C/C++中,所有数组在我们心目中,只有一维数组
所以把磁盘想象成一维数组(实际是三维结构)。多个柱面合起来,叫做一个磁盘;一个柱面内包含多个磁道;一个磁道内包含多个扇区
磁盘是以柱面为单位的一维数组
抽象成一维数组,是谁抽象的?整个数组,需要物理定义吗?
是操作系统抽象的;整个数组不需要物理定义,只需获取磁盘的几个参数(例如:总容量,扇面大小,柱面,盘面......)
活得这些参数,操作系统就会动态的获得,计算磁盘内一共会有多少个扇区--->有了类似地址空间的概念
那怎么知道哪个扇区用了,哪个没有用?
LBA地址是操作系统抽象的,磁盘是一个三维数组,访问任何一个盘区必须访问CHS,它需要三个参数 所以任何一个扇区的下标,一定能转化成三种参数
所以LBA和CHS能相互转化
5 CHS&&LBA地址
LBA和CHS地址转化时,本质问题是一维数组下标,转化成三维数组下标
CHS 转 LBA:
- 磁头数 × 每磁道扇区数 = 单个柱面的扇区总数
- LBA = 柱面号 C × 单个柱面的扇区总数 + 磁头号 H × 每磁道扇区数 + 扇区号 S - 1
- 即:LBA = 柱面号 C × (磁头数 × 每磁道扇区数) + 磁头号 H × 每磁道扇区数 + 扇区号 S - 1
- 扇区号通常是从 1 开始的,而在 LBA 中,地址是从 0 开始的
- 柱面和磁道都是从 0 开始编号的
- 总柱面数、磁道个数、扇区总数等信息,在磁盘内部会自动维护,上层系统开机时会获取到这些参数。
LBA 转 CHS:
- 柱面号 C = LBA // (磁头数 × 每磁道扇区数)【即单个柱面的扇区总数】
- 磁头号 H = (LBA % (磁头数 × 每磁道扇区数)) // 每磁道扇区数
- 扇区号 S = (LBA % 每磁道扇区数) + 1
- "//":表示除取整(整除)
因此,对于磁盘使用者而言,无需关注 CHS 地址,只需直接使用 LBA 地址即可,磁盘内部会自行完成地址转换。综上:从逻辑层面来看,磁盘可视为一个元素为扇区的一维数组,数组的下标就是对应扇区的 LBA 地址。操作系统访问磁盘时,只需通过一个数字(LBA 地址)就能精准定位到目标扇区。
二 引入文件系统
1 引入"块"的概念
我们直接访问磁盘会产生问题:(1)操作系统和硬件在数组块上的认知,产生强耦合 (2)磁盘是一个机械设备,一次访问512个字节,如果数据量太小,会导致IO效率降低
一个一个扇区的读,效率太低---->我们引入"块"的概念
其实硬盘是典型的 "块" 设备,操作系统读取硬盘数据时,并不会逐个扇区读取(这种方式效率过低),而是一次性连续读取多个扇区 ------ 也就是一次性读取一个 "块"(block)。
硬盘的每个分区会被划分为一个个的 "块"。一个 "块" 的大小在格式化时确定,且确定后无法更改,最常见的大小是 4KB(即由连续 8 个扇区组成一个 "块 ")。"块" 是文件存取的最小单位
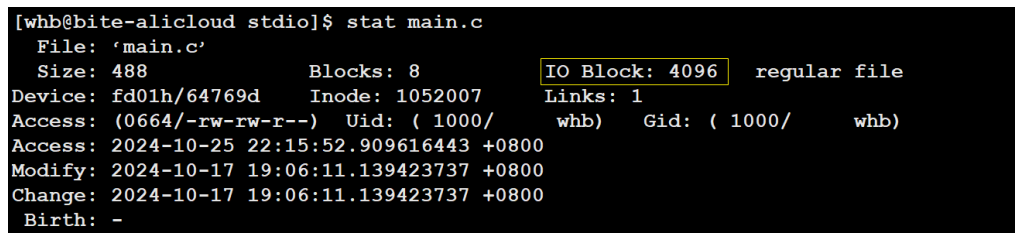
块一般是4KB--->在LBA上必须是连续的8个扇区,那么LBA/8就是块号
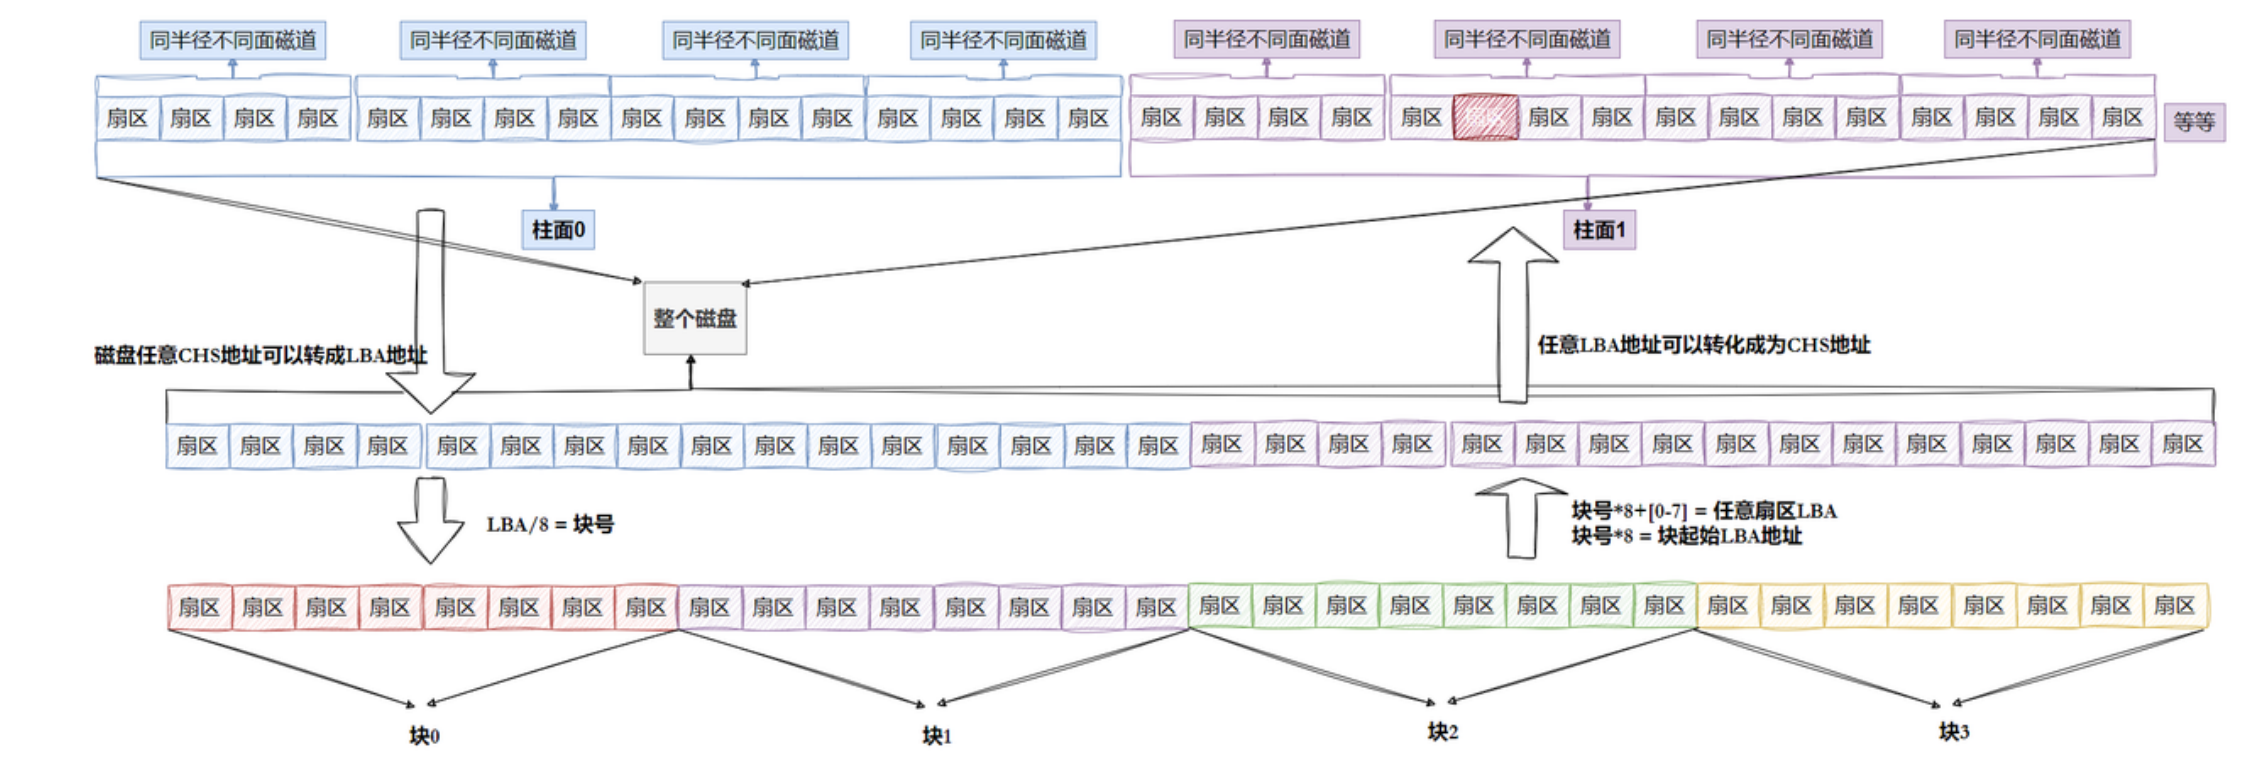
在文件系统层面上,只认块
从块到LBA到CHS,最后到磁盘,此时磁盘就可以读到4KB的地址
操作系统要不要把大量访问磁盘的请求管理起来?
要!先描述,在组织 被保存在一个结构体里面
2 引入"分区"概念
在操作系统里面,不需要把所有的块都定义出来,只需要知道有多少个块
假设磁盘的大小是800GB,那我我们只要能管理好其中的200GB,剩下没有被管理的部分,就可以借鉴这部分已经被管理的方法:crtl+c crtl+v----->这个过程,就是对磁盘分区
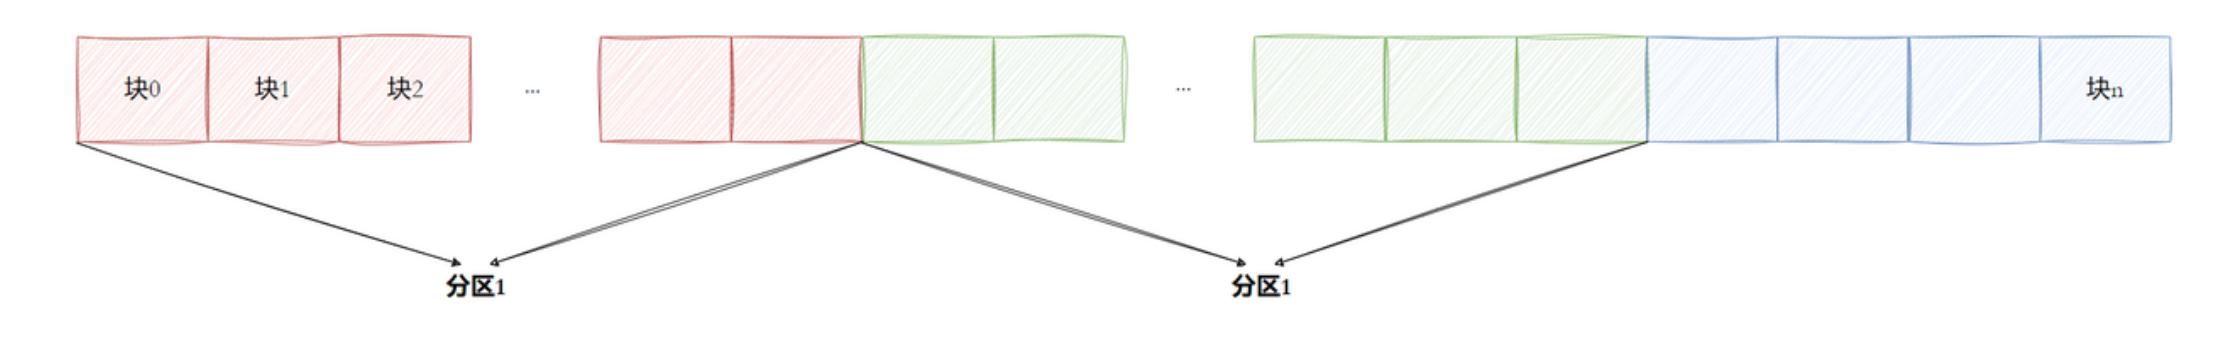
例如:一个笔记本电脑里面原本只有一个盘,我们所看到的C,D,E....盘,其实是经过我们对磁盘进行分区
分区只需记住起始块号和尾块号,我们就能知道该分区有多大
进一步把分区划分成无数个组--->把管理磁盘转化成管理组
像这种把大问题拆分成小问题---->分治思想
相比管理国家,就要简单很多,因为每个地区的管理方法不一样,一个地区的管理方法不能用在另一个地区上
3 引入"inode"概念
要管理磁盘,必须先向磁盘中写入要管理的数据,才能管理
我们以一个组为例:
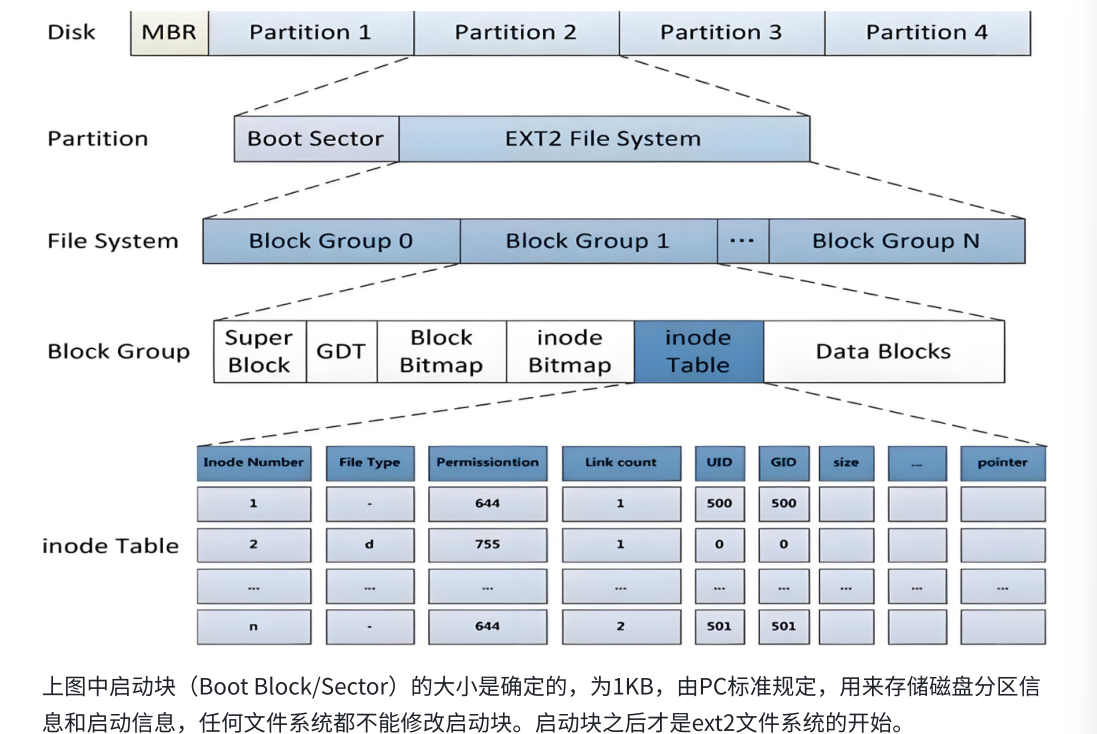
在磁盘中,含有一个叫做MBR的结构:它的作用是定位操作系统,内含分区表
文件系统是以分区为单位的!
我们都知道:文件=文件内容+文件属性,在Linux中,我们所讲的文件系统都是EXT*系列的,EXT*系列的特点是文件的属性和内容是分开存储的
我们来通过上面的图片,了解一下Block Group(一个组)中每部分的简介:
Super Block是描述整个文件系统的管理信息
GDT是组描述符表
Block Bitmap是一个位图结构,包含:比特位的位置--->可以和块号进行映射,比特位的内容----->表明对应的块是否被占用,1表示被占用,0表示没有被占用(用量衡量一个组里面块的使用情况)
inode Bitmap:也叫做inode位图,:用1 个 bit 对应 1 个 inode,通过 bit 的位置与 inode 表(inode table)中的具体 inode 一一映射。bit 值为1表示对应 inode已被占用(有效),bit 值为0表示对应 inode空闲可用(无效)。
inode Table:存放文件属性和当前分组所有inode属性的集合
Data Blocks:相当于磁盘块的集合,每一个块都有唯一标识-->块号(是属于文件系统内唯一的)
不需要记住每个块号是几,只需要在GDT中查到起始块号是几,这个组里有几个块,就知道每个块的地址
怎么知道哪些块被使用了?
因为存在Block Bitmap,就是一组连续的0,1 用0,1的个数,衡量组内中块的使用情况
由0置1,由1置0,是内存操作---->在内存中才能修改,加载到内存,修改完被刷新出去
文件属性是由一个struct inode保存,一个文件一个inode(是一个结构体变量可以直接写到磁盘上)每个人身上都有属性,属性的类别一样(身高,体重.......),但是属性的值都不一样---->文件属性类别相同,属性值不同,那么决定inode每个字段的名称,类别一样,值不一样(对于一个结构体而言,它的大小是固定的)
所以在Linux中用固定大小的inode结构体保存文件属性,一般是128字节
文件名没有在inode中保存---->原因1:文件名是字符串,可大可小,没有办法放到固定大小的inode中
可能在一个inode Table中保存了几万个inode,怎么知道谁是谁?且文件名不保存在inode中
在inode中,会存在一个inode编号----->在整个文件系统中是唯一的
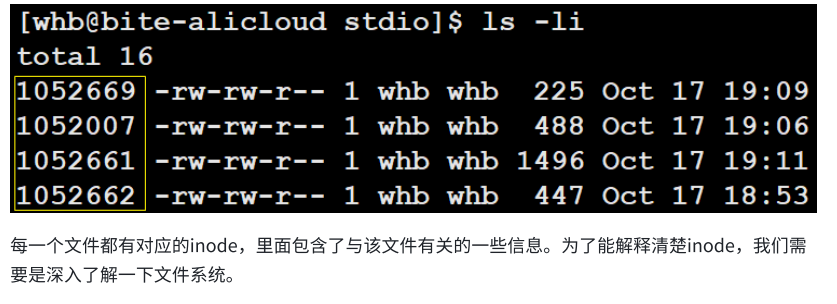
怎么知道哪些inode被占用?
inode Bitmap也是位图,每一个Bit位表示inode是否空闲。:用1 个 bit 对应 1 个 inode,通过 bit 的位置与 inode 表(inode table)中的具体 inode 一一映射。bit 值为1表示对应 inode已被占用(有效),bit 值为0表示对应 inode空闲可用(无效)
新建大小为0字节的文件,占不占磁盘空间?
占!只是不占据数据块,但是占inode Table,至少占128个字节的inode属性
查找文件,是通过inode number,找到文件的属性,但是文件的内容怎么获取?
在inode属性列表,存在一张映射表(32位),其中保存了一个文件对应的快号
三 EXT*文件系统
1 宏观认识
所有的准备工作都已经做完,是时候认识下文件系统了。我们想要在硬盘上存储文件,必须先把硬盘格式化为某种格式的文件系统,才能存储文件。文件系统的目的就是组织和管理硬盘中的文件。在 Linux 系统中,最常见的是 ext2 系列的文件系统。其早期版本为 ext2,后来又发展出 ext3 和 ext4。ext3 和 ext4 虽然对 ext2 进行了增强,但是其核心设计并没有发生变化,我们仍是以较老的 ext2 作为演示对象。
ext2 文件系统将整个分区划分成若干个同样大小的块组 (Block Group),如下图所示。只要能管理一个分区就能管理所有分区,也就能管理所有磁盘文件。
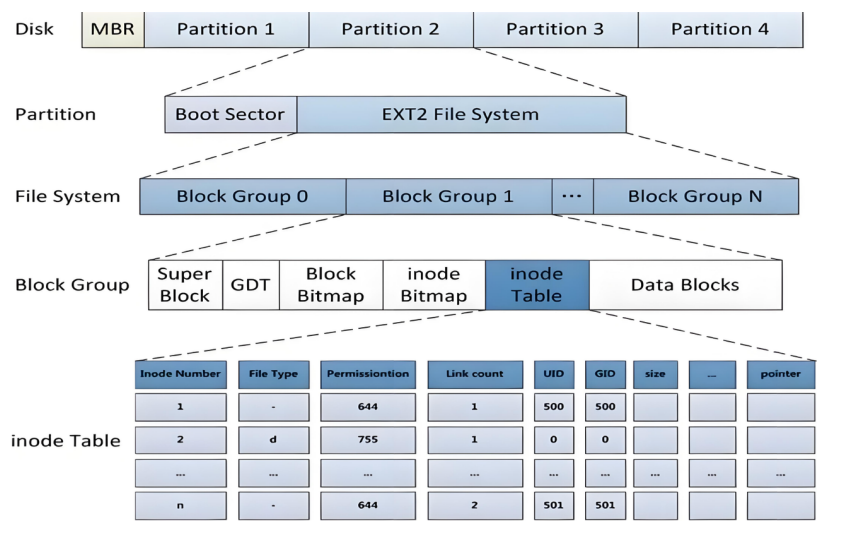
上图中启动块(Boot Block/Sector)的大小是确定的,为1KB,由PC标准规定,用来存储磁盘分区信息和启动信息,任何文件系统都不能修改启动块。启动块之后才是ext2文件系统的开始。
2 Block Group
ext2 文件系统会依据分区大小,将其划分为若干个块组(Block Group),并且每个块组都采用相同的结构组成。
3 块组内部构成
(1)超级块(Super Block)
存放文件系统本身的结构信息,用于描述整个分区的文件系统信息。记录的主要信息包括:block 和 inode 的总量、未使用的 block 和 inode 数量、单个 block 和 inode 的大小、最近一次挂载时间、最近一次写入数据的时间、最近一次检验磁盘的时间等其他文件系统相关信息。Super Block 的信息一旦被破坏,整个文件系统结构也就随之被破坏。
在EXT文件系列,inode个数和Block的个数都是固定且一样的
如果知道一个文件的Inode号,怎么在分区里找到文件?包括内容和属性
因为每个分组的Inode号是固定的,所以可以直接通过除,模运算,确定在哪个组里
(2)GDT
块组描述符表用于描述块组的属性信息,整个分区被划分为多少个块组,就对应有多少个块组描述符。每个块组描述符存储一个块组的描述信息,例如该块组中 inode Table 的起始位置、Data Blocks 的起始位置、空闲 inode 和数据块的剩余数量等。块组描述符在每个块组的开头都保存有一份副本。
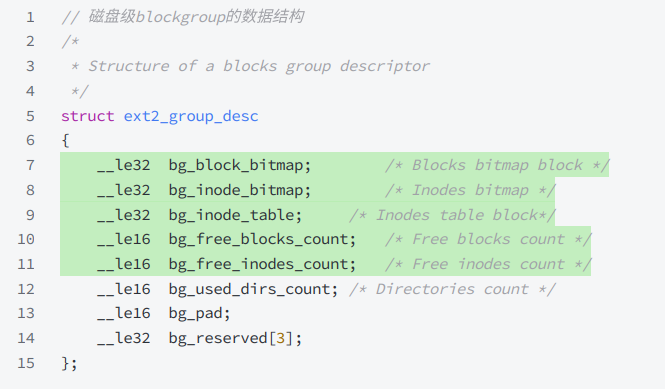
(3)位块图(Block Bitmap)
Block Bitmap 中记录着 Data Block 中哪些数据块已被占用,哪些数据块未被占用。
(4)inode位图(inode Bitmap)
每个BIt表示一个inode是否空闲可用
(5)节点表(inode Table)
-
存放文件属性,如文件大小、所有者、最近修改时间等
-
当前分组所有 Inode 属性的集合
-
inode 编号以分区为单位整体划分,不可跨分区
(6)Data Block
数据区:用于存放文件内容,由一个个 Block 组成。根据文件类型不同,分为以下几种情况:
-
对于普通文件,文件数据直接存储在数据块中。
-
对于目录,该目录下的所有文件名和目录名存储在对应目录的数据块中;除文件名外,`ls -l` 显示的其他信息则保存在对应文件的 inode 中。
-
Block 编号以分区为单位进行划分,不可跨分区使用。
4 几个问题
知道一个文件的inode,怎么理解增删查改?
删除操作:找到inode号,找到对应的inode BItmap对应的位置,后把位图中表示该节点的比特位改成0,后找到Inode的映射表,找到文件对应数据块的块号信息,找到Block Bitmap文件所占据的所有数据由1改为0----->两个位图由1变0
不用清空inode Table和Data Blocks
恢复文件:也就是把位图由0置1
查找:要用到特殊工具
如果一个小时前删除了文件,但是现在要恢复,已经忘记了inode号怎么办?在操作系统的工作日志中,会记录你删除了哪个文件以及对应的inode号
误删文件,做好的做法是什么?什么都不做
磁盘内部会包含分区表,文件系统,Super Block(sb)、块组描述符表(gdt)、块位图、inode 位图、inode 表、数据块 等结构。他们统一称为磁盘的管理文件
为什么文件名不在inode中?文件名在哪?
文件名存储在目录文件的目录项(dirent)中:
目录本身是一个特殊文件,它的 inode 指向的数据块中,存储着若干个目录项(dirent),每个目录项包含两部分:文件名和对应的inode 号。
当我们通过路径(如/home/user/file.txt)访问文件时,系统会从根目录开始,依次解析每个目录的目录项,找到对应 inode 号,最终定位到目标文件的 inode,再通过 inode 访问文件内容。
理解什么是目录:
(1)文件出门访问文件只能通过inode number
(2)文件目录是文件--->目录由属性+内容构成
其中:属性和普通文件的属性类别一样,但是属性的内容不一样 ,内容保存的是文件名和inode number的映射关系
在磁盘角度:用不用区分保存文件和目录?不用,以同一种方式保存
所以保存文件,操作系统必须先打开所处目录的文件;必须有路径,有路径才能去找文件