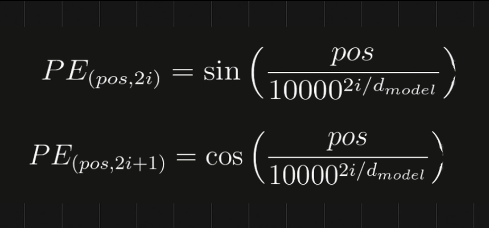transformer学习笔记2

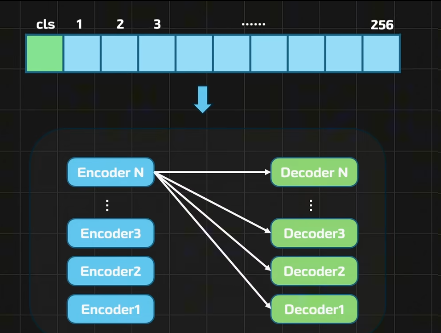
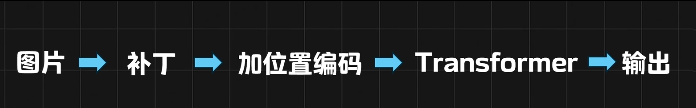
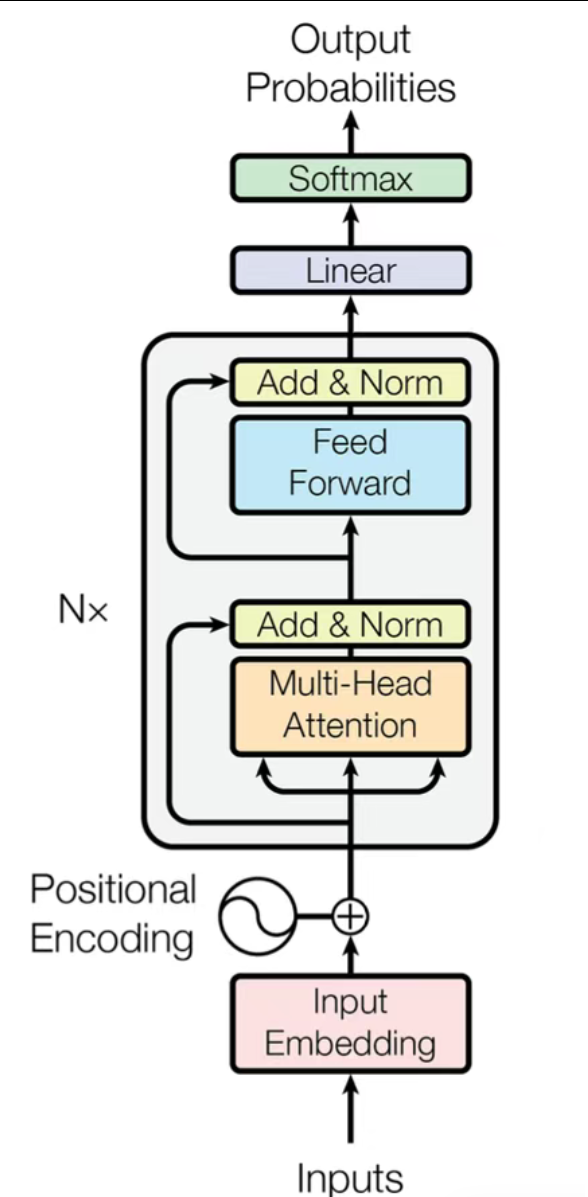
标准的Encoder Only类型的Transformer架构的示意图
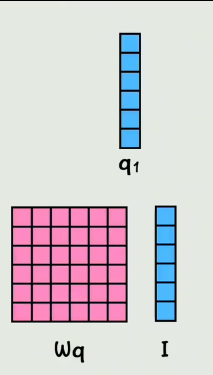
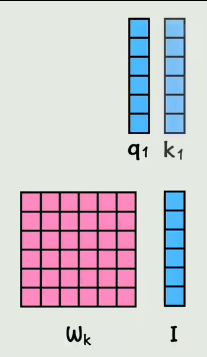
关于QKV矩阵
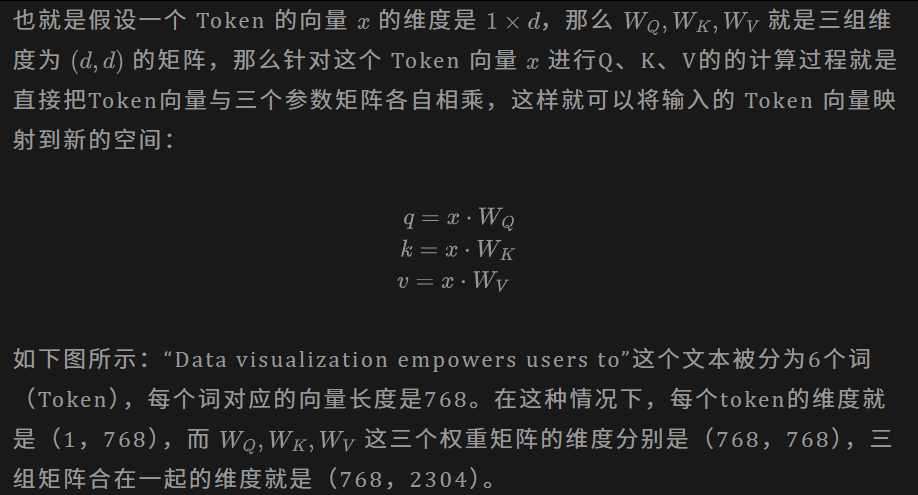
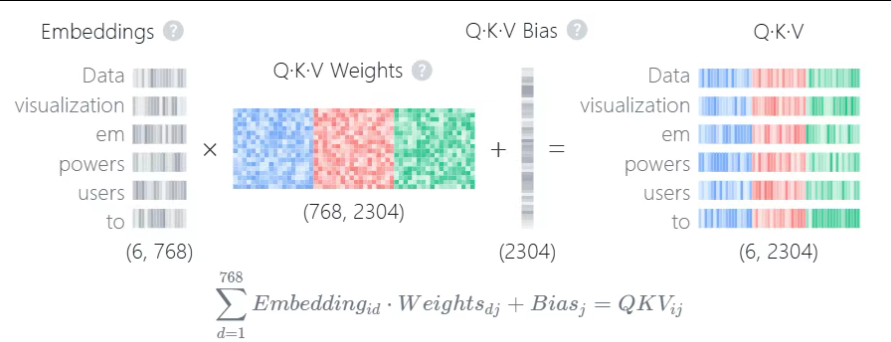
参考B站视频1(VIT)

https://www.bilibili.com/video/BV1gnWdzSEzY/?spm_id_from=333.337.search-card.all.click&vd_source=b73dd02a7fb8feec65576de4e3abaf18

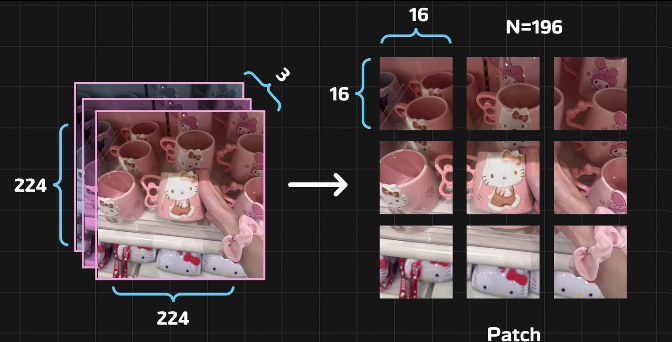
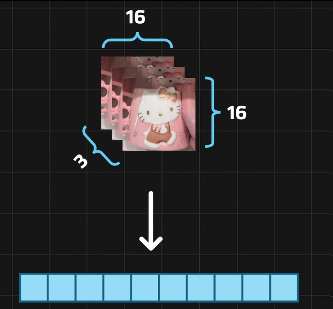
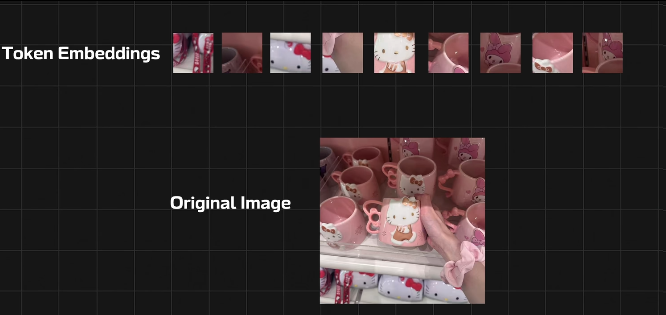
patchs切块

196块patchs


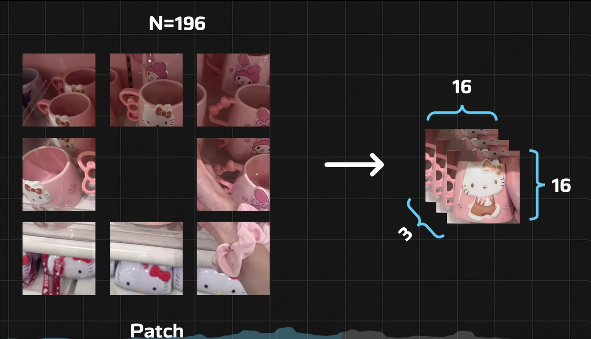
Flatten展平

196个768维的向量
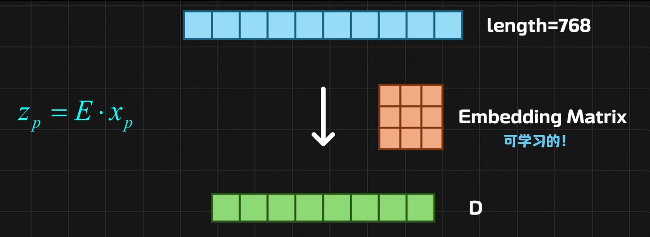
Linear Projection线性投射

196个N维的向量
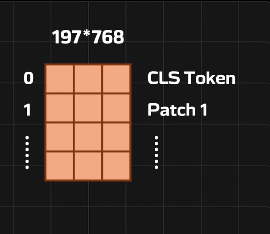
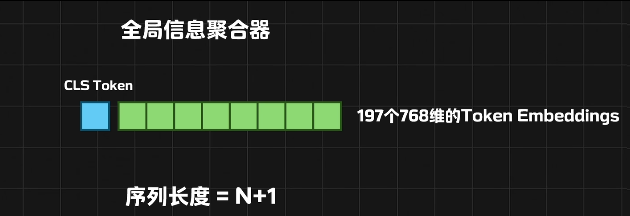
CLS Token

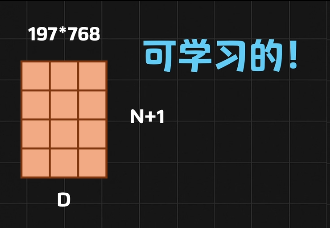
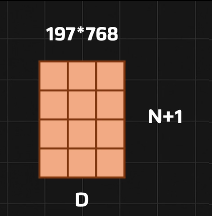
197个长度D的向量

序列长度就是分了多少块patch
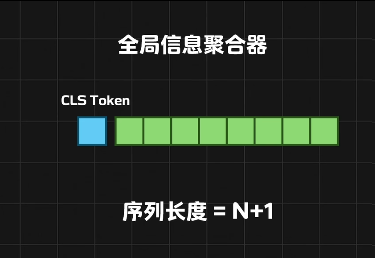
假设这个D还是768,最终得到197个768维的被编码的Token
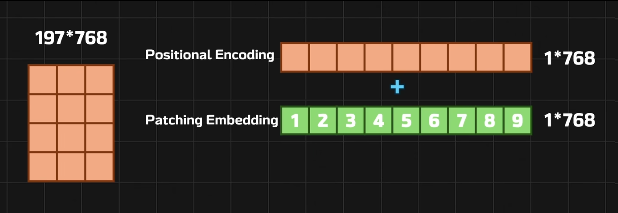
Positional Encoding加入位置编码
位置编码向量


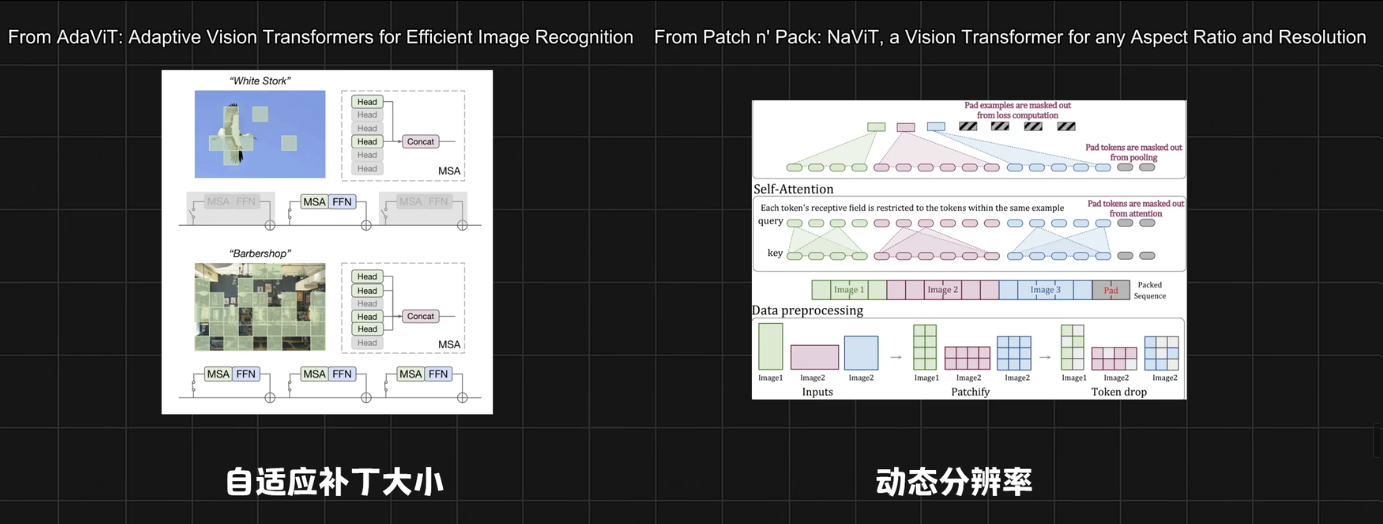
VIT改进
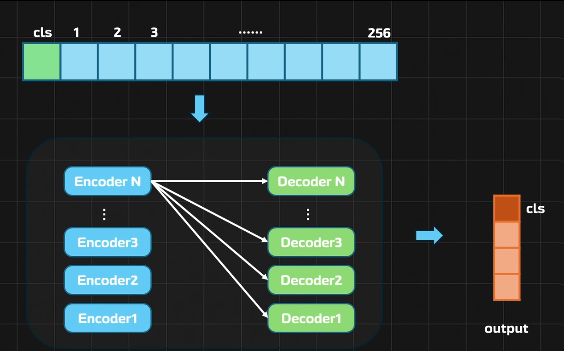
理解输入输出
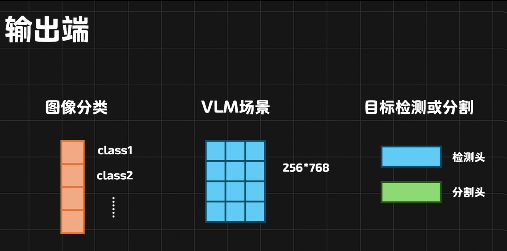
输出取决于任务要求
参考B站视频2(VIT)
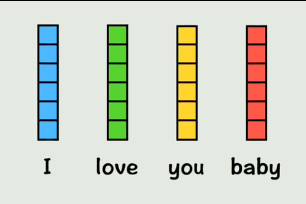
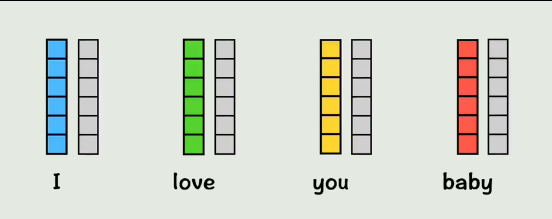
https://www.bilibili.com/video/BV1fGeAz6Eie?spm_id_from=333.788.videopod.episodes&vd_source=b73dd02a7fb8feec65576de4e3abaf18&p=6


灰色代表位置编码,直接加进去得到新的


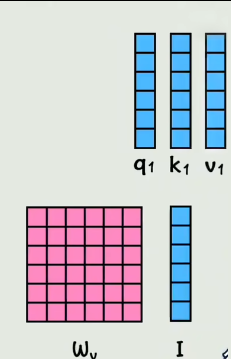
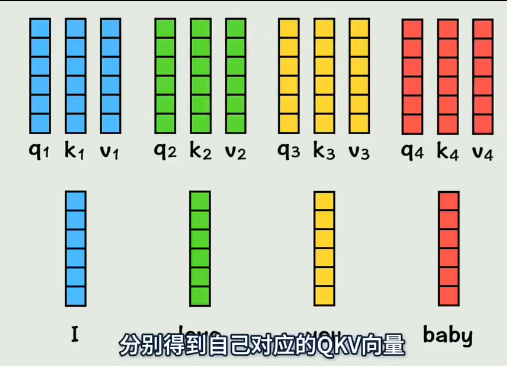
实际在GPU运算的时候,是通过拼接而成的大矩阵做乘法,不是像上边一样一个个乘
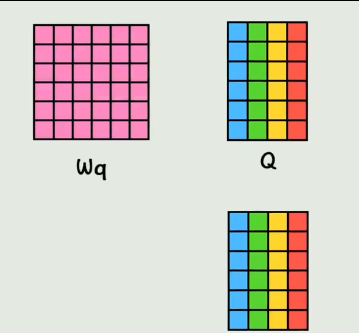
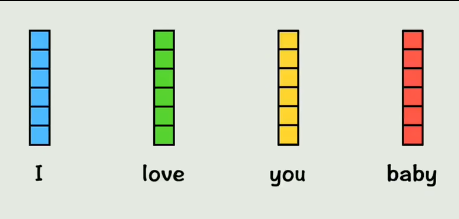
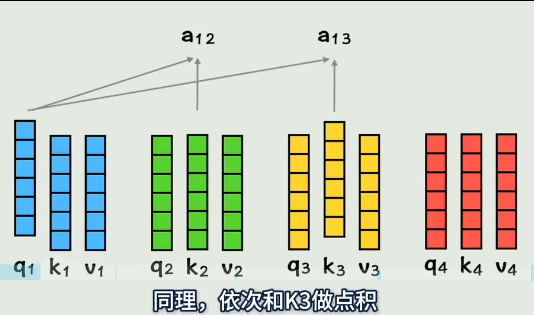
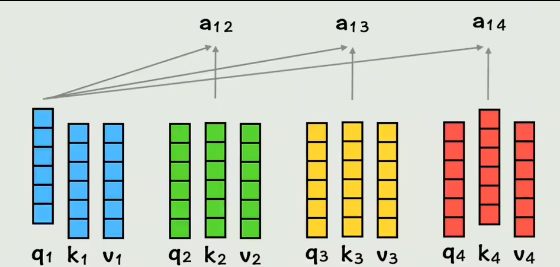
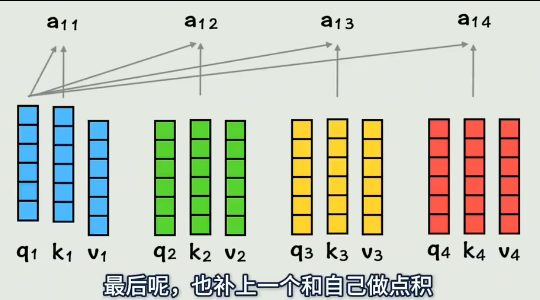
q1和k2做点积,表示:第一个词和第二个词的相似度是多少

q1和k3做点积,表示:第一个词和第三个词的相似度是多少

q1和k4做点积,表示:第一个词和第四个词的相似度是多少

最后q1和自己也做个点积,表示和自己的相似度
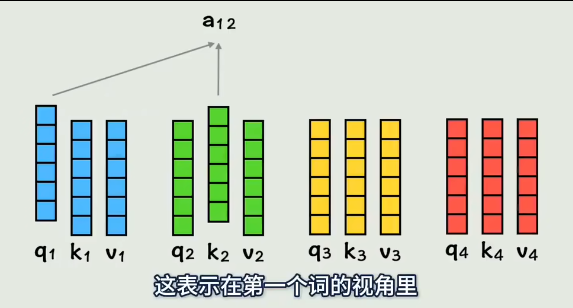


拿到相似度系数之后,分别与V向量相乘,再相加
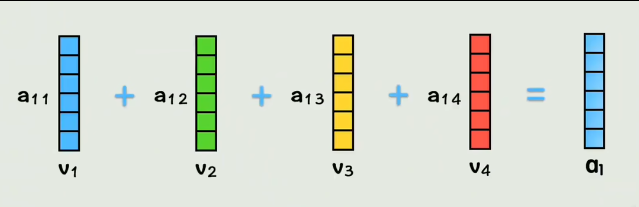
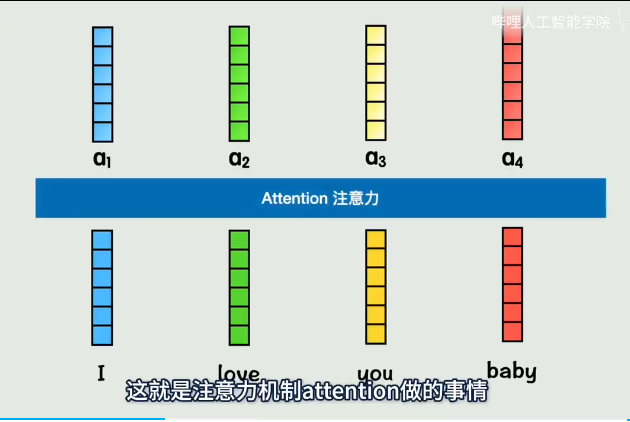
此时这个a1就表示,在第一个词的视角下,按照和它相似度大小,按权重,把每个词的词向量都加到了一块,这就把全部上下文信息都包含在第一个词中去了。
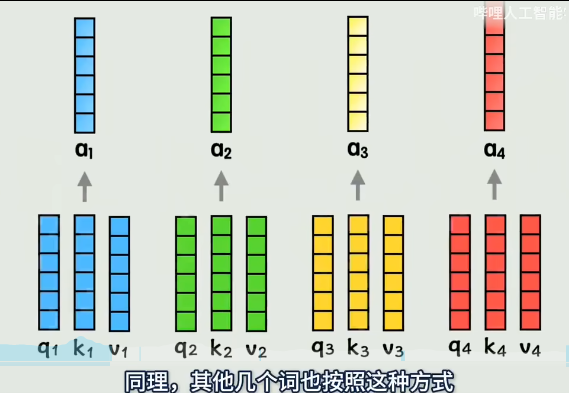
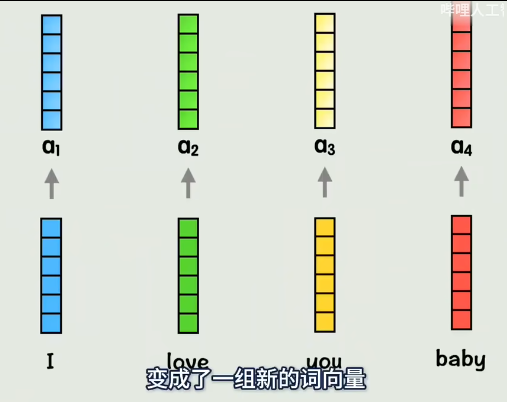
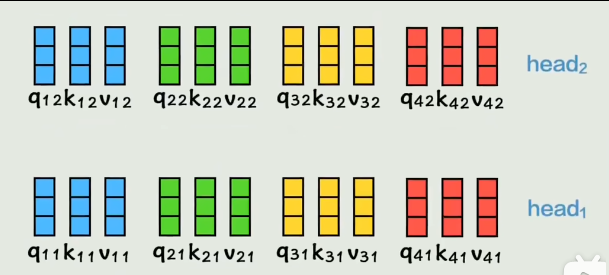
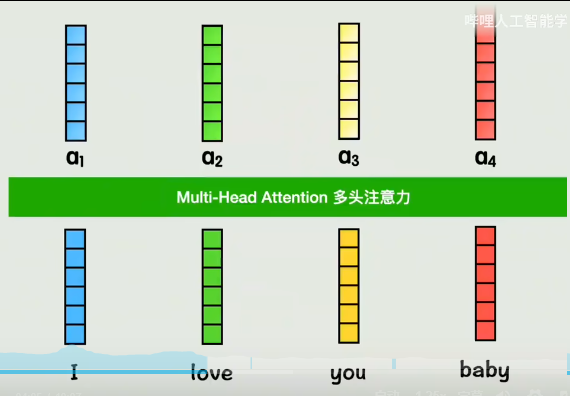
对于注意力机制来说,如果只通过一种计算方式计算一次,得到一组QKV,相关性灵活性会大大降低。

改进:

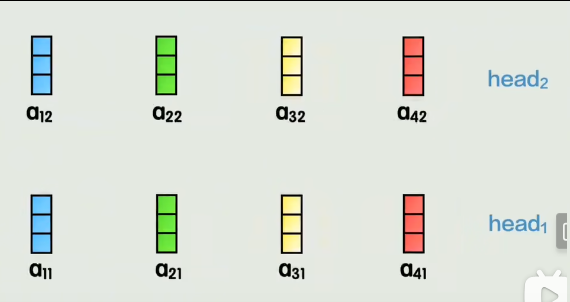
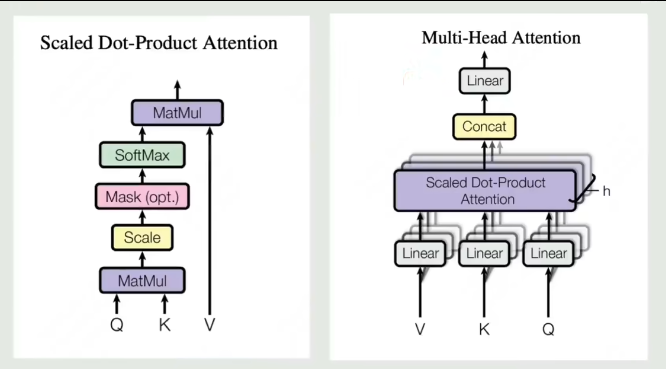
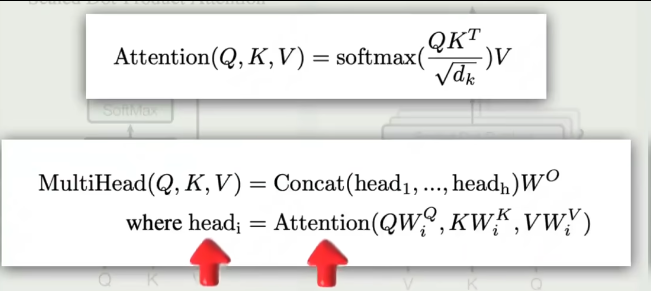
之前每个词计算一组QKV,现在在QKV基础上再经过2个权重矩阵变成2组QKV,给每个词2个学习机会,学习到不同的要计算相似度的QKV
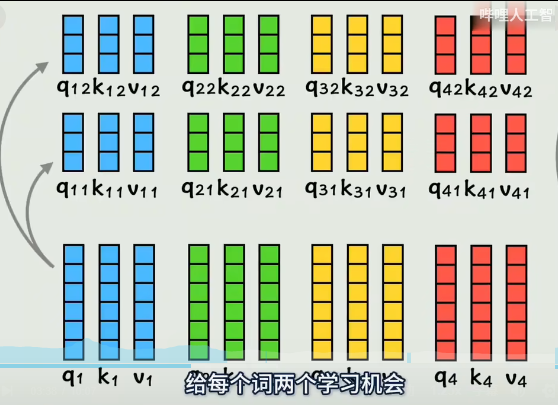


拼接

相关推荐
代码山河8 小时前
Python就业方向全解析:后端、爬虫、数据分析、AI你选哪个?
python·学习·架构·教程·面向对象·项目
sbjdhjd8 小时前
网工进阶笔记:H3CSE 园区网全栈技术与协议汇总
网络·笔记·云计算·ssh·网络工程·vlan·aaa
释厄6238 小时前
AI学习层更新与跨体转移律——人类社会同构·不缺理解缺 U
人工智能·学习
海绵宝宝的月光宝盒11 小时前
14-AutoCAD-阵列命令应用与案例实战(AR)
经验分享·笔记·自动化·课程设计·制造·学习方法·cad
小嘉丶学长12 小时前
Day14 · 字典与集合
java·开发语言·网络·python·学习·1024程序员节
白山编程大哥13 小时前
接口幂等性是什么?如何设计?
笔记
ACP广源盛1392462567313 小时前
6 盘位存储扩展方案选型笔记:YLB3116 @ACP评估记录
笔记·硬件架构·硬件工程·国产芯片
小李不想当小白13 小时前
SPI通信外设与W25Q64 (硬件SPI)(STM32标准库学习笔记)
笔记·stm32·单片机·嵌入式硬件·学习·嵌入式
weixin_4481199415 小时前
Datawhale Jev Cookbook 202610 笔记3
笔记
姚瑞南15 小时前
【PRD】招投标商机雷达爬虫系统
人工智能·经验分享·笔记·爬虫·产品运营·产品经理