论文阅读·多模态工作

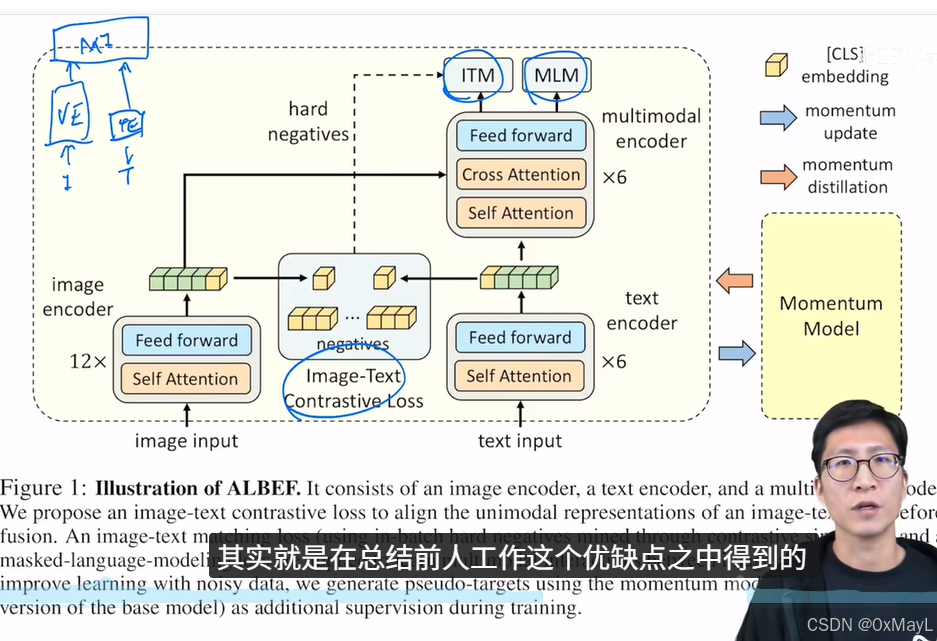
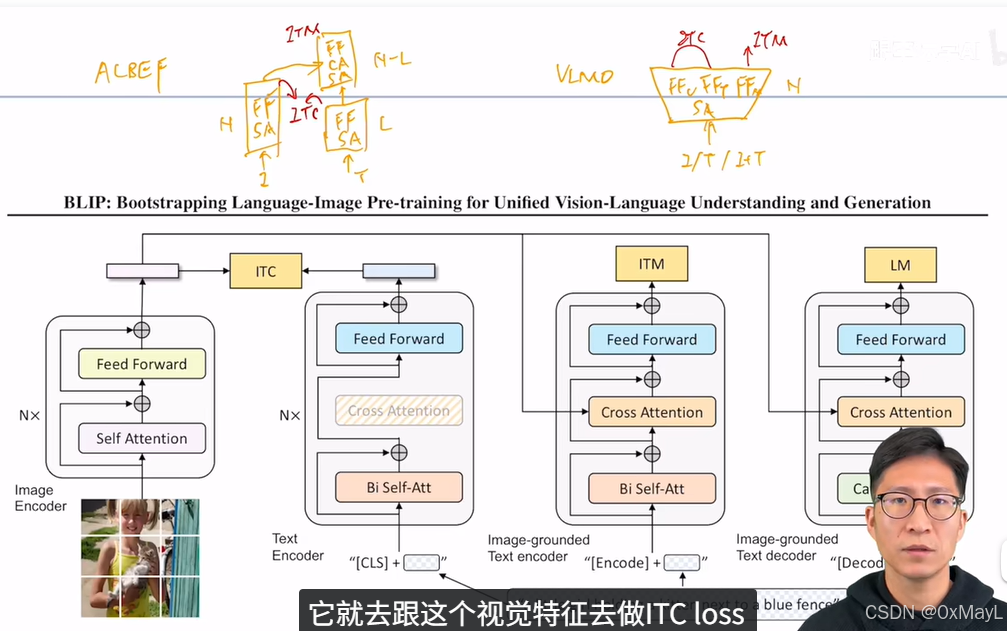
ALBEF:ALign BEfore Fusion

  • 动机:预训练的视觉特征和文本特征一开始间隔很远,不利于在最后多模态的编码器进行学习(对齐)。
  • 模型本质上:就是CLIP的模型,但是为了保留一个多模态的编码器,因此将BERT的模型拆分成文本和多模态编码器(使用交叉注意力对齐)。
  • 三种损失:图文对比损失,图文匹配损失,语言模型损失
  • 图文匹配损失:给定图像和文本,输出一个二分类值,表示是否匹配。这一步通过利用对比损失构造最难样本进行加速。
  • 语言模型损失:给定图像和掩码后的文本,输出掩码处的文本 。

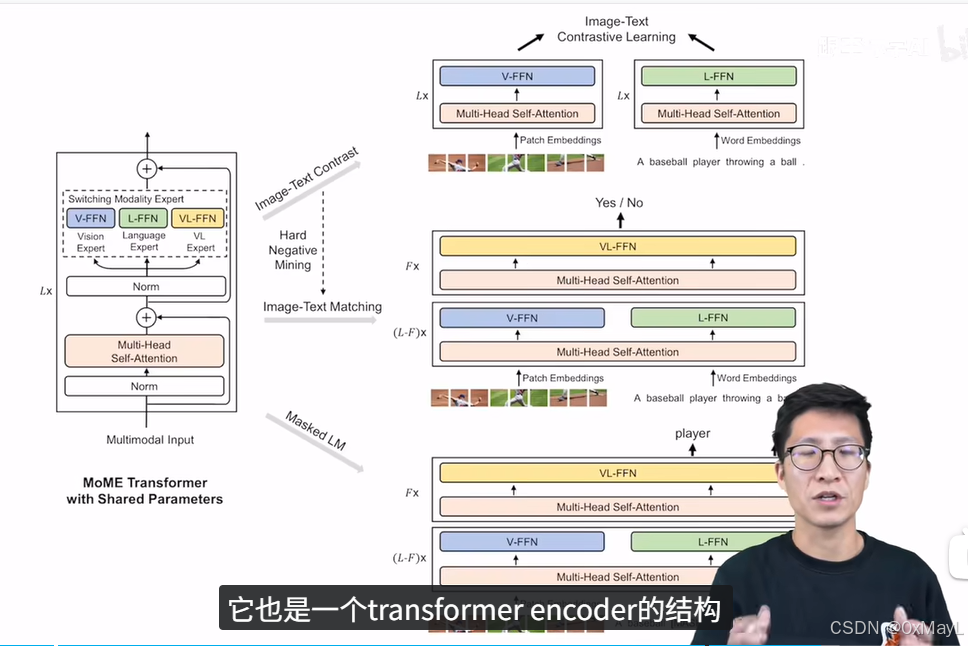
VLMO

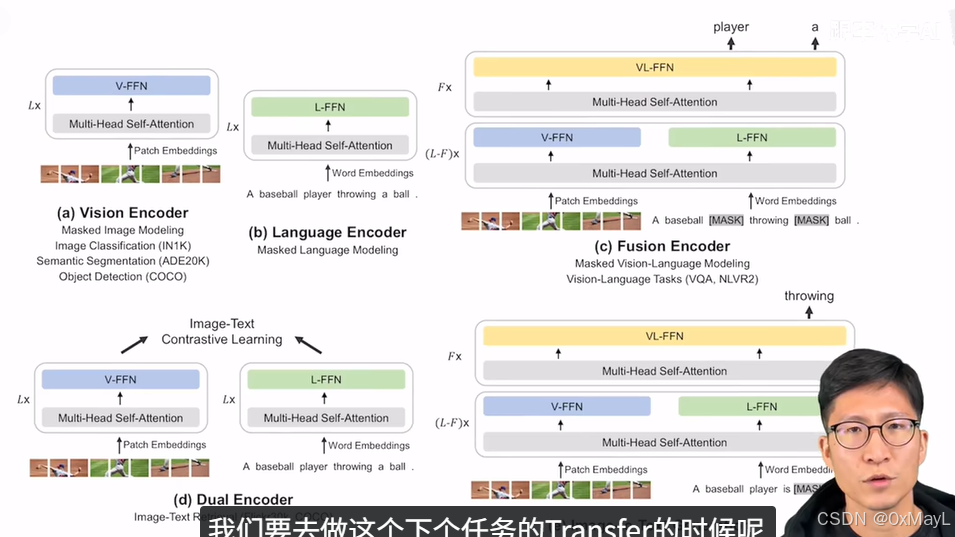
  • 动机:同一双塔模型(CLIP,视觉和文本编码器完全独立且分开);单塔模型(有一个多模态编码器,推理速度)
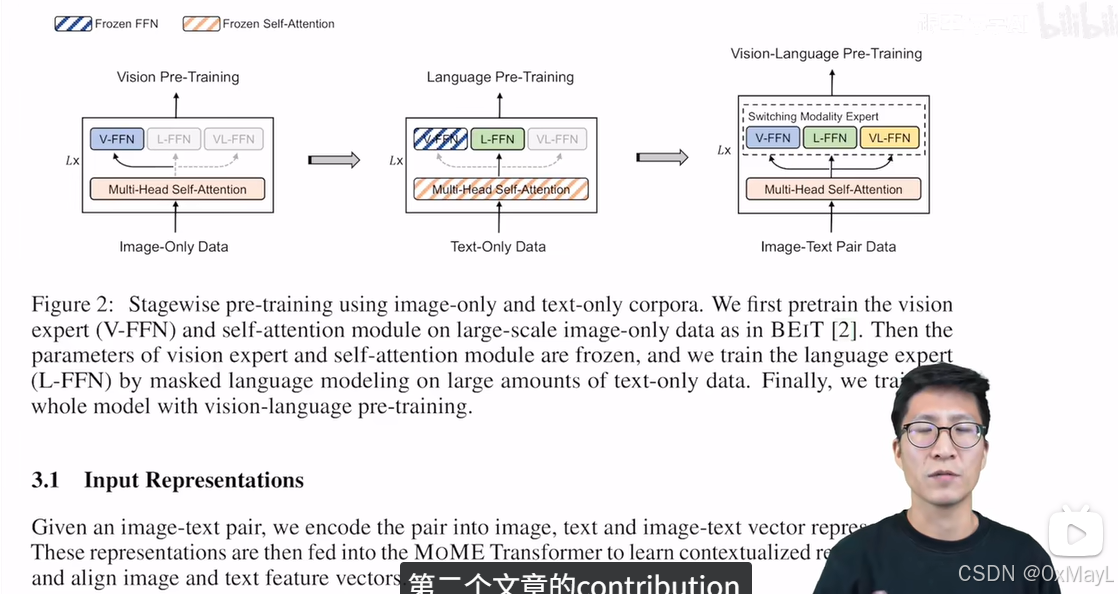
  • 模型:MOE的架构,只不过MOE换成模态的专家FFN,有一个负责模态融合FFN(VL-FFN)
  • 采用共享注意力权重,分阶段训练单一模态,多模态的训练方式。


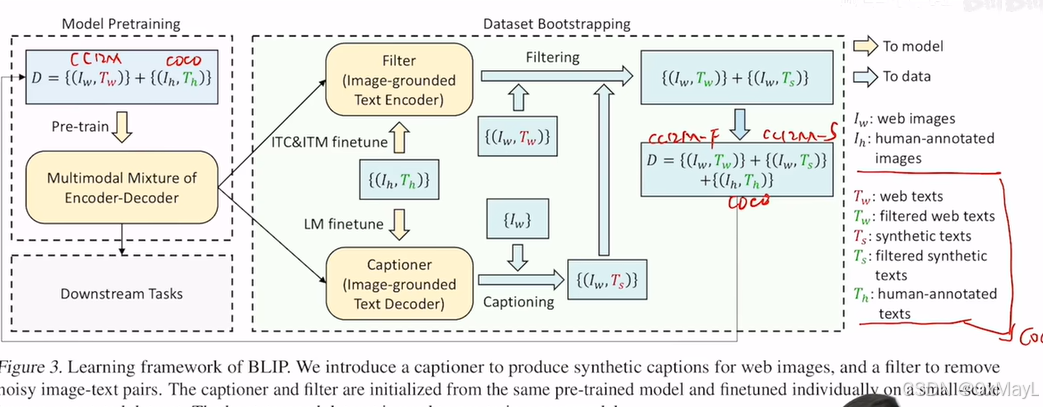
BLIP

  • 动机:之前工作不能直接实现 的多模态的文本生成(只有解码器),且数据大多数存在图文不匹配问题。
  • 模型:借鉴了VLMO的思路,多一个文本模态的解码器,不同模态的编码器架构有一点不同,但是关键是共享大多数参数 。
  • 自举的方式筛选和增强数据。

BEIT-3

  • 动机:利用掩码语言损失来直接进行损失计算 。同一个多个模态间的计算。
相关推荐
Eastmount7 小时前
[论文阅读] (54)NDSS26 JSIMPLIFIER:动静态与LLM如何协同完成JavaScript解混淆?
javascript·论文阅读·恶意代码分析·智能体安全·ndss
Rocky Ding*1 天前
深入解析GPT-6 Astra提示词工程:从Skills、AGENTS.md到可验证的Agent交付
论文阅读·人工智能·深度学习·机器学习·aigc·ai-native·提示词工程
Curious*3 天前
意识障碍研究--论文阅读3
论文阅读
Rocky Ding*3 天前
FLUX 3 Image Klein 技术解析:5.6B 生成器、Flow Map 蒸馏与 ComfyUI 可控编辑
论文阅读·人工智能·深度学习·机器学习·aigc·flux·ai-native
a puppy slide 葱3 天前
ENAS | 基于参数共享的高效神经网络架构搜索
论文阅读·人工智能·深度学习·神经网络·机器学习·计算机视觉·神经网络架构搜索
waiting&fighting3 天前
《中国银发经济发展报告2024》总结
论文阅读
m4Rk_3 天前
【论文阅读】Agent 记忆机制(103):Dynamic Coding Memory——记忆为何让 Agent 更可靠,却可能更平庸
论文阅读·人工智能·学习·开源·github
m4Rk_4 天前
【论文阅读】Agent 记忆机制(102):UMA——用多个未来问题端到端训练一份共享记忆
论文阅读·人工智能·学习·开源·github
辰辰观影5 天前
户外无信号内存小怎么缓存看视频?省内存教程分享
论文阅读·经验分享
Rocky Ding*6 天前
DeepSeek-Bot技术拆解:持久化Agent团队如何管理记忆、上下文与协作成本
论文阅读·人工智能·深度学习·机器学习·aigc·ai-native·智能体