https://github.com/thuml/Time-Series-Library/
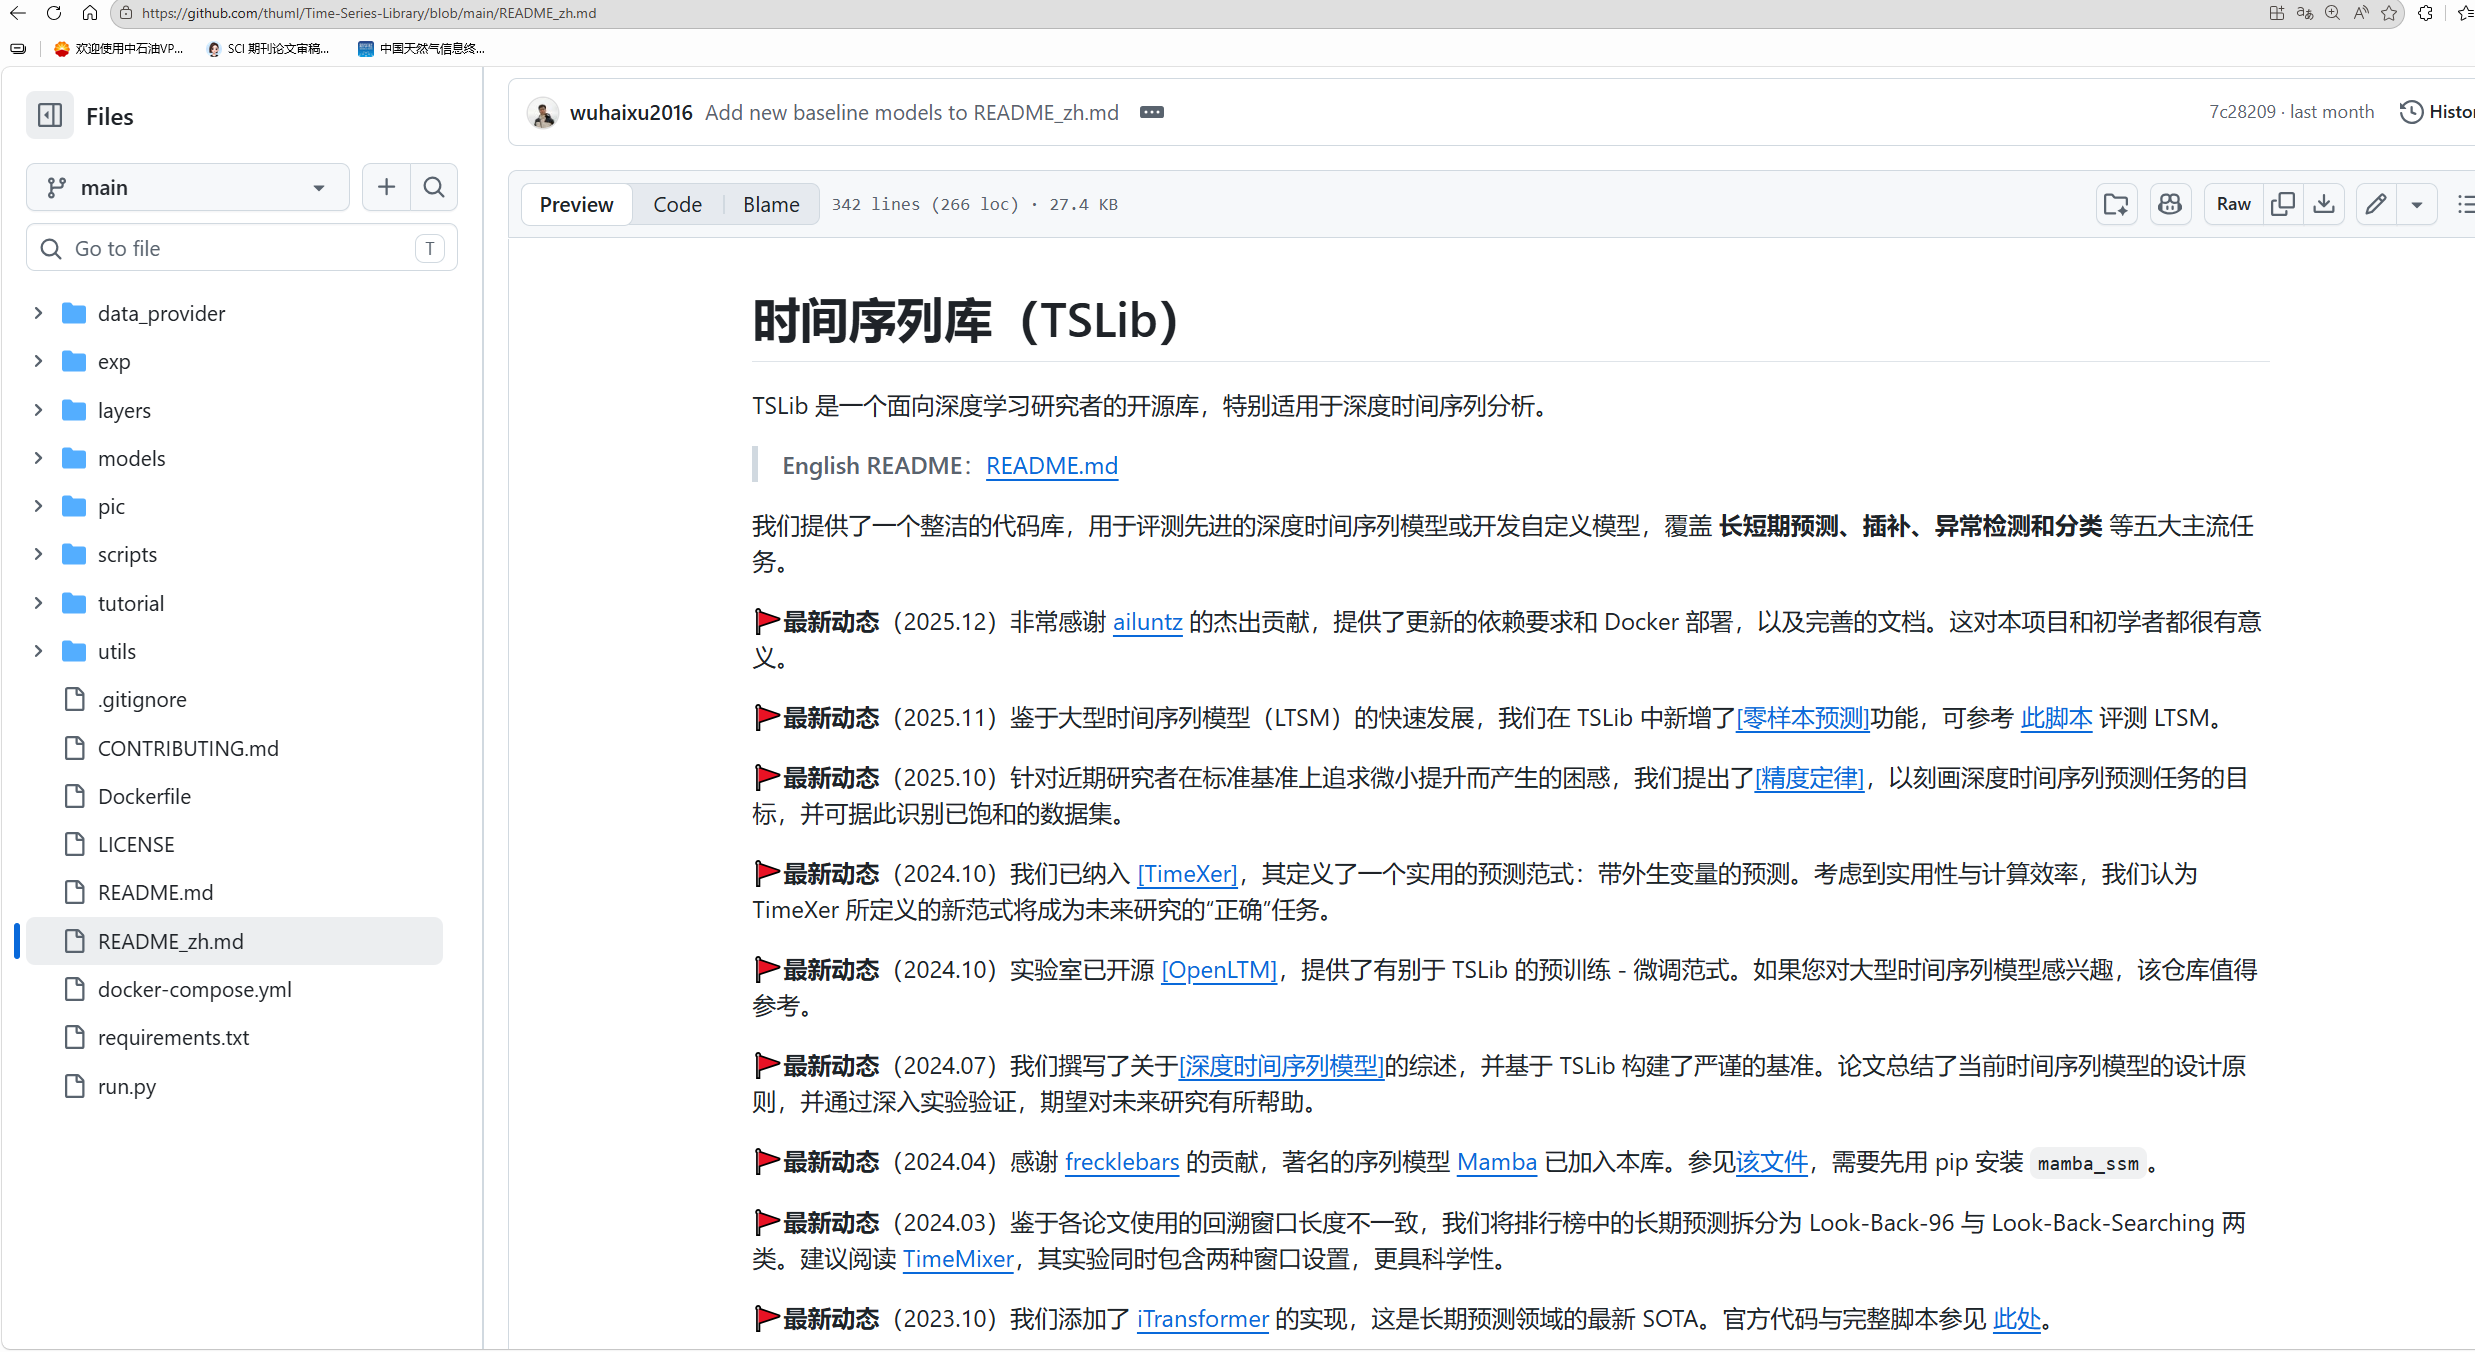
该仓库是标准化时序预测框架 ,模型接入遵循固定规范,核心只需要做4件事:写模型 → 注册模型 → 写配置 → 运行脚本。
一、前置准备
1. 克隆仓库+配置环境
bash
# 克隆官方仓库
git clone https://github.com/thuml/Time-Series-Library.git
cd Time-Series-Library

# 安装依赖(推荐conda环境)
pip install torch torchvision numpy pandas scikit-learn matplotlib tqdm
2. 仓库核心结构(只需关注这4个目录)
Time-Series-Library/
├── models/          # ✅ 所有模型存放地(放你的新模型)
├── configs/         # ✅ 模型配置文件(超参、数据集、序列长度)
├── run.py           # ✅ 主运行脚本(统一入口)
└── exp/             # 训练/测试逻辑(无需修改,框架自带)
二、实操:添加自定义模型 MyMLP
我们实现一个最简单的MLP时序预测模型,严格遵循仓库的模型接口规范。
步骤1:编写新模型代码
在 models/ 目录下新建文件 my_mlp.py,写入以下代码:
python
import torch
import torch.nn as nn

# 🔥 核心:模型类名 = 后续运行时 --model 参数
class MyMLP(nn.Module):
    """
    自定义时序预测MLP模型(适配Time-Series-Library接口)
    接口强制要求:__init__ + forward 两个方法
    输入输出维度:[Batch, Seq_Len, Channel] → [Batch, Pred_Len, Channel]
    """
    def __init__(self, configs):
        super(MyMLP, self).__init__()
        # 从配置文件读取核心参数(框架自动传入)
        self.seq_len = configs.seq_len    # 输入序列长度
        self.pred_len = configs.pred_len  # 预测序列长度
        self.channel = configs.enc_in     # 特征维度

        # 自定义MLP网络
        self.flatten = nn.Flatten()
        self.fc = nn.Sequential(
            nn.Linear(self.seq_len * self.channel, 128),
            nn.ReLU(),
            nn.Linear(128, self.pred_len * self.channel)
        )

    def forward(self, x_enc, x_mark_enc=None, x_dec=None, x_mark_dec=None, mask=None):
        """
        前向传播(严格匹配框架入参!多余参数保留即可)
        x_enc: 输入时序数据 [Batch, seq_len, channel]
        return: 预测结果 [Batch, pred_len, channel]
        """
        # 1. 展平:[B, L, D] → [B, L*D]
        x = self.flatten(x_enc)
        # 2. MLP映射
        x = self.fc(x)
        # 3. 重塑为预测维度:[B, O*D] → [B, O, D]
        pred = x.view(-1, self.pred_len, self.channel)
        return pred
✅ 接口规范 :所有模型必须接收 configs 初始化,forward 入参必须兼容框架的传参(多余参数留空即可)。
步骤2:注册新模型(让框架识别你的模型)
打开 models/__init__.py,修改两处:
- 导入你的模型类
- 将模型加入
Models字典
修改后代码如下(只展示修改部分):
python
# 1. 新增:导入自定义MyMLP模型
from .my_mlp import MyMLP

# 模型注册字典(框架通过这个字典找模型)
Models = {
    'Autoformer': Autoformer,
    'Crossformer': Crossformer,
    'DLinear': DLinear,
    # ... 官方原有模型 ...
    # 2. 新增:注册你的模型
    'MyMLP': MyMLP,
}
✅ 关键 :字典的键(MyMLP) = 运行时 --model 参数,必须和模型类名一致。
步骤3:创建模型配置文件
在 configs/ 目录下新建文件 MyMLP_ETTh1.json(适配ETTh1数据集,官方自带):
json
{
    "model": "MyMLP",
    "data": "ETTh1",
    "root_path": "./dataset/ETT/",
    "data_path": "ETTh1.csv",
    "seq_len": 96,
    "pred_len": 96,
    "enc_in": 7,
    "batch_size": 32,
    "learning_rate": 0.001,
    "train_epochs": 10,
    "patience": 3,
    "embed": "timeF",
    "freq": "h"
}
✅ 参数说明:
seq_len:输入历史序列长度pred_len:预测序列长度enc_in:数据集特征数(ETTh1=7)- 其余参数直接复用官方模板即可
步骤4:运行训练脚本
回到项目根目录,执行一行命令启动训练:
bash
python run.py \
--model MyMLP \
--data ETTh1 \
--config ./configs/MyMLP_ETTh1.json
命令参数解释
--model MyMLP:指定你注册的模型名--data ETTh1:指定数据集(官方自带,无需额外下载)--config:指定你的配置文件路径
三、验证运行成功
出现以下日志,说明新模型接入并运行成功:
>>>>>> Start training MyMLP on ETTh1...
Epoch: 1/10, Train Loss: 0.324, Val Loss: 0.287
Epoch: 2/10, Train Loss: 0.211, Val Loss: 0.203
...
>>>>>> Training finished
>>>>>> Test loss: 0.198
训练完成后,模型权重、日志会自动保存在 results/ 目录下。
四、进阶:替换为你自己的模型
只需修改 models/my_mlp.py 中的模型结构 ,接口完全不用改:
python
# 示例:替换为CNN/Transformer/任意模型
class MyModel(nn.Module):
    def __init__(self, configs):
        super().__init__()
        self.seq_len = configs.seq_len
        self.pred_len = configs.pred_len
        self.channel = configs.enc_in

        # 在这里写你的模型网络
        self.backbone = nn.Conv1d(...)

    def forward(self, x_enc, x_mark_enc=None, x_dec=None, x_mark_dec=None, mask=None):
        # 你的前向传播逻辑
        pred = self.backbone(x_enc.transpose(1,2)).transpose(1,2)
        return pred
然后重新注册、运行即可。
五、常见报错解决
- Model not found :检查
models/__init__.py注册是否正确,模型名大小写一致 - 维度不匹配 :严格保证输出
[Batch, pred_len, channel] - 参数缺失 :配置文件中必须包含
seq_len/pred_len/enc_in
总结
- 新模型放在
models/,遵循__init__ + forward接口 - 在
models/__init__.py注册模型 - 配置文件放在
configs/,指定模型名和超参 - 用
run.py一键启动训练
按照这个流程,你可以把任何时序模型无缝接入该框架并运行。